Andersons Blickwinkel
KI-Bildmatting, das Szenen versteht

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
In dem Zusatzdokumentarfilm, der der DVD-Veröffentlichung von Alien3 (1992) aus dem Jahr 2003 beiliegt, erinnerte die VFX‑Legende Richard Edlund mit Entsetzen an das „Sumo‑Ringen“ der photochemischen Matte‑Extraktion, das die Arbeit an visuellen Effekten zwischen den späten 1930er‑Jahren und den späten 1980er‑Jahren dominierte. Edlund beschrieb die unzuverlässige Natur des Prozesses als „Sumo‑Ringen“, im Vergleich zu den digitalen Blau‑/Grün‑Screen‑Techniken, die Anfang der 1990er‑Jahre die Oberhand gewannen (und er hat die Metapher wieder aufgegriffen).
Das Extrahieren eines Vordergrundelements (wie einer Person oder eines Raumschiffmodells) aus einem Hintergrund, sodass das ausgeschnittene Bild in eine Hintergrundplatte eingefügt werden kann, wurde ursprünglich erreicht, indem das Vordergrundobjekt vor einem einheitlichen blauen oder grünen Hintergrund gefilmt wurde.
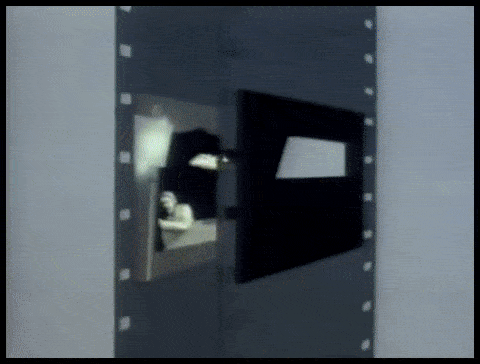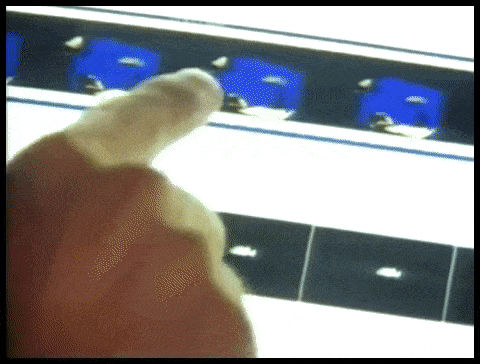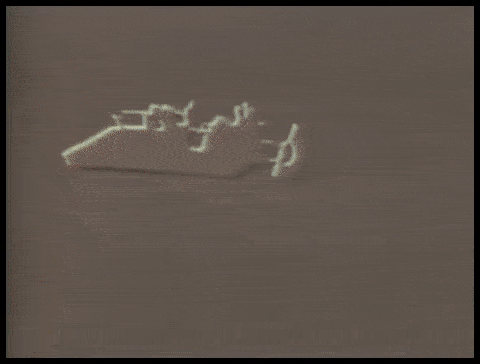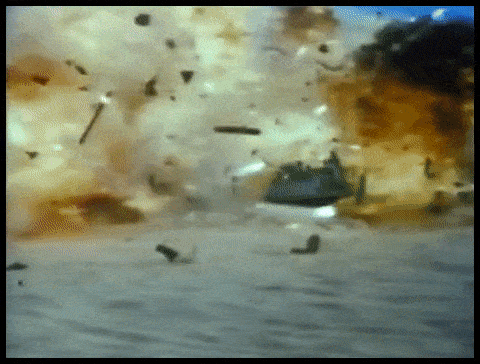
Aufwändige photochemische Extraktionsprozesse für einen VFX-Shot von ILM für „Return of the Jedi“ (1983).
Im resultierenden Filmmaterial wurde die Hintergrundfarbe anschließend chemisch isoliert und als Vorlage verwendet, um das Vordergrundobjekt (oder die Person) in einem optischen Drucker als „schwebendes“ Objekt in einer ansonsten transparenten Filmzelle neu zu drucken.
Der Vorgang war als Color Separation Overlay (CSO) bekannt – obwohl dieser Begriff später stärker mit den groben „Chromakey“-Videoeffekten in kostengünstigeren Fernsehproduktionen der 1970er‑ und 1980er‑Jahre assoziiert wurde, die mit analogen statt chemischen oder digitalen Mitteln erzielt wurden.

Eine Demonstration von Color Separation Overlay im Jahr 1970 für die britische Kindersendung „Blue Peter“. Quelle: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
In jedem Fall konnte das extrahierte Filmmaterial, egal ob für Film‑ oder Videoelemente, anschließend in jedes andere Filmmaterial eingefügt werden.
Obwohl Disneys bemerkenswert teurer und proprietärer Sodium‑Vapor‑Prozess (der speziell auf Gelb setzte und auch verwendet wurde für Alfred Hitchcocks Horrorfilm von 1963 The Birds) eine bessere Definition und schärfere Matten lieferte, blieb die photochemische Extraktion mühsam und unzuverlässig.

Der proprietäre Sodium‑Vapor‑Extraktionsprozess von Disney erforderte Hintergründe am gelben Ende des Spektrums. Hier ist Angela Lansbury während der Produktion einer VFX‑reichen Sequenz für „Bedknobs and Broomsticks“ (1971) an Drähten aufgehängt. Quelle
Jenseits des digitalen Matting
In den 1990er‑Jahren ersetzte die digitale Revolution die Chemikalien, jedoch nicht die Notwendigkeit von Green‑Screens. Es war nun möglich, den grünen (oder irgendeinen anderen) Hintergrund einfach zu entfernen, indem man nach Pixeln innerhalb eines Toleranzbereichs dieser Farbe suchte, in Bildbearbeitungsprogrammen wie Photoshop, und einer neuen Generation von Video‑Compositing‑Suiten, die farbige Hintergründe automatisch keyen konnten. Fast über Nacht wurden sechzig Jahre der optischen Druckindustrie der Geschichte übergeben.
Die letzten zehn Jahre der GPU‑beschleunigten Computer‑Vision‑Forschung leiten das Matte‑Extrahieren in ein drittes Zeitalter ein und fordern Forscher heraus, Systeme zu entwickeln, die hochwertige Matten ohne Green‑Screen extrahieren können. Allein bei arXiv sind wöchentlich Beiträge zu Innovationen bei maschinellem‑Lernen‑basierten Vordergrund‑Extraktionen zu finden.
Uns ins Bild setzen
Dieser Brennpunkt akademischen und industriellen Interesses an KI‑Extraktion hat bereits den Verbrauchermarkt beeinflusst: grobe, aber funktionierende Implementierungen sind uns allen in Form von Zoom– und Skype-Filtern bekannt, die in Videokonferenz‑Calls unsere Wohnzimmerhintergründe durch tropische Inseln usw. ersetzen können.
Allerdings erfordern die besten Matten immer noch einen Green‑Screen, wie Zoom bemerkte letzten Mittwoch.

Links, ein Mann vor einem Green‑Screen, mit gut extrahierten Haaren über Zooms Virtual‑Background‑Funktion. Rechts, eine Frau vor einer normalen häuslichen Szenerie, deren Haare algorithmisch, weniger genau und mit höherem Rechenaufwand extrahiert wurden. Quelle: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Ein weiterer Beitrag von der Zoom‑Support‑Plattform warnt, dass die Extraktion ohne Green‑Screen ebenfalls mehr Rechenleistung im Aufnahmegerät erfordert.
Die Notwendigkeit, es herauszuschneiden
Verbesserungen in Qualität, Portabilität und Ressourceneffizienz von „in‑the‑wild“-Matte‑Extraktionssystemen (d. h. Personen ohne Green‑Screen zu isolieren) sind für viel mehr Sektoren und Anwendungsbereiche relevant als nur für Videokonferenz‑Filter.
Für die Entwicklung von Datensätzen bietet verbesserte Gesicht‑, Vollkopf‑ und Ganzkörper‑Erkennung die Möglichkeit sicherzustellen, dass überflüssige Hintergrundelemente nicht in Computer‑Vision‑Modelle von menschlichen Subjekten eingelernt werden; genauere Isolation würde die semantische Segmentierung-Techniken, die darauf ausgelegt sind, Domänen (z. B. „Katze“, „Person“, „Boot“) zu unterscheiden und zu assimilieren, erheblich verbessern und VAE– und Transformer-basierte Bildsynthesesysteme wie OpenAIs neues DALL‑E 2 optimieren; bessere Extraktionsalgorithmen würden zudem den Bedarf an teurem manuellen Rotoscoping in kostenintensiven VFX‑Pipelines verringern.
Tatsächlich macht der Aufstieg multimodaler (in der Regel Text/Bild) Methodologien, bei denen ein Bereich wie „Katze“ sowohl als Bild als auch mit zugehörigen Textreferenzen kodiert wird, bereits Einzug in die Bildverarbeitung. Ein aktuelles Beispiel ist die Text2Live-Architektur, die multimodales (Text/Bild‑)Training nutzt, um Videos von, neben unzähligen weiteren Möglichkeiten, Kristallschwanen und Glashirschen zu erzeugen.
Szenenbewusstes KI‑Matting
Ein erheblicher Teil der Forschung zu KI‑basiertem automatischem Matting konzentrierte sich auf die Erkennung von Grenzen und die Bewertung pixelbasierter Gruppierungen innerhalb eines Bild‑ oder Videorahmens. Neuere Forschung aus China bietet jedoch eine Extraktionspipeline, die die Abgrenzung und Matte‑Qualität verbessert, indem sie textbasierte Beschreibungen einer Szene nutzt (ein multimodaler Ansatz, der in den letzten 3‑4 Jahren im Bereich der Computer‑Vision‑Forschung an Bedeutung gewonnen hat) und behauptet, in mehrfacher Hinsicht gegenüber früheren Methoden verbessert zu sein.

Ein Beispiel für SPG‑IM‑Extraktion (letztes Bild, unten rechts), im Vergleich zu konkurrierenden früheren Methoden. Quelle: https://arxiv.org/pdf/2204.09276.pdf
Die für den Teilsektor der Extraktionsforschung gestellte Herausforderung besteht darin, Workflows zu erzeugen, die ein Minimum an manueller Annotation und menschlicher Intervention erfordern – idealerweise gar keine. Neben den Kostenaspekten beobachten die Forscher des neuen Papiers, dass Annotationen und manuelle Segmentierungen, die von ausgelagerten Crowdworkern aus verschiedenen Kulturen durchgeführt werden, dazu führen können, dass Bilder unterschiedlich gekennzeichnet oder sogar segmentiert werden, was zu inkonsistenten und unbefriedigenden Algorithmen führt.
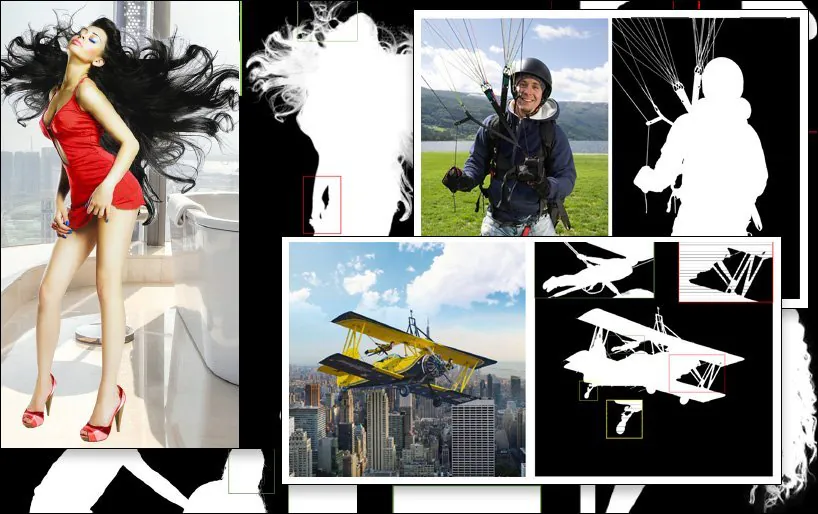
Ein Beispiel dafür ist die subjektive Interpretation dessen, was ein „Vordergrundobjekt“ definiert:

Aus dem neuen Papier: frühere Methoden LFM und MODNet („GT“ steht für Ground Truth, ein „ideales“ Ergebnis, das häufig manuell oder durch nicht‑algorithmische Methoden erzielt wird), haben unterschiedliche und unterschiedlich wirksame Auffassungen zur Definition von Vordergrundinhalt, während die neue SPG‑IM‑Methode „nahe Inhalte“ durch den Szenenkontext effektiver abgrenzt.
Um dem zu begegnen, haben die Forscher eine zweistufige Pipeline mit dem Titel Situational Perception Guided Image Matting (SPG‑IM) entwickelt. Die zweistufige Encoder/Decoder‑Architektur umfasst Situational Perception Distillation (SPD) und Situational Perception Guided Matting (SPGM).

Die SPG‑IM‑Architektur.
Zunächst pre‑trainiert SPD visuell‑zu‑textuelle MerkmalsTransformationen und erzeugt zugehörige Bildunterschriften. Anschließend wird die Vorhersage der Vordergrund‑Maske ermöglicht, indem die Pipeline an eine neuartige Salienz‑Vorhersage-Technik angebunden wird.
Dann gibt SPGM eine geschätzte Alpha‑Matte basierend auf dem rohen RGB‑Bildeingang und der im ersten Modul erzeugten Maske aus.
Das Ziel ist die situative Wahrnehmungs‑Leitung, bei der das System ein kontextuelles Verständnis dessen hat, woraus das Bild besteht, sodass es beispielsweise die Herausforderung, komplexes Haar aus einem Hintergrund zu extrahieren, anhand bekannter Merkmale dieser spezifischen Aufgabe einordnen kann.

Im nachfolgenden Beispiel erkennt SPG‑IM, dass die Leinen intrinsisch zu einem „Fallschirm“ gehören, während MODNet diese Details nicht beibehält und definiert. Ebenso oben geht die vollständige Struktur der Spielplatzvorrichtung bei MODNet willkürlich verloren.
Das neue Paper trägt den Titel Situational Perception Guided Image Matting und stammt von Forschern des OPPO Research Institute, PicUp.ai und Xmotors.
Intelligente automatisierte Matten
SPG‑IM bietet zudem ein Adaptive Focal Transformation (AFT) Refinement Network, das lokale Details und globalen Kontext separat verarbeiten kann und so „intelligente Matten“ ermöglicht.

Das Verständnis des Szenenkontexts, in diesem Fall „Mädchen mit Pferd“, kann die Vordergrundextraktion potenziell einfacher machen als frühere Methoden.
Das Papier stellt fest:
„Wir glauben, dass visuelle Darstellungen aus der visuell‑zu‑textuellen Aufgabe, z. B. Bildunterschriftenerstellung, sich stärker auf semantisch umfassendere Signale zwischen a) Objekt zu Objekt und b) Objekt zur Umgebung konzentrieren, um Beschreibungen zu erzeugen, die sowohl globale Informationen als auch lokale Details abdecken. Darüber hinaus können im Vergleich zur teuren Pixel‑Annotation beim Bild‑Matting Text‑Labels in großem Umfang zu sehr geringen Kosten gesammelt werden.“
Der SPD‑Zweig der Architektur wird gemeinsam mit dem transformer‑basierten Text‑Decoder VirTex der University of Michigan vortrainiert, der visuelle Darstellungen aus semantisch dichten Bildunterschriften lernt.

VirTex trainiert gemeinsam ein ConvNet und Transformer mittels Bild‑Untertitel‑Paaren und überträgt die gewonnenen Erkenntnisse auf nachgelagerte Vision‑Aufgaben wie Objekterkennung. Quelle: https://arxiv.org/pdf/2006.06666.pdf
Unter anderem Tests und Ablationsstudien haben die Forscher SPG‑IM gegen State‑of‑the‑Art‑Methoden auf Trimap‑Basis wie Deep Image Matting (DIM), IndexNet, Context‑Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA und Semantic Image Mapping (SIM) getestet.
Weitere zuvor getestete Frameworks umfassten trimap‑freie Ansätze LFM, HAttMatting und MODNet. Für einen fairen Vergleich wurden die Testmethoden an die unterschiedlichen Methodologien angepasst; wo kein Code verfügbar war, wurden die Techniken des Papiers anhand der beschriebenen Architektur reproduziert.
Das neue Papier stellt fest:
„Unser SPG‑IM übertrifft alle konkurrierenden trimap‑freien Methoden ([LFM], [HAttMatting] und [MODNet]) mit großem Abstand. Gleichzeitig zeigt unser Modell eine bemerkenswerte Überlegenheit gegenüber den State‑of‑the‑Art‑(SOTA) trimap‑basierten und masken‑gesteuerten Methoden in allen vier Metriken über die öffentlichen Datensätze hinweg (d. h. Composition‑1K, Distinction‑646 und Human‑2K) sowie über unseren Multi‑Object‑1K‑Benchmark.“
Und weiter:
„Es ist offensichtlich zu beobachten, dass unsere Methode feine Details (z. B. Haarspitzen, transparente Texturen und Kanten) ohne Trimap‑Leitung bewahrt. Darüber hinaus kann unser SPG‑IM im Vergleich zu anderen konkurrierenden trimap‑freien Modellen eine bessere globale semantische Vollständigkeit beibehalten.“


Er