
Andersons Blickwinkel
Konsistente AI-Videoinhaltsbearbeitung mit textgesteuerter Eingabe

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Wichtige PunkteText2Live ermöglicht konsistente Videobearbeitungen auf Basis von Texteingaben ohne…
Mehr anzeigen
- Text2Live ermöglicht konsistente Videobearbeitungen auf Basis von Texteingaben ohne Einzelbildverarbeitung.
- Das System verwendet einen neuronalen Schichtatlas, um Bearbeitungen einmalig über die gesamte Videotimeline anzuwenden.
- Text2Live automatisiert Maskierung und Compositing und macht Rotoskopie oder Greenscreens überflüssig.
Während die professionelle VFX-Community von neuen Innovationen in der Bild- und Videosynthese fasziniert ist – und sich gelegentlich ein wenig bedroht fühlt –, verweist die fehlende zeitliche Kontinuität in den meisten KI-basierten Videoschnittprojekten viele dieser Bemühungen in die «psychedelische» Sphäre, mit schimmernden und schnell wechselnden Texturen und Strukturen, inkonsistenten Effekten und der Art von grober Technologie, die an die photochemische Ära der visuellen Effekte erinnert.
Wenn Sie etwas sehr Spezifisches in einem Video ändern möchten, das nicht in den Bereich der Deepfakes fällt (d. h. die Übertragung einer neuen Identität auf bestehendes Filmmaterial einer Person), operieren die meisten aktuellen Lösungen unter ziemlich strengen Einschränkungen in Bezug auf die für die Produktion erforderliche Präzision.
Eine Ausnahme ist die laufende Arbeit einer losen Vereinigung von Akademikern des Weizmann-Instituts für Wissenschaft. Im Jahr 2021 kündigten drei seiner Forscher, in Zusammenarbeit mit Adobe (ADBE ), eine neue Methode für die Zerlegung von Video und die Überlagerung einer konsistenten internen Karte – eines geschichteten neuronalen Atlas – in eine komponierte Ausgabe an, komplett mit Alphakanälen und zeitlich kohärenter Ausgabe.
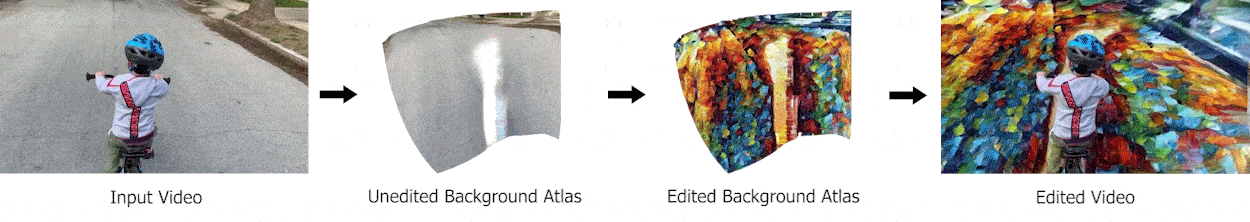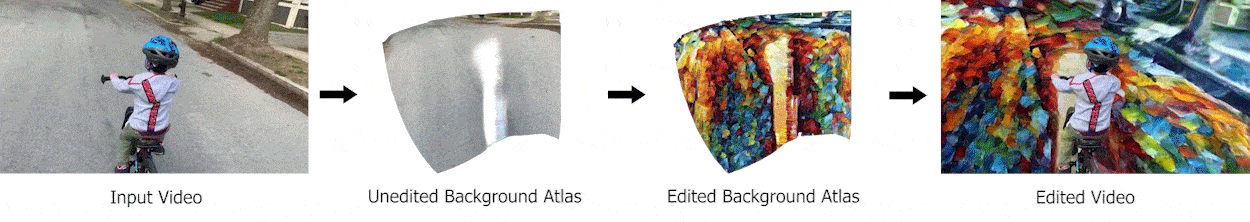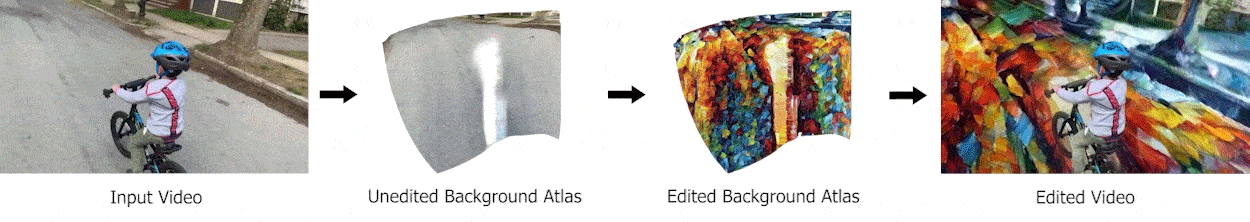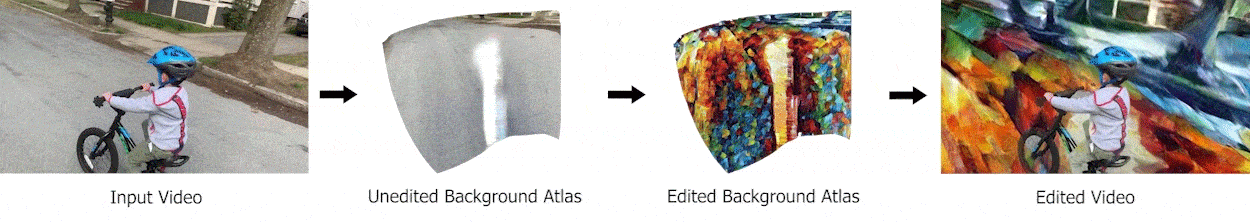
Aus dem Paper von 2021: Eine Schätzung der vollständigen Traversierung der Straße im Quellclip wird via neuronalem Netzwerk bearbeitet, was traditionell umfangreiche Rotoskopie und Match-Moving erfordern würde. Da Hintergrund- und Vordergrundelemente von verschiedenen Netzen verarbeitet werden, sind Masken wirklich ‘automatisch’. Quelle: https://layered-neural-atlases.github.io/
Obwohl es irgendwo im Bereich des optischen Flusses in VFX-Pipelines liegt, hat der geschichtete Atlas keine direkte Entsprechung in traditionellen CGI-Workflows, da er im Wesentlichen eine ‘zeitliche Texturkarte’ darstellt, die durch traditionelle Softwaremethoden erzeugt und bearbeitet werden kann. Im zweiten Bild in der Abbildung oben wird der Hintergrund der Straßenoberfläche (figurativ) über die gesamte Laufzeit des Videos dargestellt. Eine Änderung dieses Basisbildes (drittes Bild von links in der Abbildung oben) ergibt eine konsistente Änderung im Hintergrund.
Die Bilder des ‘entfalteten’ Atlas oben stellen nur einzelne interpretierte Frames dar; konsistente Änderungen in jedem Zielvideo-Frame werden auf den ursprünglichen Frame zurückgemappt, wobei notwendige Okklusionen und andere erforderliche Szeneneffekte wie Schatten oder Reflexionen beibehalten werden.
Die Kernarchitektur verwendet ein Multilayer-Perceptron (MLP), um die entfalteten Atlanten, Alphakanäle und Karten darzustellen, die alle gemeinsam optimiert werden und vollständig in einem 2D-Raum, wodurch NeRF-ähnliche Vorkenntnisse von 3D-Geometriepunkten, Tiefenkartierungen und ähnlichen CGI-ähnlichen Attributen entbehrlich werden.
Der Referenzatlas einzelner Objekte kann auch zuverlässig geändert werden:
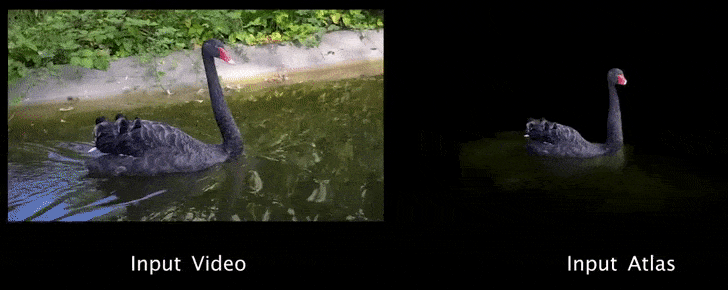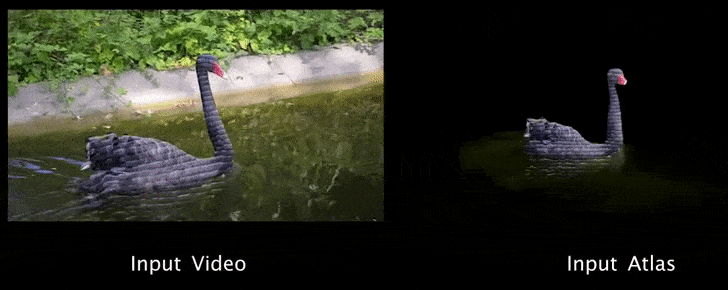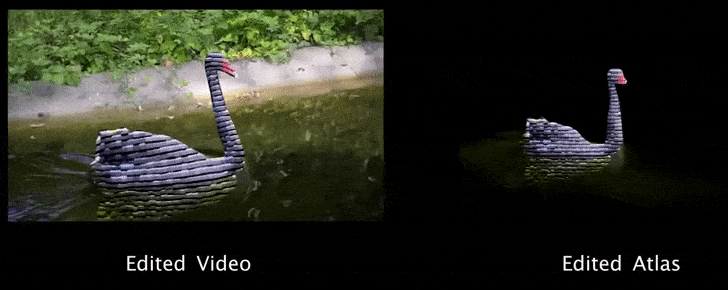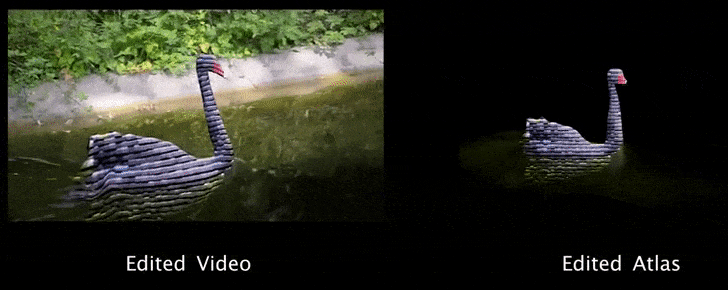
Konsistente Änderung eines beweglichen Objekts unter dem Rahmenwerk von 2021. Quelle: https://www.youtube.com/watch?v=aQhakPFC4oQ
Im Wesentlichen kombiniert das System von 2021 die Geometrieausrichtung, Match-Moving, Kartierung, Neutexturierung und Rotoskopie in einem diskreten neuronalen Prozess.
Text2Live
Die drei ursprünglichen Forscher des Papers von 2021, zusammen mit NVIDIA (NVDA ) Research, sind unter den Mitwirkenden an einer neuen Innovation auf dieser Technik, die die Kraft von geschichteten Atlanten mit der Art von textgesteuerter CLIP-Technologie kombiniert, die diese Woche mit der Veröffentlichung von OpenAI’s DALL-E 2-Framework wieder in den Vordergrund gerückt ist.
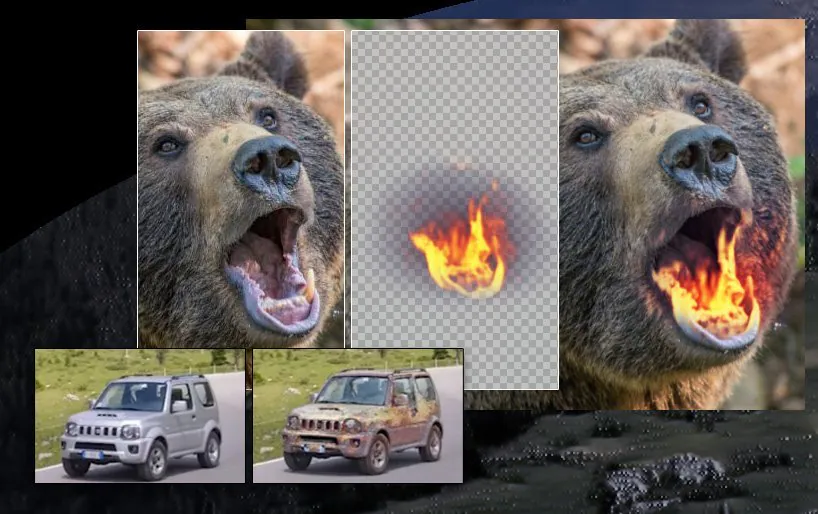
Die neue Architektur, betitelt Text2Live, ermöglicht es dem Endbenutzer, lokale Bearbeitungen an tatsächlichem Videoinhalt basierend auf Textprompts vorzunehmen:
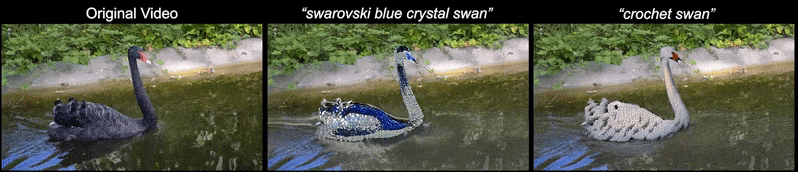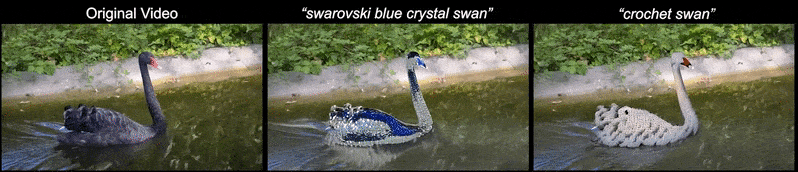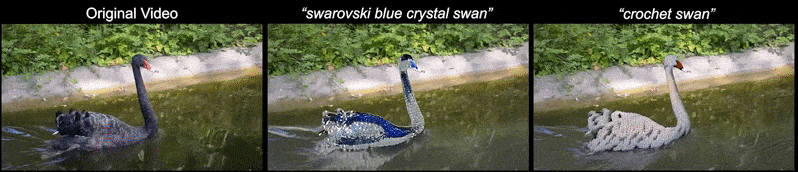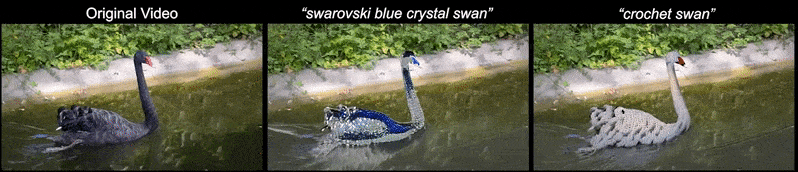
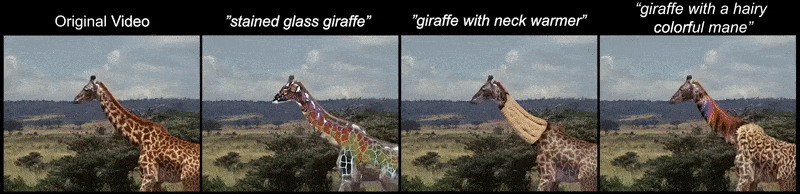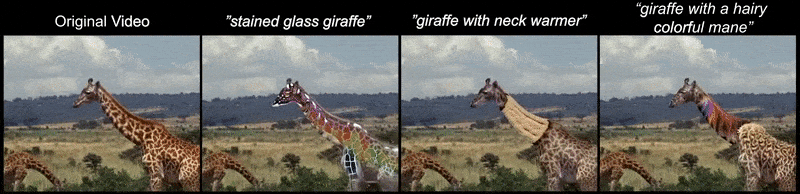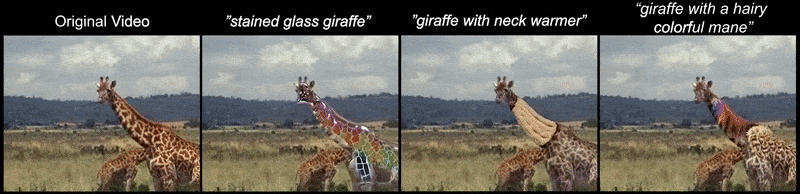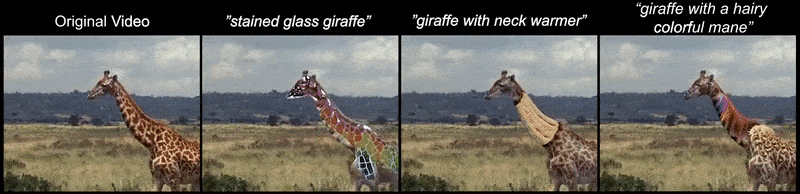
Zwei Beispiele für die Bearbeitung des Vordergrunds. Für höhere Auflösung und Schärfe besuchen Sie bitte die Originalvideos unter https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live bietet semantische und hochlokale Bearbeitung ohne die Verwendung eines vortrainierten Generators, indem es eine interne Datenbank nutzt, die spezifisch für den betroffenen Video-Clip ist.

Hintergrund- und Vordergrund-(Objekt-)Transformationen unter Text2Live. Quelle: https://text2live.github.io/sm/pages/video_results_atlases.html
Die Technik erfordert keine vom Benutzer bereitgestellten Masken, wie in einem typischen Rotoskopie- oder Green-Screen-Workflow, sondern schätzt Relevanzkarten durch eine Bootstrapping-Technik basierend auf Forschung von 2021 von der School of Computer Science an der Universität Tel Aviv und Facebook AI Research (FAIR).

Ausgabe-Karten, die via einem transformer-basierten generischen Aufmerksamkeitsmodell generiert werden.
Das neue Paper trägt den Titel Text2LIVE: Text-Driven Layered Image and Video Editing. Das ursprüngliche Team von 2021 wird von Weizmanns Omer Bar-Tal und Yoni Kasten von NVIDIA Research unterstützt.
Architektur
Text2Live besteht aus einem Generator, der auf einem einzigen Eingabebild und Ziel-Textprompts trainiert wird. Ein Contrastive Language-Image Pretraining (CLIP)-Modell, das auf 400 Millionen Text/Bild-Paaren vortrainiert wurde, liefert assoziiertes visuelles Material, aus dem Benutzereingaben interpretiert werden können.

Der Generator akzeptiert ein Eingabebild (Frame) und gibt eine Ziel-RGBA-Ebene mit Farb- und Deckkraftinformationen aus. Diese Ebene wird dann in die ursprüngliche Footage mit zusätzlichen Augmentierungen komponiert.

Der Alphakanal in der generierten RGBA-Ebene bietet eine interne Kompositions-Funktion ohne Rückgriff auf traditionelle Pipelines, die softwarebasiertes Pixel-Editing wie After Effects beinhalten.
Durch das Training mit internen Bildern, die zum Zielvideo oder Zielbild gehören, vermeidet Text2Live die Notwendigkeit, das Eingabebild in den latenten Raum eines Generative Adversarial Network (GAN) zu invertieren. Diese Praxis ist derzeit bei Weitem nicht präzise genug für professionelle Videobearbeitung. Ebenso entfällt der Einsatz eines präziseren und besser konfigurierbaren Diffusionsmodells, das jedoch die Übereinstimmung mit dem Zielvideo nicht bewahren kann.

Verschiedene prompt-basierte Transformationen von Text2Live.
Frühere Ansätze haben entweder propagationsbasierte Methoden oder optischen Fluss-basierte Ansätze verwendet. Da diese Techniken in irgendeiner Weise framebasiert sind, ist keine von ihnen in der Lage, ein konsistentes zeitliches Erscheinungsbild von Änderungen im Ausgabevideo zu erstellen. Ein neuronaler geschichteter Atlas bietet stattdessen einen einzigen Raum, in dem Änderungen angesprochen werden können, die dann treu zur vorgenommenen Änderung bleiben, während das Video fortschreitet.
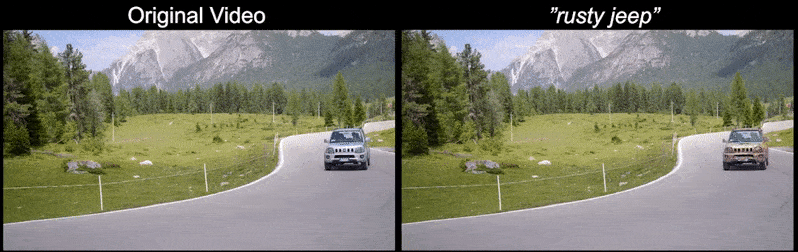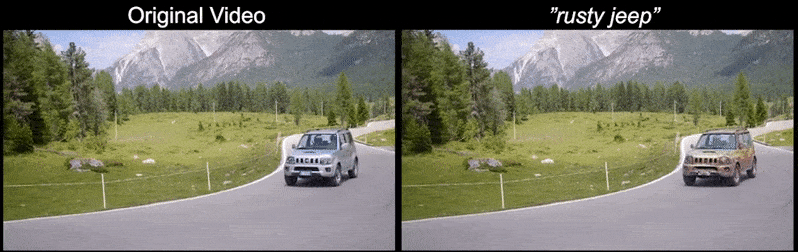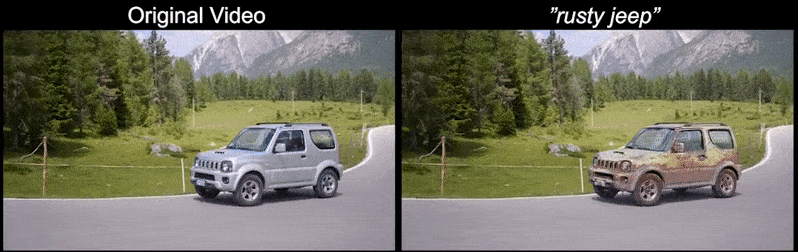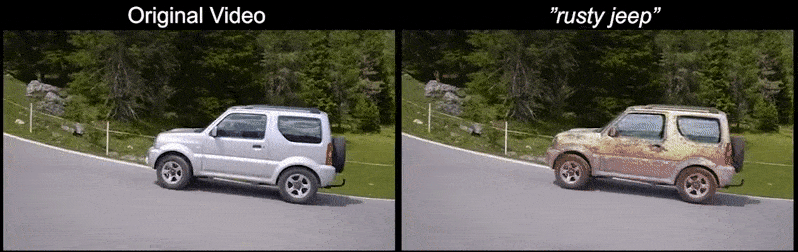
Kein Flimmern oder zufällige Halluzinationen: Text2Live erhält eine Interpretation des Textprompts ‘rostiger Jeep’ und wendet es einmal auf den neuronalen geschichteten Atlas des Autos im Video an, anstatt die Transformation für jeden interpretierten Frame neu zu starten.

Workflow von Text2Lives konsistenter Transformation eines Jeeps in eine rostige Reliquie.
Text2Live kommt einem Durchbruch im KI-basierten Compositing näher als im florierenden Text-zu-Bild-Bereich. Dieser hat durch die Veröffentlichung der zweiten Generation von OpenAIs DALL-E-Framework diese Woche große Aufmerksamkeit erhalten. DALL-E kann Zielbilder in den Transformationsprozess einbeziehen, ist beim direkten Eingriff in ein Foto jedoch weiterhin eingeschränkt. Hinzu kommen die Zensur der ursprünglichen Trainingsdaten und die Anwendung von Filtern, um Missbrauch durch Nutzer zu verhindern.
Stattdessen ermöglicht Text2Live dem Endbenutzer, einen Atlas zu extrahieren und ihn in einem Durchgang in hochkontrollierten pixelbasierten Umgebungen wie Photoshop (und möglicherweise sogar abstrakteren Bildsynthese-Frameworks wie NeRF) zu bearbeiten, bevor er ihn in eine korrekt ausgerichtete Umgebung zurückführt, die dennoch nicht auf 3D-Schätzung oder CGI-Ansätzen, die auf ältere Methoden zurückgreifen basiert.
Im Weiteren behaupten die Autoren, dass Text2Live das erste vergleichbare Framework ist, das Maskierung und Komposition in einer vollständig automatischen Weise erreicht.
Erstveröffentlichung: 7. April 2022.





