
AGI a budoucnost AI
Co je Turingův test a proč je důležitý?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Turingův test vznikl z Alanem Turingem v roce 1950 publikovaného článku “Computing Machinery and Intelligence”. Místo snahy definovat myšlení Turing navrhl napodobovací hru: lidský tazatel vyměňuje psané zprávy s neviditelnými účastníky a rozhoduje, který je člověk a který stroj.
Test zůstává vlivný, protože převádí abstraktní filozofickou otázku na pozorovatelnou interakci. Má však i omezení: působit lidsky v konverzaci není totéž jako být pravdivý, znalý, bezpečný, vědomý nebo obecně inteligentní.
Klíčové poznatky
- Turingova původní napodobovací hra je textový behaviorální test, nikoli seznam vnitřních kognitivních vlastností.
- Výsledky závisí na hodnotiteli, podnětu, délce, instrukcích pro účastníky a pravidlech hodnocení.
- Model může napodobovat lidskou konverzaci, přičemž halucinuje fakta nebo selhává v jednoduchých testech robustnosti.
- Moderní hodnocení vyžaduje úkolové metriky, adversariální testování, lidskou revizi a důkazy specifické pro rizika kromě samotné konverzace.
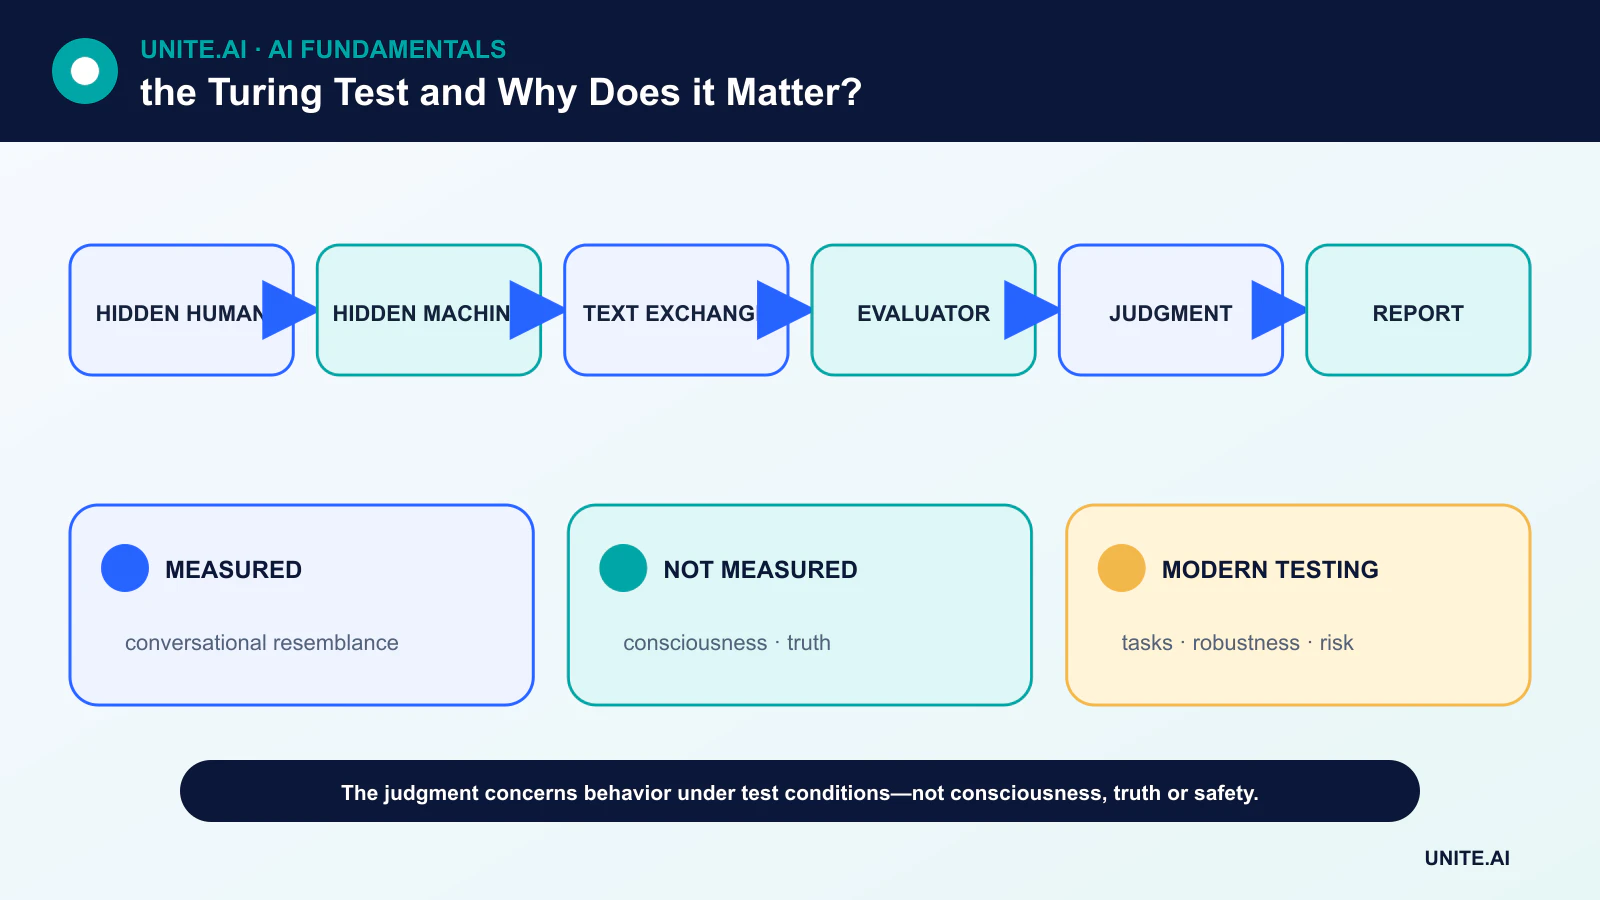
Turingova napodobovací hra
V původním uspořádání tazatel komunikoval na dálku, aby hlas a vzhled neodhalily identitu. Turing se ptal, zda by stroj mohl ve hře podávat dostatečně dobré výkony, aby ho hodnotitel nedokázal spolehlivě odlišit od člověka.
Toto operativní pojetí se vyhnulo nutnosti stanovit jedinou definici myšlení. Neprohlašovalo, že každá přesvědčivá výměna dokazuje inteligenci, a neurčovalo žádný univerzální práh úspěšnosti, který by se vztahoval na jakoukoli pozdější demonstraci chatbotu.
Co výsledek ve skutečnosti měří
Zkouška měří behaviorální nerozlišitelnost za definovaných podmínek. Krátké konverzace, nezkušení hodnotitelé nebo podněty vybrané tvůrcem systému mohou úkol usnadnit. Přesná zpráva by měla uvést výběr přepisů, počet a zázemí hodnotitelů, srovnávací lidi, časový limit a statistickou metodu.
Systém může také využívat očekávání: vyhýbavost, humor, typografické chyby a hraní rolí mohou působit lidsky, aniž by prokazovaly spolehlivé uvažování. Naopak neobvykle formální lidská odpověď může být mylně zařazena jako generovaná strojem.
Co Turingův test neprokazuje
Test přímo neměří vědomí, subjektivní prožitek, faktickou přesnost, kauzální porozumění ani morální odpovědnost. Neodhaluje tréninková data, architekturu modelu ani způsoby selhání mimo konverzaci. Také příliš neříká o nelingvistické inteligenci, jako je fyzické manipulování.
Moderní jazykové systémy jsou postaveny na transformerových neuronových sítích a hlubokém učení, ale jejich plynulé výstupy mohou být stále generovány z naučené statistické struktury místo ověřeného modelu světa.
Jak moderní hodnocení AI rozšiřuje otázku
Současné hodnocení používá odložené úkolové sady, kalibrovanou nejistotu, testy robustnosti, red teaming, kontroly fakticity a studie lidských preferencí. Metrika pro klasifikaci textu může testovat definované chování, zatímco hodnocení založené na scénářích může ověřovat, zda systém dodržuje politiku pod tlakem.
Žádný jediný benchmark neodráží všechny nasazení. Kontaminace testu může uměle zvýšit skóre a statické benchmarky podporují přeučení. Hodnocení by mělo být opakováno, jak se mění modely, data, podněty, nástroje a uživatelské populace.
Proč je test stále důležitý
Turingův test předvídal základní lekci hodnocení AI: posuzovat pozorovatelnou schopnost místo spoléhaní se na tvrzení o vnitřní podstatě. Také nás nutí ptát se, které lidské chování se počítá jako důkaz a jak experimentální nastavení formuje závěr.
Jeho nejlepší moderní využití je jako historická a koncepční referenční úroveň. Úspěch v napodobovací hře může být zajímavý, ale rozhodnutí o nasazení vyžadují důkazy spojené se skutečným úkolem, ovlivněnými uživateli a předvídatelnými škodami.
Co Turingův test měří
Turingova napodobovací hra se ptala, zda může tazatel komunikující přes text spolehlivě rozlišit stroj od člověka. Přetvořila abstraktní debatu o tom, zda stroje myslí, na pozorovatelný konverzační experiment. Test závisí na účastnících, délce, protokolu, tématech a pravidlech hodnocení; neexistuje jednotné univerzální skóre. Úspěch znamená generovat lidské odpovědi v tomto nastavení. Nepřímě měří faktickou přesnost, uvažování, vědomí, autonomii, vnímání, vtělení, spolehlivost ani prospěšné chování v reálném světě.
Lidské napodobování může odměňovat vyhýbavost, personu, chyby, humor nebo manipulaci. Hodnotitel může zaměnit člověka za stroj nebo být ovlivněn očekáváními, jazykem a kulturním kontextem. Krátké konverzace umožňují triky, které selžou při delší interakci. Naopak vysoce užitečný systém pro matematiku, překlad nebo modelování proteinů může selhat, protože se nesnaží vypadat jako člověk. Test tedy měří sociální a jazykovou schopnost formovanou hodnotitelem, nikoli kompletní řazení inteligence.
Moderní jazykové modely a přísnější hodnocení
Velké jazykové modely mohou udržet plynulý dialog predikcí sekvencí z rozsáhlých tréninkových dat a následným doladěním, ale plynulost je slabým důkazem pravdy či porozumění. Zapamatované vzory, přístup k nástrojům, skryté podněty, latence a nastavení vzorkování ovlivňují výsledky. Kontrolovaná hodnocení by měla uvádět model a protokol, zabránit úniku informací, zahrnout adversariální a doménové otázky a hodnotit nejistotu a citace. Demonstrace vybraná z úspěšných konverzací nedokáže odhadnout spolehlivost napříč celým rozsahem použití.
Moderní hodnocení je vícerozměrné: přesnost úkolu, kalibrace, robustnost, dlouhodobá konzistence, bezpečnost, zaujatost, soukromí, zabezpečení, efektivita a lidské výsledky. Behaviorální testy by měly být doplněny o důkazy o procesu, red teaming, reprodukovatelné benchmarky a monitorování v reálném světě. Benchmarky se mohou nasycovat nebo objevit v tréninkových datech, proto jsou potřeba soukromé a aktualizované testovací sady. U systémů, které jednají, je nutné hodnotit oprávnění nástrojů, zotavení a důsledky odděleně od kvality konverzace.
Proč je test stále důležitý
Turingův test zůstává historicky důležitý, protože se soustředí na chování a obtížnost definice inteligence. Také vyvolává trvalé otázky o antropomorfizaci a klamání. Rozhraní by měla identifikovat syntetické agenty místo toho, aby považovala omyl v identitě za úspěch, zejména v důležitých situacích. Používejte test jako filozofický filtr a jeden konverzační test, nikoli certifikaci obecné inteligence či osobnosti. Důležitou otázkou při nasazení je, co systém spolehlivě dokáže, na jakých důkazech a limitech, a kdo nese odpovědnost při selhání.
Praktický příklad: kontrolované konverzační hodnocení
Hodnotitelé porovnávají lidi a několik AI systémů v textových konverzacích s pevně stanovenou délkou, tématy, jazykem a anonymními identitami. Hodnotitelé zaznamenávají, zda považují každého účastníka za člověka, a také hodnotí faktičnost, konzistenci, užitečnost, nejistotu a manipulaci. Více hodnotitelů a konverzací odhaduje variabilitu a protokol zabraňuje vývojářům modelů vybírat příznivé přepisy. Lidské mylné zařazení poskytuje nezbytný základ pro interpretaci výsledku.
Systém, který oklame hodnotitele, ale vymýšlí fakta, není považován za obecně inteligentní, zatímco jasně uvedený specializovaný model může být vysoce užitečný i přes neúspěch v napodobování. Výsledky zahrnují podnět, model, sampler, přístup k nástrojům a charakteristiky hodnotitelů. Experiment je koncipován jako jeden test lidské konverzace. Rozhodnutí o nasazení používají samostatné důkazy o správnosti úkolu, bezpečnosti, soukromí a zotavení a rozhraní identifikuje agenta místo toho, aby klamání proměnilo v cíl produktu.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný výchozí stav a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené či chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny či prostředí, která jsou nejčastěji nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací či nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před nasazením přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí záměrně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu či pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahy výstrah a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Znovu vyhodnocujte, kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy zotavení, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Dosáhl nějaký AI definitivně Turingova testu?
Neexistuje žádná jediná oficiální autorita testu ani univerzálně přijatý protokol. Veřejné demonstrace používají různá pravidla, takže tvrzení o „úspěchu“ nejsou přímo srovnatelné.
Dokazuje selhání v testu, že je systém neinteligentní?
Ne. Specializovaný systém může být vysoce výkonný, aniž by napodoboval lidský konverzační styl.
Primární reference












