
Andersonův úhel
UniTune: alternativní technika neuronové úpravy obrázků od Googlu

 Přidejte Unite.AI mezi své preferované zdroje na Google
Klíčové bodyUniTune dolaďuje difúzní model na jediném obrázku, aby umožnil přesné úpravy řízené…
Zobrazit více
- UniTune dolaďuje difúzní model na jediném obrázku, aby umožnil přesné úpravy řízené textem.
- Na rozdíl od DreamBooth nebo Textual Inversion, UniTune odmítá oba přístupy pro lepší zachování detailů.
- Metoda dosahuje vysoké sémantické oddělitelnosti, přičemž obličeje zůstávají nedotčené během radikálních transformací pozadí.
Google Research, zdá se, útočí na textově založenou editaci obrázků z několika stran a zřejmě čeká, co “uspěje”. Krátce po tomto týdenním vydání jeho práce Imagic, vyhledávací gigant navrhl další latentní difuzní metodu pro provádění jinak nemožných AI-založených editací obrázků pomocí textových příkazů, tentokrát nazvanou UniTune.
Na základě příkladů uvedených v projektu nové práci, UniTune dosáhl mimořádného stupně disentanglement semantické pozice a myšlenky od skutečného obrazového obsahu:

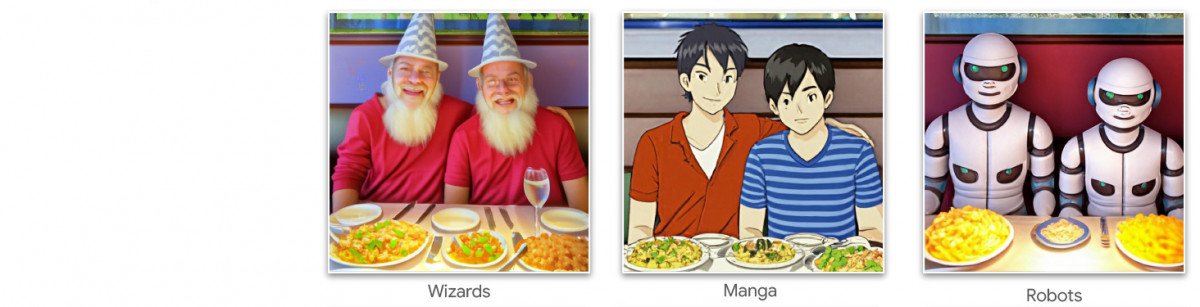

UniTune výborně ovládá sémantickou kompozici. V horní řadě obrázků se obličeje obou lidí nezdeformovaly ani při mimořádné proměně zbytku zdrojového obrázku (vpravo). Source: https://arxiv.org/pdf/2210.09477.pdf
Jak fanoušci Stable Diffusion již vědí, aplikování editací na částečné sekce obrázku bez negativního ovlivnění zbytku obrázku může být obtížnou, někdy nemožnou operací. Ačkoli populární distribuce, jako je AUTOMATIC1111, mohou vytvářet masky pro lokální a omezené editace, proces je zdlouhavý a často nepředvídatelný.
Zjevná odpověď, alespoň pro praktika počítačového vidění, je vložit vrstvu sémantické segmentace, která je schopna rozpoznat a izolovat objekty v obrázku bez zásahu uživatele, a skutečně, byly nedávno spuštěny několik nových iniciativ podél této linie myšlení.
Jinou možností pro uzamčení zmatených a spletených neuronových operací editace obrázků je využití vlivného modulu OpenAI Contrastive Language–Image Pre-training (CLIP) modulu, který je v srdci latentních difuzních modelů, jako je DALL-E 2 a Stable Diffusion, aby jednal jako filtr v okamžiku, kdy text-to-image model je připraven odeslat interpretovaný render zpět uživateli. V tomto kontextu by CLIP měl jednat jako stráž a modul kvality, odmítající nesprávné nebo jinak nevhodné vykreslené obrazy. To je brzy zavedeno (Discord link) na Stability.ai’s DreamStudio API-driven portálu.
Nicméně, protože CLIP je zřejmě jak viníkem, tak řešením v takové situaci (protože to také informovalo o tom, jak byl obrázek vyvinut), a protože hardwarové požadavky mohou překročit to, co je pravděpodobně dostupné místně pro koncového uživatele, tento přístup nemusí být ideální.
Komprimovaný jazyk
Navrhovaný UniTune místo toho “jemně ladí” existující difuzní model – v tomto případě, vlastní model Googlu Imagen, ačkoli výzkumníci uvádějí, že metoda je kompatibilní s jinými latentními difuzními architekturami – aby se vložil jedinečný token, který lze vyvolat zadáním do textového příkazu.
Na první pohled to zní jako Google DreamBooth, který je v současnosti posedlostí mezi fanoušky a vývojáři Stable Diffusion, a který může vložit nové postavy nebo objekty do existujícího kontrolního bodu, často za méně než hodinu, na základě pouhých několika zdrojových obrázků; nebo jako Textual Inversion, který vytváří “sidecar” soubory pro kontrolní bod, které jsou poté zpracovávány, jako kdyby byly původně vyškoleny do modelu, a mohou využít modelových vlastních rozsáhlých zdrojů, modifikujících jeho textový klasifikátor, což vede k malému souboru (ve srovnání s minimálními 2GB prořezanými kontrolními body DreamBooth).
Ve skutečnosti výzkumníci tvrdí, že UniTune odmítl obě tyto přístupy. Zjistili, že Textual Inversion vynechal příliš mnoho důležitých detailů, zatímco DreamBooth ‘fungoval hůře a trval déle’ než řešení, na které se nakonec usadil.
Nicméně, UniTune používá stejný zapouzdřený sémantický “metaprompt” přístup jako DreamBooth, s trénovanými změnami vyvolanými jedinečnými slovy vybranými trenérem, které nebudou kolidovat s žádnými termíny, které již existují v s velkým úsilím natrénovaném veřejném modelu.
QUOTEOPEN‘Chcete-li provést editační operaci, vzorkujeme jemně laděné modely s promptem “[rare_tokens] edit_prompt” (například “beikkpic dva psi v restauraci” nebo “beikkpic mimoň”).’QUOTECLOSE
Proces
Je záhadou, proč Google během jediného týdne vydal dvě práce s téměř stejnou výslednou funkčností. Přes mnoho podobností se však UniTune a Imagic jasně liší: Imagic řídí úpravy pomocí „nekomprimovaných“ zadání v přirozeném jazyce, zatímco UniTune trénuje jedinečné tokeny ve stylu DreamBooth. Pokud byste tedy v Imagic chtěli provést takovou změnu…

Z práce UniTune: metoda se srovnává se SDEdit, oblíbeným konkurenčním neuronovým editačním rámcem Googlu. Výsledky UniTune jsou zcela vpravo, zatímco odhadovaná maska je na druhém obrázku zleva.
…v Imagic byste zadali „třetí osoba sedící v pozadí jako roztomilá chlupatá příšera“. Ekvivalentní příkaz UniTune by byl „Muž vzadu jako [x]“, kde x označuje zvláštní jedinečné slovo přiřazené jemně doladěnému konceptu chlupaté příšery. Zatímco DreamBooth nebo Textual Inversion dostávají více obrázků, aby vytvořily abstrakci ve stylu deepfake vyvolatelnou v mnoha pózách, UniTune a Imagic dostávají jediný obrázek: původní, nedotčený originál. Připomíná to editory založené na GAN z posledních let, které převádějí vstupní obrázek na kódy v latentním prostoru GAN a posílají je do jiných oblastí prostoru pro úpravu (například projekci mladého tmavovlasého člověka přes kódy „starý“ nebo „blond“). V difuzním modelu jsou ale výsledky této metody ve srovnání překvapivě přesné a mnohem méně nejednoznačné. 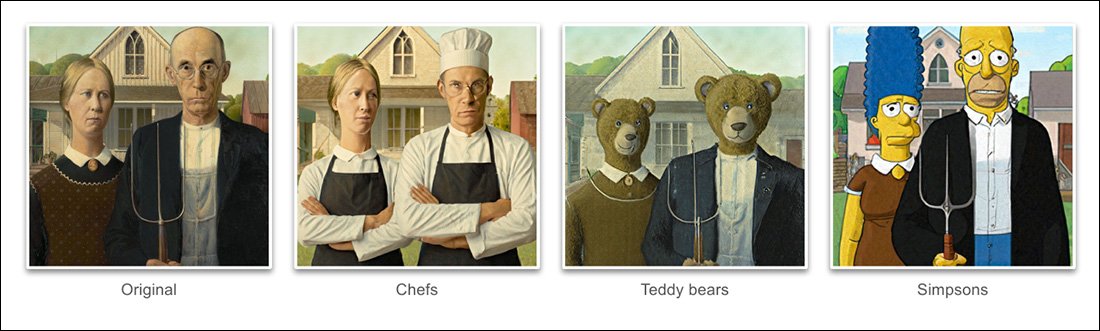
Proces jemného doladění
Metoda UniTune esenciálně pošle původní obrázek skrz difuzní model s sadou instrukcí, jak by měl být modifikován, pomocí rozsáhlých repozitářů dostupných dat vyškolovaných do modelu. Ve skutečnosti můžete to udělat právě teď se Stable Diffusion’s img2img funkcionalitou – ale ne bez ohnutí nebo nějakého změny částí obrázku, které byste raději udrželi.
Během procesu UniTune je systém jemně laděn, což znamená, že UniTune nutí model, aby obnovil trénink, s většinou jeho vrstev nezmražených (viz níže). Ve většině případů bude jemné ladění tankovat celkové obecné ztrátové hodnoty vysoce výkonného modelu ve prospěch vkládání nebo rafinování některých jiných aspektů, které jsou požadovány k vytvoření nebo vylepšení.
Nicméně, s UniTune se zdá, že modelová kopie, která je ovlivněna, ačkoli může vážit několik gigabajtů nebo více, bude považována za jednorázovou pomocnou „slupku“, a odstraněna na konci procesu, poté, co sloužila jednomu cíli. Tento druh náhodného datového tonáže se stává všedním úložným krizí pro fanoušky DreamBooth, jejichž vlastní modely, i když prořezané, nejsou menší než 2GB na subjekt.
Stejně jako u Imagic, hlavní ladění v UniTune probíhá v nižších dvou ze tří vrstev v Imagen (základní 64px, 64px>256px a 256px>1024px). Na rozdíl od Imagic, výzkumníci vidí určitou potenciální hodnotu v optimalizaci ladění také pro tuto poslední a největší super-rozlišení vrstvu (ačkoli dosud se o to nepokusili).
Pro nejnižší 64px vrstvu je model zkreslen směrem k základnímu obrázku během tréninku, s několika duplikovanými páry obrázku/textu, které jsou vloženy do systému pro 128 iterací při velikosti batch 4, a s Adafactor jako ztrátová funkce, pracující na rychlosti učení 0,0001. Ačkoli pouze enkodér T5 je zmrazen během tohoto jemného ladění, je také zmrazen během primárního tréninku Imagen
Tato operace je poté opakovaná pro 64>256px vrstvu, pomocí stejné procedury šumu, která byla použita v původním tréninku Imagen.
Vzorkování
Existuje mnoho možných vzorkovacích metod, kterými lze vyvolat změny provedené z jemně laděného modelu, včetně Classifier Free Guidance (CFG), který je hlavní součástí Stable Diffusion. CFG v zásadě definuje rozsah, ve kterém model může “sledovat svou představivost” a prozkoumat renderovací možnosti – nebo naopak, při nižších nastaveních, rozsah, ve kterém by se měl držet vstupních dat a provádět méně rozsáhlé nebo dramatické změny.

Stejně jako Textual Inversion (o něco méně DreamBooth) umožňuje UniTune aplikovat na původní obrázky osobité grafické styly i fotorealističtější úpravy.
Výzkumníci také experimentovali se SDEdit a jeho technikou „pozdního startu“, kde systém je povzbuzen k zachování původních detailů tím, že je pouze částečně “šum” z počátku, ale spíše zachovává své základní charakteristiky. Ačkoli výzkumníci použili tuto techniku pouze na nejnižší vrstvě (64px), věří, že by to mohlo být užitečné pomocné vzorkovací technika v budoucnu.
Výzkumníci také využili prompt-to-prompt jako další textovou techniku k podmínění modelu:
QUOTEOPEN‘V nastavení „prompt to prompt“ se nám technika nazvaná Prompt Guidance osvědčila zejména pro ladění věrnosti a expresivity. QUOTECLOSEQUOTEOPEN‘Prompt Guidance se podobá Classifier Free Guidance, ale základem je jiný prompt namísto nepodmíněného modelu. Tím model směřuje k rozdílu mezi oběma prompty.’QUOTECLOSE

Prompt-to-prompt v UniTune účinně odděluje oblasti určené ke změně.
Nicméně, prompt guidance, autoři uvádějí, byl potřebný pouze příležitostně v případech, kdy CFG selhal při získání požadovaného výsledku.
Jinou novou vzorkovací přístup, který se udál během vývoje UniTune, byla interpolace, kde oblasti obrázku jsou dostatečně odlišné, že původní a změněný obrázek jsou velmi podobné ve složení, což umožňuje použití více “naivnější” interpolace.

Interpolace může učinit vyšší úsilí procesy UniTune redundantními v případech, kdy jsou oblasti k transformaci diskrétní a dobře ohraničené.
Autoři navrhují, že interpolace by mohla potenciálně fungovat tak dobře, že by mohla být použita jako výchozí nastavení, a pozorují také, že má sílu provést mimořádné transformace v případech, kdy komplexní překrytí nemusí být řešena intenzivnějšími metodami.
UniTune může provádět lokální editace s nebo bez editačních masek, ale může také rozhodnout jednostranně, kde umístit editace, s neobvyklou kombinací interpretační moci a robustní esencializace vstupních dat:

V horním obrázku ve druhé sloupci, UniTune, který byl pověřen vložením ‘červeného vlaku na pozadí’, umístil jej do vhodné a autentické pozice. Pozorujte v ostatních příkladech, jak je zachována semantická integrita původního obrázku, i uprostřed mimořádných změn v pixelovém obsahu a jáderných stylech obrázků.
Latence
Ačkoli první iterace nového systému bude pomalá, a ačkoli je možné, že buď komunitní zapojení nebo firemní závazek (obvykle není obojí) nakonec urychlí a optimalizuje zdrojově náročnou rutinu, obě UniTune a Imagic provádějí některé docela významné strojové učící manévry, aby vytvořily tyto úžasné editace, a je otázkou, do jaké míry takový zdrojově náročný proces mohl být někdy škálován dolů pro domácí použití, spíše než API-driven přístup (ačkoli druhý může být více žádoucí pro Google).
V současné době je doba oběhu od vstupu k výsledku asi 3 minuty na T4 GPU, s přibližně 30 sekundami navíc pro inference (jako u každé inference rutiny). Autoři uznávají, že jde o vysokou latenci, a že jen stěží se kvalifikuje jako “interaktivní”, ale také poznamenávají, že model zůstává k dispozici pro další editace, až do okamžiku, kdy uživatel dokončí proces, což snižuje dobu na editaci.
První publikováno 21. října 2022.


