
Andersonův úhel
AI‑asistovaná úprava objektů s Imagic od Googlu a funkcí „Erase and Replace“ od Runway

 Přidejte Unite.AI mezi své preferované zdroje na Google

Tento týden dva nové, ale kontrastní algoritmy poháněné AI pro grafiku nabízejí uživatelům inovativní způsoby, jak provádět vysoce detailní a účinné úpravy objektů na fotografiích.
Prvním je Imagic od Google Research ve spolupráci s izraelským Technologickým institutem a Weizmannovým institutem vědy. Imagic umožňuje textově podmíněnou, detailní úpravu objektů pomocí doladění difúzních modelů.

Změňte, co se vám líbí, a nechte zbytek – Imagic slibuje detailní úpravu pouze částí, které chcete změnit. Zdroj: https://arxiv.org/pdf/2210.09276.pdf
Kdokoli, kdo se někdy pokusil změnit jen jeden prvek v novém rendru Stable Diffusion, dobře ví, že za každou úspěšnou úpravou systém změní ještě pět věcí, které se vám původně líbily. Jedná se o nedostatek, který v současnosti nutí mnoho nejnadanějších nadšenců do Stable Diffusion neustále přepínat mezi ním a Photoshopem, aby opravili takzvané „vedlejší poškození“. Už z tohoto úhlu pohledu jsou úspěchy Imagic pozoruhodné.
V době psaní článku Imagic ještě nemá ani propagační video a vzhledem k opatrnému postoji Googlu k uvolňování neomezených nástrojů pro syntézu obrázků není jasné, do jaké míry – pokud vůbec – budeme mít možnost systém vyzkoušet.
Druhou nabídkou je spíše přístupnější funkce Erase and Replace od Runway ML, nová funkce v sekci „AI Magic Tools“ jejich výhradně online sady nástrojů pro vizuální efekty založených na strojovém učení.
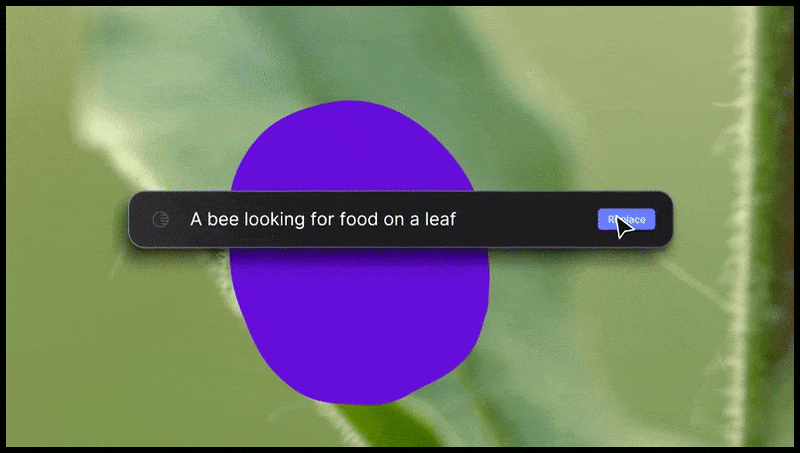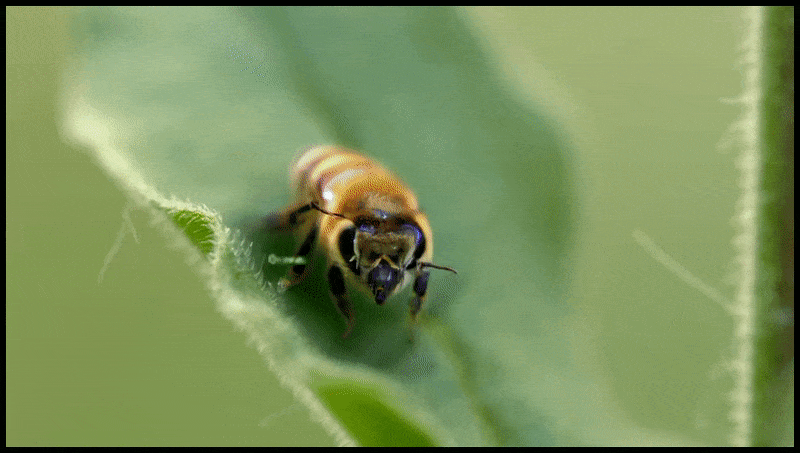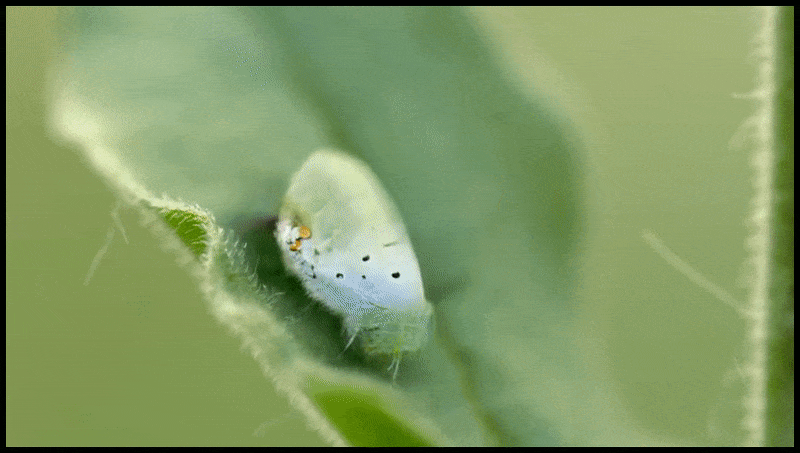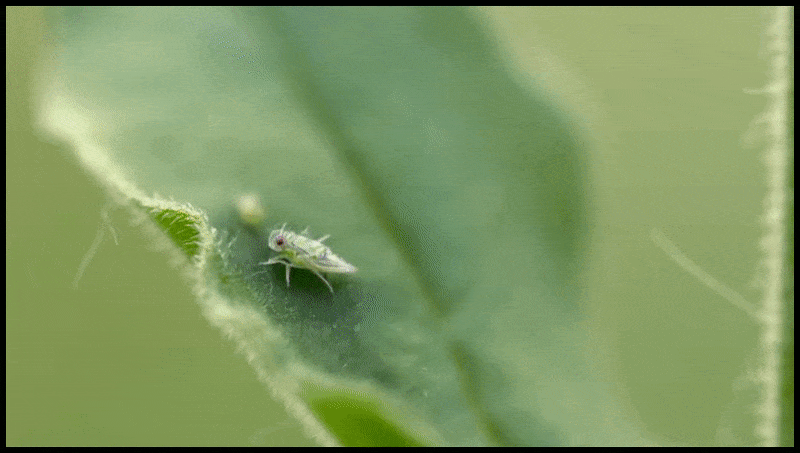
Funkce Erase and Replace od Runway ML, již viditelná v náhledu systému pro úpravu text‑to‑video.
Podívejme se nejprve na nabídku Runway.
Erase and Replace
Stejně jako Imagic, Erase and Replace pracuje výhradně se statickými obrázky, i když Runway předvedl stejnou funkci v řešení pro úpravu text‑to‑video, které zatím nebylo vydáno:
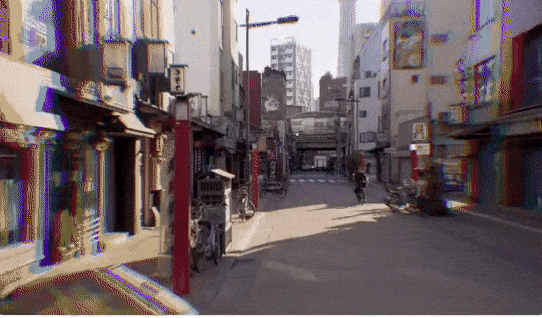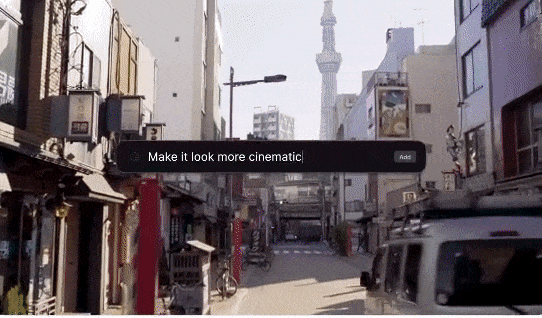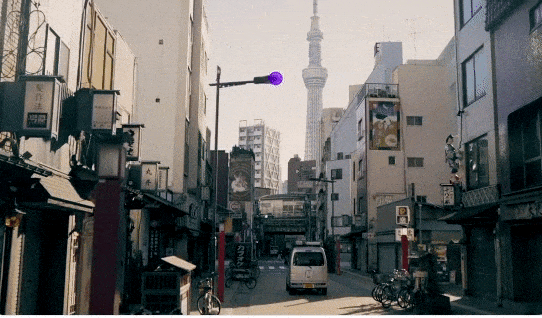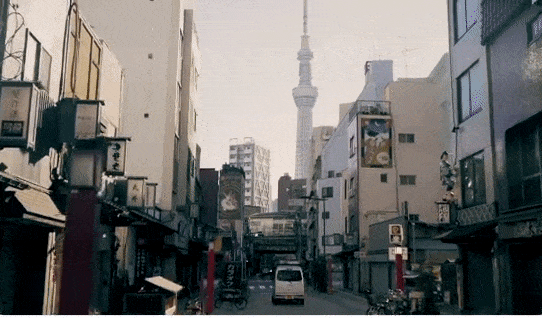
I když si každý může vyzkoušet novou funkci Erase and Replace na obrázcích, verze pro video zatím není veřejně dostupná. Zdroj: https://twitter.com/runwayml/status/1568220303808991232
Ačkoliv Runway ML nezveřejnil podrobnosti o technologiích stojících za Erase and Replace, rychlost, s jakou lze nahradit pokojovou rostlinu poměrně přesvědčivou bustou Ronalda Reagana, naznačuje, že motor, který v Erase and Replace přetváří vámi zvolený objekt, je difúzní model jako Stable Diffusion (nebo, méně pravděpodobně, licencovaný DALL‑E 2).

Nahrazení pokojové rostliny bustou The Gipper není tak rychlé jako toto, ale je poměrně rychlé. Zdroj: https://app.runwayml.com/
Systém má některá omezení typu DALL‑E 2 – obrázky nebo text, které spustí filtry Erase and Replace, vyvolají varování o možném pozastavení účtu v případě dalších porušení – prakticky jde o standardní kopii probíhajících zásad OpenAI pro DALL‑E 2.
Mnoho výsledků postrádá typické hrubé okraje Stable Diffusion. Runway ML jsou investory a výzkumnými partnery v SD a je možné, že vycvičili proprietární model, který je lepší než open‑source váhy checkpointu 1.4, s nimiž se ostatní nyní potýkají (mnoho dalších vývojových týmů, amatérů i profesionálů, také v současnosti trénuje nebo doladí modely Stable Diffusion).
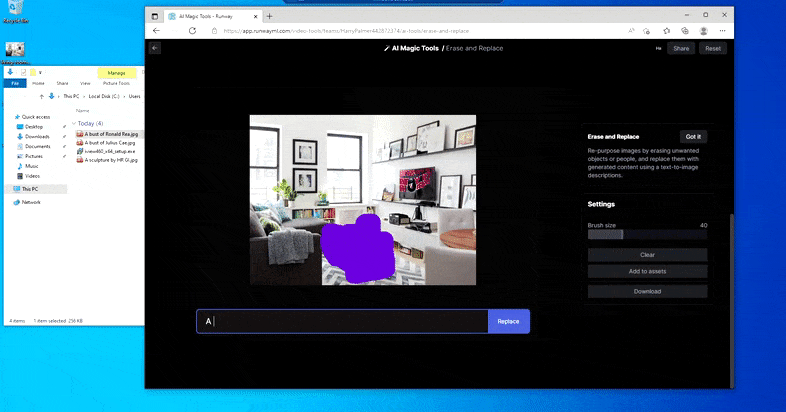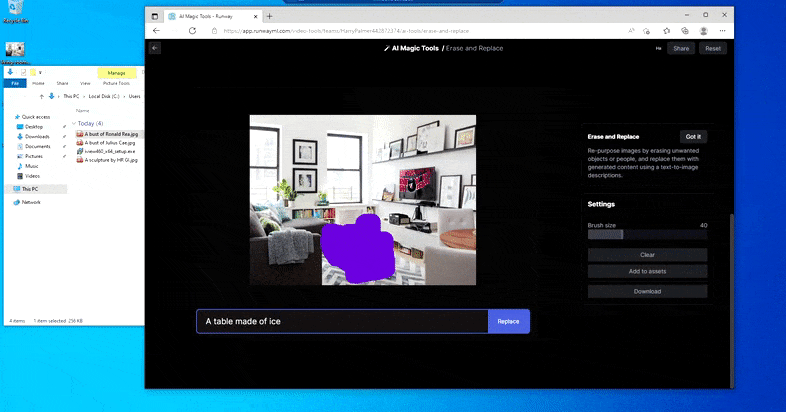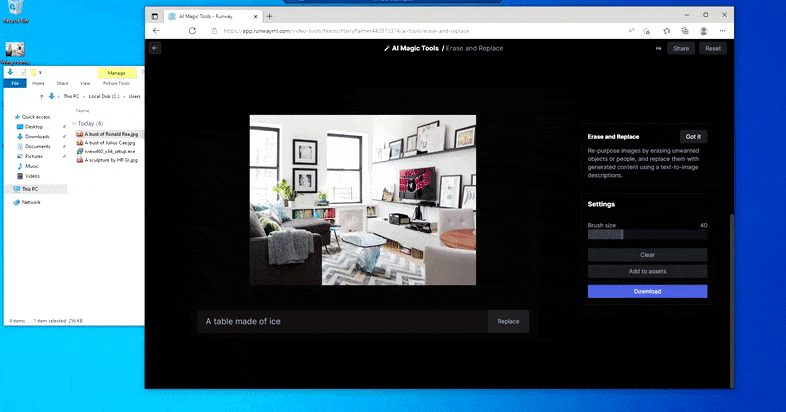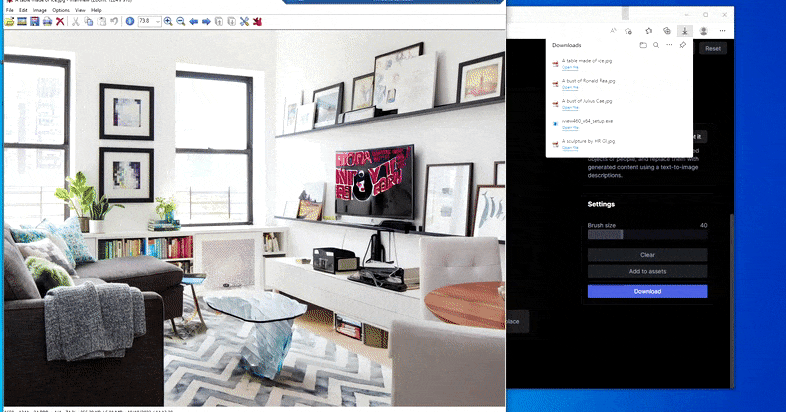
Nahrazení domácího stolu ‘stolem z ledu’ v Erase and Replace od Runway ML.
Stejně jako Imagic (viz níže) je Erase and Replace jaksi „orientováno na objekty“ – nelze jen vymazat „prázdnou“ část obrázku a doplnit ji výsledkem vašeho textového zadání; v takovém scénáři systém jednoduše vyhledá nejbližší zjevný objekt podél linie masky (například zeď nebo televizi) a transformaci provede tam.
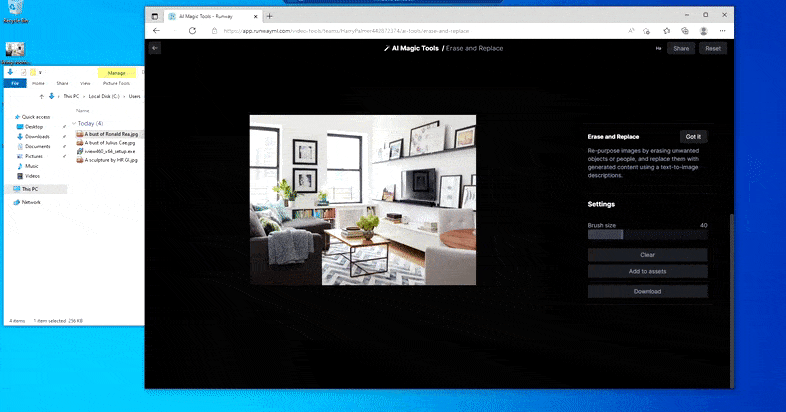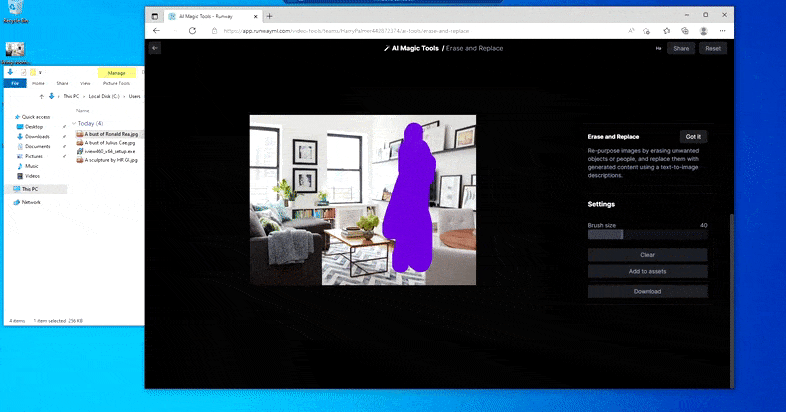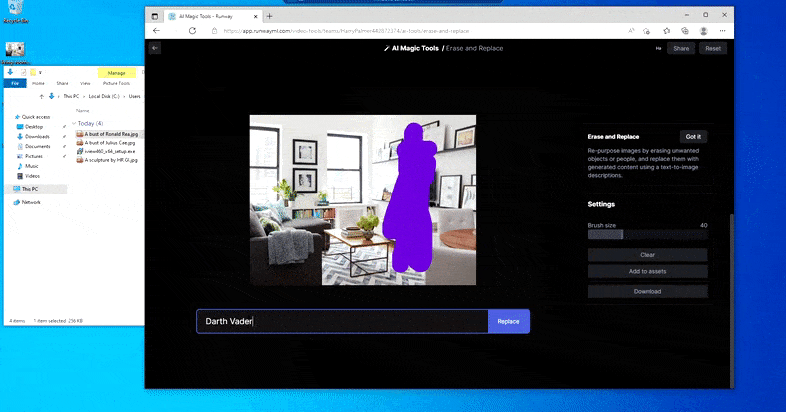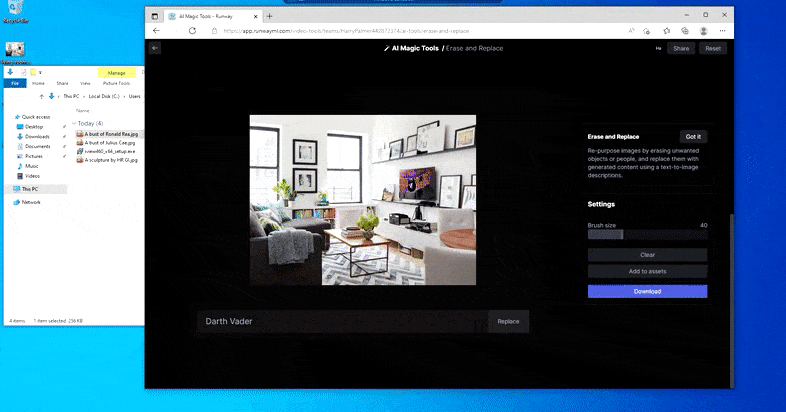
Jak název napovídá, v Erase and Replace nelze vkládat objekty do prázdného prostoru. Zde se pokus o vyvolání nejznámějšího Sithského lorda proměnil v podivnou nástěnnou malbu s Vaderem na televizi, zhruba tam, kde byla zakreslena oblast „replace“.
Je těžké říci, zda se Erase and Replace vyhýbá používání chráněných obrázků (které jsou stále do značné míry blokovány, i když s různou úspěšností, v DALL‑E 2), nebo zda model používaný v backendovém renderovacím enginu prostě není na takové úlohy optimalizován.

Mírně NSFW nástěnná malba „Mural of Nicole Kidman“ naznačuje, že (pravděpodobně) difúzní model postrádá dřívější systematické odmítání DALL‑E 2 při renderování realistických tváří nebo erotického obsahu, zatímco výsledky pokusů o zobrazení chráněných děl se pohybují od nejasného („xenomorph“) po absurdní („železný trůn“). Vpravo dole je zdrojový obrázek.
Bylo by zajímavé zjistit, jaké metody Erase and Replace používá k izolaci objektů, které dokáže nahradit. Předpokládá se, že obrázek prochází nějakou odvozenou verzí CLIP, přičemž jednotlivé položky jsou identifikovány rozpoznáním objektů a následnou sémantickou segmentací. Žádná z těchto operací v běžné instalaci Stable Diffusion nefunguje tak dobře.
Nic však není dokonalé – někdy se systém zdá spíše vymazat než nahradit, i když (jak jsme viděli na obrázku výše) podkladový renderovací mechanismus jasně rozumí textovému zadání. V tomto případě je nemožné proměnit konferenční stolek v xenomorfa – stolek se prostě jen ztratí.
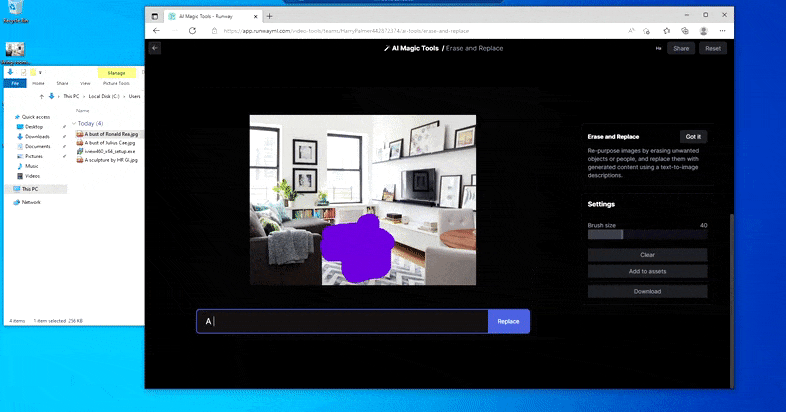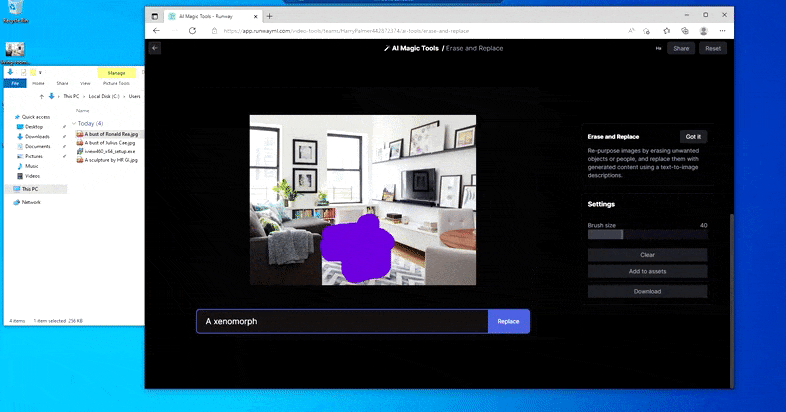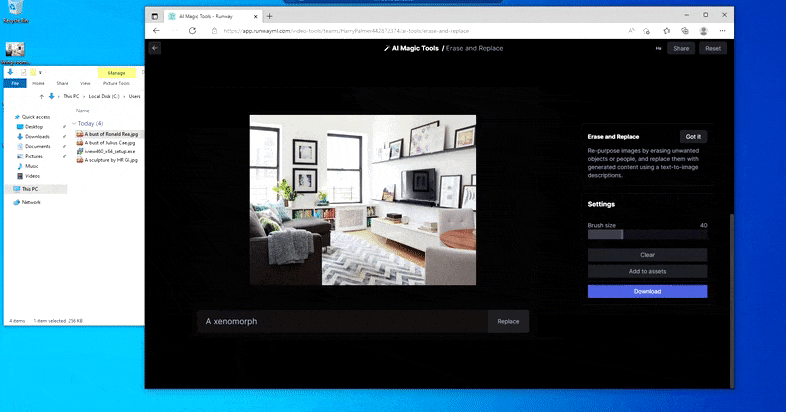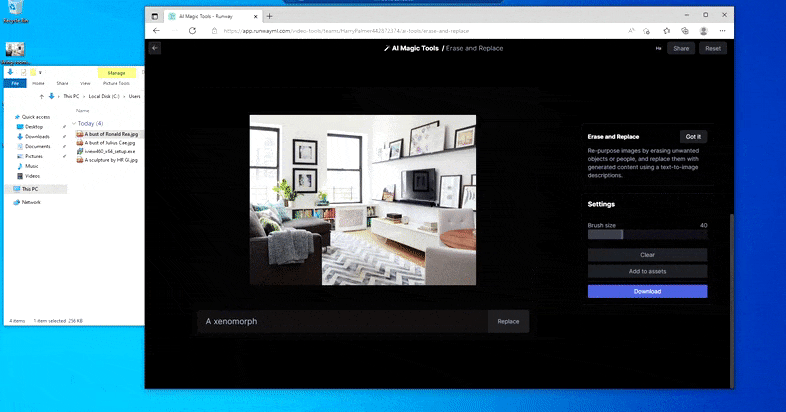
Strašidelnější verze „Kde je Waldo“, když Erase and Replace nedokáže vytvořit mimozemšťana.
Erase and Replace se jeví jako účinný systém pro nahrazování objektů s vynikajícím doplňováním. Nicméně nedokáže upravovat již existující vnímané objekty, pouze je nahrazuje. Skutečná změna existujícího obsahu obrázku bez narušení okolního materiálu je pravděpodobně mnohem obtížnější úkol, úzce spjatý s dlouhým bojem výzkumné komunity počítačového vidění o disentanglement v různých latentních prostorech populárních rámců.
Imagic
Právě tento úkol Imagic řeší. Nový článek nabízí řadu příkladů úprav, které úspěšně mění jednotlivé části fotografie, zatímco zbytek obrazu zůstává nedotčený.

U Imagic neupravené obrázky netrpí charakteristickým roztažením, deformací a „hádaním zakrytí“, typickým pro deepfake loutkování, které využívá omezené předpoklady odvozené z jediného obrazu.
Systém používá třífázový proces – optimalizaci textových embeddingů, doladění modelu a nakonec generování upraveného obrazu.

Imagic zakóduje cílový textový prompt pro získání počátečního textového embeddingu a poté optimalizuje výsledek, aby získal vstupní obrázek. Následně je generativní model doladěn na zdrojový obrázek, přidává se řada parametrů a poté se podrobí požadované interpolaci.
Není překvapením, že rámec vychází z architektury text‑to‑video Imagen od Googlu, i když výzkumníci uvádějí, že principy systému jsou obecně použitelné i na latentní difúzní modely.
Imagen používá tříúrovňovou architekturu, na rozdíl od sedmúrovňového uspořádání použitého ve společnosti pro její novější iteraci text‑to‑video softwaru. Tři odlišné moduly zahrnují generativní difúzní model pracující při rozlišení 64 × 64 px; model super‑rozlišení, který tento výstup zvětší na 256 × 256 px; a další model super‑rozlišení, který výstup posune až na rozlišení 1024 × 1024 px.
Imagic zasahuje v nejranější fázi tohoto procesu, optimalizuje požadovaný textový embedding ve fázi 64 px pomocí Adam optimalizátoru s konstantní učební rychlostí 0,0001.
Mistrovská ukázka disentanglementu: uživatelé, kteří se pokoušeli změnit něco tak jednoduchého jako barvu renderovaného objektu v difúzním, GAN nebo NeRF modelu, ocení, jak významné je, že Imagic dokáže provádět takové transformace bez „roztrhání“ konzistence zbytku obrazu.
Doladění pak probíhá na základním modelu Imagen, po dobu 1500 kroků na vstupní obrázek, podmíněné revidovaným embeddingem. Současně je paralelně optimalizována sekundární vrstva 64 px → 256 px na podmíněném obrázku. Výzkumníci poznamenávají, že podobná optimalizace pro finální vrstvu 256 px → 1024 px má „málo či žádný vliv“ na konečné výsledky, a proto ji neimplementovali.
Článek uvádí, že optimalizační proces trvá přibližně osm minut na každý obrázek na dvojicích čipů TPUV4. Finální render probíhá v jádru Imagen podle schématu vzorkování DDIM.
Stejně jako u podobných procesů doladění pro Googlový DreamBooth, lze výsledné embeddingy také využít k stylizaci i k fotorealistickým úpravám, které čerpají informace ze širší podkladové databáze napájející Imagen (protože, jak ukazuje první sloupec níže, zdrojové obrázky neobsahují žádný z potřebných prvků pro provedení těchto transformací).
Pomocí Imagic lze vyvolat flexibilní fotorealistické pohyby a úpravy, zatímco odvozené a disentanglované kódy získané během procesu lze stejně snadno použít pro stylizovaný výstup.
Výzkumníci porovnali Imagic s předchozími pracemi SDEdit, GAN‑založeným přístupem z roku 2021, vzniklým ve spolupráci Stanfordské univerzity a Carnegie Mellon University; a Text2Live, spoluprací z dubna 2022 mezi Weizmannovým institutem vědy a NVIDIA.
Vizuální srovnání mezi Imagic, SDEdit a Text2Live.
Je zřejmé, že předchozí přístupy mají potíže, ale ve spodním řádku, kde jde o zásadní změnu pózy, stávající metody zcela selhávají při přepracování zdrojového materiálu, zatímco Imagic dosahuje pozoruhodného úspěchu.
Požadavky Imagic na zdroje a doba tréninku na jeden obrázek, ačkoliv jsou ve srovnání s takovými snahami krátké, z něj dělají nepravděpodobnou součást lokální aplikace pro úpravu obrázků na osobních počítačích – a není jasné, do jaké míry by proces doladění šel zmenšit na úroveň spotřebitelských zařízení.
V současném stavu je Imagic působivou nabídkou, která je spíše vhodná pro API – prostředí, ve kterém se Google Research, opatrný vůči kritice za usnadňování deepfakingu, pravděpodobně cítí nejpohodlněji.
Poprvé publikováno 18. října 2022.


