
Основи ШІ
Що таке отруєння даних? Як зловмисники спотворюють моделі ШІ та набори даних
Отруєння даних полягає в маніпулюванні навчальними даними, даними для донавчання, оцінювання або пошуку, щоб система ШІ засвоїла спотворену поведінку або видавала результати, вибрані зловмисником. У цьому посібнику пояснено механізм, компроміси, методи оцінювання та засоби контролю, важливі на практиці.

 Додайте Unite.AI до бажаних джерел у Google
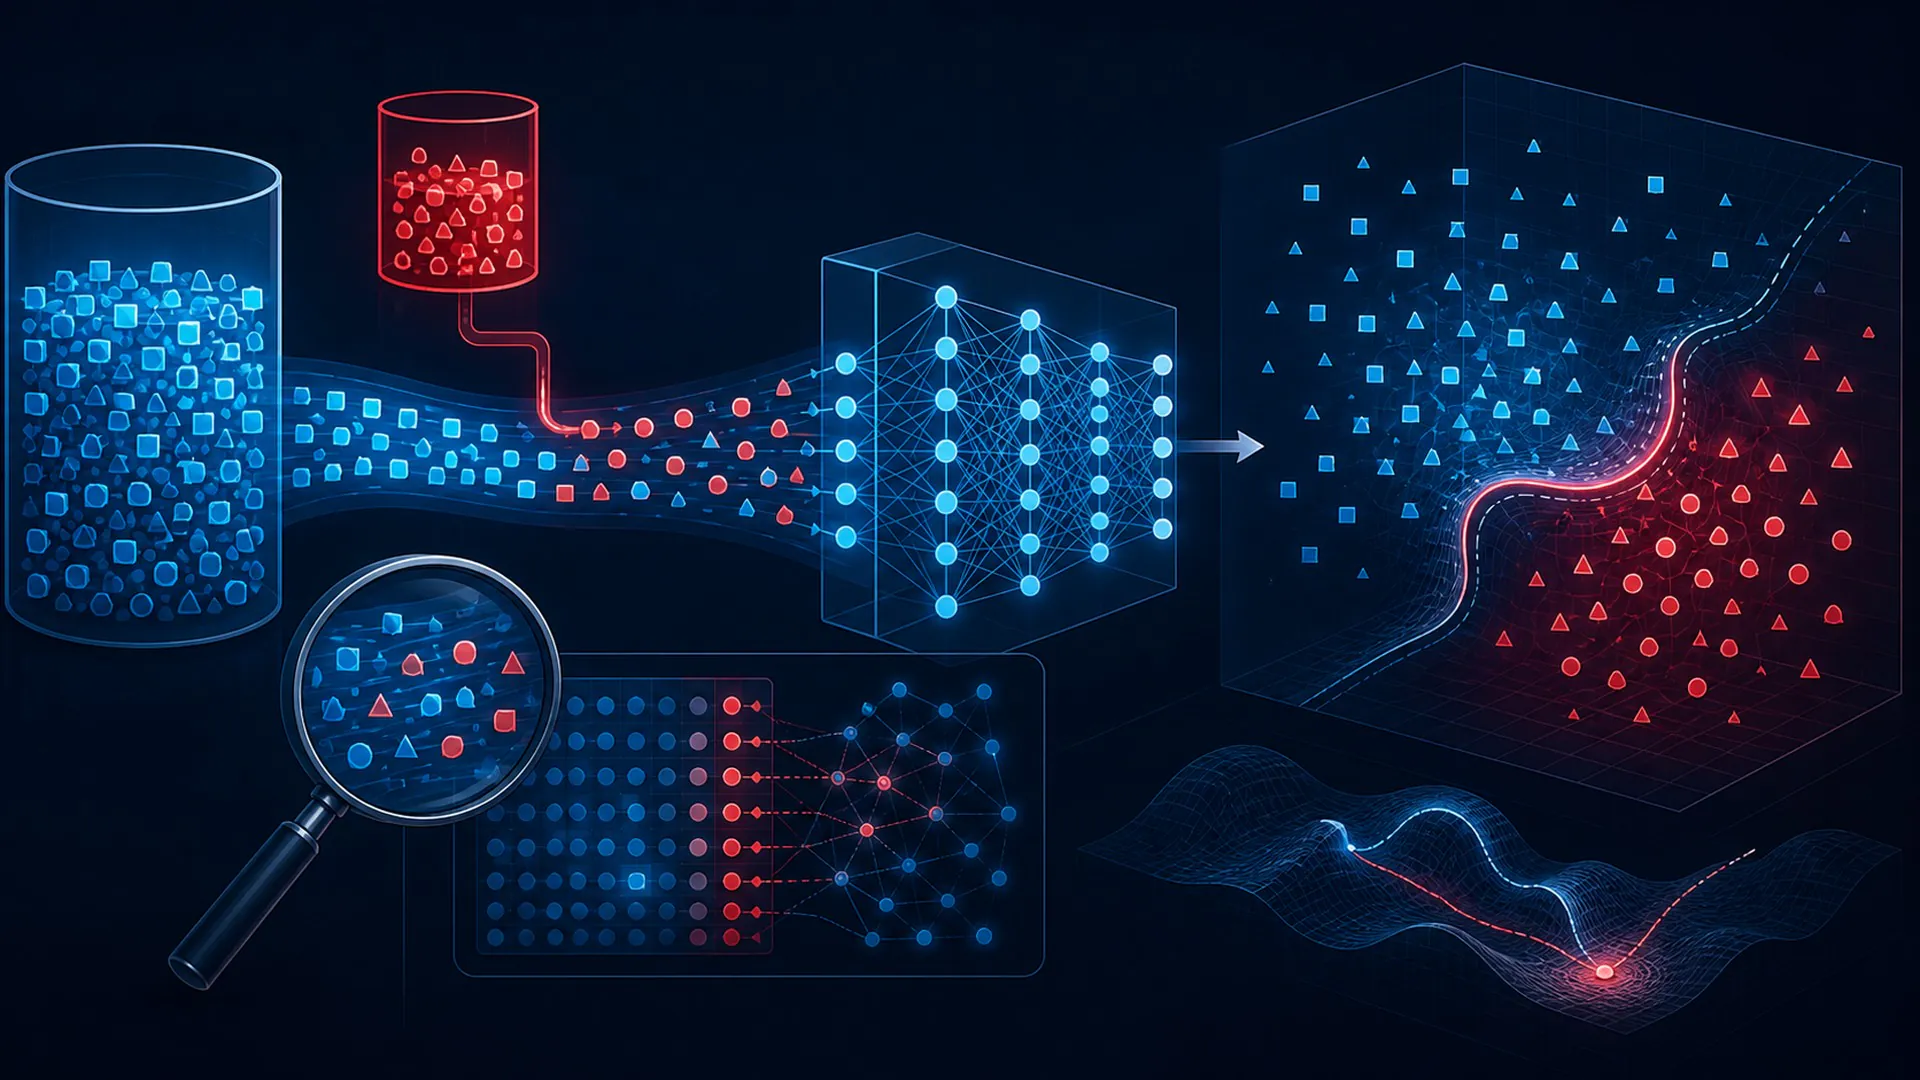
Отруєння даних передбачає маніпулювання даними для навчання, донавчання, оцінювання або пошуку, щоб система ШІ засвоїла спотворену поведінку або видавала результати, обрані зловмисником.
Отруєння даних потребує точного пояснення, адже ця назва позначає конкретний потік інформації, вибір способу навчання, механізм під час роботи системи або межу управління. Якщо вважати цей термін синонімом «передового ШІ», твердження стає неможливо перевірити. У цьому посібнику ми простежимо шлях поняття від вхідних даних і припущень до спостережуваного результату, а потім перевіримо спрощене пояснення, яке найчастіше з ним плутають.
Отруєння даних: визначення, межі та мета
Отруєння даних передбачає маніпулювання даними для навчання, донавчання, оцінювання або пошуку, щоб система ШІ засвоїла спотворену поведінку або видавала результати, обрані зловмисником. Це визначення містить три практичні умови: можна ідентифікувати вхідні дані; наявне перетворення або рішення, характерне для отруєння даних; і є результат, який можна оцінити відповідно до визначеної мети. Якщо бракує хоча б одного з цих елементів, цей термін може описувати радше намір, ніж реалізований механізм.
Довіра до ШІ потребує доказів на всіх етапах життєвого циклу. Засіб контролю має значення лише тоді, коли чітко визначено відповідального за нього, сферу застосування, умови спрацьовування, очікувану поведінку та спосіб перевірки. Для отруєння даних важливо розглядати систему в цілому, адже на її роботу можуть впливати навколишні дані, інтерфейси, обладнання, дозволи й люди, навіть якщо сама модель не змінюється. Тому корисне пояснення має розділяти засвоєну моделлю поведінку та продукт, який визначає, коли, де й із якими повноваженнями її застосовують.
Найближче оманливе спрощення — атака ухилення, яку застосовують лише після розгортання моделі. Вона може мати помітну спільну ознаку з отруєнням даних, але змінює причинно-наслідкову картину: для підтвердження успіху потрібні будуть інші докази, на витрати найбільше впливатимуть інші ресурси, а для запобігання шкоді знадобляться інші засоби контролю. Отже, межа тут визначається практичними відмінностями, а не термінологією.
П’ять етапів отруєння даних
Діаграма — це стислий причинно-наслідковий план отруєння даних, а не твердження, що кожна реалізація складається з п’яти програмних компонентів. Деякі системи поєднують етапи, а інші повторюють їх циклічно. Цей план корисний, бо вимагає, щоб для кожної зміни інформації або повноважень були визначені відповідальний, вхідні дані, результат і спосіб перевірки.
1. Отримати вплив на джерело даних: вхідні дані та припущення при отруєнні даних
На цьому етапі отруєння даних система має отримати вплив на джерело даних. Важливо запитати не лише, чи відбувається ця операція, а й яку інформацію вона використовує, який стан змінює та які докази підтверджують правомірність цієї зміни. Фахівець, який проводить перевірку, має вміти відрізнити цю операцію від атаки ухилення, яку застосовують лише після розгортання моделі, і відтворити її результат за тих самих визначених умов.
Передавання даних на цей етап отруєння даних починається з визначеної мети й має завершитися результатом, який дасть змогу додати неправильно позначені, упереджені або такі, що містять тригер, приклади. Фіксуйте невизначеність, відхилені альтернативи, використані ресурси, а також будь-який людський або програмний контроль на цьому етапі. За цим журналом команди можуть виявити, чи може невелику цільову підмножину бути важко помітити в даних у масштабах вебу, перш ніж та сама вразливість вплине на важливий результат.
2. Додати неправильно позначені, упереджені або такі, що містять тригер, приклади: подання або рішення при отруєнні даних
На цьому етапі отруєння даних система має додати неправильно позначені, упереджені або такі, що містять тригер, приклади. Важливо запитати не лише, чи відбувається ця операція, а й яку інформацію вона використовує, який стан змінює та які докази підтверджують правомірність цієї зміни. Фахівець, який проводить перевірку, має вміти відрізнити цю операцію від атаки ухилення, яку застосовують лише після розгортання моделі, і відтворити її результат за тих самих визначених умов.
Передавання даних на цей етап отруєння даних починається з отримання впливу на джерело даних і має завершитися результатом, який дасть змогу пройти фільтрацію та видалення дублікатів. Фіксуйте невизначеність, відхилені альтернативи, використані ресурси, а також будь-який людський або програмний контроль на цьому етапі. За цим журналом команди можуть виявити, чи може невелику цільову підмножину бути важко помітити в даних у масштабах вебу, перш ніж та сама вразливість вплине на важливий результат.
3. Пережити фільтрацію та дедуплікацію: характерне перетворення під час отруєння даних
На цьому етапі отруєння даних система має пережити фільтрацію та дедуплікацію. Важливо з’ясувати не лише, чи відбувається ця операція, а й яку інформацію вона використовує, який стан змінює та які докази підтверджують правомірність цієї зміни. Рецензент має вміти відрізнити цю операцію від атаки ухилення, що застосовується лише після розгортання моделі, а також відтворити її результат за тих самих заявлених умов.
Перехід до цього етапу отруєння даних починається з додавання прикладів із неправильними мітками, упереджених прикладів або прикладів із тригерами й має завершуватися результатом, який може сприяти зміні навченої моделі або контексту, отриманого із пошуку. Фіксуйте невизначеність, відхилені альтернативи, використані ресурси, а також будь-який людський чи програмний контроль на цьому етапі. Саме за таким журналом команди можуть виявити, чи здатна невелика цільова підмножина залишатися непомітною у вебмасштабних даних, перш ніж та сама вразливість призведе до суттєвих наслідків.
4. Змінити навчену модель або контекст, отриманий із пошуку: межа обмежень і перевірки під час отруєння даних
На цьому етапі отруєння даних система має змінити навчену модель або контекст, отриманий із пошуку. Важливо з’ясувати не лише, чи відбувається ця операція, а й яку інформацію вона використовує, який стан змінює та які докази підтверджують правомірність цієї зміни. Рецензент має вміти відрізнити цю операцію від атаки ухилення, що застосовується лише після розгортання моделі, а також відтворити її результат за тих самих заявлених умов.
Перехід до цього етапу отруєння даних починається з того, що система переживає фільтрацію та дедуплікацію, і має завершуватися результатом, який може сприяти активації масштабного погіршення або цільового бекдору. Фіксуйте невизначеність, відхилені альтернативи, використані ресурси, а також будь-який людський чи програмний контроль на цьому етапі. Саме за таким журналом команди можуть виявити, чи здатна невелика цільова підмножина залишатися непомітною у вебмасштабних даних, перш ніж та сама вразливість призведе до суттєвих наслідків.
5. Активувати масштабне погіршення або цільовий бекдор: результат, зворотний зв’язок і правило зупинки під час отруєння даних
На цьому етапі отруєння даних система має активувати масштабне погіршення або цільовий бекдор. Важливо з’ясувати не лише, чи відбувається ця операція, а й яку інформацію вона використовує, який стан змінює та які докази підтверджують правомірність цієї зміни. Рецензент має вміти відрізнити цю операцію від атаки ухилення, що застосовується лише після розгортання моделі, а також відтворити її результат за тих самих заявлених умов.
Перехід до цього етапу отруєння даних починається зі зміни навченої моделі або контексту, отриманого із пошуку, і має завершуватися результатом, який може сприяти моніторингу або остаточному рішенню. Фіксуйте невизначеність, відхилені альтернативи, використані ресурси, а також будь-який людський чи програмний контроль на цьому етапі. Саме за таким журналом команди можуть виявити, чи здатна невелика цільова підмножина залишатися непомітною у вебмасштабних даних, перш ніж та сама вразливість призведе до суттєвих наслідків.
Читайте схему отруєння даних від початку до кінця, щоб зрозуміти роботу системи в робочому середовищі, і у зворотному напрямку, щоб діагностувати збій. Аналіз у прямому напрямку з’ясовує, як один етап забезпечує наступний. Зворотний аналіз починається з некоректного, повільного, дорогого або небезпечного результату й допомагає визначити, яке попереднє припущення до нього призвело. Саме під час аналізу у зворотному напрямку команда часто виявляє, що вирішальна помилка сталася ще до того, як модель видала будь-який результат.
Приклад отруєння даних із докладним розбором
Зловмисник може додати приклади, які навчать класифікатор сприймати рідкісний візуальний фрагмент як надійну мітку.
Цей приклад показовий, адже отруєння даних можна оцінювати за спостережуваними вхідними даними, проміжними станами та результатом, а не за ретельно підготовленою демонстрацією. Ґрунтовне тестування мало б охоплювати звичайні, складні та навмисно оманливі сценарії, пов’язані з цим випадком, передбачати контрольний варіант без застосування цієї техніки та фіксувати як середню якість роботи, так і серйозність окремих збоїв.
Змініть одне припущення у прикладі отруєння даних і повторіть аналіз. Приберіть обов’язковий вхідний параметр, додайте суперечливий сигнал, обмежте обчислювальні ресурси, змініть склад користувачів або змусьте систему утриматися від відповіді. Механізм, який працює лише за одного ретельно підготовленого сценарію, ще не доводить, що він узагальнюється на умови робочого середовища.
Отруєння даних і найпоширеніше спрощення цього поняття
Отруєння даних часто зводять до атаки ухилення, що застосовується лише після розгортання моделі. Таке спрощення усуває саму межу, яка визначає це поняття. Через це покупці можуть порівнювати непорівнювані продукти, дослідники — перебільшувати, що саме доводить експеримент, а оператори — відстежувати не той сигнал після розгортання.
| Аспект | Практична відповідь |
|---|---|
| Визначення | Отруєння даних передбачає маніпулювання даними для навчання, донавчання, оцінювання або пошуку, щоб система ШІ засвоїла спотворену поведінку або видавала результати, обрані зловмисником. |
| Плутанина | атакою ухилення, що застосовується лише після розгортання моделі. |
| Ризик | крихітну цільову підмножину може бути важко виявити у вебмасштабних даних. |
Порівняння також має визначати одиницю аналізу. У дослідженні отруєння даних може розглядатися окрема модель або алгоритм, тоді як у розгорнутому сервісі додаються пошук, маршрутизація, кешування, політики, ідентифікація, інтерфейси користувача й моніторинг. Два продукти можуть використовувати той самий загальний термін, але реалізовувати різні компоненти цього стеку. З’ясуйте, який компонент виконує визначальне перетворення і які інші компоненти необхідні для отримання заявленого результату.
Чому отруєння даних важливе для сучасних систем ШІ
Отруєння даних важливе нині, оскільки системи ШІ отримують ширші контексти, працюють із більшою кількістю модальностей, використовують більше обчислювальних ресурсів під час виконання, мають ширший доступ до інструментів і тісніше інтегруються в організаційні рішення. За таких умов те, що раніше здавалося суто дослідницькою деталлю, може визначати затримку, безпеку, доступність, вплив на довкілля, якість продукту або юридичну відповідальність.
Важливо не те, чи може отруєння даних дати один вражаючий результат. Важливо, чи поліпшує цей метод значущий результат за репрезентативних умов і чи робить це ефективніше за простіший базовий підхід. Звітуйте про розподіли, категорії збоїв, затримку на граничних значеннях, використання ресурсів і групи, яких це стосується, замість того, щоб зводити всі результати до одного середнього показника.
Відстежуйте як технічні показники, так і вплив на людей. Документуйте невизначеність, зберігайте історію походження даних, передбачте можливість ескалації та сплануйте відновлення до того, як система зіткнеться зі змінами реальних умов. Застосування цих принципів саме до отруєння даних робить результати придатними для використання іншими: інша команда зможе оцінити, чи, ймовірно, збережеться заявлений приріст за іншої моделі, мови, апаратної платформи, набору даних, сукупності користувачів або рівня допустимого ризику.
Переваги, які може дати отруєння даних
Найвагоміша причина застосовувати отруєння даних полягає в тому, що воно може безпосередньо усунути цільове вузьке місце. Залежно від реалізації перевага може виявлятися у кращому обґрунтуванні відповідей, точнішому відображенні даних, кращому узагальненні, меншій затримці, скороченні переміщення даних у пам’яті, чіткішій підзвітності або безпечнішому розмежуванні між пропозицією моделі та реальною дією.
Переваги слід описувати через рішення та вимірювання. «Більша інтелектуальність» — не критерій прийнятності для отруєння даних. Корисна ціль може передбачати конкретний рівень помилок на складних випадках, здатність відновитися після суперечливих даних, вартість на певному процентилі потоку запитів, час перевірки людиною, калібрування або частку дій, що залишаються в межах визначених повноважень.
Визначальний сценарій збою під час отруєння даних
Головне обмеження полягає в тому, що крихітну цільову підмножину може бути важко виявити у вебмасштабних даних. Цей збій не можна вважати другорядним питанням і згадувати про нього лише після завершення розробки. Він має від самого початку визначати збір даних, архітектуру, дозволи, оцінювання, умови випуску та моніторинг системи на предмет отруєння даних.
Контрольний захід проти отруєння даних корисний лише тоді, коли спрацьовує до настання витратних або незворотних наслідків. Визначте найранішу спостережувану ознаку збою, установіть порогове значення або правило, призначте відповідального за результат і перевірте можливість відновлення. Залежно від сценарію використання відновлення може означати відмову від відповіді, перехід на простішу систему, запит додаткових даних, передавання питання фахівцеві, відкат моделі або повне припинення дії.
План оцінювання отруєння даних
Почніть оцінювання отруєння даних із формулювання рішення, яке мають обґрунтувати докази. Визначте цільову сукупність, наслідки хибного результату, інформацію, яка справді доступна на момент ухвалення рішення, і найпростішу правдоподібну альтернативу. Це не дасть бенчмарку стати самоціллю лише тому, що його легко провести.
Для контрольованих порівнянь використовуйте незмінений тестовий набір, а потім перевірте отруєння даних у поетапно розгорнутому робочому середовищі. Оцінювання офлайн дає змогу порівнювати варіанти; тіньовий режим, канаркові запуски, обмеження частоти запитів або етапи погодження показують, як реальний трафік, цикли зворотного зв’язку та люди змінюють поведінку. На етапі розгортання слід чітко визначити умову зупинки, а не виходити з припущення, що кожне поліпшення варто повністю впроваджувати.
Зберігайте версії вхідних даних, потрібних для відтворення отруєння даних: вихідних даних, попереднього оброблення, токенізатора або кодера, ваг моделі, конфігурації, запиту або політики, індексу пошуку, набору для оцінювання, припущень щодо апаратного забезпечення та коду обслуговування моделі, якщо це застосовно. Без відстеження походження даних команда не зможе визначити, чи змінився результат через методику, середовище або непомічену зміну конвеєра.
Насамкінець запитайте себе, яке відкриття спростувало б твердження, що отруєння даних дає користь. Якщо жоден результат не може змінити рішення про впровадження, таке оцінювання — це маркетинг. Заздалегідь установлені порогові значення прийнятності та збережений контрольний набір перетворюють цю роботу на доказову оцінку.
Запитання, які варто поставити перед упровадженням отруєння даних
- Мета: Яке вимірюване вузьке місце має усунути отруєння даних?
- Механізм: На якому з п’яти етапів відбувається характерне перетворення?
- Базовий варіант: Як цей підхід порівнюється з атакою ухилення, що застосовується лише після розгортання моделі, або з іншою простішою альтернативою?
- Докази: Які типові, складні, змагальні випадки та випадки для підгруп перевіряли?
- Експлуатація: Які витрати на затримку, пам’ять, обчислення, енергію, обслуговування та перевірку виникають у масштабі?
- Ризик: Як команда виявлятиме ситуацію, коли невелику цільову підмножину даних важко помітити в масиві вебмасштабу?
- Відновлення: Чи може система утриматися від відповіді, перейти до резервного варіанта, відкотити зміни або передати випадок на розгляд до того, як буде завдано шкоди?
Основні джерела для вивчення отруєння даних
Авторитетними відправними джерелами щодо частини стеку ШІ, пов’язаної з отруєнням даних, є рамкова система управління ризиками ШІ NIST, специфікації C2PA та рамкова система конфіденційності NIST. Ознайомтеся з ними разом із документацією саме до тієї моделі, набору даних, апаратного забезпечення та юрисдикції, про які йдеться. Загальне джерело може визначити механізм, але лише докази, отримані в конкретному середовищі розгортання, дають змогу встановити, чи придатна певна реалізація.
Що слід пам’ятати про отруєння даних
Отруєння даних — це визначений механізм у межах ширшої соціотехнічної системи. Його цінність полягає в поліпшенні конкретного результату за чітко визначених умов, а не в самій назві. Схема з п’яти етапів показує потік інформації, порівняння визначає, чим цей механізм не є, а шлях контролю вказує, де відповідальний оператор може втрутитися.
Практичне правило щодо отруєння даних: визначте мету, порівняйте підхід із правдоподібним базовим варіантом, перевірте найважливіший сценарій збою та збережіть докази, потрібні для відстеження змін. За наявності цих складників цей підхід стає інженерним і управлінським рішенням, яке можна оцінити. Без них це лише багатообіцяюча назва, за якою приховується невідомий експлуатаційний ризик.



