

Моделі та платформи ШІ
SEER: прорив у самоконтрольованому навчанні для комп’ютерного зору

 Додайте Unite.AI до бажаних джерел у Google
За останні десять років штучний інтелект (AI) та машинне навчання (ML) зробили величезний прогрес. Сьогодні вони більш точні, ефективні та потужні, ніж будь-коли раніше. Сучасні моделі AI та ML можуть безшовно та точно розпізнавати об’єкти на зображеннях або відеофайлах. Крім того, вони можуть генерувати текст та мову, яка паралельна людській інтелектові.
Моделі AI та ML сучасності сильно залежать від навчання на позначених наборах даних, які вчать їх, як інтерпретувати блок тексту, ідентифікувати об’єкти на зображенні або відеофреймі та багато інших завдань.
Незважаючи на їхні можливості, моделі AI та ML не досконалі, і вчені працюють над створенням моделей, які матимуть змогу навчатися з інформації, яку вони отримують, і не обов’язково залежати від позначених або анотованих даних. Цей підхід називається самонавчанням (self-supervised learning — навчання із самостійним формуванням цільових міток), і це один з найефективніших методів створення моделей ML та AI, які мають “здоровий глузд” або фонове знання для вирішення завдань, які виходять за рамки можливостей моделей AI сьогодні.
Самонавчання вже показало свої результати в обробці природної мови, оскільки воно дозволило розробникам тренувати великі моделі, які можуть працювати з величезною кількістю даних, і призвело до кількох проривів у сферах висновування природної мови, машинного перекладу та відповідей на питання.
Модель SEER від Facebook (META ) AI спрямована на максимізацію можливостей самонавчання у сфері комп’ютерного зору. SEER або SElf SupERvised – це модель самонавчання комп’ютерного зору, яка має понад мільярд параметрів, і вона здатна знаходити закономірності або навчатися навіть з випадкової групи зображень, знайдених в інтернеті, без належних анотацій або міток.
Потрібність самонавчання у комп’ютерному зорі
Анотація даних або позначення даних – це стадія попередньої обробки при розробці моделей машинного навчання та штучного інтелекту. Процес анотації даних ідентифікує сирі дані, такі як зображення або відеофрейми, а потім додає мітки до даних, щоб вказати контекст даних для моделі. Ці мітки дозволяють моделі робити точні передбачення щодо даних.
Одним з найбільших перешкод та викликів, з якими стикаються розробники при роботі над моделями комп’ютерного зору, є пошук високоякісних анотованих даних. Комп’ютерний зір сьогодні залежить від цих позначених або анотованих наборів даних для навчання моделей, які дозволяють їм розпізнавати об’єкти на зображенні.
Анотація даних та її використання у моделі комп’ютерного зору створюють наступні проблеми:
Керування якісними наборами даних
Найбільша проблема, з якою стикаються розробники, полягає у отриманні високоякісних наборів даних постійно, оскільки високоякісні набори даних з належними мітками та чіткими зображеннями призводять до кращого навчання та точних моделей. Однак отримання високоякісних наборів даних постійно має свої власні проблеми.
Управління робочою силою
Позначення даних часто супроводжується проблемами управління робочою силою, головним чином тому, що для обробки та позначення великих обсягів неструктурованих та неанотованих даних потрібна велика кількість працівників, а також забезпечення якості. Тому розробникам необхідно знаходити баланс між якістю та обсягом розмічування даних.
Фінансові обмеження
Найбільша проблема – це фінансові обмеження, які супроводжують процес позначення даних, і більшість часу вартість позначення даних становить значну частку загальної вартості проекту.
Як ми бачимо, анотація даних – це велика проблема при розробці передових моделей комп’ютерного зору, особливо при розробці складних моделей, які працюють з великими обсягами тренувальних даних. Це причина, чому індустрія комп’ютерного зору потребує самонавчання для розробки складних та передових моделей комп’ютерного зору, які здатні вирішувати завдання, які виходять за рамки можливостей сучасних моделей.
З іншого боку, вже існує багато моделей самонавчання, які добре працюють у контрольованому середовищі, головним чином на наборі даних ImageNet. Хоча ці моделі можуть добре працювати, вони не задовольняють основній умові самонавчання у комп’ютерному зорі: навчання з будь-якого необмеженого набору даних або випадкових зображень, а не тільки з добре визначеного набору даних. Коли реалізовано ідеально, самонавчання може допомогти у розробці більш точних та ефективних моделей комп’ютерного зору, які є економічно ефективними та життєздатними.
SEER або SElf-supERvised Модель: Введення
Останні тенденції в галузі AI та ML вказують на те, що підходи до попереднього навчання, такі як напівкероване навчання, навчання зі слабким наглядом та самонавчання, можуть суттєво покращити результати для більшості глибоких моделей навчання для подальших цільових завдань.
Є два ключових фактори, які суттєво внесли свій внесок у покращення результатів цих глибоких моделей навчання.
Попереднє навчання на великих наборах даних
Попереднє навчання на великих наборах даних зазвичай призводить до кращої точності та результатів, оскільки воно піддає модель великому різноманіттю даних. Великі набори даних дозволяють моделям краще зрозуміти закономірності у даних, а в кінцевому підсумку призводять до кращої роботи моделі в реальних сценаріях.
Деякі з найкращих моделей, такі як модель мови GPT-3 та модель розпізнавання мови Wav2vec 2.0, тренуються на великих наборах даних. Модель мови GPT-3 використовує набір даних для попереднього навчання з понад 300 мільярдів слів, тоді як модель розпізнавання мови Wav2vec 2.0 використовує набір даних з понад 53 тисяч годин аудіоданих.
Моделі з великою ємністю
Моделі з більшим числом параметрів часто дають точніші результати, оскільки більша кількість параметрів дозволяє моделі зосередитися лише на об’єктах у даних, які необхідні, а не на інтерференції або шумі у даних.
У минулому розробники робили спроби тренувати моделі самонавчання на неозначених або некурованих даних, але з меншими наборами даних, які містили лише кілька мільйонів зображень. Але чи можуть моделі самонавчання давати високі результати, коли вони тренуються на великому обсязі неозначених та некурованих даних? Це саме питання, на яке модель SEER намагається відповісти.
Модель SEER – це глибокий навчальний каркас, який спрямований на реєстрацію зображень, доступних в інтернеті, незалежно від курованих або позначених наборів даних. Каркас SEER дозволяє розробникам тренувати великі та складні моделі машинного навчання на випадкових даних без нагляду, тобто модель аналізує дані та вчиться закономірностям або інформації самостійно, без будь-якої додаткової ручної підтримки.
Остаточною метою моделі SEER є допомогти у розробці стратегій для процесу попереднього навчання, який використовує некуровані дані для надання високих результатів у навчанні переносу. Крім того, модель SEER також спрямована на створення систем, які можуть безперервно навчатися з нескінченного потоку даних у самонавчальному режимі.
Каркас SEER тренує моделі високої ємності на мільярдах випадкових та не обмежених зображень, витягнутих з інтернету. Моделі, треновані на цих зображеннях, не залежать від метаданих зображень або анотацій для навчання моделі або фільтрації даних. Останнім часом самонавчання показало великий потенціал, оскільки тренування моделей на некурованих даних дало кращі результати порівняно з попереднім навчанням з наглядом для подальших цільових завдань.
Каркас SEER та RegNet: Зв’язок
Для аналізу моделі SEER вона зосереджена на архітектурі RegNet з понад 700 мільйонами параметрів, які відповідають цілі моделі SEER самонавчання на некурованих даних за дві основні причини:
- Вони пропонують ідеальний баланс між продуктивністю та ефективністю.
- Вони дуже гнучкі та можуть бути використані для масштабування кількості параметрів.

Каркас SEER: Попередня робота з різних областей
Каркас SEER спрямований на дослідження меж тренування великих архітектур моделей у некурованих або неозначених наборах даних за допомогою самонавчання, і модель шукає натхнення у попередній роботі в цій галузі.
Самонавчальне попереднє навчання візуальних особливостей
Самонавчання вже було реалізовано у комп’ютерному зорі протягом деякого часу з методами, які використовують автоенкодери, дискримінацію на рівні екземплярів або кластеризацію. Останнім часом методи, які використовують контрастне навчання, показали, що попереднє навчання моделей за допомогою несупервізійного навчання для подальших цільових завдань може працювати краще, ніж підхід з наглядом.
Основний висновок з несупервізійного навчання візуальних особливостей полягає у тому, що поки ви тренуєтеся на фільтрованих даних, позначені мітки не потрібні. Модель SEER спрямована на дослідження того, чи може модель навчатися точним представленням, коли великі архітектури моделей тренуються на великому обсязі некурованих, неозначених та випадкових зображень.
Навчання візуальних особливостей у масштабі
Попередні моделі користувалися попереднім навчанням моделей на великих позначених наборах даних з слабким наглядом, наглядом та напівнаглядом на мільйонах фільтрованих зображень. Крім того, аналіз моделей також показав, що попереднє навчання моделей на мільярдах зображень часто дає кращу точність порівняно з тренуванням моделі з нуля.
Крім того, тренування моделі у великому масштабі зазвичай залежить від кроків фільтрації даних для того, щоб зробити зображення резонансними з цільовими поняттями. Ці кроки фільтрації або використовують передбачення від попередньо тренованого класифікатора, або використовують хештеги, які часто є синсетами класів ImageNet. Модель SEER працює інакше, оскільки вона спрямована на навчання особливостей у будь-якому випадковому зображенні, і тому тренувальні дані для моделі SEER не куруються для відповідності до попередньо визначеного набору особливостей або понять.
Масштабування архітектур для розпізнавання зображень
Моделі зазвичай користуються тренуванням великих архітектур на кращій якості вихідних візуальних особливостей. Це важливо при попередньому навчанні на великому наборі даних, оскільки модель з обмеженою ємністю часто недофітує. Це має ще більшу важливість при попередньому навчанні з контрастним навчанням, оскільки в таких випадках модель повинна навчатися розрізняти екземпляри набору даних, щоб навчатися кращих візуальних представлень.
Однак, для розпізнавання зображень масштабування архітектури включає в себе набагато більше, ніж просто зміна глибини та ширини моделі, і для створення масштабно-ефективної моделі з вищою ємністю потрібно багато літератури. Модель SEER демонструє переваги використання сім’ї моделей RegNets для реалізації самонавчання у великому масштабі.
SEER: Методи та компоненти
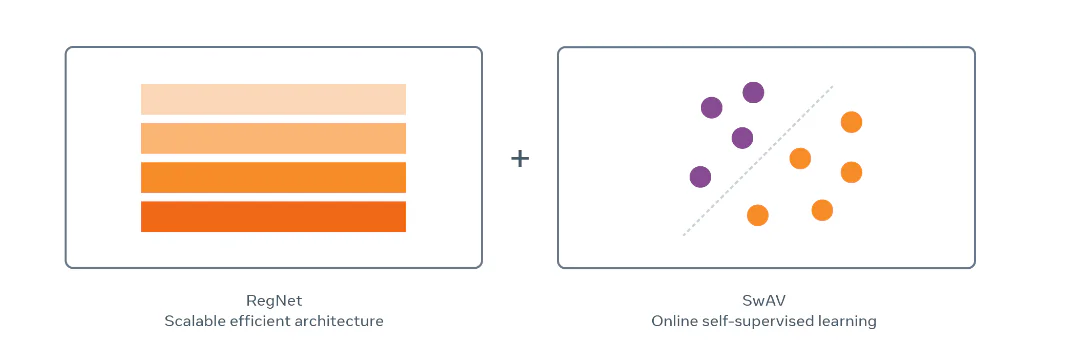
Каркас SEER використовує різні методи та компоненти для попереднього навчання моделі для навчання візуальним представленням. Деякі з основних методів та компонентів, які використовує каркас SEER, це: RegNet та SwAV. Давайте коротко обговоримо методи та компоненти, які використовує каркас SEER.
Самонавчальне попереднє навчання з SwAV
Каркас SEER попередньо тренується з SwAV, онлайн-самонавчальним підходом. SwAV – це онлайн-кластерний метод, який використовується для тренування конвольних мереж без анотацій. Каркас SwAV працює шляхом тренування вкладення, яке створює кластерні призначення послідовно між різними виглядами одного зображення. Система потім вчиться семантичним представленням шляхом видобування кластерів, які є інваріантними до аугментацій даних.
На практиці каркас SwAV порівнює особливості різних виглядів зображення шляхом використання їх незалежних кластерних призначень. Якщо ці призначення захоплюють одні й ті самі особливості, то можливо передбачити призначення одного зображення, використовуючи особливість іншого вигляду.
Модель SEER розглядає набір K кластерів, і кожен з цих кластерів асоціюється з навчуваним d-вимірним вектором vk. Для пакета B зображень, кожне зображення i перетворюється у два різних вигляди: xi1 , і xi2. Вигляди потім феатуризуються за допомогою конвольної мережі, що призводить до двох наборів особливостей: (f11, …, fB2), і (f12, … , fB2). Кожен набір особливостей потім незалежно призначає кластерним прототипам за допомогою Оптимального Транспорту-рішувача.
Оптимальний Транспорт-рішувач забезпечує, що особливості розподіляються рівномірно по кластерах, і це допомагає уникнути тривіальних рішень, коли всі представлення відображаються на один прототип. Результируюче призначення потім міняється між двома наборами: кластерне призначення yi1 вигляду xi1 потрібно передбачити за допомогою особливістю fi2 вигляду xi2, і навпаки.
Прототипні ваги та конвольна мережа потім тренуються для мінімізації втрат для всіх прикладів. Втрата кластерного передбачення l по суті є крос-ентропією між софтмаксом добутку f та кластерного призначення.

RegNetY: Масштабно-ефективна сім’я моделей
Масштабування ємності моделі та даних вимагає архітектур, які є ефективними не тільки з точки зору пам’яті, але також з точки зору часу виконання та RegNets – це сім’я моделей, спеціально розроблених для цієї мети.
Сім’я архітектур RegNet визначається простором конвольних мереж з 4 стадіями, де кожна стадія містить серію ідентичних блоків, зберігаючи при цьому фіксовану структуру блоків, переважно залишковий блок із вузьким місцем (residual bottleneck block).
Каркас SEER зосереджується на архітектурі RegNetY та додає Сквіз-і-Ексайтацію до стандартної архітектури RegNets у спробі покращити їхню продуктивність. Крім того, модель RegNetY має 5 параметрів, які допомагають у пошуку хороших екземплярів з фіксованою кількістю FLOPs, які споживають розумні ресурси. Модель SEER спрямована на покращення своїх результатів шляхом реалізації архітектури RegNetY безпосередньо на своєму самонавчальному попередньому навчанні.
Архітектура RegNetY 256GF: Модель SEER зосереджується в основному на архітектурі RegNetY 256GF у сім’ї RegNetY, і її параметри використовують правило масштабування архітектури RegNets. Параметри описані наступним чином.

Архітектура RegNetY 256GF має 4 стадії зі стадійними ширинами (528, 1056, 2904, 7392) та стадійними глибинами (2,7,17,1), які додають понад 696 мільйонів параметрів. Коли тренується на 512 V100 32GB NVIDIA GPU, кожна ітерація триває близько 6125 мс для пакета з 8 704 зображень. Тренування моделі на наборі даних з понад мільярдом зображень, з пакетом з 8 704 зображень на понад 512 GPU, потребує 114 890 ітерацій, і тренування триває близько 8 днів.
Оптимізація та тренування у великому масштабі
Модель SEER пропонує кілька коригувань для тренування самонавчальних методів та адаптації цих методів до великого масштабу. Ці методи включають:
- Графік швидкості навчання.
- Зменшення споживання пам’яті на GPU.
- Оптимізація швидкості тренування.
- Попереднє тренування на великому масштабі.
Давайте коротко обговоримо ці методи.
Графік швидкості навчання
Модель SEER досліджує можливість використання двох графіків швидкості навчання: графіка швидкості навчання у вигляді косинуса, та фіксованого графіка швидкості навчання.
Графік швидкості навчання у вигляді косинуса використовується для порівняння різних моделей справедливо, оскільки він адаптується до кількості оновлень. Однак графік швидкості навчання у вигляді косинуса не адаптується до великомасштабного тренування в першу чергу, оскільки вона по-різному зважує зображення залежно від того, коли їх бачать під час навчання, і він також використовує повні оновлення для планування.
Фіксований графік швидкості навчання тримає швидкість навчання фіксованою, доки функція втрат не перестане зменшуватися, а потім швидкість навчання ділиться на 2. Аналіз показує, що фіксований графік швидкості навчання працює краще, оскільки він має місце для більш гнучкого тренування. Однак, оскільки модель тренується тільки на 1 мільярд зображень, вона використовує графік швидкості навчання у вигляді косинуса для тренування своєї найбільшої моделі, RegNet 256GF.
Зменшення споживання пам’яті на GPU
Модель також спрямована на зменшення обсягу пам’яті GPU, необхідного під час періоду тренування, шляхом використання змішаної точності та градієнтного чекпойнтінгу. Модель використовує бібліотеку NVIDIA Apex Library з рівнем оптимізації O1 для виконання операцій, таких як конволюції та GEMMs, у 16-бітній плаваючій точності. Модель також використовує реалізацію градієнтного чекпойнтінгу PyTorch, яка обмінює додаткові обчислення на економію пам’яті.
Крім того, модель також викидає будь-які проміжні активації, зроблені під час прямого проходу, а під час зворотного проходу вона перераховує ці активації.
Оптимізація швидкості тренування
Використання змішаної точності для оптимізації використання пам’яті має додаткові переваги, оскільки прискорювачі використовують зменшений розмір FP16, збільшуючи пропускну здатність порівняно з FP32. Це допомагає прискорити період тренування, послаблюючи обмеження пропускної здатності пам’яті.
Модель SEER також синхронізує BatchNorm шар по GPU, створюючи групи процесів замість використання глобальної синхронізації, яка зазвичай займає більше часу. Нарешті, завантажувач даних, використаний у моделі SEER, попередньо витягує більше тренувальних пакетів, що призводить до більшої кількості даних, пропущених під час тренування порівняно з завантажувачем даних PyTorch.
Попереднє тренування на великому масштабі
Модель SEER використовує понад мільярд зображень під час попереднього тренування, і вона розглядає завантажувач даних, який випадково відбирає зображення безпосередньо з інтернету та Instagram. Через те, що модель SEER тренується на цих зображеннях у дикій природі та онлайн, вона не застосовує жодної попередньої обробки цих зображень, ані не курує їх за допомогою процесів, таких як видалення дублікатів або фільтрація хештегів.
Варті зазначити, що набір даних не є статичним, і зображення у наборі даних оновлюються кожні три місяці. Однак оновлення набору даних не впливає на продуктивність моделі.
Реалізація моделі SEER
Модель SEER попередньо тренує RegNetY 256GF з SwAV, використовуючи шість обрізаних фрагментів кожного зображення, з кожним зображенням, яке має роздільну здатність 2×224 + 4×96. Під час фази попереднього тренування модель використовує 3-шарову MLP або багатошарову перцептронну мережу з проєкційними головками розмірів 10444×8192, 8192×8192 та 8192×256.
Замість використання шарів BatchNorm у голові, модель SEER використовує 16 тисяч прототипів з температурою t встановленою на 0,1. Параметр регуляризації Сінкгорна встановлений на 0,05, і вона виконує 10 ітерацій алгоритму. Модель далі синхронізує статистику BatchNorm по GPU, і створює численні групи процесів з розміром 64 для синхронізації.
Крім того, модель використовує оптимізатор LARS або шар-адаптивну швидкість масштабування, вагове затухання 10-5, активаційні чекпойнти та оптимізацію змішаної точності O1. Модель потім тренується за допомогою стохастичного градієнтного спуску за допомогою пакета з 8192 випадковими зображеннями, розподіленими по 512 NVIDIA GPU, що призводить до 16 зображень на GPU.
Швидкість навчання лінійно збільшується від 0,15 до 9,6 для перших 8 тисяч тренувальних оновлень. Після розігріву модель слідує графіку швидкості навчання у вигляді косинуса, який знижується до кінцевого значення 0,0096. Загалом, модель SEER тренується понад мільярд зображень за 122 тисячі ітерацій.
Результати каркаса SEER
Якість особливостей, згенерованих підходом самонавчального попереднього навчання, вивчається та аналізується на різних бенчмарках та подальших цільових завданнях. Модель також розглядає сценарій із малою кількістю прикладів, який надає обмежений доступ до зображень та їхніх міток для подальших цільових завдань.
Доточне налаштування великих попередньо тренованих моделей
Модель вимірює якість моделей, попередньо тренованих на випадкових даних, шляхом перенесення їх до бенчмарку ImageNet для класифікації зображень. Результати доточного налаштування великих попередньо тренованих моделей визначаються наступними параметрами.
Експериментальні налаштування
Модель попередньо тренує 6 архітектур RegNet з різною ємністю, а саме RegNetY- {8,16,32,64,128,256}GF, на понад 1 мільярд випадкових та публічних зображень Instagram з SwAV. Моделі потім налаштовуються для класифікації зображень на ImageNet, який використовує понад 1,28 мільйона стандартних тренувальних зображень з належними мітками, і має стандартний набір валідації з понад 50 тисяч зображень для оцінки.
Модель потім застосовує ті самі техніки збільшення даних, як і в SwAV, і налаштовується протягом 35 епох з оптимізатором SGD або стохастичного градієнтного спуску з розміром пакета 256 та швидкістю навчання 0,0125, яка зменшується у 10 разів після 30 епох, імпульсом 0,9 та ваговим затуханням 10-4. Модель повідомляє про точність топ-1 на наборі валідації, використовуючи центральний обрізаний фрагмент розміром 224×224.
Порівняння з іншими самонавчальними підходами попереднього тренування
У наступній таблиці найбільша попередньо тренована модель у RegNetY-256GF порівнюється з існуючими попередньо тренованими моделями, які використовують підхід самонавчання.

Як ми бачимо, модель SEER повертає точність топ-1 на рівні 84,2% на ImageNet, і перевершує SimCLRv2, найкращу існуючу попередньо треновану модель, на 1%.
Крім того, наступна фігура порівнює каркас SEER з моделями різної ємності. Як ми бачимо, незалежно від ємності моделі, поєднання каркаса RegNet з SwAV дає точні результати під час попереднього тренування.

Модель SEER попередньо тренується на некурованих та випадкових зображеннях, і вони мають архітектуру RegNet з самонавчальним методом SwAV. Модель SEER порівнюється з SimCLRv2 та моделями ViT з різними архітектурами мереж. Нарешті, модель налаштовується на наборі даних ImageNet, і повідомляється точність топ-1.
Вплив ємності моделі
Ємність моделі має суттєвий вплив на продуктивність попереднього тренування, і наступна фігура порівнює це з впливом при тренуванні з нуля.

Як ми бачимо, показник точності топ-1 попередньо тренованих моделей вища, ніж моделей, тренованих з нуля, і різниця стає все більшою з збільшенням кількості параметрів. Це також очевидно, що хоча ємність моделі приносить користь і попередньо тренованим, і тренованим з нуля моделям, вплив більший на попередньо треновані моделі при роботі з великою кількістю параметрів.
Можлива причина, чому тренування моделі з нуля може перефітуватися, полягає у тому, що розмір набору даних ImageNet відносно малий.
Навчання на малій кількості прикладів
Навчання на малій кількості прикладів означає оцінку продуктивності моделі SEER у сценарії з малою кількістю прикладів, тобто використовуючи лише частину загального обсягу даних при виконанні подальших цільових завдань.
Експериментальні налаштування
Каркас SEER використовує два набори даних для навчання на малій кількості прикладів, а саме Places205 та ImageNet. Крім того, модель припускає, що має обмежений доступ до набору даних під час перенесення, як у плані зображень, так і їхніх міток. Це обмежене середовище відрізняється від стандартних налаштувань, використовуваних для самонавчання, де модель має доступ до всього набору даних, і тільки доступ до міток зображень обмежений.
Результати на наборі даних Place205
Наступна фігура показує вплив попереднього тренування моделі на різні частини набору даних Place205.

Підхід порівнюється з попереднім тренуванням моделі на наборі даних ImageNet під наглядом з тією ж архітектурою RegNetY-128 GF. Результати порівняння несподівані, оскільки можна побачити, що існує стабільний виграш близько 2,5% у точності топ-1 незалежно від частини тренувальних даних, доступних для налаштування на наборі даних Place205.
Різниця між супервізованим і самонавчальним попереднім тренуванням можна пояснити різницею у природі тренувальних даних, оскільки особливості, вивчені моделлю з випадкових зображень у дикій природі, можуть бути більш придатними для класифікації сцен. Крім того, нерівномірний розподіл основних поняттів може виявитися перевагою для попереднього тренування на незбалансованому наборі даних, таким як Places205.
Результати на ImageNet

Наступна таблиця порівнює підхід моделі SEER з самонавчальними підходами попереднього тренування та напівнаглядовими підходами на навчанні на малій кількості прикладів. Варті зазначити, що всі ці методи використовують усі 1,2 мільйона зображень набору даних ImageNet для попереднього тренування, і вони тільки обмежують доступ до міток.
Як ми бачимо, хоча мережі бачили більше зображень з того самого розподілу під час попереднього тренування, це вигідно для цих підходів. Однак що вражає, так це те, що навіть хоча модель SEER бачить тільки 1-10% набору даних ImageNet, вона все ж здатна досягти точності топ-1 близько 80%, що трохи не дотягує до точності підходів, описаних у таблиці вище.
Вплив ємності моделі
Наступна фігура обговорює вплив ємності моделі на навчання на малій кількості прикладів: при 1%, 10% та 100% набору даних ImageNet.

Як ми бачимо, збільшення ємності моделі може покращити точність моделі, оскільки вона зменшує доступ до зображень та їхніх міток у наборі даних.
Перенесення до інших бенчмарків
Для подальшої оцінки моделі SEER та аналізу її продуктивності попередньо треновані особливості переносяться до інших подальших цільових завдань.
Лінійна оцінка класифікації зображень

Наступна таблиця порівнює особливості з попередньо тренованого RegNetY-256GF та RegNetY128-GF, попередньо тренованого на наборі даних ImageNet з тією ж архітектурою з наглядом та без нагляду. Для аналізу якості особливостей модель заморожує ваги та використовує лінійний класифікатор зверху особливостей, використовуючи тренувальний набір для подальших цільових завдань. Наступні бенчмарки розглядаються для цього процесу: Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) та Pascal VOC (VOC).
Виявлення та сегментація
Наступна фігура порівнює попередньо треновані особливості на виявленні та сегментації та оцінює їх.

Каркас SEER тренує модель Mask-RCNN на бенчмарку COCO з попередньо тренованими RegNetY-64GF та RegNetY-128GF як будівельними блоками. Для обох архітектур, а також подальших цільових завдань, підхід самонавчального попереднього тренування SEER перевершує наглядове тренування на 1,5 до 2 AP-балів.
Порівняння з слабо наглядовим попереднім тренуванням
Більшість зображень, доступних в інтернеті, зазвичай мають мета-опис або альтернативний текст, або описи, або геолокації, які можуть надати перевагу під час попереднього тренування. Попередня робота показала, що передбачення кураторського або позначеного набору хештегів може покращити якість передбачуваних візуальних особливостей. Однак цей підхід потребує фільтрації зображень, і він працює найкраще тільки тоді, коли наявні текстові метадані.
Наступна фігура порівнює попереднє тренування архітектури ResNetXt101-32dx8d на випадкових зображеннях з тією ж архітектурою, тренованою на позначених зображеннях з хештегами та метаданими, і повідомляє про точність топ-1 для обох.

Як ми бачимо, хоча каркас SEER не використовує метадані під час попереднього тренування, його точність порівнянна з моделями, які використовують метадані для попереднього тренування.
Абляційний аналіз
Абляційний аналіз проводиться для аналізу впливу певного компонента на загальну продуктивність моделі. Абляційний аналіз проводиться шляхом видалення компонента з моделі зовсім, і розуміння того, як модель працює.
Вплив архітектури моделі
Архітектура моделі має суттєвий вплив на продуктивність моделі, особливо коли модель масштабується або змінюються специфікації попереднього тренування.
Наступна фігура обговорює вплив зміни архітектури на якість попередньо тренованих особливостей при лінійній оцінці на наборі даних ImageNet. Передбачувані особливості можна досліджувати безпосередньо в цьому випадку, оскільки оцінка не сприяє моделі, яка повертає високу точність при тренуванні з нуля на наборі даних ImageNet.

Як ми бачимо, для архітектур ResNeXts та ResNet особливості, отримані з передостаннього шару, працюють краще з поточними налаштуваннями. З іншого боку, архітектура RegNet перевершує інші архітектури.
Загалом, можна зробити висновок, що збільшення ємності моделі має позитивний вплив на якість особливостей, і існує логарифмічний виграш у продуктивності моделі.
Масштабування попереднього тренування
Є дві основні причини, чому тренування моделі на більших наборах даних може покращити загальну якість візуальних особливостей, які модель вчиться: більше унікальних зображень та більше параметрів. Давайте коротко розглянемо ці причини та їхній вплив на продуктивність моделі.
Збільшення кількості унікальних зображень

Наступна фігура порівнює дві різні архітектури, RegNet8 та RegNet16, які мають одну й ту ж кількість параметрів, але тренуються на різній кількості унікальних зображень. Каркас SEER тренує моделі протягом оновлень, що відповідають 1 епохі для мільярда зображень, або 32 епох для 32 унікальних зображень, і з одним півколом косинусної швидкості навчання.
Як ми бачимо, для того щоб модель працювала добре, кількість унікальних зображень, поданих до моделі, в ідеалі має бути більшою. У цьому випадку модель працює добре, коли їй подаються унікальні зображення більше, ніж зображення, присутні в наборі даних ImageNet.
Більше параметрів
Наступна фігура показує продуктивність моделі, коли вона тренується над мільярдом зображень за допомогою архітектури RegNet-128GF. Зі збільшенням кількості параметрів продуктивність моделі стабільно зростає.

Самонавчальний комп’ютерний зір у реальному світі
До цього часу ми обговорювали, як самонавчання та модель SEER для комп’ютерного зору працюють у теорії. Тепер давайте розглянемо, як самонавчальний комп’ютерний зір працює в реальних сценаріях, і чому SEER є майбутнім самонавчального комп’ютерного зору.
Модель SEER конкурує з роботою, виконаною в галузі обробки природної мови, де висококласні моделі використовують трильйони наборів даних та параметрів, поєднаних з трильйонами слів тексту під час попереднього тренування моделі. Продуктивність на подальших цільових завданнях загалом збільшується з збільшенням кількості вхідних даних для тренування моделі, і те ж саме справедливо для задач комп’ютерного зору.
Але використання самонавчальних технік для обробки природної мови відрізняється від використання самонавчальних технік для комп’ютерного зору. Це тому, що при роботі з текстами семантичні поняття зазвичай розбиваються на окремі слова, але при роботі з зображеннями модель повинна вирішити, який піксель належить до якого поняття.
Крім того, різні зображення мають різні вигляди, і хоча кілька зображень можуть мати один і той же об’єкт, поняття можуть відрізнятися суттєво. Наприклад, розглянемо набір даних із зображеннями кота. Хоча основний об’єкт, кота, спільний для всіх зображень, поняття можуть відрізнятися суттєво, оскільки кот може стояти нерухомо на одному зображенні, а на іншому зображенні кот може гратися з м’ячем, і так далі.
Через те, що зображення часто мають різні поняття, важливо, щоб модель мала можливість подивитися на велику кількість зображень, щоб зрозуміти відмінності навколо одного й того ж поняття.
Щоб успішно масштабувати модель для ефективної роботи з високовимірними та складними даними зображень, потрібні два компоненти:
- Згорткова нейронна мережа (CNN), достатньо велика для засвоєння візуальних понять із дуже великого набору зображень.
- Алгоритм, здатний вивчати закономірності у великій кількості зображень без міток, анотацій або метаданих.
SEER прагне застосувати ці компоненти в комп’ютерному зорі. Модель використовує досягнення SwAV — методу самоконтрольованого навчання, який за допомогою онлайн-кластеризації групує або поєднує зображення зі схожими візуальними поняттями й використовує цю схожість для кращого виявлення закономірностей.
Завдяки архітектурі SwAV модель SEER ефективніше застосовує самоконтрольоване навчання в комп’ютерному зорі та може скоротити час навчання до шести разів.
Крім того, навчання в такому масштабі — на понад мільярді зображень — потребує архітектури, ефективної за часом виконання, використанням пам’яті й точністю. Тут застосовують моделі RegNet: ці згорткові мережі, за описом у статті, можна масштабувати до трильйонів параметрів і оптимізувати відповідно до обмежень пам’яті та вимог до часу виконання.
Висновок: Самонавчальне майбутнє
Самонавчальне навчання було великою темою обговорення в галузі AI та ML протягом деякого часу, оскільки воно дозволяє моделям AI навчатися інформацію безпосередньо з великої кількості даних, доступних випадково в інтернеті, а не залежати від ретельно кураторських та позначених наборів даних, які мають єдину мету тренування моделей AI.
Самонавчальне навчання є важливим поняттям для майбутнього AI та ML, оскільки воно має потенціал дозволити розробникам створювати моделі AI, які добре адаптуються до реальних сценаріїв, і мають багато випадків використання, а не мають певної мети, і SEER є віхою у реалізації самонавчального навчання в галузі комп’ютерного зору.
Модель SEER робить перший крок у трансформації галузі комп’ютерного зору, і зменшенні нашої залежності від позначених наборів даних. Модель SEER спрямована на ліквідацію необхідності анотації наборів даних, що дозволить розробникам працювати з різноманітними та великими обсягами даних. Реалізація SEER особливо корисна для розробників, які працюють над моделями, які займаються областями з обмеженими зображеннями або метаданими, такими як медична галузь.
Крім того, ліквідація людських анотацій дозволить розробникам розробляти та розгортати модель швидше, що дозволить їм реагувати на швидко змінювані ситуації швидше та з більшою точністю.



