
Інтерв’ю
Нікундж Баджай, співзасновник і генеральний директор TrueFoundry – серія інтерв’ю

 Додайте Unite.AI до бажаних джерел у Google
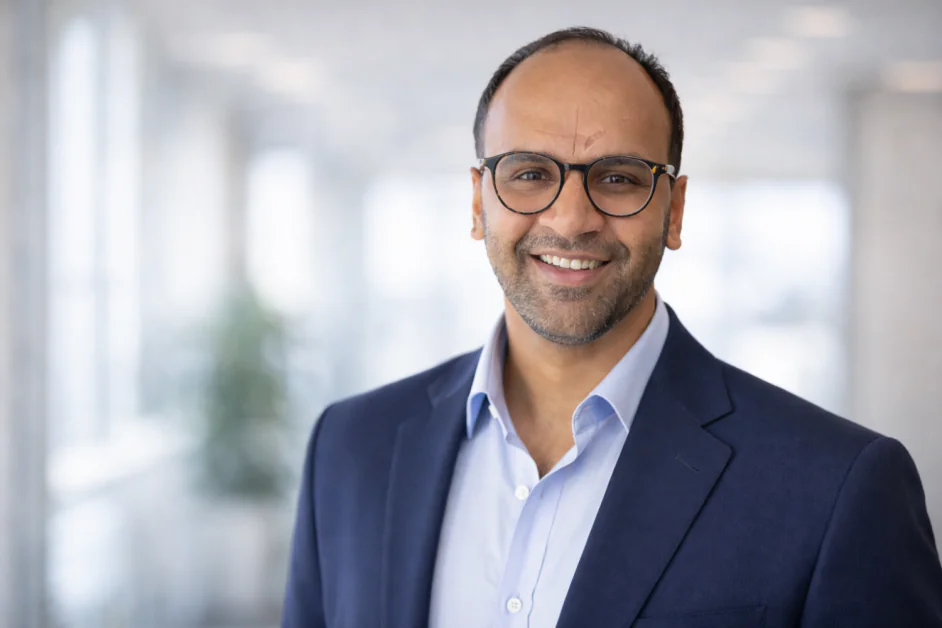
До заснування TrueFoundry ви займалися дослідженнями машинного навчання, системами ШІ в робочому середовищі Facebook (META ) та великомасштабними рекомендаційними системами. Який досвід найбезпосередніше спонукав вас створити компанію інфраструктури ШІ для підприємств і яка проблема, на вашу думку, тоді залишалася невирішеною?
У Meta ми розглядали машинне навчання як окремий випадок програмного забезпечення, а генеративний ШІ — як окремий випадок машинного навчання. У результаті сформувався вертикальний технологічний стек із програмним забезпеченням унизу, машинним навчанням посередині та генеративним ШІ нагорі. За такої організації моделі, які я створюю як розробник машинного навчання, розгортаються за тією самою схемою, що й решта програмного забезпечення, тому масштабувати системи дуже просто.
Проте більшість підприємств розгортала паралельні стеки, тобто окремі стеки для програмного забезпечення, машинного навчання й генеративного ШІ. Щойно з’являються такі паралельні стеки, масштабування ускладнюється через необхідність передавати роботу між сферою машинного навчання та сферою програмного забезпечення.
Наша команда завжди працювала на перетині створення моделей машинного навчання та відповідної інфраструктури. Завдяки цій особливій перспективі ми побачили можливість запровадити подібні вертикальні стеки на підприємствах і пристосувати їх до конкретних вимог. Наприкінці 2021 року ми також висунули гіпотезу, що машинне навчання наближається до переломного моменту. Коли він настане, більшій кількості компаній знадобиться вертикально інтегрований стек для ефективного розгортання та масштабування цих систем. Саме це зрештою привело нас до заснування TrueFoundry, і наша гіпотеза підтвердилася. Після запуску ChatGPT наприкінці 2022 року впровадження ШІ прискорилося.
Що змінилося в тому, як організації мають думати про надійність і відмови, коли системи ШІ переходять від експериментів до повсякденної роботи?
У випадку генеративного ШІ на кону значно більше, ніж у традиційних системах машинного навчання. Коли ці системи переходять у робочі середовища, організації стикаються з набагато вищим рівнем неоднозначності та недетермінованості, оскільки LLM за своєю природою стохастичні. Агентні системи, побудовані на їхній основі, додають ще більше неоднозначності.
Крім того, відмови вже не є бінарними. Йдеться не лише про те, працює система чи ні: багато проблем проявляються як часткові відмови або непомітне погіршення роботи. З часом системи можуть відповідати з більшою затримкою, нижчою якістю або поводитися неправильно. У багатьох випадках таке погіршення важче виявити, а іноді воно навіть шкідливіше за повну зупинку роботи.
Організації мають оцінювати надійність не лише за часом безперебійної роботи, а й з огляду на погіршення продуктивності з часом.
TrueFailover запустили під час хвилі резонансних збоїв у хмарних сервісах і сервісах ШІ. Які нещодавні події чітко показали, що надійність ШІ перетворилася з бажаного доповнення на основну архітектурну вимогу?
Один із наших клієнтів у сфері охорони здоров’я обробляє в реальному часі запити пацієнтів щодо рецептів, для яких критично важливе своєчасне реагування. Він постраждав від перерви в роботі, спричиненої відмовою моделі. Його робочі процеси генерують тисячі доларів доходу за секунду, а збій порушив деякі з цих критично важливих процесів. Це був один із перших клієнтів TrueFailover, тому ми змогли допомогти йому швидко відновити роботу й обмежити наслідки.
Такі інциденти порушують важливе питання: якщо у випадку систем генеративного ШІ на кону дедалі більше, чому процеси відновлення все ще переважно ручні? Це зміцнило переконання, що системи слід створювати, виходячи з того, що відмови траплятимуться, і проєктувати так, щоб вони автоматично виправляли себе. Надійність також потрібно закладати в сам стек ШІ за допомогою шлюзів ШІ, які можуть забезпечувати централізовану маршрутизацію, спостережуваність, захисні механізми та інтелектуальне перемикання між моделями різних постачальників.
Багато перерв у роботі ШІ досі подають як дрібні технічні негаразди. Де, на вашу думку, починають проявлятися реальні економічні та людські втрати, коли системи ШІ зупиняються?
ШІ на підприємствах розвинувся настільки, що ці негаразди вже не впливають лише на внутрішні робочі процеси. Сьогодні збої та погіршення роботи безпосередньо й негайно впливають на громадське сприйняття та прибутки, оскільки застосунки в робочих середовищах уже обслуговують клієнтів. Саме перехід від внутрішнього тестування до загальнодоступних застосунків, де на кону багато, зумовлює зростання потреби в увазі й нагляді з боку вищого керівництва.
У міру того як системи ШІ глибше інтегруються в операційні робочі процеси, збої перестають бути лише технічними проблемами. Вони дедалі частіше мають прямі наслідки для бізнесу, клієнтів і репутації.
Як швидко в критично важливих середовищах, як-от аптеки, надання медичної допомоги чи підтримка клієнтів, простій ШІ може перерости в операційний або репутаційний ризик?
У критично важливих середовищах це відбувається майже миттєво, оскільки системи підтримують робочі процеси в реальному часі, для яких важливе своєчасне виконання. Навіть коротка перерва може зупинити критичні процеси, затримати надання послуг або порушити роботу подальших систем, які залежать від цих результатів, спричиняючи каскадні операційні наслідки в усій організації.
У таких галузях, як охорона здоров’я, вплив виходить за межі операційних збоїв і зачіпає клієнтський досвід та результати надання послуг. Якщо пацієнт не може вчасно отримати ліки за рецептом, це може мати реальні наслідки. Це проблема не лише для пацієнта: вона також може зашкодити репутації аптеки або надавача медичних послуг. У критично важливих середовищах, де значення має довіра, безперервна робота систем є першочерговою. Тому організації дедалі більше усвідомлюють, що системи ШІ потрібно проєктувати з розрахунком на відмови, а механізми відновлення мають активуватися автоматично, щоб мінімізувати ризик.
Ви казали, що багато команд проєктують архітектуру заради можливостей, а не безперервної роботи. Чому, на вашу думку, стійкість історично мала нижчий пріоритет у проєктуванні систем ШІ?
Головна причина — стимули всередині організацій. Нові можливості помітні й захопливі. Вони відкривають шлях до демонстрацій, функцій і нових перспектив продукту, які керівництво може побачити одразу.
Безперервність за визначенням непомітна, коли все працює добре. Тому системи винагороди зазвичай більше заохочують випуск нових функцій, ніж забезпечення того, щоб нічого не виходило з ладу. У результаті організації часто вкладають непропорційно більше в розвиток можливостей, ніж в інженерне забезпечення стійкості.
Які нові вразливі місця з’являються в стеку ШІ через дедалі більшу залежність підприємств від зовнішніх моделей та API, а їхнє значення керівники можуть ще не повністю усвідомлювати?
LLM за своєю суттю є спільними ресурсами, і підприємства не володіють ними так, як традиційною інфраструктурою. Крім того, важливі, критичні для бізнесу системи підприємств працюють на зовнішніх системах, ще не повністю перевірених часом. Самі LLM швидко розвиваються, а отже, постачальника моделі не можна притягати до відповідальності за такі речі, як затримка чи незначне зниження продуктивності моделі, оскільки він дуже швидко проводить нові ітерації досліджень.
Оскільки LLM є спільними ресурсами, певна дія іншого їхнього користувача може спричинити різкий стрибок затримки. Сама природа LLM створює багато таких точок відмови, і підприємства в цьому новому світі просто не мають повного контролю. Без повного контролю найкраще, що може зробити підприємство, — забезпечити достатнє резервування системи, щоб спроєктувати стійке рішення.
Якщо не зосереджуватися на конкретних продуктах, як організаціям слід переосмислити архітектуру ШІ, щоб виходити з неминучості відмов, а не вважати збої рідкісними крайовими випадками?
Організаціям варто повернутися до основних принципів проєктування розподілених систем. Програмні системи створювали з припущенням, що мережеві компоненти й машини виходитимуть з ладу і що цілий регіон може припинити роботу.
Системи ШІ не мають бути винятком. Слід припускати, що постачальники моделей стикатимуться із затримками, погіршенням роботи чи збоями, і передбачати резервування, щоб застосунки залишалися стійкими в різних сценаріях відмов.
Чи очікуєте ви, що стійкість ШІ стане вирішальним чинником вибору платформи й постачальника, подібно до того, як час безперебійної роботи та резервування впливали на рішення щодо хмарної інфраструктури?
З переходом дедалі більшої кількості систем ШІ в робочі середовища стійкість стане мінімальною вимогою. Якщо постачальник не може показати графіки й метрики часу безперебійної роботи та загальної стійкості, його навіть не розглядатимуть. Коли стійкість стане базовим очікуванням від усіх постачальників, вирішальними чинниками будуть користувацький досвід, оптимізація продуктивності, спостережуваність і можливості продукту вищого рівня. З часом такі компоненти, як шлюз ШІ та автоматичне перемикання в разі відмови, стануть основними елементами інфраструктури ШІ для підприємств.
Що в майбутньому насправді означатиме ШІ, «готовий до експлуатації», у світі, де від нього очікують постійної доступності, а не лише періодичної користі?
Готові до експлуатації системи ШІ мають бути спостережуваними, керованими та відновлюваними. Усі три вимоги обов’язкові.
Для спостережуваності ШІ в робочому середовищі командам потрібне глибоке розуміння поведінки моделей, затримок, частоти помилок, використання токенів, дрейфу та закономірностей відмов. Без розвиненої спостережуваності дуже важко виявити погіршення до того, як його почнуть помічати користувачі.
Керованість систем охоплює регулювання трафіку, обмеження частоти запитів, захисні механізми, забезпечення дотримання політик та інтелектуальну маршрутизацію між моделями й постачальниками. Тут шлюз ШІ стає фундаментом: він діє як централізований рівень керування, що застосовує захисні механізми, забезпечує послідовне управління й дозволяє динамічно перемикати моделі, коли продуктивність або надійність знижується.
Нарешті, для відновлюваності системи слід будувати з припущенням, що компоненти можуть бути частково або повністю несправними — через збої постачальників, погіршення якості моделей, обмеження частоти запитів або неочікувані вхідні дані від зловмисників. Автоматичне перемикання в разі відмови й механізми самовідновлення мають бути вбудовані в архітектуру, а не залежати від ручних процедур, які запускають лише після виникнення проблеми.
Саме в цьому напрямі ми працюємо в TrueFoundry. Постачальники, які так визначають готовність до експлуатації, поєднуючи спостережуваність, централізоване керування й автоматичне відновлення, здобудуть довгострокову довіру клієнтів і зможуть і далі розв’язувати нові проблеми в міру їх появи.
Дякую за чудове інтерв’ю. Читачі, які бажають дізнатися більше, можуть відвідати TrueFoundry.


