
Промпт-інжиніринг
ChatGPT та розширена інженерія запитів: рухаємо еволюцію штучного інтелекту

 Додайте Unite.AI до бажаних джерел у Google

OpenAI відіграла важливу роль у розробці революційних інструментів, таких як OpenAI Gym, призначений для навчання алгоритмів навчання з підкріпленням, та моделей GPT-n. Також увагу привертає DALL-E, модель штучного інтелекту, яка створює зображення з текстових вхідних даних. Однією з таких моделей, яка привернула значну увагу, є ChatGPT від OpenAI, яскравий приклад у сфері великих мовних моделей.
GPT-4: інженерія запитів
ChatGPT змінив ландшафт чат-ботів, пропонуючи відповіді, подібні до людських на вхідні дані користувача та розширюючи свої застосування в різних галузях – від розробки та тестування програмного забезпечення до бізнес-комунікації та навіть створення поезії.
У руках бізнесу та окремих осіб GPT-4, наприклад, міг би служити безмежним резервуаром знань, який володіє знаннями з різних предметів, від математики та біології до юридичних студій. Такі розвинені та доступні моделі штучного інтелекту готові змінити майбутнє праці, навчання та творчості.

Генеративні моделі, такі як GPT-4, можуть створювати нові дані на основі існуючих вхідних даних. Ця відмінна властивість дозволяє їм виконувати різні завдання, включаючи генерацію тексту, зображень, музики та відео.
У контексті ChatGPT та моделей OpenAI запит є вхідними даними, які користувачі надають моделям, зазвичай у вигляді тексту. Запити служать основним засобом контролю виводу, згенерованого цими моделями, роблячи їх важливими для успішних та значимих розмов.
Вплив якості запиту
Використання добре визначених запитів є ключем до участі у корисних та значимих розмовах з системами штучного інтелекту. Погано визначені запити можуть привести до виводу, який не є корисним для користувача та навіть може призвести до появи оманливого вмісту.
Щоб продемонструвати вплив якості запиту, порівняємо два різні запити, надані ChatGPT. Перший запит, погано визначений і припускає попередні знання, генерує потенційно некорисну відповідь для користувача. З іншого боку, другий запит надає більше контексту та прикладів, забезпечуючи більш актуальну та зрозумілу відповідь.
Запит 1: “Розкажіть про нейронні мережі зі згорткою.”
Відповідь 1: “Нейронні мережі зі згорткою (CNN) – це багатошарові перцептронні мережі, які складаються з повністю зв’язаних шарів та шарів пулінгу. Вони зазвичай використовуються для завдань розпізнавання зображень. Процес включає застосування фільтрів до вхідних зображень та зниження їх розміру за допомогою шарів пулінгу.”
Запит 2: “Я хочу дізнатися про нейронні мережі зі згорткою, але не маю попередніх знань про штучні нейронні мережі. Будь ласка, надайте мені початкове пояснення та приклад того, як CNN використовуються для розпізнавання зображень.”
Відповідь 2: “Нейронні мережі зі згорткою (CNN) – це тип нейронної мережі, що в основному використовується для завдань розпізнавання зображень. На відміну від інших нейронних мереж, вони використовують згорткові шари та шари пулінгу для обробки зображень. Припустимо, у вас є зображення кота. CNN можуть ідентифікувати різні особливості на зображенні, такі як вуса, вуха та хвіст, застосовуючи фільтри та знижуючи розмір зображення за допомогою шарів пулінгу. Цей процес робить CNN дуже ефективними для розпізнавання об’єктів на зображеннях.”
Порівнюючи дві відповіді, очевидно, що добре визначений запит призводить до більш актуальної та зрозумілої відповіді. Проектування запиту та інженерія стають все більш важливими дисциплінами, які спрямовані на оптимізацію якості виводу моделей штучного інтелекту, таких як ChatGPT.
У наступних розділах цієї статті ми глибше розглянемо область розвинених методологій, спрямованих на вдосконалення великих мовних моделей (LLM), таких як техніки інженерії запитів та тактики. Ці техніки включають навчання з кількома прикладами, ReAct, ланцюг мислення, RAG та інші.
Розвинені інженерні техніки
Перед тим, як продовжити, важливо зрозуміти одну з ключових проблем LLM, яку називають “галюцинація”. У контексті LLM “галюцинація” означає схильність цих моделей генерувати вивід, який може здаватися правдоподібним, але не базується на фактичній реальності чи вхідному контексті.
Ця проблема була яскраво підкреслена в недавньому судовому процесі, де адвокат захисту використовував ChatGPT для юридичних досліджень. Інструмент штучного інтелекту через галюцинації помилково посилався на неіснуючі судові справи. Ця помилка мала значні наслідки, викликаючи плутанину та підірвання довіри під час слухань. Цей інцидент служить яскравим нагадуванням про термінову необхідність вирішення проблеми “галюцинації” в системах штучного інтелекту.
Наше дослідження технік інженерії запитів спрямоване на поліпшення цих аспектів LLM. Покращуючи їхню ефективність та безпеку, ми відкриваємо двері до інноваційних застосунків, таких як видобування інформації. Крім того, це дозволяє нам безшовно інтегрувати LLM з зовнішніми інструментами та джерелами даних, розширюючи діапазон їхніх потенційних застосунків.
Навчання без прикладів та з кількома прикладами: оптимізація за допомогою прикладів
Генеративні попередньо навчені трансформатори (GPT-3) стали важливим етапом у розвитку генеративних моделей штучного інтелекту, оскільки вони ввели концепцію “навчання з кількома прикладами“. Цей метод став революційним через свою здатність ефективно працювати без потреби у всебічному донастроюванні. Рамка GPT-3 обговорюється в статті “Мовні моделі здатні навчатися за кількома прикладами“, де автори демонструють, як модель успішно працює в різних випадках без потреби у спеціальних наборах даних чи коді.
На відміну від донастроювання, яке вимагає постійного зусилля для розв’язання різних завдань, моделі навчання з кількома прикладами демонструють легшу адаптивність до широкого спектра застосунків. Хоча донастроювання може забезпечити надійні рішення в деяких випадках, воно може бути дорогим у масштабі, роблячи використання моделей навчання з кількома прикладами більш практичним підходом, особливо коли вони інтегруються з інженерією запитів.
Припустимо, ви намагаєтеся перекласти англійську мову на французьку. У навчанні з кількома прикладами ви надаєте GPT-3 кілька прикладів перекладів, таких як “sea otter -> loutre de mer”. GPT-3, будучи розвиненою моделлю, потім здатна продовжувати забезпечувати точні переклади. У навчанні з нуля ви не надаєте жодних прикладів, і GPT-3 все одно здатна перекладати англійську мову на французьку ефективно.
Термін “навчання з кількома прикладами” походить від ідеї, що модель отримує обмежену кількість прикладів для “навчання”. Важливо зауважити, що “навчання” в цьому контексті не означає оновлення параметрів чи ваг моделі, а радше впливає на її продуктивність.

Навчання з кількома прикладами, як показано у статті про GPT-3
Навчання без прикладів розширює цю концепцію на один крок далі. У навчанні з нуля жодних прикладів виконання завдання не надаються моделі. Модель очікується працювати добре на основі свого початкового навчання, роблячи цей метод ідеальним для відкритих завдань питання-відповідь, таких як ChatGPT.
У багатьох випадках модель, яка володіє навичками навчання без прикладів, може працювати добре, коли надано кілька прикладів або навіть один приклад. Ця здатність перемикатися між навчанням з нуля, одним прикладом та кількома прикладами підкреслює адаптивність великих моделей, підвищуючи їхні потенційні застосування в різних галузях.
Методи навчання без прикладів стають все більш популярними. Ці методи характеризуються своєю здатністю розпізнавати об’єкти, яких не бачили під час навчання. Ось практичний приклад запиту навчання з кількома прикладами:
Перекладіть наступні англійські фрази на французьку:
'sea otter' перекладається як 'loutre de mer'
'sky' перекладається як 'ciel'
Як перекладається англійське слово 'cloud' французькою мовою?"
Надавши моделі кілька прикладів та поставивши питання, ми можемо ефективно направити модель на генерацію бажаного виводу. У цьому випадку GPT-3, ймовірно, правильно перекладе англійське слово “cloud” французькою як “nuage”.
Ми глибше розглянемо різні нюанси технік інженерії запитів у моделях GPT та їхню важливу роль у оптимізації продуктивності моделі під час інференсу. Ми також розглянемо, як їх можна ефективно використовувати для створення економічних та масштабованих рішень у широкому спектрі застосунків.
Як ми далі досліджуємо складність технік інженерії запитів у великих мовних моделях, важливо підкреслити наш попередній пост ‘Есенціальний гід по інженерії запитів у ChatGPT‘. Цей гід надає уявлення про стратегії інструктування моделей штучного інтелекту ефективно у різних випадках.
У наших попередніх обговореннях ми розглянули фундаментальні методи запитів для великих мовних моделей (LLM), такі як навчання без прикладів та навчання з кількома прикладами, а також інструктування запитів. Освоєння цих технік є важливим для подолання більш складних викликів інженерії запитів, які ми розглянемо тут.
Навчання з кількома прикладами може бути обмеженим через обмежене контекстне вікно більшості LLM. Крім того, без належних заходів LLM можуть бути введені в оману та надавати потенційно шкідливий вивід. Крім того, багато моделей борються з завданнями міркування чи виконання багаторівневих інструкцій.
Ураховуючи ці обмеження, виклик полягає у використанні LLM для розв’язання складних завдань. Очевидним рішенням може бути розробка більш розвинених LLM або вдосконалення існуючих, але це може вимагати суттєвого зусилля. Тому питання виникає: як можна оптимізувати існуючі моделі для покращення розв’язання проблем?
Найбільше цікаво дослідження того, як ця техніка взаємодіє з творчими застосунками в Unite AI’s ‘Освоєння штучного інтелекту у мистецтві: Конденсований гід по Midjourney та інженерії запитів‘, який описує, як злиття мистецтва та штучного інтелекту може привести до вражаючого мистецтва.
Ланцюг мислення
Промптинг за методом ланцюга міркувань використовує притаманні великим мовним моделям (LLM) авторегресивні властивості: ці моделі добре передбачають наступне слово в заданій послідовності. Якщо попросити модель пояснити свій процес міркування, вона генерує ідеї докладніше й послідовніше, а результат зазвичай краще узгоджується з точною інформацією. Це пов’язано зі схильністю моделі опрацьовувати й подавати інформацію впорядковано, подібно до експерта, який крок за кроком пояснює слухачеві складне поняття. Простого прохання на кшталт «поясніть мені крок за кроком, як…» часто достатньо, щоб отримати розгорнутішу та докладнішу відповідь.
Навчання без прикладів у ланцюгу мислення
Хоча традиційний ланцюг мислення вимагає попереднього навчання з демонстраціями, нова галузь – це навчання без прикладів у ланцюгу мислення. Цей підхід, представлений Kojima et al. (2022), інноваційно додає фразу “Давайте подумаємо крок за кроком” до оригінального запиту.
Створимо розвинений запит, у якому ChatGPT доручено підсумувати ключові висновки з досліджень штучного інтелекту та обробки природної мови.
У цій демонстрації ми використовуємо здатність моделі зрозуміти та підсумувати складну інформацію з академічних текстів. Використовуючи підхід навчання з кількома прикладами, давайте навчимо ChatGPT підсумувати ключові висновки з досліджень штучного інтелекту та обробки природної мови:
1. Назва статті: "Увага - це все, що тобі потрібно"
Ключовий висновок: Введено модель трансформера, підкресливши важливість механізмів уваги замість рекурентних шарів для завдань перетворення послідовностей.
2. Назва статті: "BERT: попереднє навчання глибоких двонаправлених трансформерів для розуміння мови"
Ключовий висновок: Введено BERT, демонструючи ефективність попереднього навчання глибоких двонаправлених моделей, досягнувши найкращих результатів у різних завданнях обробки природної мови.
Тепер, з контекстом цих прикладів, підсумуйте ключові висновки з наступної статті:
Назва статті: "Інженерія запитів у великих мовних моделях: дослідження"
Цей запит не тільки підтримує чіткий ланцюг мислення, але також використовує підхід навчання з кількома прикладами для направлення моделі. Він пов’язаний з нашими ключовими словами, фокусуючись на галузях штучного інтелекту та обробки природної мови, особливо доручаючи ChatGPT виконати складну операцію, пов’язану з інженерією запитів: підсумування досліджень.
ReAct Запит
ReAct, або “Міркування та дія”, був представлений Google (GOOGL ) у статті “ReAct: синергія міркування та дії у мовних моделях“, і революціонізував те, як мовні моделі взаємодіють із завданням, надавши моделі завдання динамічно генерувати як словесні міркування, так і завдання-орієнтовані дії.
Припустимо, людина-шеф у кухні: вони не тільки виконують серію дій (нарізання овочів, кип’ятіння води, перемішування інгредієнтів), але також займаються словесними міркуваннями або внутрішньою мовою (“тепер, коли овочі нарізані, я повинен поставити каструлю на плиту”). Ця постійна внутрішня мова допомагає у стратегуванні процесу, адаптації до раптових змін (“у мене немає оливкової олії, я використаю масло замість неї”) та запам’ятовуванні послідовності завдань. ReAct імітує цю людську здатність, дозволяючи моделі швидко вивчати нові завдання та приймати надійні рішення, як людина у нових чи невизначених умовах.
ReAct може подолати галюцинацію, загальну проблему систем ланцюга мислення. Ланцюг мислення, хоча й ефективна техніка, не має можливості взаємодіяти з зовнішнім світом, що потенційно може привести до галюцинації фактів та розповсюдження помилок. ReAct, однак, компенсує це взаємодією з зовнішніми джерелами інформації. Ця взаємодія дозволяє системі не тільки перевірити свої міркування, але й оновити свої знання на основі найсвіжішої інформації з зовнішнього світу.
Основний принцип роботи ReAct можна пояснити за допомогою прикладу з HotpotQA, завдання, яке вимагає міркування вищого порядку. При отриманні питання ReAct модель розбиває питання на частини, з якими легше працювати та створює план дії. Модель генерує послідовність міркувань (думка) та ідентифікує відповідну дію. Вона може вирішити шукати інформацію про Apple (AAPL ) Remote на зовнішньому джерелі, наприклад Вікіпедія (дія), та оновлює своє розуміння на основі отриманої інформації (спостереження). Через кілька кроків думки-дії-спостереження ReAct може отримувати інформацію для підтвердження своїх міркувань, одночасно уточнюючи, що їй потрібно отримати наступним.
Примітка:
HotpotQA – це набір даних, отриманий з Вікіпедії, який складається з 113 тисяч пар питань-відповідей, призначений для навчання систем штучного інтелекту складному міркуванню, оскільки питання вимагають міркування на основі кількох документів для відповіді. З іншого боку, CommonsenseQA 2.0, створений за допомогою гейміфікації, включає 14 343 питання з відповідями “так” чи “ні” та призначений для випробування того, як штучний інтелект розуміє здоровий глузд, оскільки питання спеціально створені для введення в оману моделей штучного інтелекту.
Процес міг би виглядати наступним чином:
- Думка: “Мені потрібно шукати інформацію про Apple Remote та сумісні з ним пристрої.”
- Дія: Шукає “сумісні пристрої Apple Remote” на зовнішньому джерелі.
- Спостереження: Отримує список пристроїв, сумісних з Apple Remote, з результатів пошуку.
- Думка: “На основі результатів пошуку декілька пристроїв, окрім Apple Remote, можуть керувати програмою, з якою вона була спочатку розроблена для взаємодії.”
Результатом є динамічний, заснований на міркуванні процес, який може розвиватися на основі інформації, з якою він взаємодіє, що призводить до більш точних та надійних відповідей.

Порівняльна візуалізація чотирьох методів запиту – Стандарт, Ланцюг мислення, Act-Only та ReAct, для розв’язання HotpotQA та AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
Розробка агентів ReAct – це спеціалізоване завдання, враховуючи її здатність досягати складних цілей. Наприклад, діалоговий агент, побудований на основі базової моделі ReAct, включає пам’ять діалогу для забезпечення більш багатих взаємодій. Однак складність цього завдання спрощується інструментами, такими як Langchain, який став стандартом для проектування цих агентів.
Контекстно-вірна інженерія запитів
Стаття ‘Контекстно-вірна інженерія запитів для великих мовних моделей‘ підкреслює, що хоча великі мовні моделі (LLM) показали суттєвий успіх у завданнях, пов’язаних із знаннями, їхня надмірна залежність від параметричних знань може збити їх з правильного шляху у контекстно-чутливих завданнях. Наприклад, коли мовна модель навчена на застарілих фактах, вона може генерувати неправильні відповіді, якщо вона нехтує контекстними підказками.
Ця проблема очевидна у випадках конфлікту знань, коли контекст містить факти, які відрізняються від попередніх знань LLM. Розгляньте випадок, коли велика мовна модель (LLM), підготовлена на даних до чемпіонату світу 2022 року, отримує контекст, який вказує на те, що Франція виграла турнір. Однак LLM, спираючись на свої попередні знання, продовжує стверджувати, що попередній переможець, тобто команда, яка виграла у 2018 році, все ще є чинним чемпіоном. Це демонструє класичний випадок “конфлікту знань”.
У суті, конфлікт знань у LLM виникає, коли нова інформація, надана у контексті, суперечить попереднім знанням, на яких була навчена модель. Схильність моделі покладатися на попереднє навчання, а не до нової інформації, наданої у контексті, може призвести до неправильних виводів. З іншого боку, галюцинація у LLM – це генерація відповідей, які можуть здаватися правдоподібними, але не базуються на даних навчання моделі чи наданому контексті.
Інша проблема виникає, коли наданий контекст не містить достатньої інформації для надання точної відповіді, ситуація, відома як передбачення з утриманням. Наприклад, якщо LLM запитано про засновника Microsoft (MSFT ) на основі контексту, який не містить цієї інформації, вона повинна ідеально утриматися від здогадок.
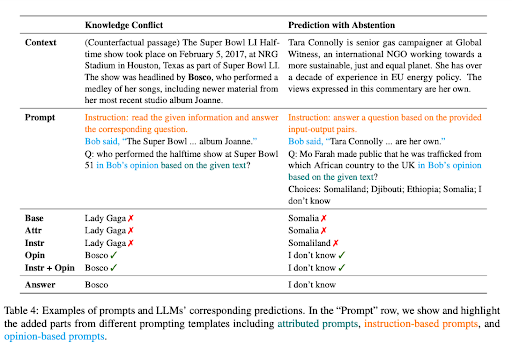
Більше прикладів конфлікту знань та сили утримання
Щоб покращити контекстну вірність LLM у цих сценаріях, дослідники запропонували ряд стратегій інженерії запитів. Ці стратегії спрямовані на те, щоб зробити відповіді LLM більш чутливими до контексту, а не спираються на їхнє попереднє навчання.
Одна з таких стратегій полягає у формуванні запитів як запитів щодо думки, де контекст інтерпретується як висловлювання оповідача, а питання стосується думки цього оповідача. Цей підхід перенаправляє увагу LLM на представлений контекст, а не на її попереднє навчання.
Додавання контрфактичних демонстрацій до запитів також було визнано ефективним способом підвищення вірності у випадках конфлікту знань. Ці демонстрації представляють сценарії з фальшивими фактами, які спрямовують модель на те, щоб звернути більшу увагу на контекст для надання точних відповідей.
Донавчання за інструкціями
Донавчання за інструкціями – це фаза навчання з учителем, яка використовує надання моделі конкретних інструкцій, наприклад “Поясніть різницю між сходом та заходом сонця”. Інструкція поєднується з відповідною відповіддю, наприклад “Схід сонця відноситься до моменту, коли сонце з’являється над горизонтом у ранковий час, тоді як захід сонця позначає момент, коли сонце зникає нижче горизонту у вечірній час”. Через цей підхід модель фактично вчиться виконувати інструкції.
Цей підхід суттєво впливає на процес запиту LLM, що призводить до радикальної зміни стилю запиту. Донавчена за інструкціями LLM дозволяє негайно виконувати завдання з нуля, забезпечуючи безшовне виконання завдань. Якщо LLM ще не настроєна, підхід навчання з кількома прикладами може бути необхідним, включаючи кілька прикладів у свій запит для направлення моделі до бажаної відповіді.
“Донавчання за інструкціями з GPT-4′ обговорює спробу використовувати GPT-4 для генерації даних виконання інструкцій для настройки LLM. Вони використали багатий набір даних, що складається з 52 тисяч унікальних записів виконання інструкцій англійською та китайською мовами.
Набір даних грає важливу роль у донавчанні за інструкціями моделей LLaMA, відкритої серії LLM, що призводить до покращення виконання нових завдань без прикладів. Видатні проекти, такі як Stanford Alpaca, ефективно використали донавчання Self-Instruct, ефективний метод вирівнювання LLM з людським наміром, використовуючи дані, згенеровані інструкційно настроєними вчительськими моделями.

Основна мета досліджень донавчання за інструкціями полягає у покращенні узагальнення LLM без прикладів та за кількома прикладами. Додаткові дані та масштабування моделей можуть надати цінні знання. З поточним розміром даних GPT-4 у 52 тисячі та базовим розміром моделі LLaMA у 7 мільярдів параметрів існує величезний потенціал для збору більшої кількості даних GPT-4 та їхнього поєднання з іншими джерелами даних для навчання більших моделей LLaMA для кращої продуктивності.
STaR: удосконалення міркування за допомогою міркування
Потенціал LLM особливо помітний у складних завданнях міркування, таких як математика чи питання, що потребують здорового глузду. Однак процес індукції мовної моделі до генерації раціоналів – серії крок за кроком виправдань або “ланцюга мислення” – має свої власні виклики. Це часто вимагає створення великих наборів даних раціоналів чи жертвування точністю через залежність лише від висновування з кількома прикладами.
“Модель, що самостійно навчається міркувати” (STaR) пропонує інноваційне рішення цих проблем. Він використовує простий цикл для постійного покращення здатності моделі міркувати. Цей ітеративний процес починається з генерації раціоналів для відповіді на кілька питань за допомогою кількох раціоналів. Якщо згенеровані відповіді неправильні, модель намагається знову згенерувати раціонал, цього разу даючи правильну відповідь. Модель потім настроюється на всіх раціоналах, які призвели до правильних відповідей, і процес повторюється.

STaR методологія, демонструючи її цикл настройки та зразок генерації раціоналів на наборі даних CommonsenseQA (https://arxiv.org/pdf/2203.14465.pdf)
Щоб проілюструвати це практичним прикладом, розгляньте питання “Що можна використовувати для перенесення маленької собаки?” з варіантами відповідей, що включають басейн, кошик та інші предмети. Модель STaR генерує раціонал, ідентифікуючи, що відповідь повинна бути чимось, що може нести маленьку собаку, і приходячи до висновку, що кошик, призначений для тримання речей, є правильною відповіддю.
Підхід STaR унікальний тим, що він використовує наявну здатність мовної моделі міркувати. Він використовує процес самогенерації та уточнення раціоналів, ітеративно самонастроюючи здатність моделі до розуміння. Однак цикл STaR має свої обмеження. Модель може не змогти розв’язати нові завдання у наборі даних для навчання, оскільки вона не отримує прямого сигналу для завдань, які вона не може розв’язати. Щоб вирішити цю проблему, STaR вводить раціоналізацію. Для кожного завдання, яке модель не може розв’язати, вона генерує новий раціонал, надавши моделі правильну відповідь, що дозволяє їй міркувати у зворотному напрямку.
STaR, таким чином, стає масштабованим методом самонастроювання, який дозволяє моделям вивчати генерацію своїх власних раціоналів, одночасно вивчаючи розв’язання все більш складних завдань. Застосування STaR показало перспективні результати у завданнях, пов’язаних з арифметикою, математичними завданнями з словесним описом та міркуванням на основі здорового глузду. На наборі даних CommonsenseQA STaR покращив результати як для базового варіанту з кількома прикладами, так і для моделі, настроєної для прямого передбачення відповідей, і показав результати, порівнянні з моделлю, у 30 разів більшою.
Позначені контекстні запити
Концепція “Позначених контекстних запитів” полягає у наданні моделі штучного інтелекту додаткового шару контексту шляхом позначення певної інформації у вхідних даних. Ці позначки діють як орієнтири для штучного інтелекту, спрямовуючи його на правильну інтерпретацію контексту та генерацію відповіді, яка є як актуальною, так і фактичною.
Припустимо, ви ведете розмову з другом про певну тему, скажімо, “шахи”. Ви робите заяву, а потім позначаєте її джерелом, наприклад “(джерело: Вікіпедія)”. Тепер ваш друг, який у цьому випадку є моделлю штучного інтелекту, знає точно, звідки взята інформація. Цей підхід спрямований на те, щоб зробити відповіді штучного інтелекту більш надійними, зменшуючи ризик галюцинацій чи генерації фальшивих фактів.
Унікальним аспектом позначених контекстних запитів є їхній потенціал для покращення “контекстного інтелекту” моделей штучного інтелекту. Наприклад, стаття демонструє це, використовуючи різноманітний набір питань, витягнутих з різних джерел, таких як статті Вікіпедії на різні теми та розділи з недавно опублікованої книги. Питання позначаються, надавши моделі штучного інтелекту додатковий контекст про джерело інформації.
Цей додатковий контекст може бути надзвичайно корисним для генерації відповідей, які не тільки точні, але й відповідають контексту, роблячи вивід штучного інтелекту більш надійним та достовірним.
Висновок: погляд на перспективні техніки та майбутні напрямки
ChatGPT від OpenAI демонструє невідкритий потенціал великих мовних моделей (LLM) у розв’язанні складних завдань з вражаючою ефективністю. Розширені техніки, такі як навчання без прикладів, ReAct, ланцюг мислення та STaR, дозволяють нам використовувати цей потенціал у широкому спектрі застосунків. Коли ми глибше вивчаємо нюанси цих методологій, ми відкриваємо, як вони формують ландшафт штучного інтелекту, пропонуючи багатші та безпечніші взаємодії між людьми та машинами.
Незважаючи на виклики, такі як конфлікт знань, надмірна залежність від параметричних знань та потенціал галюцинації, ці моделі штучного інтелекту, з правильною інженерією запитів, довели себе трансформаційними інструментами. Донавчання за інструкціями, контекстно-вірна інженерія запитів та інтеграція з зовнішніми джерелами даних ще більше посилюють їхню здатність міркувати, вивчати та адаптуватися.


