
Найкраще
10 найкращих інструментів ШІ для вебскрейпінгу (листопад 2026)

 Додайте Unite.AI до бажаних джерел у Google
Unite.AI може отримувати винагороду, коли ви використовуєте посилання на переглянуті нами продукти. Це не впливає на наші редакційні оцінки. Читайте розкриття про партнерські зв’язки.
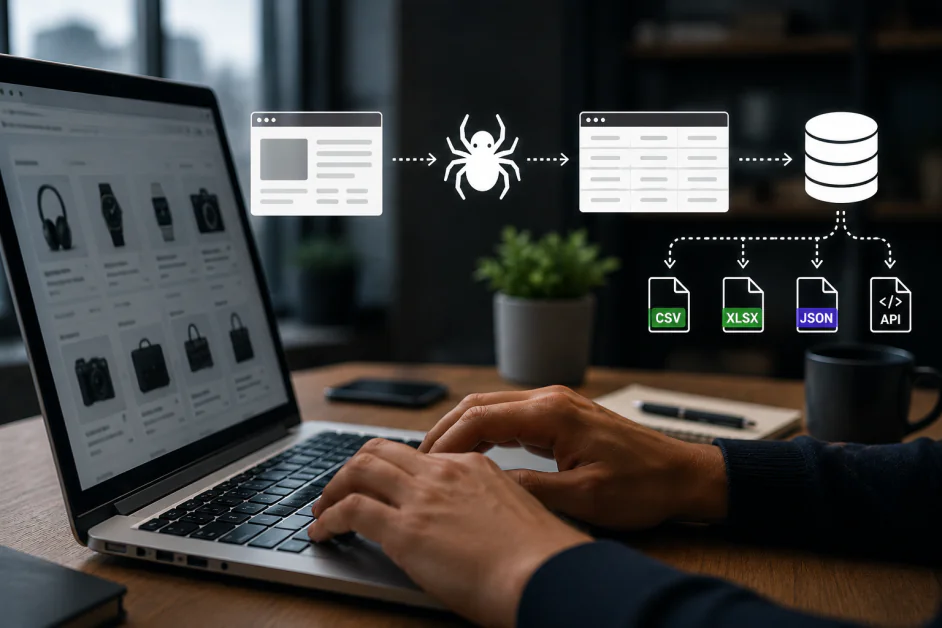
Ключові моментиПідбирайте інструмент збору даних відповідно до завдання після завантаження сторінки, а…
Показати більше
- Підбирайте інструмент збору даних відповідно до завдання після завантаження сторінки, а не розглядайте весь збір як одну проблему.
- Призначайте відповідальність за робочий процес людям, які розуміють як сайти-джерела, так і потрібний результат.
- Плануйте бюджет виходячи з придатних для використання записів, а не з заявленої кількості запитів, оскільки рендеринг і проксі завищують підсумкові показники.
Найкращий інструмент ШІ для вебскрейпінгу залежить від того, що ви хочете робити після завантаження сторінки. Помічнику з досліджень потрібні текст, який легко читати, і посилання на джерела. Системі ринкової аналітики — узгоджені записи у великому масштабі. Інтерактивному агенту може знадобитися браузер, здатний переходити за кількома кроками й зберігати активний сеанс.
У цьому посібнику розглянуто десять інструментів для виконання таких завдань: платформи для збору даних корпоративного рівня, API для контенту, скрейпери без коду, сервіси пошукових даних і керовані браузери. Ми оцінюємо, як кожен продукт збирає інформацію, хто може підтримувати робочий процес і які компроміси слід враховувати, коли прототип стає регулярним процесом.
Наша команда незалежно оцінила кожне рішення в цьому посібнику, розглянувши його можливості, практичні переваги, обмеження та відповідність сценаріям використання, відображеним у нашому рейтингу.
Порівняння найкращих інструментів ШІ для вебскрейпінгу
| Інструмент ШІ | Найкраще підходить для | Основні переваги |
|---|---|---|
| Bright Data | Збору даних корпоративного рівня та різноманітних конвеєрів даних | Scraper APIs, Browser API, Scraper Studio, набори даних, проксі |
| Firecrawl | Вебконтенту для застосунків зі штучним інтелектом | Пошук, скрейпінг, побудова мапи, обхід сайтів, Markdown, JSON, взаємодія, MCP |
| Apify | Багаторазового використання завдань зі скрейпінгу та хмарної оркестрації | Actors, Crawlee, розклади, сховища, проксі, API, MCP |
| Browse AI | Збору даних без коду та відстеження змін | Налаштування за допомогою ШІ, роботи, сповіщення, розклади, інтеграції |
| SearchAPI | Структурованих результатів пошуку та локалізованих досліджень | Google, Maps, покупки, відео, пошукові інтерфейси ШІ, JSON |
| Octoparse | Візуального скрейпінгу з повторюваним виконанням у хмарі | Шаблони, AI Assistant, автоматичне виявлення, запуски в хмарі, експорт |
| Browserless | Керованих браузерів для Puppeteer і Playwright | Браузери на хостингу, постійні сеанси, REST API, MCP |
| ScrapingBee | Керованого вилучення даних через API застосунку | Вилучення даних за допомогою ШІ, CSS/XPath, Markdown, сценарії JS, MCP |
| Oxylabs | Керованого отримання даних із вимогливих публічних сайтів | Web API /Scrape, рендеринг, структурований вивід, MCP |
| Diffbot | Автоматичного вилучення даних та аналітики сутностей | Extract, стандартні схеми, Crawl, Knowledge Graph |
Як вибрати інструмент ШІ для вебскрейпінгу
Доберіть інструмент відповідно до завдання
Для бази знань на основі ШІ важливі текст, який легко читати, структурований вивід і збереження URL-адрес джерел. Для регулярних бізнес-досліджень візуальний робот і сповіщення про зміни можуть бути важливішими за програмний інтерфейс. Для інтерактивного агента зверніть увагу на безперервність сеансів і керування браузером. API результатів пошуку вирішують інше завдання: вони надають пошукові дані, а збір інформації зі сторінок за посиланнями — це окремий крок.
Визначте, хто відповідатиме за робочий процес
Платформа без коду дає аналітику змогу самостійно налаштовувати етапи вилучення даних. API надає розробникам зручний інтерфейс для інтеграції збору даних у застосунок. Хмарна платформа для завдань додає планування запусків і сховище, тоді як керований браузер залишає більше логіки автоматизації вашій команді. Правильний вибір дає змогу доручити підтримку тим, хто розуміє і вебсайти-джерела, і потрібний формат результату.
Плануйте бюджет на корисні записи, а не на гучні цифри запитів
Порівнюйте вартість виконаного завдання з набором потрібних вам полів. На загальну суму можуть вплинути рендеринг, преміумпроксі, тривалість роботи браузера, вилучення даних за допомогою ШІ, сховище та повторні спроби. Безплатний кредит, одиниця використання браузера й пошуковий запит — це різні показники. Для регулярної роботи разом із кількістю успішних відповідей відстежуйте повноту даних, дублікати, актуальність і вартість кожного придатного до використання запису.
10 найкращих інструментів ШІ для вебскрейпінгу
1. Bright Data
Bright Data — наша найкраща рекомендація для організацій, яким потрібно збирати вебдані різними способами на одній платформі. Серед доступних рішень — готові Scraper APIs, попередньо зібрані набори даних, Scraper Studio, Web Unlocker і проксі-сервіси. Наприклад, команда, що займається аналітикою електронної торгівлі, може використовувати структуровані канали даних для відомих роздрібних мереж і водночас налаштувати власний збір даних для спеціалізованого маркетплейсу. Завдяки такому широкому вибору платформа особливо корисна, коли робота з даними охоплює не один сайт чи відділ.
Для інтерактивних сторінок Browser API надає браузери, якими розробники керують за допомогою Puppeteer, Playwright або Selenium. Він поєднує роботу браузера з керуванням проксі та обробкою CAPTCHA, а підтримка Chrome DevTools допомагає інженерам перевіряти проблемні сеанси. Це корисно, коли для отримання потрібної інформації робочий процес має спершу перейти на сторінку або взаємодіяти з нею, а не просто завантажити готовий набір даних.
Основний компроміс полягає у виборі продуктів і контролі витрат. Трафік браузера, результати вебскрейпінгу й придбання наборів даних — це різні робочі навантаження, тож одна загальна ціна не може описати всю платформу. Bright Data підходить командам, у яких є відповідальний за якість збору даних, охоплення цільових ресурсів і витрати. Проєкт із вузьким завданням може швидше перейти у виробниче середовище завдяки простішому API для вилучення даних.
Переваги й недоліки
- Широкий вибір способів збору даних на одній платформі
- Браузери в хмарі підтримують поширені бібліотеки автоматизації
- Готові API та набори даних скорочують час на налаштування
- Для різних продуктів потрібно окремо планувати витрати
- Для власних конвеєрів і далі потрібен відповідальний інженер
2. Firecrawl
Firecrawl — наш вибір для розробників, які перетворюють вебконтент на корисний контекст для застосунків зі штучним інтелектом. Його інструменти для пошуку, вебскрейпінгу, побудови мапи сайту й обходу вебсторінок охоплюють увесь шлях — від пошуку сторінки до збору даних із сайту, а формати Markdown і структурований JSON зменшують обсяг очищення даних після їх отримання. Завдяки цьому дослідницький помічник або продукт бази знань може приділяти більше уваги відповідям на запитання й менше — видаленню навігаційних меню із сирого HTML.
Нинішня пропозиція Interact розширює платформу, додаючи можливість працювати безпосередньо в браузері. Агенти можуть описувати дії природною мовою або виконувати код у браузері, зберігати стан між викликами й повторно використовувати автентифіковані профілі. Це суттєве доповнення для сторінок, на яких перед вилученням даних потрібно натискати кнопки, застосовувати фільтри або входити в обліковий запис. Підтримка MCP і командного рядка також дає змогу використовувати Firecrawl у робочих процесах розробки агентів, а не лише як звичайний API застосунку.
Firecrawl найкраще підходить, коли першочергове завдання — отримати контент, а застосунок уже має засоби для його зберігання та пошуку. Командам і далі потрібно визначати межі обходу сайтів, зберігати URL-адреси джерел і розрізняти відсутнє поле та порожнє. Код із відкритим вихідним кодом пропонує ще один спосіб розгортання, однак командам слід оцінити конкретні функції та експлуатаційні вимоги обраного варіанта, а не вважати, що хмарна й самостійно керована версії однакові.
Переваги й недоліки
- Markdown і JSON добре підходять для конвеєрів ШІ
- Interact підтримує браузерні завдання зі збереженням стану
- Доступ через API, MCP і CLI
- Отриманий контент і далі потрібно перевіряти
- Самостійне розгортання потребує операційного супроводу
3. Apify
Apify — найкращий вибір у цьому огляді для команд, яким потрібні багаторазово використовувані інструменти для вебскрейпінгу та платформа для роботи з ними. На маркетплейсі поширюються Actors — готові програми, які приймають вхідні дані, запускаються в хмарі й повертають результати. Готові Actors можуть пришвидшити типові завдання зі збору даних, а власні Actors дають розробникам змогу зберігати й використовувати власну логіку їх вилучення. Завдяки цьому Apify допомагає перетворити експеримент на повторюване виробниче завдання.
Платформа також забезпечує важливі операційні функції, зокрема планування запусків, зберігання результатів, доступ до проксі, моніторинг та інтеграції. Розробники можуть створювати рішення за допомогою Crawlee — бібліотеки з відкритим вихідним кодом для обходу вебсторінок і автоматизації браузера. Сервер MCP від Apify надає агентам ШІ доступ до Actors, тож той самий готовий інструмент може працювати в застосунку, запланованому конвеєрі або помічнику без потреби створювати окрему реалізацію вебскрейпера для кожного інтерфейсу.
Вибору Actor слід приділяти не менше уваги, ніж вибору платформи. Різні розробники можуть пропонувати різні ціни, рівні підтримки й обслуговування, варіанти вхідних даних і якість результатів. Успішне виконання завдання також не означає, що зібрано всі очікувані записи. Apify найкраще підходить, коли є відповідальний за схему завдання, відстеження змін і планування бюджету на вибраний Actor та використання інфраструктури; для ручного збору даних з однієї сторінки така складна оркестрація зазвичай не потрібна.
Переваги й недоліки
- Готові й власні Actors працюють на одній платформі
- Планування запусків, зберігання даних і моніторинг допомагають виконувати завдання регулярно
- MCP інтегрує Actors у робочі процеси агентів
- Рівень обслуговування та якість Actors різняться
- Витрати на використання платформи й Actors потрібно враховувати в бюджеті
4. Browse AI
Browse AI — наша рекомендація для бізнес-користувачів, яким регулярно потрібні вебдані й які не хочуть розробляти для цього програмне забезпечення. Налаштування дає змогу зчитати надану сторінку, запропонувати структуру даних, а потім переглянути чи скоригувати поля. Навчання робота залишається ключовим етапом для повторюваного вилучення даних. Це практичний підхід для операційних і маркетингових команд, які збирають у звичні таблиці переліки товарів, записи з каталогів або інформацію про конкурентів.
Моніторинг — одна з особливо сильних сторін сервісу. Роботи можуть перевіряти сторінки за розкладом, виявляти нові або змінені дані й надсилати сповіщення з поясненням, що саме змінилося. Робочі процеси можуть об’єднувати збір даних із різних сторінок, а інтеграції через API, вебхуки та електронні таблиці допомагають передавати результати в інструменти, якими команда вже користується. Тож моніторинг цін може стати постійним бізнес-процесом, а не низкою ручних перевірок у браузері.
Простота використання не скасовує потреби чітко визначити дані. Користувачам варто вирішити, про які зміни потрібно сповіщати, і перевірити, чи правильно працюють розбиття на сторінки, етапи входу в обліковий запис і обробка порожніх результатів. Значні зміни дизайну сайту все ще можуть потребувати втручання. Browse AI найкраще підходить, коли бізнес-команда може переглядати витягнуті рядки даних і підтримувати робота в робочому стані; розробникам, яким потрібна суворо версіонована логіка роботи браузера, може більше підійти сервіс на основі коду.
Переваги та недоліки
- Налаштування полів за допомогою ШІ спрощує початок роботи
- Моніторинг за розкладом допомагає виявляти важливі зміни
- Інтеграції з електронними таблицями, API та вебхуками
- Значні зміни сайту можуть вимагати повторного навчання
- Складна логіка потребує ретельного проєктування робочого процесу
5. SearchAPI
SearchAPI — наша спеціалізована рекомендація для збору результатів пошуку у структурованому вигляді. Його API для Google може повертати посилання на результати й пошукові функції у форматі JSON, тож не потрібно підтримувати парсер для сторінки результатів, яка постійно змінюється. Ширший каталог охоплює такі джерела, як Карти, покупки, новини, відео та підтримувані пошукові системи на базі ШІ. Сервіс особливо корисний, коли дані про те, що знаходять користувачі, і видимість у пошуку є кінцевим продуктом, а не проміжним етапом перед скануванням іншого сайту.
Локалізація — важлива перевага сервісу для таких завдань. Параметри місцезнаходження, країни, мови та пристрою дають змогу командам досліджувати ринок у заданому пошуковому контексті. SEO-застосунок може відстежувати запит в одному місті, а помічник-дослідник — знаходити відповідні джерела й зберігати отримані посилання для подальшого пошуку. Важливо враховувати документацію для конкретної пошукової системи, оскільки доступні параметри й поля результатів відрізняються залежно від пошукового продукту.
SearchAPI слід обирати відповідно до пошукових систем і полів, потрібних для конкретного робочого процесу. Результат пошуку не містить усього вмісту сторінки за посиланням, а розширені блоки результатів не завжди мають однакову структуру даних. Командам варто розрахувати потрібну кількість запитів, перевірити вимоги до пропускної здатності й передбачити коректну обробку відсутніх розділів результатів. Для вилучення даних із довільних сайтів або інтерактивної роботи в браузері краще почати з іншого інструмента з цього посібника.
Переваги та недоліки
- Структуровані результати усувають потребу підтримувати парсер сторінки результатів пошуку
- Широкий каталог пошукових та суміжних систем
- Детальні налаштування локалізації
- Результати пошуку не замінюють вилучення даних зі сторінок, на які ведуть посилання
- Поля й параметри залежать від пошукової системи
6. Octoparse
Octoparse демонструє свого ШІ-помічника Copilot і автоматизацію за участю людини. Відео: Octoparse.
Octoparse добре підходить аналітикам, які хочуть візуально налаштувати скрапер, а потім запускати його знову й знову. Нинішня платформа пропонує готові шаблони, налаштування за допомогою AI Assistant і автоматичне виявлення сторінок у настільному застосунку. Користувачі можуть удосконалювати створене завдання, а не починати з написання коду для браузера. Така гнучкість корисна для збору каталогів товарів, довідників або переліків, де послідовність сторінок не менш важлива, ніж поля на кожній із них.
Виконання завдань у хмарі перетворює підготовлене завдання на регулярний процес збору даних, для якого не потрібно постійно тримати ввімкненим особистий комп’ютер. Планування, паралельне виконання, ротація IP-адрес і підключення для експорту допомагають масштабувати завдання, що переросли можливості настільного прототипу. Візуальний підхід особливо привабливий для команд, які розуміють особливості вихідних сайтів і вимоги до даних, але не хочуть підтримувати власний сервіс автоматизації браузера.
Щоб ефективно користуватися Octoparse, потрібно ретельно проєктувати завдання. Розбиття на сторінки, нескінченне прокручування, кроки заповнення форм і дублікати записів можуть змінити зміст результатів, хоча на перший погляд завдання виконалося успішно. Можливості хмарного виконання та функції тарифного плану мають відповідати запланованому графіку й обсягу робіт. Ми рекомендуємо цей інструмент командам, яким потрібен більший контроль над етапами вилучення даних, ніж дає швидкий інструмент із запуском одним натисканням, за умови, що є відповідальна особа, яка зможе коригувати завдання зі зміною вихідних сторінок.
Переваги та недоліки
- Шаблони та допомога ШІ спрощують налаштування
- Візуальне редагування дає змогу налаштовувати докладні завдання з вилучення даних
- Хмарне виконання завдань підтримує збір даних за розкладом
- Для складних сайтів потрібно доопрацьовувати завдання
- Доступність хмарних функцій залежить від вибраного тарифу
7. Browserless
Ми рекомендуємо Browserless розробникам, які хочуть керувати браузером, а його хостинг і масштабування доручити керованому сервісу. Наявні скрипти Puppeteer або Playwright можна під’єднати до віддалених браузерів, тому сервіс привабливий для проєктів, у яких уже працює код автоматизації. Це особливо корисно, коли збір даних передбачає кілька взаємодій, роботу з інтерфейсом із великою кількістю JavaScript або сесію, яка має тривати довше, ніж один простий запит.
Сервіс також надає REST API для скрейпінгу, створення знімків екрана й PDF-файлів, а також для користувацьких функцій браузера. Розміщений на платформі MCP-сервер надає агентам ШІ доступ до інструментів браузера, а функції сесій і автентифіковані профілі підтримують робочі процеси, яким потрібна безперервність. Тож Browserless підходить і розробникам, які створюють власні засоби збирання даних, і агентам, яким потрібно переходити сторінками та збирати інформацію у справжньому браузері.
Під час вибору сервісу важливо з’ясувати, як обліковується робота браузера. Наразі безплатний тариф передбачає 1 000 одиниць на місяць і два одночасно запущені браузери, а не 1 000 гарантованих скрейпінг-запитів. Час роботи браузера витрачає одиниці, а за проксі-трафік і успішне розв’язання CAPTCHA стягується додаткова плата; обмеження для сесій залежать від тарифу. Команди й надалі відповідають за логіку вилучення даних і перевірку результатів, тож Browserless найкраще підходить тоді, коли керування браузером важливіше за візуальний конструктор роботів.
Переваги й недоліки
- Зберігає звичні робочі процеси Puppeteer і Playwright
- REST API охоплюють скрейпінг і експорт вебсторінок
- Функції сесій і MCP підходять для інтерактивних агентів
- Час роботи браузера й додаткові функції впливають на витрату одиниць
- Для користувацького вилучення даних усе ще потрібна логіка застосунку
8. ScrapingBee
ScrapingBee — вдалий вибір для розробників, яким потрібен керований запит для скрейпінгу, а не безпосереднє керування браузером, що працює тривалий час. Його API поєднує отримання сторінок і рендеринг JavaScript з керуванням проксі, а дані можна вилучати за правилами CSS або XPath чи за допомогою інструкцій для ШІ. Такий підхід корисний для проєктів, яким потрібні структуровані записи з кількох вебсайтів, але які не хочуть самостійно обслуговувати парк браузерів.
Сценарії JavaScript можуть натискати кнопки, прокручувати сторінку, вводити текст або чекати перед збиранням даних. Формат Markdown підходить для робочих процесів із контентом на основі ШІ, а знімки екрана допомагають зафіксувати відрендерену сторінку. У поточній версії продукту також є спеціалізовані API для окремих цільових ресурсів, а ще доступ через CLI та MCP. Для стабільних полів розробник може використовувати чітко задані правила вилучення, а коли структура сторінки чи запит менш передбачувані — інструкції звичайною мовою.
Практична відмінність від платформи з розміщеним браузером полягає в тому, що ScrapingBee зосереджується на запиті та поверненому результаті, тоді як ширше керування завданням залишається за користувацьким застосунком. Для координації обробки кількох сторінок, усунення дублікатів, планування оновлень і перевірки записів усе ще потрібне окреме рішення. Витрата кредитів також змінюється залежно від використовуваних функцій, зокрема рендерингу та параметрів проксі. Ми рекомендуємо цей сервіс командам розробників, яким потрібен простий HTTP-інтерфейс і які хочуть керувати оркестрацією свого конвеєра даних у власному коді.
Переваги й недоліки
- Правила селекторів і вилучення даних за допомогою ШІ забезпечують гнучкість
- Рендеринг і сценарії дають змогу працювати з інтерактивними сторінками
- Markdown, CLI та MCP підтримують робочі процеси із ШІ
- Розширені параметри запитів збільшують витрату кредитів
- Для завдань із кількома сторінками все ще потрібна оркестрація
9. Oxylabs
Oxylabs — вдалий варіант для команд, яким потрібен керований доступ до складних загальнодоступних вебсайтів і можливість збільшувати обсяги збирання даних. Поточний Web API містить функцію /Scrape для отримання та структурування вебданих, а рендеринг JavaScript і керування доступом інтегровані в сервіс. До лінійки продуктів також входять /Search та інфраструктура браузерів, що дає командам змогу обирати різні підходи залежно від того, чи починається завдання з пошуку, вилучення даних або взаємодії.
Спеціалізовані параметри для окремих цільових ресурсів допомагають отримувати корисні поля з пошукових систем і сайтів електронної комерції, а підключення агентів через MCP та Agent Skills дає змогу інтегрувати збирання даних у робочі процеси із ШІ. Oxylabs і надалі окремо документує Classic Web Scraper API. Ця відмінність важлива для наявних інтеграцій: команда, яка обслуговує Classic API, має користуватися відповідною документацією, а не вважати, що приклад для новішого Web API можна застосовувати без змін.
Oxylabs найдоцільніше використовувати, коли складність цільових ресурсів, пропускна здатність або витрати на підтримку інфраструктури доступу виправдовують керовану платформу. Застосунок усе одно має визначати бажану схему даних, період актуальності та правила обробки неповних записів. Перед запуском узгодьте вибране покоління API, параметри цільових ресурсів і модель використання з фактичним завданням. Для невеликого обсягу даних, який збирають вручну, візуальний скрейпер може бути простішим варіантом.
Переваги й недоліки
- Інфраструктура для керування рендерингом і доступом
- Параметри структурованого вилучення даних для конкретних цілей
- Поточний Web API підтримує інтеграції з агентами
- Для класичного й поточного API потрібні окремі налаштування
- Якість результатів усе одно потрібно перевіряти на рівні застосунку
10. Diffbot
Diffbot — наш вибір, коли важливіше зрозуміти інформацію на сторінці, ніж відтворити її структуру. Extract використовує комп’ютерний зір і обробку природної мови, щоб класифікувати сторінки та створювати структурований JSON за стандартними схемами. Для команди, яка збирає статті чи товари з багатьох джерел, це може зменшити обсяг коду для обробки даних, потрібного для перетворення сторінок на записи, які можна порівнювати.
Knowledge Graph від Diffbot задовольняє пов’язану, але окрему потребу: роботу з такими сутностями, як організації, люди й статті, уже зібраними з відкритого вебу. Записи можуть об’єднувати інформацію з кількох джерел і пов’язувати сутності значущими зв’язками. Завдяки цьому Diffbot корисний для збагачення даних, дослідження компаній і аналітичних застосунків, яким потрібен контекст, що виходить за межі полів, видимих на одній сторінці.
Компроміс полягає в тому, що рішення має відповідати моделі даних Diffbot. Стандартизоване вилучення даних корисне, коли типи сторінок і поля відповідають завданню, але для незвичного поля чи спеціалізованої взаємодії може знадобитися інший підхід. Командам слід розрізняти вилучення даних із вибраних ними URL-адрес і запити до наявного графа знань, а потім відповідно оцінювати повноту охоплення та актуальність джерел. Diffbot більше підходить технічним командам, які створюють нормалізовані інформаційні продукти, ніж користувачам, яким потрібно лише скопіювати кілька рядків у таблицю.
Переваги та недоліки
- Автоматична класифікація зменшує обсяг роботи з парсерами
- Стандартні схеми допомагають нормалізувати схожі сторінки
- Knowledge Graph додає контекст про сутності
- Стандартні поля можуть не відповідати спеціалізованим вимогам
- Вилучення даних і доступ до графа знань призначені для різних робочих процесів
Поширені запитання
Що робить інструмент вебскрейпінгу інструментом на базі ШІ?
ШІ може допомагати визначати поля, інтерпретувати вміст сторінок, генерувати кроки для вилучення даних або керувати діями в браузері. Одні інструменти використовують ШІ під час налаштування, інші — під час кожного вилучення даних. Сервіс також може підтримувати застосунки зі ШІ, надаючи їм очищений вміст без використання мовної моделі для кожного запиту. Обирайте функцію, що розв’язує ваше завдання зі збирання даних, а не покладайтеся на саму назву.
Чим відрізняється скрейпінг від автоматизації браузера?
Скрейпінг збирає інформацію. Автоматизація браузера виконує дії на сторінці, наприклад відкриває меню, вводить пошуковий запит або проходить багатокроковий процес. Ці підходи часто використовують разом: автоматизований браузер відкриває потрібний стан сторінки, після чого етап вилучення даних збирає необхідні поля. Якщо такі взаємодії не потрібні, зазвичай простіше скористатися прямим API-запитом.
Які інструменти найкраще підійдуть команді без технічних фахівців?
Для простого регулярного збирання даних і відстеження змін ми насамперед рекомендуємо Browse AI. Гідною альтернативою є Octoparse, якщо команда хоче мати більше візуального контролю над етапами завдання. Обидва інструменти найкраще працюють, коли хтось перевіряє отримані записи й розуміє, як змінюється вихідний вебсайт.
Які дані слід зберігати після скрейпінгу для конвеєра ШІ або RAG?
Зберігайте URL-адресу джерела, час збирання даних, заголовок сторінки, а також текст або структуровані поля, потрібні застосунку. Markdown може зберігати читабельну структуру документа, тоді як JSON підходить для записів із визначеною структурою. Видаляйте дублікати й не змішуйте навігаційний текст з основним вмістом. Збереження відомостей про походження даних спрощує перевірку та оновлення відповідей згодом.
Коли варто використовувати керований браузер?
Керований браузер стане в пригоді, якщо для збирання даних потрібні виконання JavaScript, кілька взаємодій або збереження сесії, а команда не хоче самостійно розміщувати браузерні процеси. Browserless — це спеціалізоване рішення для наявного коду Puppeteer або Playwright. Для однієї статичної сторінки простіший запит або API для вилучення даних може потребувати менше ресурсів.
Чи дорівнюють 1,000 безкоштовних одиниць 1,000 скрейпінгам?
Ні. Кожен постачальник має власні правила обліку одиниць і кредитів. Browserless обліковує з’єднання з браузером інтервалами тривалістю до 30 секунд, а передавання даних через проксі та розв’язання CAPTCHA потребують додаткових одиниць. Інші сервіси стягують плату залежно від параметрів запиту, кількості записів або обчислювальних ресурсів. Оцінюйте весь робочий процес, а не прирівнюйте різні безкоштовні ліміти.
Чи можна довіряти результатам вилучення даних за допомогою ШІ без перевірки?
Навіть коректна відповідь у форматі JSON може не містити певного запису або неправильно інтерпретувати поле. Визначте обов’язкові поля, перевіряйте типи й діапазони значень, вибірково переглядайте вихідні сторінки та відстежуйте зміни в кількості записів. Для регулярних завдань чітко визначені стани помилки й порожнього результату корисніші, ніж припущення, що кожна відповідь містить повний набір даних.
Підсумок про інструменти вебскрейпінгу на базі ШІ
Bright Data — наш найкращий вибір для масштабної роботи з вебданими, а Firecrawl — оптимальний варіант для початку роботи з перетворення вебсторінок на контент, готовий до використання ШІ. Обирайте Apify, якщо важливу роль у проєкті відіграють багаторазові інструменти, заплановані завдання та хмарні операції.
Для бізнес-команд Browse AI спрощує регулярний моніторинг, а Octoparse дає змогу візуально налаштовувати складніші завдання зі збирання даних. SearchAPI — спеціалізований вибір, коли потрібні структуровані пошукові дані.
Browserless стане в пригоді розробникам, яким потрібне кероване виконання браузера зі звичними бібліотеками автоматизації. ScrapingBee — гідна альтернатива, якщо керований запит на збирання даних краще відповідає потребам застосунку. Oxylabs підходить для складних завдань зі збирання даних із відкритого вебу, а Diffbot вирізняється стандартизованим вилученням даних та аналітикою сутностей.
Найкращий вибір на перспективу — той, що надає потрібну інформацію за допомогою робочого процесу, який ваша команда здатна підтримувати. Добирайте спосіб збирання даних відповідно до завдання, зберігайте контекст джерел і оцінюйте цінність за придатністю результатів до використання, а не за кількістю запитаних сторінок.




