
Найкраще
10 кращих інструментів AI для веб‑скрапінгу (вересень 2026)

 Додайте Unite.AI до бажаних джерел у Google
Unite.AI може отримувати винагороду, коли ви використовуєте посилання на переглянуті нами продукти. Це не впливає на наші редакційні оцінки. Читайте розкриття про партнерські зв’язки.
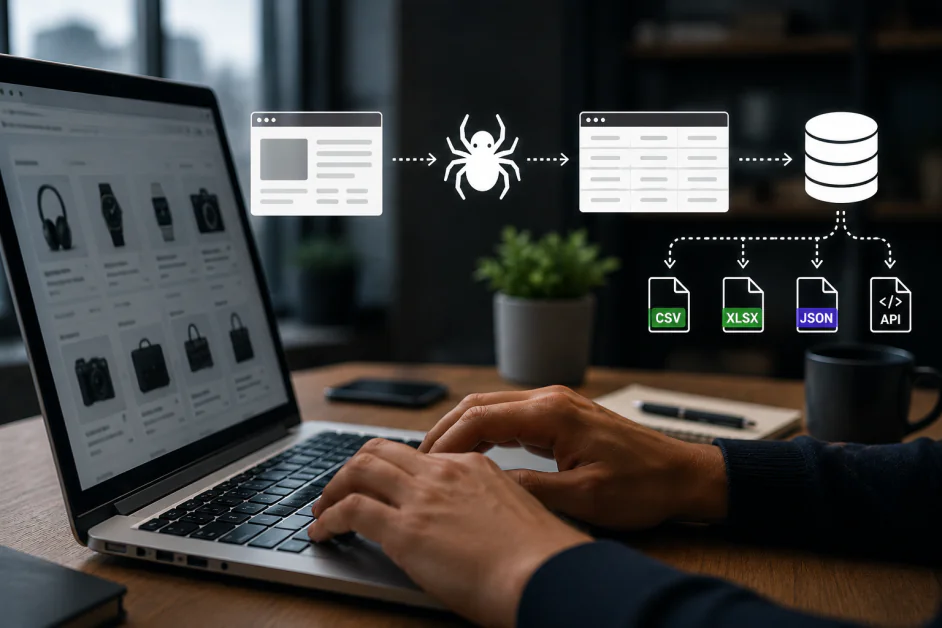
Інструменти AI для веб‑скрапінгу вже не просто парсери сторінок. Найкращі платформи зараз допомагають командам збирати публічні веб‑дані, перетворювати хаотичні сторінки у структуровані набори даних, живити системи генерації з пошуком, моніторити ринки та надавати AI‑агентам надійний веб‑контекст.
Цей зсув важливий, бо скрапінг став і більш цінним, і складнішим у виконанні. Сучасні сайти динамічні, персоналізовані, інтенсивно скриптовані та часто захищені системами протидії зловживанням. Корисний інструмент скрапінгу має робити більше, ніж просто отримувати HTML. Він повинен підтримувати рендеринг, логіку витягування, планування, якість даних, відповідність вимогам та передачу у системи, де дані фактично використовуються.
Правильний вибір залежить від завдання. Деяким командам потрібна інфраструктура корпоративного рівня для масштабних програм збору публічних даних. Іншим потрібен Markdown, готовий до LLM, безкодовий робот для повторюваних досліджень, платформа розробника для автоматизації браузера або спеціалізований API результатів пошуку. Нижче наведені інструменти, які охоплюють різні підходи.
Наша команда незалежно оцінювала кожне рішення в цьому посібнику, аналізуючи його можливості, практичні сильні сторони, обмеження та відповідність випадкам використання, відображеним у нашому рейтингу.
Найкращі інструменти AI для веб‑скрапінгу у порівнянні
| AI‑інструмент | Найкраще підходить для | Ключові переваги |
|---|---|---|
| Bright Data | Корпоративний веб‑скрапінг, інфраструктура проксі та AI‑конвеєри даних | Scraper API, Browser API, Scraper Studio, Web Unlocker, інфраструктура проксі, набори даних, RAG‑конвеєри |
| Firecrawl | Перетворення веб‑сайтів у чистий контент, готовий до LLM, для AI‑застосунків | Scrape, crawl, search, map, monitor, Markdown, структурований JSON, взаємодія з браузером, API, MCP, open source |
| Apify | Розробники, які створюють масштабовані скрапери, автоматизації браузера та data‑агенти | Marketplace акторів, Crawlee, Playwright, Puppeteer, Selenium, планування, проксі, набори даних, API, інтеграції MCP |
| Browse AI | Безкодовий веб‑скрапінг, моніторинг сайтів та регулярний збір бізнес‑даних | AI‑роботи, навчання «точка‑і‑клік», моніторинг сайтів, плановане витягування, готові роботи, інтеграції |
| SearchAPI | Реальний час SERP та дані пошукових систем для AI, SEO та дослідницьких конвеєрів | Google, Google Maps, Bing, YouTube, дані покупок і новин, структурований JSON, гео‑таргетинг, ротація проксі, повтори, MCP |
| ScrapingBee | API скрапінгу, зручний для розробників, з AI‑витягуванням та рендерингом JavaScript | Витягування природною мовою, структурований JSON, Markdown, сценарії JavaScript, ротація проксі, скріншоти, спеціалізовані API, CLI, MCP |
| Octoparse | Візуальний безкодовий скрапінг динамічних сайтів та регулярних хмарних завдань | Візуальний конструктор робочих процесів, AI‑автовизначення, хмарне витягування, шаблони, ротація IP, планування, експорти, API |
| Oxylabs | Корпоративні API скрапінгу, AI‑грунтування та складні публічні сайти | Web Scraper API, AI Studio, Headless Browser, Web Unblocker, Fast Search API, структуровані дані, гео‑таргетинг |
| Diffbot | Автоматична класифікація сторінок, витягування сутностей та доступ до Knowledge Graph | Extract API, Crawl API, Knowledge Graph, збагачення сутностей, обробка природної мови, комп’ютерний зір, структуровані набори даних |
| ScrapeGraphAI | Витягування природною мовою зі структурованим JSON та інтеграціями AI‑фреймворків | Витягування за підказками, схеми JSON, сканування, моніторинг, рендеринг JavaScript, SDK, CLI, MCP, інтеграції LangChain та CrewAI |
Як обрати інструмент AI для веб‑скрапінгу
Почніть з типу проблеми веб‑даних, яку ви маєте. Якщо мета – забезпечити AI‑продукт чистим веб‑контекстом, пріоритетом будуть Markdown, структурований JSON, контроль сканування та вивід, зручний для пошуку. Якщо потрібне регулярне бізнес‑дослідження, безкодовий робот або візуальний конструктор робочих процесів може бути швидшим. Якщо потрібен масштабний збір публічних даних, шукайте глибину інфраструктури: рендеринг, черги, контроль проксі, розблокування, моніторинг та надійна доставка.
Друге питання – хто буде підтримувати робочий процес. Маркетинг‑команда, що стежить за конкурентами, потребує зовсім іншого продукту, ніж інженерна команда, що будує конвеєр даних. Хороші системи скрапінгу роблять витягування повторюваним, але не усувають потребу в валідації. Сайти змінюються, поля «дрейфують», а AI‑асистоване витягування може звучати впевнено, навіть коли сторінка неоднозначна. Найкраща конфігурація – та, що відповідає технічному рівню вашої команди, процесу перегляду та вимогам відповідності.
10 кращих інструментів AI для веб‑скрапінгу
1. Bright Data
Bright Data – найсильніший варіант, коли збір веб‑даних є ядром бізнес‑системи, а не побічним проєктом. Платформа поєднує Scraper API, інфраструктуру браузера, управління проксі, технологію розблокування та готові набори даних, що дозволяє командам збирати публічні веб‑дані у великому масштабі без необхідності збирати кожен шар окремо.
Вона особливо корисна для компаній, які створюють інтелектуальні рішення щодо ринку, моніторинг електронної комерції, пошукову аналітику, набори даних для навчання AI, конвеєри RAG або конкурентні продукти даних. Bright Data дає технічним командам достатньо контролю для побудови складних робочих процесів, одночасно пропонуючи керовані шляхи для тих, хто хоче отримати структуровані дані без підтримки крихкого стеку скрапінгу.
Ця ширина функціоналу – також і критерій покупки. Bright Data має сенс, коли організація може призначити інженерну чи data‑операційну відповідальність, визначити дозволені цілі та моніторити якість і вартість протягом часу. Менші команди з обмеженим переліком простих сайтів можуть краще підходити легшому API або безкодовому сервісу, тоді як регульовані програми повинні узгоджувати політики збору з юридичним та конфіденційним оглядом.
Плюси та мінуси
- Найширше покриття інфраструктури у цьому рейтингу
- Сильна відповідність для великих обсягів і складних публічних сайтів
- Готові скрапери та набори даних скорочують час розробки
- Корисно для AI‑конвеєрів даних, пошукової інтелігенції та моніторингу електронної комерції
- Більше інфраструктури, ніж потребують малі випадкові проєкти
- Командам все одно потрібне чітке управління даними та правила щодо цільових сайтів
- Складні сценарії вимагають технічного налаштування та моніторингу
2. Firecrawl
Firecrawl створений для ери AI‑скрапінгу. Замість того, щоб змушувати розробників чистити сирий HTML, керувати рендерингом сторінок і вручну нормалізувати безладний вміст, він перетворює веб‑сторінки у чистий Markdown або структуровані дані, які можуть живити агентів, пошукові системи, дослідницькі інструменти та продуктові робочі процеси.
Перевага – простота на рівні застосунку. Розробники можуть скрапити сторінку, сканувати сайт, шукати в інтернеті, картографувати URL, моніторити зміни або запитувати структурований вивід з набагато меншим обсягом «трубопроводів», ніж у традиційного стеку скрапінгу. Firecrawl особливо підходить, коли кінцевий продукт – AI‑асистент, база знань, дослідницький конвеєр або система RAG.
Командам слід розглядати Firecrawl як шар отримання контенту, а не всю платформу даних. У продакшн‑використанні все ще потрібне визначення джерел, дедуплікація, правила актуальності, валідація схем та спостереження за змінами сайтів. Його цінність найвища, коли розробники хочуть стислий API та можливість самостійного хостингу, але не потребують широких проксі‑контролів чи керованих наборів даних, які пропонують корпоративні постачальники.
Плюси та мінуси
- Відмінно підходить для AI‑застосунків, яким потрібен чистий веб‑контекст
- Markdown та структурований вивід зменшують подальшу очистку
- Корисний API для скрапінгу, сканування, пошуку, картографування та моніторингу
- Open‑source варіант дає технічним командам більше гнучкості розгортання
- Не є повноцінною платформою проксі чи корпоративною інфраструктурою даних
- Складні витягування все ще виграють від проєктування схем і валідації
- Командам зі строгими вимогами до відповідності слід ретельно переглянути варіанти розгортання та зберігання
3. Apify
Apify – сильний вибір для команд, які хочуть і платформу розробника, і великий маркетплейс готових інструментів веб‑автоматизації. Модель Actor дозволяє упакувати скрапери, автоматизації браузера та робочі процеси даних у повторно‑використовувані хмарні завдання, які можна планувати, викликати через API, підключати до сховищ і ділитися між учасниками команди.
Розробники отримують практичний шлях від прототипу до продакшн. Вони можуть будувати на базі Crawlee, Playwright, Puppeteer, Selenium або готових Actors, а потім використовувати Apify для виконання, черг, проксі, наборів даних, веб‑хукiв та інтеграцій. Це особливо корисно для команд, яким потрібні повторювані завдання з даними, а не одноразове витягування сторінок.
Гнучкість Apify – це сила і відповідальність. Командам потрібно обирати довірені Actors, контролювати версії, моніторити виконання та планувати витрати на обчислення, проксі та сховище у міру зростання навантаження. Платформа найкраще підходить розробникам, які шукають повторно‑використовувані блоки та хмарні операції в одному місці; випадкові користувачі можуть знайти швидший старт у спеціалізованих скраперах.
Плюси та мінуси
- Великий маркетплейс готових Actors для типових цілей
- Сильні інструменти розробника для кастомного скрапінгу та автоматизації браузера
- Добре підходить для планованих, повторюваних робочих процесів зі збору даних
- Підтримка Crawlee забезпечує технічним командам гнучку open‑source основу
- Якість у маркетплейсі варіюється залежно від Actor та випадку використання
- Кастомні завдання все ще потребують обслуговування при зміні сайтів
- Некористувачі можуть віддати перевагу простішому візуальному скраперу
4. Browse AI
Browse AI найкращий для бізнес‑команд, яким потрібні веб‑дані, але не хочеться будувати скрапери. Користувачі навчають робота, показуючи, що саме збирати, а потім запускають його за запитом або за розкладом. Це робить інструмент корисним для відстеження конкурентів, моніторингу листингів, збору лідів, спостереження за інвентарем або перетворення повторюваних досліджень у регулярний робочий процес.
Сила – доступність. Browse AI дає операційним, маркетинговим, рекрутинговим, e‑commerce та дослідницьким командам практичний спосіб отримувати структуровані дані без залучення інженерії до підтримки кожного селектора. Це не найглибша платформа розробника; вона орієнтована на те, щоб зробити повторюваний збір веб‑даних доступним.
Browse AI працює найкраще, коли цільовий робочий процес можна чітко продемонструвати та переглянути людиною. Користувачі мають протестувати пагінацію, кроки входу, порожні стани та зміни розмітки перед тим, як покладатися на автоматизацію у прийнятті рішень. Це сильний вибір для проєктів у підрозділах, проте інженерні програми можуть потребувати більш детального контролю над повторними спробами, контрактами даних та розгортанням.
Плюси та мінуси
- Сильний безкодовий досвід для бізнес‑користувачів
- Добре підходить для регулярного моніторингу та робочих процесів у стилі електронних таблиць
- Навчання робота «точка‑і‑клік» простіше, ніж налаштування селекторів
- Корисно для команд, яким потрібні веб‑дані без підтримки інженерії
- Менш гнучко, ніж платформи, орієнтовані на розробників, для складної логіки
- Роботи можуть потребувати корекції, коли цільові сторінки суттєво змінюються
- Великі або сильно кастомізовані проєкти можуть перевищити можливості безкоду
5. SearchAPI
SearchAPI – спеціалізований сервіс скрапінгу для команд, яким потрібні актуальні результати пошукових систем у вигляді структурованих даних, а не сирих HTML‑сторінок. Єдиний API‑інтерфейс може повертати органічні посилання, рекламу, новини, карти, результати покупок, панелі знань, питання «People Also Ask», AI‑генеровані функції пошуку та інші типи результатів у JSON, залежно від обраного рушія.
Платформа особливо корисна для моніторингу SEO, аналізу локального пошуку, дослідження ринку, інтелігенції продукту та AI‑агентів, яким потрібен реальний час пошукового контексту. SearchAPI керує рендерингом браузера, ротацією проксі, повторними спробами та обробкою CAPTCHA, а параметри локалізації підтримують країну, мову, місцезнаходження та тип пристрою. Документовані рушії виходять за межі стандартних результатів Google і включають Google Maps, Bing, YouTube, новини та комерційний пошук.
SearchAPI також пропонує сервер MCP для підключення підтримуваних AI‑асистентів і середовищ розробки до своїх пошукових інструментів. Компроміс – спеціалізація: це потужний шар пошукових даних, а не універсальний сканер для витягування довільних полів з будь‑якого сайту. Покупцям слід ретельно планувати використання, оскільки плани базуються на кредитах, пропускна здатність варіюється за рівнем, а більш багаті пошукові поверхні все ще потребують перевірки схем при зміні розмітки.
Плюси та мінуси
- Повертає структуровані дані SERP у реальному часі без потреби підтримки скрапінгу пошукових систем або інфраструктури проксі
- Підтримує основні пошукові, картографічні, відео, новинні, торгові та інші спеціалізовані рушії результатів
- Контроль за місцем, мовою, країною та пристроєм підходить для відстеження позицій та досліджень ринку
- API та доступ до MCP роблять пошукові дані практичними для застосунків та AI‑агентів
- Зосереджено на даних результатів пошукових систем, а не на довільному скануванні сайтів
- Плани на основі кредитів і обмеження пропускної здатності вимагають прогнозування для високих навантажень
- Додатки повинні валідувати поля, оскільки пошукові системи змінюють розмітку результатів
6. ScrapingBee
ScrapingBee – API, орієнтоване на розробників, для команд, які хочуть збирати та структурувати веб‑дані без підтримки безголових браузерів або інфраструктури проксі. Воно поєднує рендеринг JavaScript, ротацію проксі, скріншоти, CSS/XPath‑витягування та AI‑шар, який перетворює запити природною мовою та правила полів у структурований JSON.
Платформа особливо корисна, коли розробники хочуть один кінцевий пункт для простих сторінок і інтерактивних сайтів. Сценарії JavaScript можуть клікати, прокручувати, вводити дані або чекати перед витягуванням, а вихід у Markdown, спеціалізовані API, CLI та інтеграції MCP допомагають переміщати отриманий контент у аналітику, автоматизацію та AI‑робочі процеси. ScrapingBee простіше впровадити, ніж повний стек скрапінгу, хоча споживання кредитів може зрости через преміум‑проксі, рендеринг та AI‑функції.
ScrapingBee найкраще підходить, коли інженери хочуть керований шар запитів, залишаючи оркестрацію та контроль якості у власному застосунку. Командам слід визначити правила повторних спроб, схеми, межі сканування та валідацію для багатосторінкових завдань, а не розглядати кожну успішну HTTP‑відповідь як достовірні дані. Візуальний настільний скрапер буде простішим для нетехнічних користувачів, проте API‑команди отримують більше прямого контролю над інтеграцією та розгортанням.
Плюси та мінуси
- Витягування AI природною мовою може повертати структурований JSON без ручного створення селекторів
- Рендеринг JavaScript та скриптові дії обробляють багато динамічних робочих процесів
- Ротація проксі, скріншоти, вихід у Markdown та спеціалізовані API доступні в одному сервісі
- CLI, MCP та інтеграції автоматизації підходять для розробників та агентних робочих процесів
- Витрата кредитів зростає, коли запити включають AI‑витягування, преміум‑проксі або рендеринг JavaScript
- Продукт орієнтований на API, а не на візуальний настільний скрапер
- Складні багатосторінкові сканування все ще потребують оркестрації та перевірки якості
7. Octoparse
Octoparse – зрілий безкодовий скрапер для користувачів, які віддають перевагу візуальному робочому процесу замість розробницького фреймворку. Він може виявляти дані на сторінці, проводити користувача крок за кроком через процес витягування та запускати скрапінгові завдання у хмарі, що робить його корисним для регулярного збору даних з інтернет‑магазинів, каталогів, листингів, сторінок пошуку та інших структурованих веб‑джерел.
Платформа найсильніша, коли команда потребує більшого контролю над робочим процесом, ніж швидке скрапінгове розширення браузера, але все ж хоче уникнути написання коду. Шаблони, планування, хмарне витягування, автоматичний експорт та підтримка динамічних сторінок роблять Octoparse практичним проміжним варіантом між простими безкодовими інструментами та інженерними скрапінговими платформами.
Візуальна модель все ж вимагає ретельного проєктування робочих процесів. Командам слід протестувати пагінацію, безкінечний скрол, стан входу, дублікати записів та гілки помилок перед тим, як покладатися на плановані завдання. Octoparse добре підходить аналітикам та операційним користувачам, які можуть власноруч здійснювати ці перевірки, тоді як розробники, що будують чітко версіоновані конвеєри, можуть віддати перевагу API або код‑орієнтованому фреймворку з більшою підтримкою контролю версій та автоматизованого тестування.
Плюси та мінуси
- Візуальний конструктор робочих процесів дає користувачам більше контролю, ніж прості інструменти «один клік»
- Хмарне витягування допомагає запускати регулярні завдання без локального комп’ютера
- Шаблони скорочують час налаштування для типових сайтів та типів даних
- Добре підходить для операційних команд, яким потрібні повторювані структуровані набори даних
- Проєктування робочих процесів може зайняти час на складних сайтах
- Менш природний для розробницьких команд, які віддають перевагу код‑орієнтованим конвеєрам
- Постійний моніторинг все ще потрібен, коли цільові сайти змінюються
8. Oxylabs
Oxylabs – сильний варіант для команд, які потребують надійного доступу до публічних веб‑даних у масштабах і не хочуть самостійно керувати ротацією проксі, рендерингом та шарами захисту від блокувань. Його Web Scraper API розроблений для збору структурованих публічних даних з широкого спектру цілей, одночасно обробляючи більшу частину інфраструктури скрапінгу «за лаштунками».
Компанія також розширила свої можливості у AI‑даних, запровадивши AI Studio, Fast Search API, автоматизацію браузера та сценарії, орієнтовані на «grounding». Це робить Oxylabs актуальним для організацій, які будують системи інтелігенції ринку, моніторинг пошуку, конвеєри «grounding» моделей, набори даних електронної комерції та робочі процеси агентів, яким потрібен свіжий веб‑контекст.
Oxylabs найпривабливіший, коли надійність, складність цільових сайтів або географічне охоплення виправдовують корпоративний сервіс. Покупцям слід спланувати цільові сайти, вимоги до виводу, час відповіді та відповідальність за відповідність перед вибором конфігурації продукту. Менші проєкти можуть не використовувати всю глибину інфраструктури, тоді як великі програми все ще потребують незалежного моніторингу якості, оскільки успішний збір не гарантує точну нормалізацію.
Плюси та мінуси
- Сильна корпоративна інфраструктура скрапінгу та проксі
- Корисно для конвеєрів публічних веб‑даних, які потребують масштабу та надійності
- AI Studio та Fast Search API підтримують робочі процеси агентів та «grounding»
- Добре підходить для складних динамічних сайтів та гео‑таргетованого збору
- Оптимально для команд з визначеними технічними та відповідальними вимогами
- Може бути надмірною інфраструктурою для малих безкодових проєктів
- Складні робочі процеси потребують ретельного підбору цілей та валідації
9. Diffbot
Diffbot відрізняється від більшості інструментів скрапінгу тим, що зосереджується на розумінні сторінок та сутностей, а не лише на зборі полів. Його технологія витягування класифікує сторінки, ідентифікує структуровані сутності та підключає веб‑дані до ширшого Knowledge Graph, що корисно, коли мета – збагачена, нормалізована інформація, а не просто «сыра» таблиця.
Це робить Diffbot особливо релевантним для команд, що працюють над інтелігенцією сутностей, даними про компанії та людей, дослідженням ринку, Knowledge Graph, моніторингом медіа та AI‑системами, яким потрібні структуровані факти з відкритого інтернету. Це не швидкий «точка‑і‑клік» скрапер, а швидше шар веб‑масштабного витягування та знань.
Головне питання покупки – чи відповідає модель даних Diffbot сутностям і взаємозв’язкам, потрібним вашому проєкту. Якщо так, команди можуть уникнути створення парсерів під конкретні сторінки та конвеєрів збагачення з нуля. Якщо ні, традиційний скрапер може надати більше прямого контролю. Оцінка має включати репрезентативні сторінки, охоплення полів, частоту оновлень, розв’язання сутностей та спосіб збереження походження даних у подальшому.
Плюси та мінуси
- Сильне автоматичне витягування та розуміння сутностей
- Доступ до Knowledge Graph додає контекст за межами окремої сторінки
- Корисно для збагачення, досліджень та структурованих інтелігенційних робочих процесів
- Добре підходить, коли важливі нормалізовані сутності, а не «сирі» таблиці сторінок
- Менш інтуїтивно для простих скрапінгових завдань у вигляді електронних таблиць
- Найкращі результати залежать від того, чи підходять моделі Diffbot до типу цільового контенту
- Командам потрібно розуміти Knowledge Graph та модель API, щоб отримати повну цінність
10. ScrapeGraphAI
ScrapeGraphAI розроблений для користувачів, які хочуть описати потрібні дані простою мовою та отримати структурований вивід. Замість написання селекторів для кожного поля, команди можуть надати URL, визначити потрібну інформацію та скористатися AI‑асистованим витягуванням, яке повертає чистий JSON для застосунків, дослідницьких процесів або агентів.
Це хороший варіант для розробників, які будують AI‑робочі процеси навколо веб‑даних, особливо коли завдання витягування часто змінюється або потребує інтеграції з фреймворками типу LangChain, CrewAI, SDK, інструментами командного рядка або середовищами з підтримкою MCP. Ключова перевага – гнучкість: логіка витягування може керуватись підказками, а не бути прив’язана до крихких селекторів.
Така гнучкість робить валідацію особливо важливою. Командам слід визначити схеми, правила повторних спроб, поля доказів та правила перегляду зразків перед продакшн‑використанням, бо правдоподібна відповідь не обов’язково є повним витягуванням. ScrapeGraphAI привабливий для експериментів та адаптивних робочих процесів, тоді як стабільні високовольюмові завдання можуть все ж виграти від детермінованих селекторів або гібридного підходу, що використовує AI лише там, де структура сторінки варіюється.
Плюси та мінуси
- Витягування природною мовою корисне для змінних або дослідницьких завдань
- Структурований JSON‑вивід підходить для AI‑застосунків та автоматизаційних процесів
- Інтеграції для розробників підтримують випадки використання агентів та оркестрації
- Корисно, коли підтримка селекторів уповільнює експерименти
- AI‑витягування слід валідувати перед продакшн‑використанням
- Дизайн підказок і схеми впливають на консистентність виводу
- Менш підходить командам, які потребують суто візуального безкодовго робочого процесу
Frequently Asked Questions
What makes a web scraping tool AI-powered?
AI‑засновані скрапери зазвичай допомагають у одному або кількох із чотирьох завдань: ідентифікація полів на сторінці, перетворення вмісту сторінки у структуровані дані, керування браузером за допомогою інструкцій природною мовою або підготовка витягнутого контенту для AI‑систем. Найкращі інструменти все ще потребують чітких підказок, схем, валідації та правил щодо того, які дані збирати.
What is the difference between scraping and browser automation?
Скрапінг зосереджений на витягуванні даних зі сторінок. Автоматизація браузера керує браузером: клікає, прокручує, входить у систему, заповнює форми, чекає динамічний контент або проходить багатокроковий робочий процес. Багато сучасних інструментів поєднують обидва підходи, але різниця важлива: статичний перелік продуктів – це завдання скрапінгу, тоді як робочий процес, що вимагає навігації та взаємодії, може потребувати автоматизації браузера.
Which output format is best for a RAG system?
Системи Retrieval‑Augmented Generation зазвичай найкраще працюють з чистим текстом, Markdown, структурованим JSON, метаданими та стабільними URL‑джерелами. Мета – не лише зібрати контент, а й зберегти достатню структуру для розбиття на фрагменти, пошуку, цитування та перевірки якості. Сира HTML може бути корисною, проте часто створює додаткову роботу з очищенням перед використанням у AI‑застосунку.
Can AI scrapers handle JavaScript websites?
Багато можуть, проте якість залежить від продукту. Деякі інструменти рендерять сторінки у браузері, інші використовують безголову інфраструктуру, а ще інші – витяг після повного завантаження сторінки. Підтримка JavaScript важлива для електронної комерції, маркетплейсів, соціальних платформ, панелей управління та сучасних веб‑додатків, де потрібні дані з’являються після початкової відповіді сервера.
Are no-code scrapers suitable for large projects?
Безкодові скрапери можуть бути відмінними для повторюваних бізнес‑процесів, моніторингу конкурентів, дослідження лідів та операційних завдань. У великих програмах з часом може виникнути потреба у API, чергах, моніторингу, інфраструктурі проксі, контролі версій, валідації даних та інженерному управлінні. Найкращі безкодові інструменти найсильніші, коли робочий процес чітко визначений і команда хоче швидкості без розробки кастомного скрапера.
Is web scraping legal?
Законність скрапінгу залежить від юрисдикції, цільового сайту, типу даних, методу доступу та способу використання даних. Збір публічних веб‑даних все ще може піднімати питання щодо договорних, конфіденційних, інтелектуальних прав, кібербезпеки та політик платформи. Командам слід переглянути застосовні закони, robots.txt та умови використання, внутрішні політики відповідності та чутливість даних перед запуском скрапінгової програми.
Should AI-generated extraction results be validated?
Так. AI може зробити скрапінг більш гнучким, але також може неправильно інтерпретувати сторінки, об’єднувати поля, пропускати прихований контекст або повертати несумісні структури при зміні макетів. Продакшн‑процеси повинні включати перевірку схем, вибірковий перегляд, сповіщення про зміни, обробку помилок та людський огляд для чутливих рішень.
Final Thoughts on AI Web Scraping Tools
Bright Data – найсильніший загальний вибір для команд, яким потрібна серйозна інфраструктура та великі програми збору публічних даних. Firecrawl найчистіший варіант для AI‑застосунків, яким потрібен веб‑контекст, готовий до LLM, тоді як Apify надає розробникам гнучку платформу для кастомних скраперів, Actors та автоматизації браузера.
Для бізнес‑команд Browse AI та Octoparse роблять регулярний збір даних більш доступним без необхідності перетворювати кожен робочий процес у інженерний проєкт. ScrapingBee – потужний API, зручний для розробників, що забезпечує витягування природною мовою, рендеринг JavaScript та структурований вивід без підтримки браузера та проксі‑інфраструктури.
SearchAPI виділяється, коли потрібні свіжі, структуровані дані пошукових систем для SEO, досліджень або AI‑агентів, а не довільне сканування сайтів. Oxylabs найкращий для корпоративних API скрапінгу та складних публічних сайтів, Diffbot привабливий, коли важливі витягування сутностей та контекст Knowledge Graph, а ScrapeGraphAI – гнучка підказков‑орієнтована опція витягування для AI‑робочих процесів.




