Погляд Anderson
Виокремлення переднього плану зображень із ШІ, що розуміє сцени

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиAI-матування тепер використовує розуміння сцени для заміни зелених екранів.
Показати більше
- AI-матування тепер використовує розуміння сцени для заміни зелених екранів.
- Новий конвеєр SPG-IM значно перевершує методи без тримап.
- Текстові мітки пропонують низьковитратну альтернативу дорогій піксельній анотації.
У додатковому документальному фільмі до DVD-видання 2003 року фільму Alien3 (1992) легендарний фахівець із візуальних ефектів Річард Едлунд із жахом згадував «боротьбу сумо» фотохімічного виокремлення масок. Цей процес домінував у роботі над візуальними ефектами від кінця 1930-х до кінця 1980-х років. Едлунд порівнював його непередбачуваність із боротьбою сумо на противагу цифровим технологіям синього й зеленого екрана, які поширилися на початку 1990-х. Відтоді він не раз повертався до цієї метафори.
Виділення переднього елементу (наприклад, людини або моделі космічного корабля) з фону, щоб вирізане зображення можна було композиціонувати на фон, спочатку здійснювалося шляхом зйомки переднього об’єкта на рівномірному синьому або зеленому фоні.
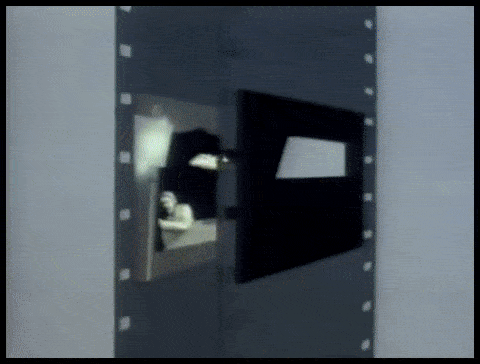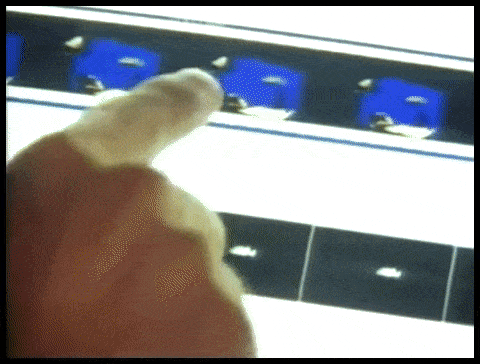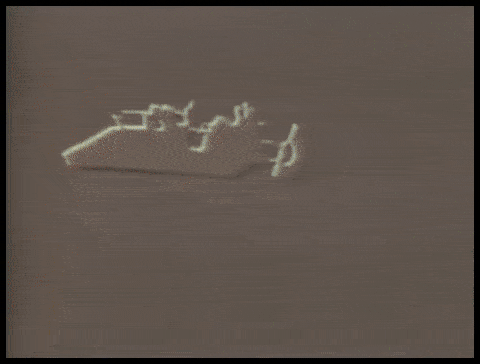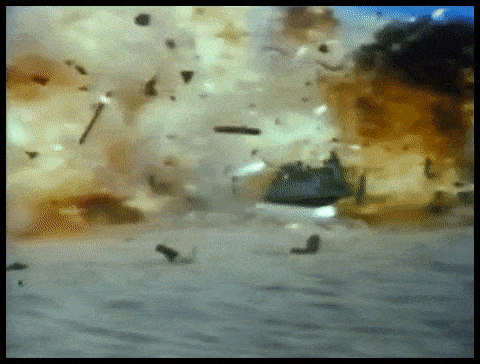
Трудомісткі фотохімічні процеси виокремлення для кадру з візуальними ефектами ILM у фільмі «Return of the Jedi» (1983).
У отриманих кадрах колір фону потім хімічно виділявся і використовувався як шаблон для повторного друку переднього об’єкта (або людини) в оптичному принтері як «плаваючого» об’єкта на кадрі плівки, прозорому поза цим об’єктом.
Процес називали color separation overlay (CSO) — хоча згодом цей термін став більш асоціюватися з грубими ‘Chromakey’ відеоефектами у низькобюджетних телевізійних випусках 1970‑х і 1980‑х років, які досягалися за допомогою аналогових, а не хімічних чи цифрових засобів.

Демонстрація накладання із розділенням кольорів у британській дитячій програмі «Blue Peter» 1970 року. Джерело: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
У будь‑якому випадку, чи то для кіно, чи для відео, після цього виокремлений відеоматеріал можна було вставляти в будь‑яке інше відео.
Хоча значно дорожчий і власний процес із використанням парів натрію Disney (який працював на жовтому кольорі, зокрема, і був також використаний у фільмі жахів Альфреда Хічкока 1963 року The Birds) забезпечував кращу чіткість і чіткіші маски, фотохімічне виділення залишалося надзвичайно трудомістким і ненадійним.

Власний процес виокремлення Disney з використанням парів натрію вимагав фону поблизу жовтого краю спектра. Тут Angela Lansbury підвішена на дротах під час зйомок насиченої візуальними ефектами сцени для «Bedknobs and Broomsticks» (1971). Джерело
Поза цифровим виокремленням переднього плану
У 1990‑х роках цифрова революція відмовилася від хімікатів, хоча потреба у зелених екранах залишилася. Тепер можна було видаляти зелений (або будь‑який інший) фон просто шляхом пошуку пікселів у межах допустимого діапазону цього кольору у програмах для редагування пікселів, таких як Photoshop, і новому поколінні пакетів відео‑композиції, які могли автоматично видаляти кольорові фони. Майже за одну ніч шістдесят років індустрії оптичного друку було відправлено в історію.
Останні десять років досліджень комп’ютерного зору з прискоренням GPU вводять виокремлення масок в третю епоху, ставлячи перед дослідниками завдання розробити системи, які можуть отримувати високоякісні маски без потреби у зелених екранах. Лише на Arxiv щотижня з’являються статті, пов’язані з інноваціями у виокремленні переднього плану на основі машинного навчання.
Розміщуючи нас у кадрі
Цей центр академічного та промислового інтересу до виокремлення зображень за допомогою ШІ вже вплинув на споживчий ринок: грубі, але працездатні реалізації нам всім знайомі у вигляді фільтрів Zoom та Skype, які можуть замінювати фон нашої вітальні на тропічні острови тощо під час відеоконференцій.
Проте найкращі маски все ще потребують зеленого екрану, як Zoom зазначив у середу.

Ліворуч — чоловік перед зеленим екраном, чиє волосся добре виокремлене функцією Virtual Background у Zoom. Праворуч — жінка у звичайній домашній обстановці, чиє волосся виокремлене алгоритмічно, з меншою точністю та вищими обчислювальними вимогами. Джерело: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Подальший допис на платформі підтримки Zoom застерігає, що виокремлення без зеленого екрана також вимагає більшої обчислювальної потужності в пристрої захоплення.
Потреба вирізати
Покращення якості, портативності та економії ресурсів у системах виокремлення масок «в польових умовах» (тобто ізоляції людей без потреби у зелених екранах) мають значення для багатьох інших галузей і завдань, а не лише для фільтрів відеоконференцій.
Для розробки наборів даних покращене розпізнавання облич, повних голів та всього тіла дає можливість забезпечити, щоб зайві елементи фону не потрапляли у навчання моделей комп’ютерного зору, що розпізнають людей; більш точна ізоляція значно покращить техніки семантичної сегментації, призначені для розрізнення та асиміляції доменів (наприклад, ‘кіт’, ‘людина’, ‘човен’), а також удосконалить системи синтезу зображень на базі VAE та трансформерів, такі як новий DALL‑E 2 від OpenAI; кращі алгоритми виокремлення скоротять потребу у дорогому ручному ротоскопуванні у витратних VFX‑конвеєрах.
Насправді, підйом мультимодальних (зазвичай текст/зображення) методологій, де домен, такий як «кіт», кодується як зображенням, так і пов’язаними текстовими посиланнями, вже проникає у обробку зображень. Один недавній приклад — архітектура Text2Live, яка використовує мультимодальне (текст/зображення) навчання для створення відео, серед безлічі інших можливостей, кришталевих лебедів та скляних жирафів.
Виокремлення переднього плану з ШІ, що враховує сцену
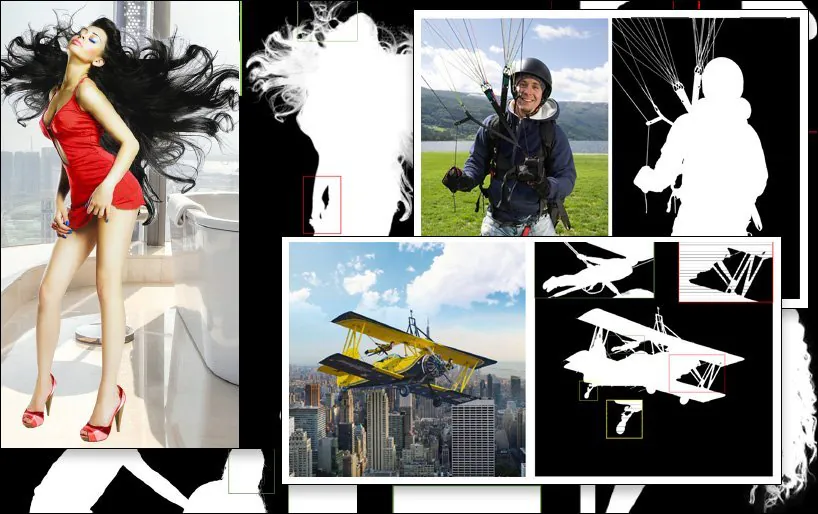
Багато досліджень у галузі автоматичного виокремлення переднього плану за допомогою ШІ зосереджувалися на розпізнаванні меж та оцінці піксельних групувань всередині зображення чи відеокадру. Однак нове дослідження з Китаю пропонує конвеєр виокремлення, який покращує розмежування та якість маски, використовуючи текстові описи сцени (мультимодальний підхід, який набув популярності в дослідницькому секторі комп’ютерного зору за останні 3‑4 роки), стверджуючи, що вдосконалив попередні методи у кількох аспектах.

Приклад виокремлення SPG-IM (останнє зображення праворуч унизу) порівняно з попередніми конкурентними методами. Джерело: https://arxiv.org/pdf/2204.09276.pdf
Завдання, що стоїть перед підрозділом досліджень виокремлення, — створити робочі процеси, які потребують мінімуму ручної анотації та людського втручання — ідеально — жодного. Окрім фінансових наслідків, дослідники нової статті зазначають, що анотації та ручні сегментації, виконані залученими зовнішніми працівниками з різних культур, можуть призводити до різного маркування чи навіть сегментації зображень, що створює непослідовні та незадовільні алгоритми.
Одним прикладом цього є суб’єктивна інтерпретація того, що визначає «об’єкт переднього плану»:

З нової статті: попередні методи LFM і MODNet по-різному визначають передній план і мають різну ефективність. Новий SPG-IM краще окреслює близький вміст за допомогою контексту сцени. GT означає Ground Truth — ідеальний еталонний результат, який часто отримують вручну або неалгоритмічними методами.
Для вирішення цієї проблеми дослідники розробили двоетапний конвеєр під назвою Situational Perception Guided Image Matting (SPG-IM). Двоетапна архітектура кодувальник/декодувальник включає Situational Perception Distillation (SPD) та Situational Perception Guided Matting (SPGM).

Архітектура SPG-IM.
Спочатку SPD передтренує перетворення візуальних у текстові ознаки, створюючи підписи, що відповідають їхнім зображенням. Після цього передбачення маски переднього плану активується шляхом підключення конвеєра до нової техніки прогнозування важливості.
Потім SPGM генерує оцінкову альфа-маску на основі вхідного необробленого RGB‑зображення та створеної маски, отриманої в першому модулі.
Метою є керування ситуаційним сприйняттям, коли система має контекстуальне розуміння того, з чого складається зображення, що дозволяє, наприклад, сформулювати завдання виокремлення складних пасом волосся з фону, враховуючи відомі характеристики такого специфічного завдання.

У нижньому прикладі SPG-IM розуміє, що стропи є невіддільною частиною парашута, тоді як MODNet не зберігає й не виокремлює цих деталей. Аналогічно, у верхньому прикладі MODNet довільно втрачає повну структуру ігрового обладнання.
Нова стаття називається Situational Perception Guided Image Matting і написана дослідниками з OPPO Research Institute, PicUp.ai та Xmotors.
Інтелектуальні автоматичні маски
SPG-IM також пропонує мережу уточнення Adaptive Focal Transformation (AFT), яка може окремо обробляти локальні деталі та глобальний контекст, сприяючи створенню «інтелектуальних масок».

Розуміння контексту сцени, у цьому разі дівчини з конем, потенційно полегшує виокремлення переднього плану порівняно з попередніми методами.
У статті зазначено:
‘Ми вважаємо, що візуальні представлення, отримані з візуально‑текстового завдання, наприклад підписування зображень, зосереджуються на більш семантично комплексних сигналах між a) об’єктом та об’єктом і b) об’єктом та навколишнім середовищем, щоб створювати описи, які охоплюють як глобальну інформацію, так і локальні деталі. Крім того, у порівнянні з дорогим піксельним анотуванням виокремлення переднього плану зображень, текстові мітки можна збирати масово за дуже низькою вартістю.’
Гілка SPD архітектури спільно передтренується з трансформер‑базованим текстовим декодером VirTex Мічиганського університету, який вивчає візуальні представлення на основі семантично насичених підписів.

VirTex спільно навчає ConvNet і трансформери на парах зображень та підписів і переносить отримані знання на подальші завдання комп’ютерного зору, наприклад виявлення об’єктів. Джерело: https://arxiv.org/pdf/2006.06666.pdf
Серед інших тестів і абляційних досліджень дослідники порівняли SPG-IM із передовими методами на основі trimap: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA та Semantic Image Matting (SIM).
Серед інших випробуваних попередніх фреймворків були підходи без trimap: LFM, HAttMatting та MODNet. Для справедливого порівняння методи тестування адаптували відповідно до різних методологій; якщо код був недоступний, техніки зі статті відтворювали за описаною архітектурою.
У новій статті зазначено:
‘Наш SPG-IM перевершує всі конкурентні методи без trimap ([LFM], [HAttMatting] та [MODNet]) з великою перевагою. При цьому наша модель також демонструє значну перевагу над передовими (SOTA) trimap‑базованими та маскою‑керованими методами за всіма чотирма метриками на публічних наборах даних (тобто Composition‑1K, Distinction‑646 та Human‑2K), а також нашим бенчмарком Multi‑Object‑1K.’
‘Очевидно, що наш метод зберігає дрібні деталі (наприклад, кінчики волосся, прозорі текстури та контури) без керування trimap. Крім того, у порівнянні з іншими конкурентними моделями без trimap, наш SPG‑IM зберігає кращу глобальну семантичну повноту.’


Перший раз опубліковано 24 квітня 2022 року.