
Погляд Anderson
Узгоджене редагування відеоконтенту засобами ШІ за текстовими вказівками

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиText2Live дозволяє виконувати узгоджені редагування відео за текстовими підказками без…
Показати більше
- Text2Live дозволяє виконувати узгоджені редагування відео за текстовими підказками без покадрової обробки.
- Система використовує нейронний шаруватий атлас для застосування редагувань один раз на всій часовій шкалі відео.
- Text2Live автоматизує маскування та композитинг, усуваючи потребу в ротоскопії або хромакеї.
Хоча професійна спільнота візуальних ефектів зацікавлена – і іноді відчуває загрозу – новими інноваціями в синтезі зображень і відео, відсутність часової безперервності в більшості проектів відеомонтажу на основі штучного інтелекту відводить ці зусилля в сферу “психоделічного” мистецтва, із мерехтливими текстурами та структурами, що швидко змінюються, неузгодженими ефектами та грубими технологічними маніпуляціями, що нагадують фотохімічну епоху візуальних ефектів.
Якщо ви хочете змінити щось дуже конкретне у відео, що не належить до сфери глибоких підробок (тобто, накладення нової особистості на існуюче відео людини), більшість поточних рішень працюють під досить серйозними обмеженнями щодо точності, необхідної для виробництва високоякісних візуальних ефектів.
Одним із винятків є триваюча робота вільної асоціації вчених з Інституту Вейцмана. У 2021 році троє його дослідників, у співпраці з Adobe (ADBE ), оголосили про новий метод розкладання відео і накладення послідовної внутрішньої карти – шарованого нейронного атласу – у композитний результат з альфа-каналами та часовою узгодженістю.
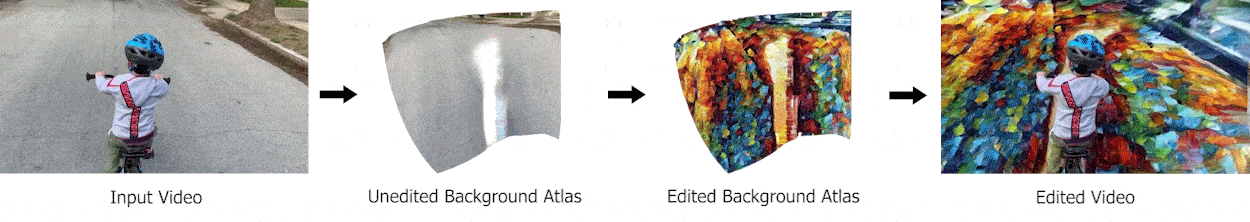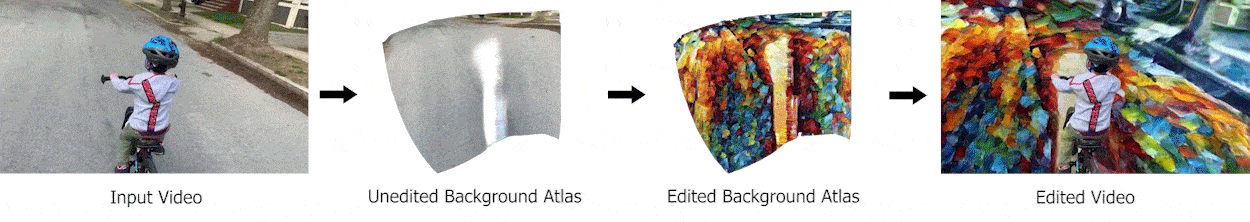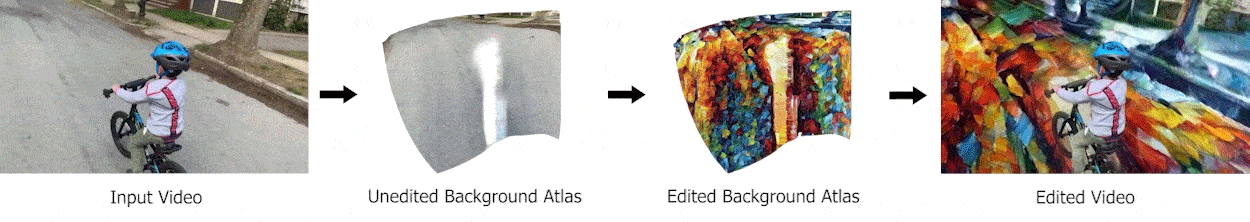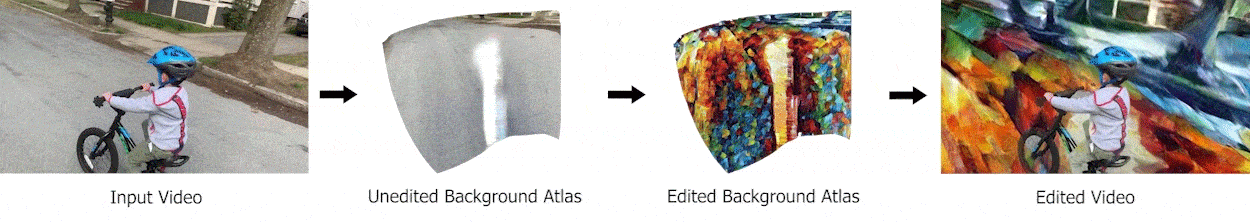
Зі статті 2021 року: оцінка повного проходу дороги у вихідному кліпі редактується через нейронну мережу таким чином, який традиційно потребував би великої ротоскопії та матч-мувінгу. Оскільки фонові та передні елементи обробляються різними мережами, маски є справді «автоматичними». Джерело: https://layered-neural-atlases.github.io/
Хоча це дещо нагадує оптичний потік у пайплайнах візуальних ефектів, шарований атлас не має прямого аналога у традиційних робочих процесах CGI, оскільки він фактично являє собою «часову карту текстур», яку можна створити та редагувати традиційними програмними методами. На другому зображенні на ілюстрації вище фон дороги представлений (фігурально) протягом усього часу виконання відео. Зміна цього базового зображення (третє зображення зліва на ілюстрації вище) призводить до послідовної зміни фону.
Зображення “розгорнутого” атласу вище представляють лише окремі інтерпретовані кадри; послідовні зміни в будь-якому цільовому кадрі відео відображаються назад до оригінального кадру, зберігаючи будь-які необхідні перекриття та інші необхідні ефекти сцени, такі як тіні чи відблиски.
Основна архітектура використовує багатошаровий персептрон (MLP) для представлення розгорнутих атласів, альфа-каналів та відображень, всі з яких оптимізуються спільно та повністю у двовимірному просторі, що усуває необхідність попередніх знань про точки 3D-геометрії, як у NeRF, глибинні карти та інші атрибути CGI-стилю.
Опорний атлас окремих об’єктів також можна надійно змінити:
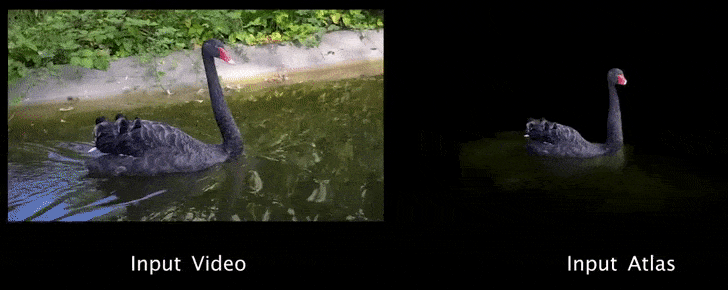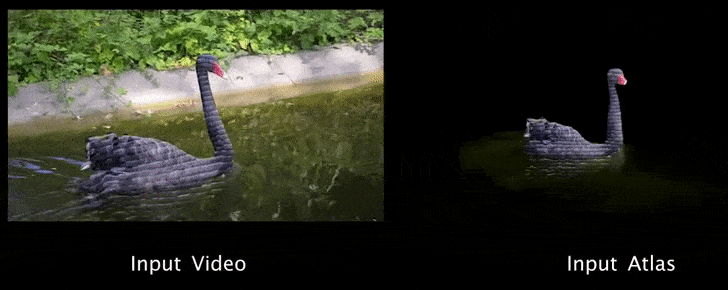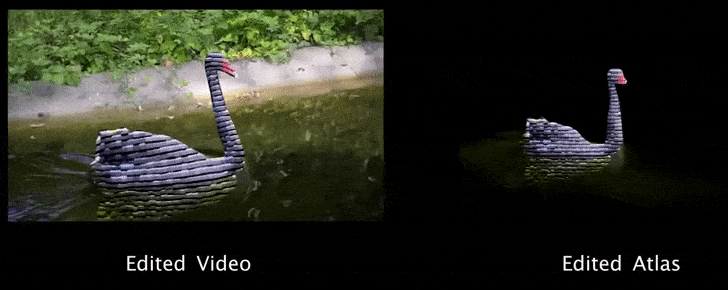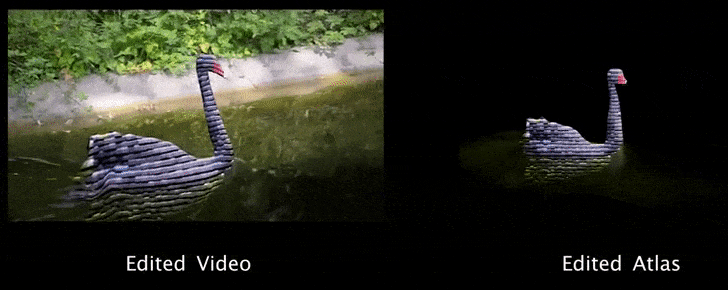
Послідовна зміна рухомого об’єкта у межах системи 2021 року. Джерело: https://www.youtube.com/watch?v=aQhakPFC4oQ
По суті, система 2021 року поєднує в собі геометричну відповідність, матч-мувінг, відображення, пере-текстурування та ротоскопію у дискретний нейронний процес.
Text2Live
Троє оригінальних авторів статті 2021 року, разом з дослідниками NVIDIA (NVDA ), серед інших учасників нової інновації на основі цієї техніки, яка поєднує потужність шарованих атласів із текстово-керованими технологіями CLIP, які повернулися до загальної уваги цього тижня з виходом OpenAI DALL-E 2.
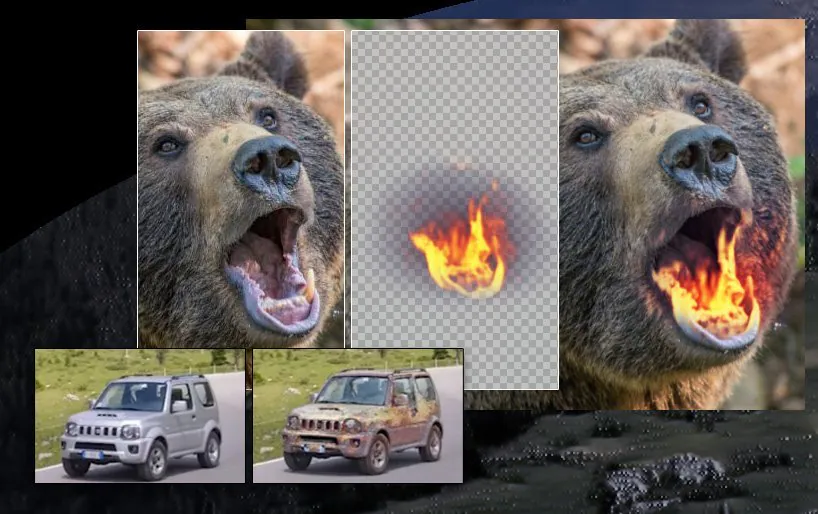
Нова архітектура, названа Text2Live, дозволяє кінцевому користувачеві створювати локалізовані редагування фактичного відеоконтенту на основі текстових підказок:
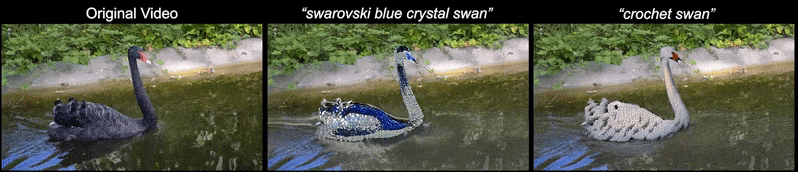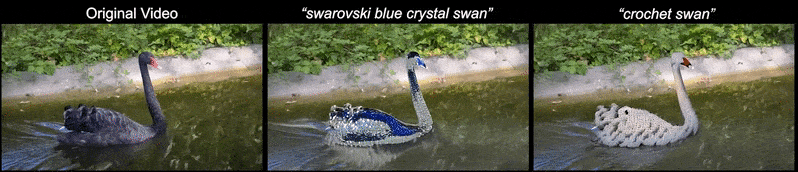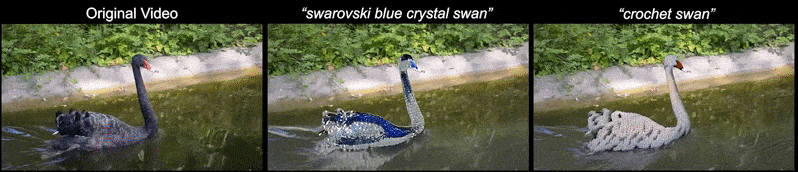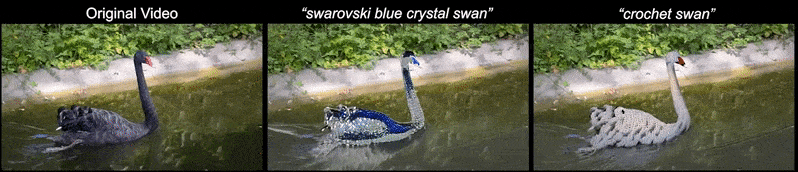
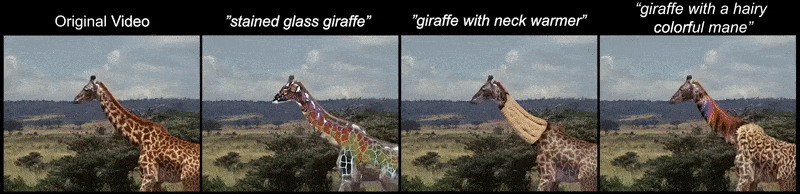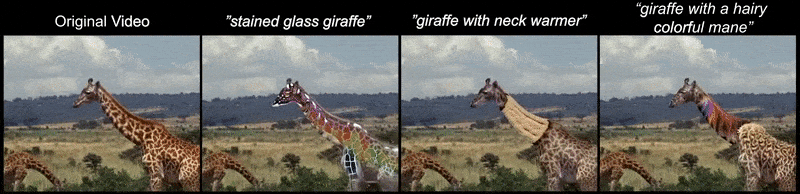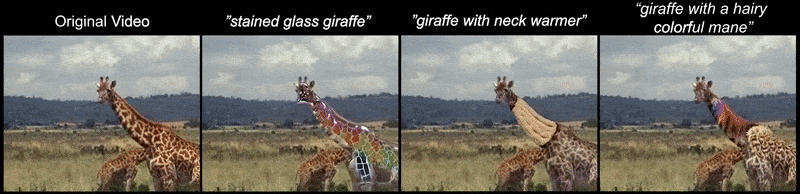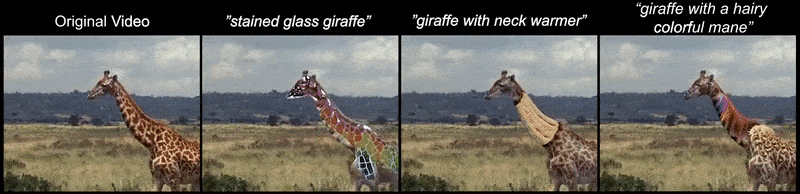
Два приклади редагування переднього плану. Для кращої роздільної здатності та чіткості дивіться оригінальні відео на https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live пропонує семантичне та високо локалізоване редагування без використання попередньо натренованого генератора, використовуючи внутрішню базу даних, специфічну для відеокліпу, який зазнає впливу.

Перетворення фону та переднього плану (об’єкта) за допомогою Text2Live. Джерело: https://text2live.github.io/sm/pages/video_results_atlases.html
Ця техніка не вимагає масок, наданих користувачем, таких як типова ротоскопія або зелений екран, а радше оцінює карти відповідності через техніку бутстрепінгу, засновану на дослідженнях 2021 року Школи комп’ютерних наук Тель-Авівського університету та Facebook AI Research (FAIR).

Вихідні карти, згенеровані за допомогою моделі загальної уваги на основі трансформера.
Нова праця називається Text2LIVE: Текст-кероване шароване редагування зображень і відео. До початкової команди 2021 року приєдналися Омер Бар-Тал з Вейцманського інституту та Йоні Кастен з NVIDIA Research.
Архітектура
Text2Live складається з генератора, натренованого на одному вхідному зображенні та текстових підказках. Модель контрастивного попереднього навчання мови та зображень (CLIP), навчена на 400 мільйонах пар тексту й зображень, забезпечує пов’язаний візуальний матеріал, з якого можна інтерпретувати перетворення, введені користувачем.

Генератор приймає вхідне зображення (кадр) та виводить цільовий шар RGBA, який містить інформацію про колір та непрозорість. Цей шар потім компонується у вихідне відео з додатковими доповненнями.

Альфа-канал у згенерованому шарі RGBA забезпечує внутрішню композитну функцію без звернення до традиційних пайплайнів, що включають програмне забезпечення на основі пікселів, таке як After Effects.
Натренувавшись на внутрішніх зображеннях, що мають значення для цільового відео чи зображення, Text2Live уникнув вимоги або інвертувати вхідне зображення у латентний простір Генеративної Адверсарної Мережі (GAN), що зараз далеко не досить точне для вимог виробництва відеомонтажу, або використовувати модель Дифузії, яка більш точна та налаштовувана, але не може зберегти вірність цільовому відео.

Різноманітні редагування на основі підказок від Text2Live.
Попередні підходи використовували або методи на основі поширення чи підходи на основі оптичного потоку. Оскільки ці техніки до певної міри засновані на кадрах, жодна з них не здатна створити узгоджений у часі вигляд змін у вихідному відео. Шарований нейронний атлас, натомість, забезпечує єдиний простір, у якому можна адресувати зміни, які потім можуть залишатися вірними до прийнятої зміни, коли відео прогресує.
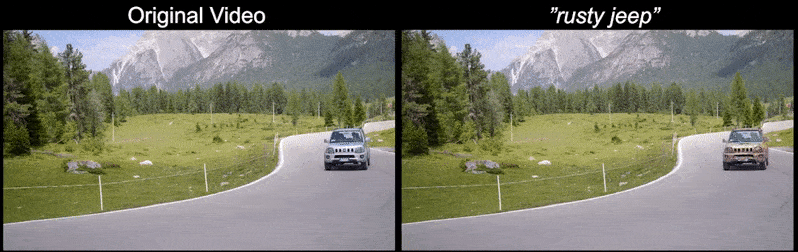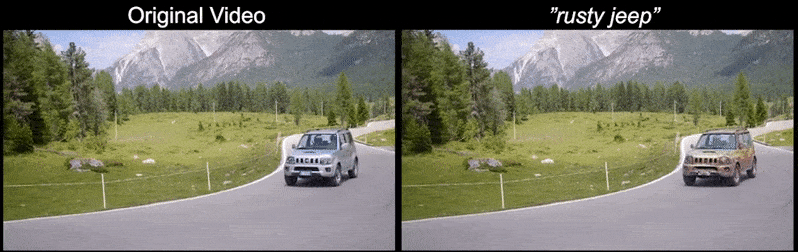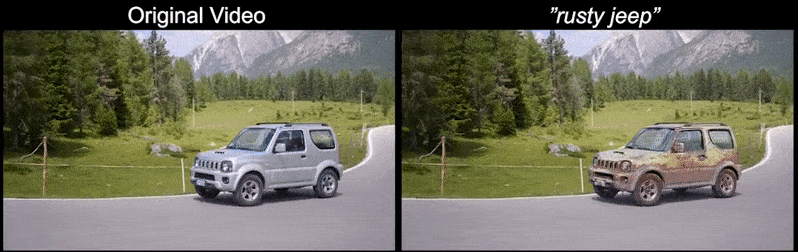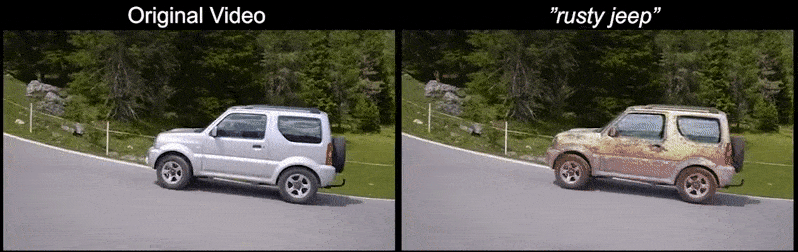
Немає мерехтіння чи випадкових галюцинацій: Text2Live отримує інтерпретацію текстової підказки «іржавий джип» та застосовує її один раз до нейронного шарованого атласу автомобіля у відео, замість повторної трансформації для кожного інтерпретованого кадру.

Робочий процес послідовної трансформації Джипа у іржавий релікт за допомогою Text2Live.
Text2Live ближче до прориву в композитингу на основі штучного інтелекту, ніж у плідному просторі генерування зображень із тексту, який привернув таку увагу цього тижня з виходом другого покоління рамки DALL-E від OpenAI (яка може включати цільові зображення як частини трансформативного процесу, але залишається обмеженою у своїй здатності безпосередньо втручатися у фотографію, крім цензури джерельних даних та введення фільтрів, призначених для запобігання зловживанню користувачами).
Text2Live дозволяє кінцевому користувачеві витягнути атлас, а потім редагувати його в одному проході у висококонтрольних піксельних середовищах, таких як Photoshop (і, можливо, навіть у більш абстрактних рамках синтезу зображень, таких як NeRF), перед тим, як повернути його у правильно орієнтоване середовище, яке не залежить від 3D-оцінки чи підходів CGI, що повертаються до старих методів.
Крім того, Text2Live, як стверджують автори, є першою порівнюваною рамкою, яка досягає маскування та композитування цілком автоматичним чином.
Уперше опубліковано 7 квітня 2022 року.





