
Погляд Anderson
Adobe Research розширює можливості редагування облич із розділенням ознак у GAN

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиМапер Adobe з прихованого в приховане фіксує ідентичність під час редагування 35…
Показати більше
- Мапер Adobe з прихованого в приховане фіксує ідентичність під час редагування 35 атрибутів обличчя без перенавчання.
- Система використовує FaceNet як дискримінатор для запобігання деградації ідентичності під час трансформацій атрибутів.
- Конкуруючі фреймворки, як-от InterFaceGAN, переплутують вік зі статтю чи окулярами, але підхід Adobe уникає цих побічних ефектів.
Не складно зрозуміти, чому зчеплення ознак є проблемою в синтезі зображень, оскільки це часто проблема в інших областях життя; наприклад, це набагато складніше видалити куркуму з каррі, ніж вийняти маринований огірок із бургера, і майже неможливо позбавити кави цукру. Деякі речі просто приходять в комплекті.
Аналогічно, зчеплення ознак є перешкодою для архітектур синтезу зображень, які б хотіли розділити різні функції та концепції при використанні машинного навчання для створення або редагування облич (або собак, човнів чи будь-якої іншої області).
Якщо б ви могли розділити такі нитки, як вік, стать, колір волосся, відтінок шкіри, емоція тощо, ви мали б початок справжньої інструментальності та гнучкості в рамках, які могли б створювати та редагувати зображення облич на справді детальному рівні, не втягуючи небажаних “пасажирів” у ці конверсії.

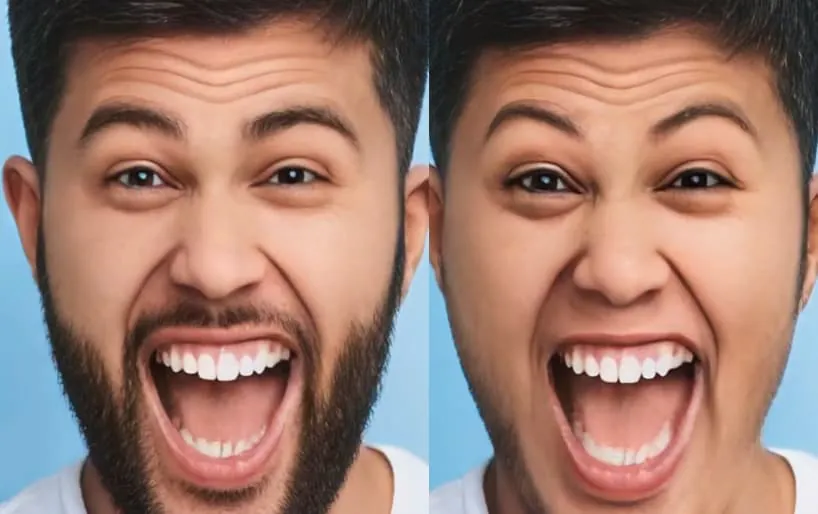
При максимальному зчеплення ознакі (зверху зліва) ви можете тільки змінити зображення навченої мережі GAN на зображення іншої людини.
Це фактично використання останньої технології комп’ютерного зору для досягнення чогось, що було вирішено іншими засобами більше тридцяти років тому.
З деякою мірою розділення (‘Середнє розділення’ у вищезазначеному зображенні), можна виконувати стилеві зміни, такі як колір волосся, вираз обличчя, нанесення косметики та обмежене обертання голови тощо.

Джерело: FEAT: Face Editing with Attention, лютий 2022, https://arxiv.org/pdf/2202.02713.pdf
Було кілька спроб за останні два роки створити інтерактивні середовища редагування обличчя, які дозволяють користувачеві змінювати характеристики обличчя за допомогою слайдерів та інших традиційних взаємодій з інтерфейсом, зберігаючи при цьому основні риси цільового обличчя при внесенні змін. Однак це виявилося складною задачею через зчеплення ознак функцій/стилів у латентному просторі GAN.
Наприклад, ознака окулярів часто переплетена з ознакою старіння, що означає, що додавання окулярів може також “старити” обличчя, а старіння обличчя може додати окуляри, залежно від ступеня застосованого розділення високорівневих функцій (див. “Тестування” нижче для прикладів).
Більш того, майже неможливо змінити колір волосся та інші аспекти волосся без перерахування волосся та його розташування, що дає “шиплячий” перехідний ефект.

Джерело: InterFaceGAN Demo (CVPR 2020), https://www.youtube.com/watch?v=uoftpl3Bj6w
Перехід між латентними кодами GAN
Нова робота Adobe (ADBE ), представлена на WACV 2022, пропонує новий підхід до цих основних проблем у роботі під назвою Від латентного до латентного: навчений перетворювач для збереження ідентичності під час редагування декількох атрибутів обличчя в зображеннях, згенерованих StyleGAN.
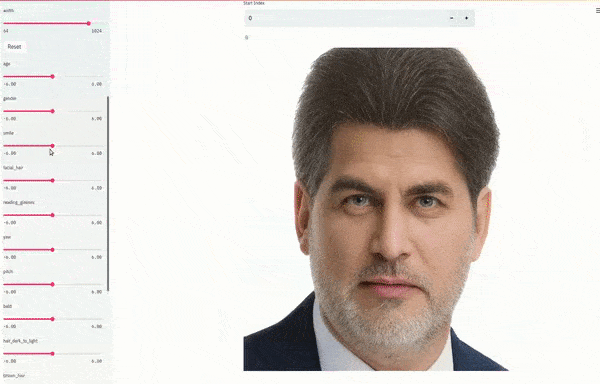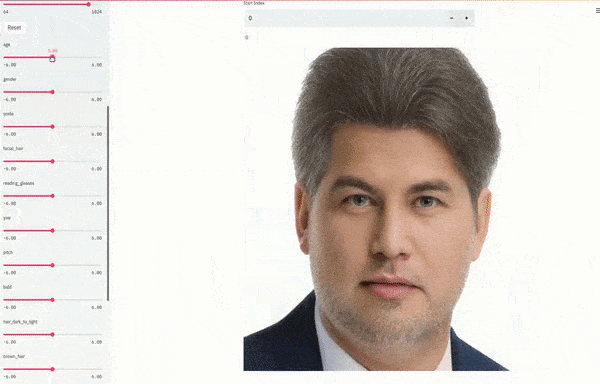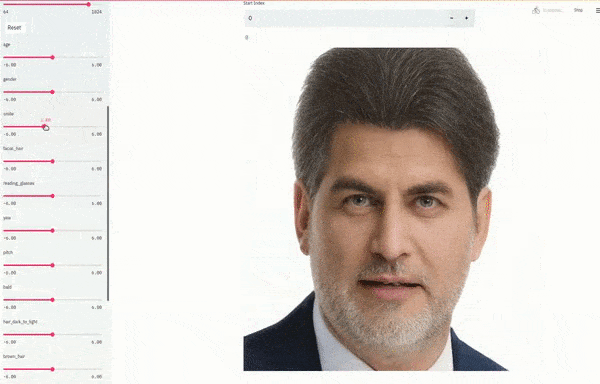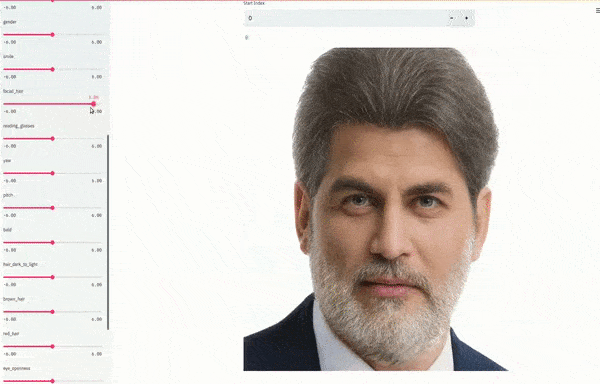
Додатковий матеріал з роботи Від латентного до латентного: навчений перетворювач для збереження ідентичності під час редагування декількох атрибутів обличчя в зображеннях, згенерованих StyleGAN. Тут ми бачимо, що базові характеристики в навченому обличчі не втягуються в не пов’язані з ними зміни. Див. повне відео нижче для більшої деталізації та роздільності. Джерело: https://www.youtube.com/watch?v=rf_61llRH0Q
Роботу очолив науковець Adobe Siavash Khodadadeh разом з чотирма іншими дослідниками Adobe та дослідником з кафедри комп’ютерних наук Університету Центральної Флориди.
Ця робота цікава тим, що Adobe вже деякий час працює в цій сфері, і легко уявити цю функціональність у майбутньому проекті Creative Suite; але головним чином тому, що архітектура, створена для цього проекту, підходить до збереження візуальної цілісності в редакторі обличчя GAN при застосуванні змін.
Автори заявляють:
‘[Ми] тренуємо нейронну мережу для виконання латентно-латентної трансформації, яка знаходить латентний код, відповідний зображенню з зміненим атрибутом. Оскільки цей метод виконує перетворення за один крок, він не залежить від лінійної або нелінійної траєкторії поступової зміни атрибутів.’
‘Завдяки наскрізному навчанню мережі протягом усього процесу генерації, система може адаптуватися до латентних просторів архітектур-генераторів. Властивості збереження, такі як збереження ідентичності людини, можуть бути закодовані у вигляді тренувальних втрат. ‘
‘Як тільки латентно-латентна мережа була тренована, її можна повторно використовувати для довільних зображень без повторного навчання.’
Це означає, що запропонована архітектура надходить до кінцевого користувача у готовому стані. Їй все ще потрібно запустити нейронну мережу на локальних ресурсах, але нові зображення можна “впустити” та зробити готовими для зміни майже відразу, оскільки архітектура достатньо розділяє ознаки й не потребує подальшого навчання для кожного зображення.
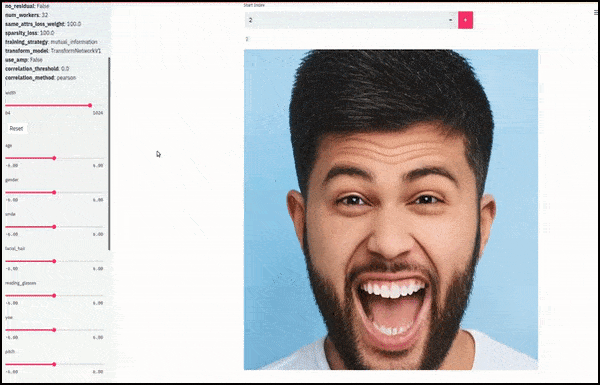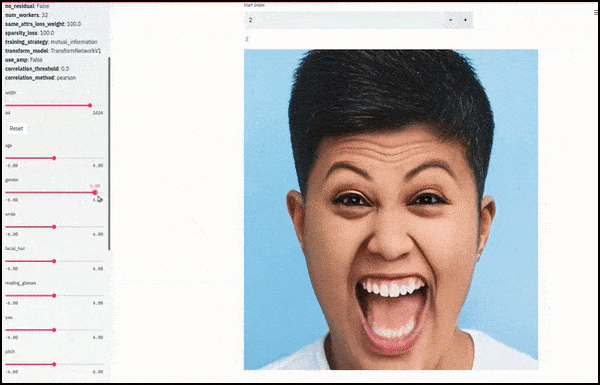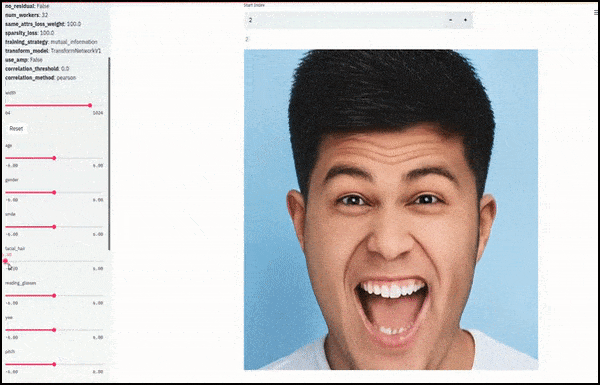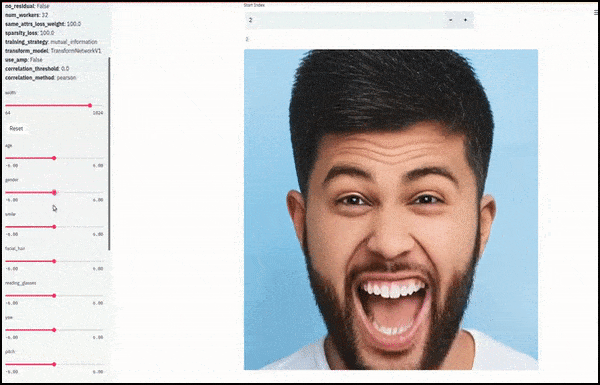
Стать та волосся на обличчі змінені як слайдери малюють довільні шляхи через латентний простір, а не просто ‘перемикаються між кінцевими точками’. Див. відео нижче для більшої кількості трансформацій у вищій роздільності.
Одним з основних досягнень у роботі є здатність мережі “заморозити” ідентичності у латентному просторі, змінюючи тільки атрибут у цільовому векторі та надаючи “коригувальні члени”, які зберігають ідентичності під час трансформації.
По суті, запропонована мережа вбудована у ширшу архітектуру, яка оркеструє всі оброблені елементи, які проходять через попередньо треновані компоненти з замороженими вагами, які не будуть викликати нежадані бічні ефекти на трансформації.
Оскільки процес тренування залежить від трійок, які можна згенерувати або за допомогою вихідного зображення (під інверсією GAN) чи існуючого початкового латентного коду, весь процес навчання відбувається без учителя, а неявні операції зі звичного для таких систем маркування та відбору даних фактично вже закладені в архітектуру. Насправді, нова система використовує готові регресори атрибутів:
‘Кількість атрибутів, які наша мережа може незалежно контролювати, обмежена тільки можливостями розпізнавача(ів) – якщо у вас є розпізнавач для атрибута, ми можемо додати його до довільних облич. У наших експериментах ми тренували латентно-латентну мережу для регулювання 35 різних атрибутів обличчя, більше, ніж у будь-якому попередньому підході.’
Система включає додатковий засіб захисту проти нежаданих “бічних” трансформацій: у відсутності запиту на зміну атрибута латентно-латентна мережа буде відображати латентний вектор на самого себе, ще більше збільшуючи стабільну тривалість цільової ідентичності.
Розпізнавання обличчя
Одна з повторюваних проблем редакторів обличчя GAN та архітектур на основі кодувача/декодувача за останні кілька років полягала в тому, що застосовані трансформації схильні погіршувати подібність. Для боротьби з цим проект Adobe використовує вбудовану мережу розпізнавання обличчя під назвою FaceNet як дискримінатор.

Архітектура проекту, див. нижче ліворуч для включення FaceNet. Джерело: Від латентного до латентного: навчений перетворювач для збереження ідентичності під час редагування декількох атрибутів обличчя в зображеннях, згенерованих StyleGAN, OpenAccess.
(На особистому рівні це здається сприятливим кроком до інтеграції стандартних систем розпізнавання обличчя та навіть розпізнавання виразів у генеративні мережі, аргументно найкращий шлях вперед для подолання сліпого піксель-за-пікселем відображення, яке домінує в поточних архітектурах deepfake за рахунок виразності та інших важливих областей у сфері генерації обличчя.)
Доступ до всіх зон у латентному просторі
Іншою вражаючою особливістю цієї рамки є її здатність довільно рухатися між потенційними трансформаціями у латентному просторі на розсуд користувача. Були попередні системи, які надавали дослідницькі інтерфейси, часто залишаючи користувача фактично “перемикаючись” між фіксованими хронологіями трансформації функцій – вражаюче, але часто досить лінійний або прескриптивний досвід.
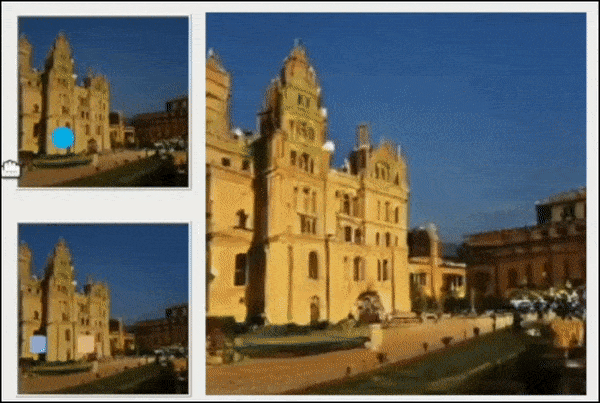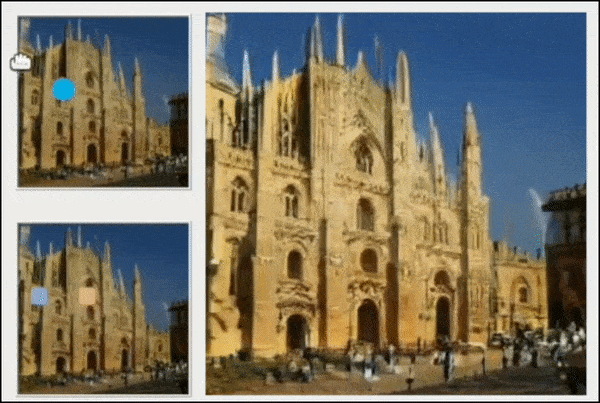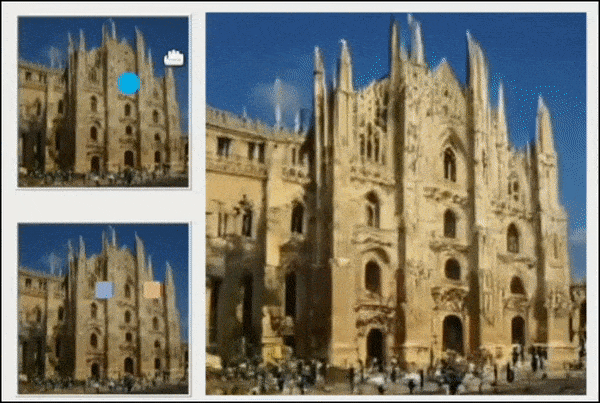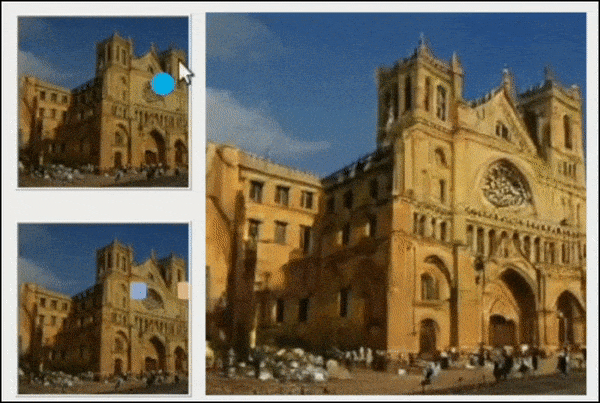
З Покращення GAN-рівноваги за допомогою підвищення просторової свідомості: тут користувач перемикається через ряд потенційних точок переходу між двома латентними просторовими розташуваннями, але в межах попередньо тренованих розташувань у латентному просторі. Для застосування інших видів трансформації на основі того самого матеріалу необхідна переконфігурація та/або повторна тренування. Джерело: https://genforce.github.io/eqgan/
Окрім можливості використовувати цілком нові зображення, користувач також може вручну “заморозити” елементи, які вони хочуть зберегти під час процесу трансформації. Таким чином користувач може забезпечити, наприклад, що фон не зміщується, або що очі залишаються відкритими або закритими.
Дані
Мережа регресії атрибутів була тренована на трьох наборах даних: FFHQ, CelebAMask-HQ та локальному наборі даних, згенерованому GAN шляхом вибірки 400 000 векторів з простору Z StyleGAN-V2.
Зображення поза розподілом були відфільтровані, а атрибути витягнуті за допомогою Face API від Microsoft, а отриманий набір зображень був розділений у співвідношенні 90/10, залишаючи 721 218 тренувальних зображень та 72 172 тестових зображень для порівняння.
Тестування
Хоча експериментальна мережа спочатку була сконфігурована для розміщення 35 потенційних трансформацій, їх було скорочено до восьми для проведення аналогічного тестування проти порівнюваних рамок InterFaceGAN, GANSpace та StyleFlow.
Вісім вибраних атрибутів були віком, облисінням, бородою, виразом, статтю, окулярами, нахилом голови вгору чи вниз та поворотом голови вбік. Було необхідно перепрограмувати конкурентні рамки для деяких з восьми атрибутів, які не були передбачені в оригінальному розподілі, наприклад, додавання облисіння та бороди до InterFaceGAN.
Як і очікувалося, більший рівень зчеплення ознаку відбувся в конкуруючих архітектурах. Наприклад, у одному з тестів InterFaceGAN та StyleFlow змінили стать суб’єкта, коли їм було доручено застосувати віковий атрибут:

Два з конкуруючих рамок включили зміну статі у трансформацію ‘віку’, а також змінили колір волосся без прямого бажання користувача.
Крім того, дві з конкуруючих рамок виявили, що окуляри та вік є невід’ємними аспектами:

Окуляри та колір волосся змінені без додаткової оплати!
Це не беззаперечна перемога цього дослідження за всіма показниками: як можна побачити у супроводжувальному відео, розміщеному в кінці статті, рамка є найменш ефективною при спробі екстраполювати різні кути повороту голови вбік, тоді як GANSpace має кращий загальний результат для віку та додавання окулярів. Архітектура переходу між латентними кодами показала однакові результати з GANSpace та StyleFlow щодо зміни нахилу голови вгору чи вниз.

Результати, розраховані на основі калібрування детектора обличчя MTCNN. Нижчі результати кращі.
Для подальших деталей та кращої роздільності прикладів див. супроводжувальне відео нижче.
Перша публікація 16 лютого 2022 року.





