
ผู้นำทางความคิด
ทำไมคุณภาพข้อมูลถึงเป็นตัวตัดสินว่า AI ขององค์กรจะสำเร็จหรือล้มเหลว

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
นับตั้งแต่ OpenAI เปิดตัว ChatGPT ในปลายปี 2022 ทุกๆ บริษัทต่างพยายามเร่งพัฒนา AI ให้เร็วขึ้น ผู้ผลิตฮาร์ดแวร์รายใหญ่ๆ เช่น Nvidia (NVDA ) ขาย GPU มากกว่าที่เคย และผู้สร้างโมเดลขนาดใหญ่ๆ เช่น OpenAI และ Anthropic ยังคงสร้างโมเดลที่ใหญ่ขึ้นและใหญ่ขึ้น
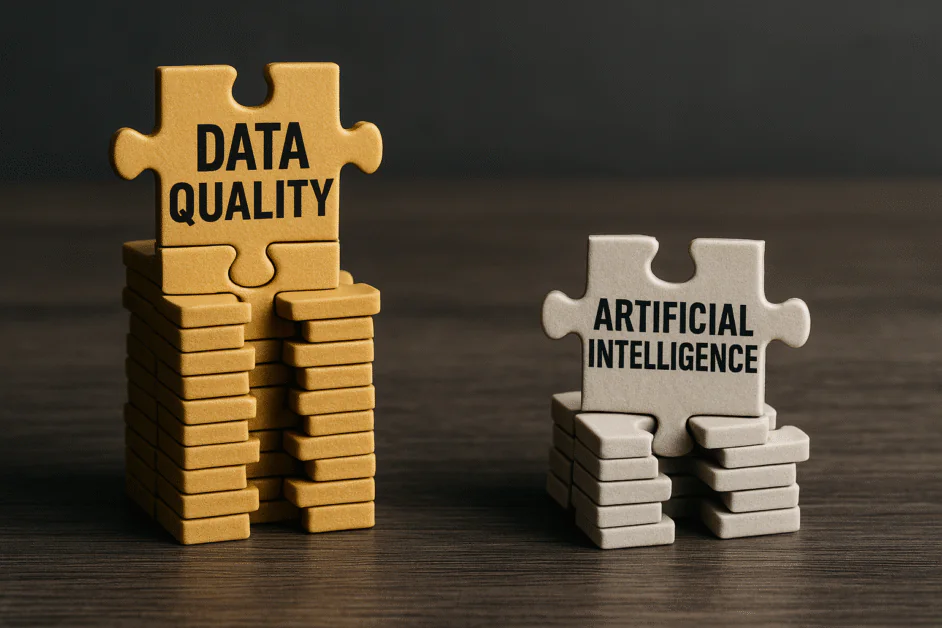
อย่างไรก็ตาม แม้จะมีโมเดลที่ทันสมัยและงบประมาณที่มาก แต่หลายๆ โครงการ AI ก็ยังคงล้มเหลว เราได้เห็นสิ่งนี้เกิดขึ้นในหลายๆ อุตสาหกรรม ตั้งแต่สาธารณสุข ไปจนถึงการขนส่ง และการเงิน สาเหตุไม่ได้ไกลตัวเลย: AI มีคุณภาพเท่ากับคุณภาพของข้อมูลที่ใช้ในการฝึกอบรมและข้อมูลที่ได้รับในเวลาจริง เมื่อข้อมูลนั้นมีการระบุฉลากที่ไม่ดี ล้าสมัย หรือไม่สมบูรณ์ โมเดลใดๆ ก็ไม่สามารถให้ผลลัพธ์ที่เชื่อถือได้
และนี่คือปัญหาที่ใหญ่ที่สุดหลายๆ บริษัทต้องเผชิญในปัจจุบัน พวกเขาใช้เงินลงทุนในเครื่องมือ AI ในขณะที่ระบบข้อมูลของพวกเขายังคงกระจัดกระจายและไม่น่าเชื่อถือ ผลลัพธ์คือภาพลวงตาของความก้าวหน้า ในขณะที่โมเดลให้คำตอบที่น่าประทับใจ แต่ข้อมูลที่ใช้ในการสร้างคำตอบนั้นมีฐานะที่ไม่แข็งแกร่ง จริงๆ แล้วอุปสรรคต่อความสำเร็จของ AI ไม่ใช่ประสิทธิภาพของโมเดล แต่เป็นคุณภาพของข้อมูล
ข้อมูลที่ดีหมายถึงอะไร
ข้อมูลที่มีคุณภาพไม่ได้หมายถึงความแม่นยำเพียงอย่างเดียว แต่หมายถึงข้อมูลที่เป็นปัจจุบัน สมบูรณ์ และเกี่ยวข้องกับปัญหาที่ต้องแก้ไข ลองนึกภาพลูกค้าที่พยายามยกเลิกคำสั่งซื้อบนเว็บไซต์ขายของออนไลน์ ระบบจะต้องตรวจสอบรายละเอียดคำสั่งซื้อ สถานะการจัดส่ง และบันทึกการชำระเงิน หากข้อมูลเหล่านั้นอยู่ในระบบที่แตกต่างกันและไม่สามารถสื่อสารกัน โมเดล AI จะไม่สามารถให้คำตอบที่มีประโยชน์ได้
ข้อมูลที่ดีเชื่อมต่อจุดเหล่านี้ทันที ทำให้ AI สามารถมองเห็นภาพรวมได้มากกว่าเพียงแค่ส่วนหนึ่งของมัน ข้อมูลที่ไม่ดี另一方面บังคับให้โมเดลต้องเดา และเมื่อ AI เริ่มเดา มันจะทำผิดพลาดที่มีค่าใช้จ่ายและทำลายความไว้วางใจ ตัวอย่างล่าสุดแสดงให้เห็นว่าอันตรายของการเดาเหล่านี้
ชัตบอท AI ของนิวยอร์กซิตี้ ให้คำแนะนำที่ผิดกฎหมายเพราะมันใช้ข้อมูลกฎหมายที่ล้าสมัยหรือไม่สมบูรณ์ ชัตบอทบริการลูกค้าของแอร์แคเนดา ให้คำกล่าวที่ไม่ถูกต้องเพราะมันไม่มีข้อมูลจากนโยบายบริษัท แม้แต่ระบบจัดหางานขนาดใหญ่ก็ยังกรองผู้สมัครที่ไม่ถูกต้องเนื่องจากข้อมูลที่มีอคติหรือมีการระบุฉลากที่ไม่ถูกต้อง ตามที่เห็นใน การยุติข้อพิพาท AI ของ EEOC ความล้มเหลวเหล่านี้ไม่ใช่แค่ทางเทคนิค แต่ยังเป็นเรื่องของชื่อเสียงและทางการเงิน และเกิดจากระบบ AI ที่ได้รับการฝึกอบรมจากข้อมูลที่ไม่น่าเชื่อถือ
การศึกษาในอุตสาหกรรมยืนยันถึงขนาดของปัญหานี้ Gartner รายงานว่า 80 เปอร์เซ็นต์ของโครงการ AI ล้มเหลวในการขยายขนาดเนื่องจากคุณภาพและความปลอดภัยของข้อมูลที่ไม่ดี ในทำนองเดียวกัน การสำรวจของ MIT Sloan Management Review พบว่าปัญหาข้อมูล ไม่ใช่แอลกอริทึม เป็นสาเหตุหลักที่โครงการ AI ขององค์กรล้มเหลว
วัฒนธรรมมีความสำคัญเท่ากับโค้ด
การปรับปรุงคุณภาพข้อมูลไม่ใช่สิ่งที่คุณสามารถแก้ไขได้ด้วยเครื่องมือหรือคำสั่งเดียว มันจำเป็นต้องมีการเปลี่ยนแปลงทางวัฒนธรรม ซึ่งหมายความว่าผู้นำธุรกิจจะต้องปฏิบัติต่อข้อมูลเหมือนระบบที่มีชีวิตที่ต้องการการดูแลและความรับผิดชอบ สิ่งนี้ไม่ได้เพียงแค่ประกาศว่า “เราต้องการทำให้ข้อมูลดีขึ้น” — นั่นไม่เพียงพอ ทุกส่วนขององค์กรจะต้องเข้าใจว่าข้อมูลเคลื่อนไหวอย่างไร ใครเป็นเจ้าของ และเกิดอะไรขึ้นเมื่อมันเปลี่ยนแปลง (AC.TO )
เรามองเห็นแล้วว่าสิ่งนี้เกิดขึ้นในระบบจริงหลายๆ ระบบหลายๆ แอปพลิเคชัน AI พึ่งพาการอัปเดตข้อมูลทุกคืน หากฐานข้อมูลของคุณอัปเดตเพียงครั้งเดียวต่อวัน ความรู้ของโมเดลจะล้าสมัยเสมอ ในสภาพแวดล้อมที่เปลี่ยนแปลงอย่างรวดเร็ว ความล่าช้านี้อาจหมายถึงข้อมูลที่ล้าสมัยและตัดสินใจที่ไม่ดี บริษัทต่างๆ ต้องคิดใหม่ว่าข้อมูลไหลเวียนอย่างไร ตั้งแต่วิธีการเก็บข้อมูลไปจนถึงวิธีการส่งมอบให้กับโมเดล
การทำสิ่งนี้อย่างดีสามารถช่วยประหยัดเวลาและค่าใช้จ่ายได้มาก เมื่อข้อมูลไหลเวียนได้รับการออกแบบด้วยความชัดเจนและวัตถุประสงค์ ระบบ AI สามารถเรียนรู้และดำเนินการตามข้อมูลล่าสุดและเกี่ยวข้องได้ เมื่อไม่เช่นนั้น ทีมงานจะใช้เวลาในการทำความสะอาดข้อมูลมากกว่าการใช้งาน
ผู้เชี่ยวชาญด้าน การบริหารจัดการข้อมูล มักจะชี้ให้เห็นว่าคำตอบสำคัญสำหรับคุณภาพข้อมูลที่ดีคือการสร้างวงจรป้อนกลับระหว่างคน กระบวนการ และแพลตฟอร์ม หากไม่มีวงจรนี้ ข้อมูลจะเก่าและโมเดลจะสูญเสียสัมผัสกับสภาพแวดล้อมจริง — ปัญหาที่บางครั้งเรียกว่า “การลื่นไถลของข้อมูล”
การสร้างสมดุลระหว่างความเร็วและความซื่อสัตย์
มักจะมีความตึงเครียดระหว่างการเคลื่อนไหวอย่างรวดเร็วและการรักษาความแม่นยำ องค์กรหลายแห่งต้องการผลลัพธ์ทันทีจากการลงทุน AI แต่การเร่งรีบอาจนำไปสู่ปัญหาที่ใหญ่ขึ้นในภายหลัง เป้าหมายควรเป็นการสร้างระบบที่มีความคล่องตัวและความซื่อสัตย์ ในอีกคำหนึ่ง คือการสร้างระบบที่สามารถเคลื่อนไหวได้อย่างรวดเร็วโดยไม่สูญเสียความแม่นยำ
ในจุดนี้ ทุกบริษัทควรระบุเส้นทางที่ชัดเจนสำหรับข้อมูลไหลเวียนจากแหล่งที่มาไปยังโมเดลในเวลาจริง นอกจากนี้ยังช่วยให้กำหนดข้อมูลประเภทใดที่ได้รับอนุญาตและข้อมูลประเภทใดที่ต้องถูกปิดกั้น ข้อมูลที่ละเอียดอ่อนหรือเป็นความลับไม่ควรเข้าถึงโมเดล แม้ว่าผู้ใช้จะมีสิทธิ์เข้าถึงข้อมูลนั้น การปกป้องขอบเขตนี้ช่วยสร้างความไว้วางใจและป้องกันระบบ AI จากการรั่วไหลหรือใช้ข้อมูลในทางที่ผิด
เมื่อ AI มีความเป็นอิสระมากขึ้น การกำกับดูแลของมนุษย์ยังคงมีความสำคัญ โมเดลไม่ควรควบคุมการดำเนินการทางธุรกิจโดยสมบูรณ์ และไม่ควรตัดสินใจใดๆ โดยไม่มีการตรวจสอบจากมนุษย์ มนุษย์จะต้องตรวจสอบและอนุมัติการดำเนินการของโมเดลเพื่อให้แน่ใจว่ามันสอดคล้องกับนโยบายและข้อบังคับของบริษัท
การสร้างคุณภาพตั้งแต่พื้นฐาน
การรักษาคุณภาพข้อมูลในระดับที่กว้างขวางไม่ใช่แค่การแก้ไขข้อผิดพลาด แต่เริ่มต้นตั้งแต่การออกแบบ คุณจำเป็นต้องระบุว่าข้อมูลที่น่าเชื่อถือที่สุดของคุณอาศัยอยู่ที่ไหน จากนั้นออกแบบระบบที่รวบรวมข้อมูลเหล่านั้นไว้ในที่เดียวที่เชื่อถือได้ จากที่นั่น คุณสามารถติดตามข้อมูลที่โมเดลใช้และที่มาของมัน
แนวทางนี้ป้องกันความสับสนและทำให้ระบบมีความโปร่งใส มันช่วยให้ทีมงานแก้ไขปัญหาได้เร็วขึ้นเมื่อมีอะไรผิดพลาด เมื่อคุณรู้ว่าข้อมูลใดที่ใช้ในการตอบคำถามของโมเดล คุณสามารถตรวจสอบและแก้ไขปัญหาได้ก่อนที่จะแพร่กระจาย
อนาคตของ AI ในองค์กรจะ thuộcส่วนบริษัทที่ฝังตัวคุณภาพลงในโครงสร้างพื้นฐานโดยอัตโนมัติ เราคาดหวังที่จะเห็นระบบ AI ที่พร้อมใช้งานมากขึ้น ซึ่งจัดการทั้งการให้เหตุผลและการบูรณาการข้อมูลในแพ็คเกจเดียว “เครื่องใช้ AI” เหล่านี้อาจทำให้องค์กรต่างๆ ติดตั้งระบบอัจฉริยะได้ง่ายขึ้นโดยไม่สูญเสียการควบคุมข้อมูล
นักวิเคราะห์คาดการณ์ว่าองค์กรที่สามารถรวมและควบคุมข้อมูลได้อย่างมีประสิทธิภาพจะเห็นการนำ AI ไปใช้เร็วขึ้นและมีผลตอบแทนที่สูงขึ้นจากโครงการ AI รายงานล่าสุดเกี่ยวกับ ความพร้อมของข้อมูล อธิบายว่าความสามารถนี้แยกองค์กรที่สร้างนวัตกรรมอย่างต่อเนื่องจากองค์กรที่หยุดชะงักหลังการทดลองเบื้องต้น ความแตกต่างมักมาจากการที่ระบบ AI ของพวกเขามีฐานข้อมูลที่สม่ำเสมอและเป็นระบบ
สรุป
คุณภาพข้อมูลอาจไม่น่าตื่นเต้นเท่ากับการพัฒนาโมเดลใหม่ๆ แต่มันเป็นพลังเงียบๆ ที่ตัดสินว่า AI จะสำเร็จหรือล้มเหลว โดยไม่มีข้อมูลที่สะอาด ปัจจุบัน และสม่ำเสมอ ระบบที่ฉลาดที่สุดก็จะสะดุดเช่นกัน แต่ด้วยข้อมูลที่ดี แม้แต่โครงการ AI ที่ไม่ใหญ่โตก็สามารถสร้างคุณค่าที่ยั่งยืนได้
ทุกผู้นำที่ลงทุนใน AI ควรถามคำถามง่ายๆ ว่า: เราเชื่อถือข้อมูลที่ขับเคลื่อนการตัดสินใจของเราหรือไม่ จากสิ่งที่เราเห็นมา บริษัทที่สามารถตอบ “ใช่” ได้อย่างมั่นใจใจคือบริษัทที่นำหน้าในการแข่งขัน AI แล้ว


