
พื้นฐาน AI
การตรวจสอบข้าม (Cross-Validation) คืออะไร? วิธีประเมินประสิทธิภาพโมเดลอย่างเชื่อถือได้
Cross‑validation หมุนเวียนการถือครองโฟลด์ที่แยกออกอย่างต่อเนื่อง เพื่อให้ทีมสามารถประมาณประสิทธิภาพและความแปรปรวนเมื่อการแบ่ง validation เพียงครั้งเดียวอาจไม่เสถียร คู่มือนี้อธิบายกลไก, การแลกเปลี่ยน, การประเมิน, และการควบคุมที่สำคัญในทางปฏิบัติ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
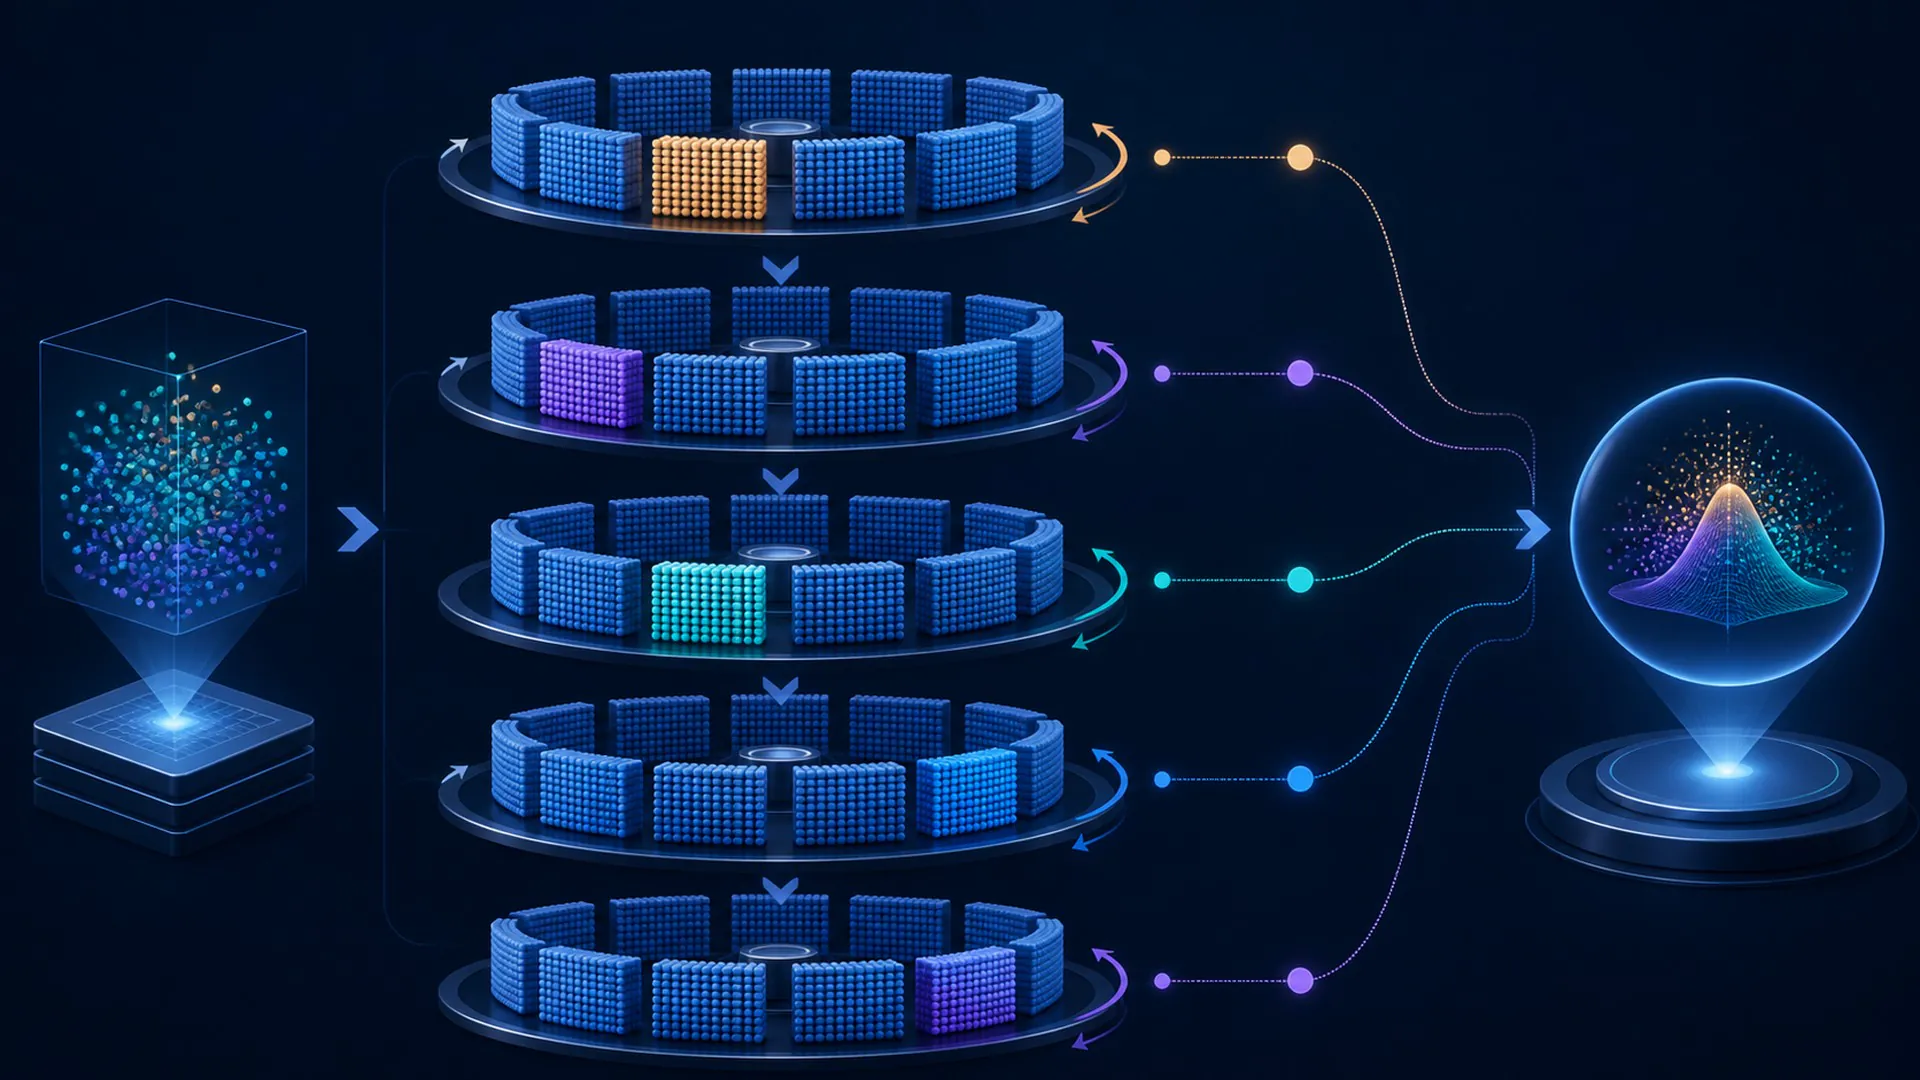
การตรวจสอบข้ามทำการหมุนพับที่ถือเป็นข้อมูลทดสอบซ้ำหลายครั้งเพื่อให้ทีมสามารถประเมินประสิทธิภาพและความแปรปรวนได้เมื่อการแบ่งการตรวจสอบเพียงครั้งเดียวอาจไม่เสถียร
การตรวจสอบข้ามต้องการคำอธิบายที่แม่นยำเพราะชื่อของมันระบุถึงกระบวนการไหลของข้อมูล การเลือกการฝึก กลไกการทำงาน หรือขอบเขตการกำกับดูแลที่เฉพาะเจาะจง การถือว่ามันเป็นคำพ้องของ “AI ขั้นสูง” ทำให้ข้ออ้างไม่สามารถทดสอบได้ คู่มือนี้จะติดตามแนวคิดตั้งแต่ข้อมูลเข้าและสมมติฐานจนถึงผลลัพธ์ที่สังเกตได้ แล้วทดสอบทางลัดที่มักจะสับสนกับมันมากที่สุด
การตรวจสอบข้าม: คำจำกัดความ, ขอบเขต, และวัตถุประสงค์
การตรวจสอบข้ามทำการหมุนพับที่ถือเป็นข้อมูลทดสอบซ้ำหลายครั้งเพื่อให้ทีมสามารถประเมินประสิทธิภาพและความแปรปรวนได้เมื่อการแบ่งการตรวจสอบเพียงครั้งเดียวอาจไม่เสถียร คำจำกัดความประกอบด้วยข้อผูกมัดเชิงปฏิบัติสามประการ: มีข้อมูลเข้าอย่างชัดเจน การแปลงหรือการตัดสินใจที่เป็นลักษณะของการตรวจสอบข้าม และผลลัพธ์ที่สามารถประเมินเทียบกับวัตถุประสงค์ที่ระบุไว้ หากหนึ่งในองค์ประกอบเหล่านี้ขาดหาย ป้ายกำกับอาจบรรยายถึงความปรารถนาแทนกลไกที่ได้ดำเนินการจริง
การเรียนรู้เชิงสถิติเปลี่ยนตัวอย่างจำกัดให้เป็นข้ออ้างเกี่ยวกับข้อมูลในอนาคต การแบ่งข้อมูล, การปรับแต่ง, การทำให้เป็นระเบียบ, ตัวชี้วัด, และการเฝ้าติดตามจึงเป็นส่วนหนึ่งของปัญหาการทั่วไป化หนึ่งเดียว ไม่ใช่เทคนิคแยกตามตำราเรียน สำหรับการตรวจสอบข้าม มุมมองระบบนี้สำคัญเพราะประสิทธิภาพอาจถูกกำหนดโดยข้อมูลโดยรอบ, อินเทอร์เฟซ, ฮาร์ดแวร์, สิทธิ์การเข้าถึง, และผู้คน แม้ว่าโมเดลพื้นฐานจะไม่เปลี่ยนแปลง คำอธิบายที่มีประโยชน์จึงแยกพฤติกรรมที่โมเดลเรียนรู้ออกจากผลิตภัณฑ์ที่ตัดสินใจว่าเมื่อใด, ที่ไหน, และด้วยอำนาจใดที่พฤติกรรมนั้นจะถูกใช้
ทางลัดที่ทำให้เข้าใจผิดที่ใกล้เคียงที่สุดคือการทดสอบหลายโมเดลบนชุดทดสอบสุดท้าย แม้ว่ามันอาจมีลักษณะเด่นที่มองเห็นได้ร่วมกับการตรวจสอบข้าม แต่ก็เปลี่ยนเรื่องราวเชิงสาเหตุ: หลักฐานที่ต่างกันจะยืนยันความสำเร็จ, ทรัพยากรที่ต่างกันจะเป็นตัวกำหนดต้นทุน, และการควบคุมที่ต่างกันจะป้องกันอันตราย ดังนั้นขอบเขตจึงเป็นเชิงปฏิบัติ มากกว่าการกำหนดตามศัพท์
แผนผังการทำงานห้าขั้นตอนของการตรวจสอบข้าม
แผนภาพนี้เป็นแผนผังเชิงสาเหตุแบบกะทัดรัดสำหรับการตรวจสอบข้าม ไม่ได้หมายความว่าการนำไปใช้ทุกกรณีต้องมีห้าคอมโพเนนต์ซอฟต์แวร์บางอย่าง ระบบบางอย่างอาจรวมขั้นตอนเข้าด้วยกันหรือทำซ้ำในลูป แผนผังยังคงมีประโยชน์เพราะบังคับให้การเปลี่ยนแปลงข้อมูลหรืออำนาจแต่ละครั้งต้องมีเจ้าของ, อินพุต, เอาต์พุต, และการทดสอบ
1. แบ่งข้อมูลเป็นพับที่เหมาะสม: ข้อมูลเข้าและสมมติฐานในการตรวจสอบข้าม
ในขั้นตอนนี้ของการตรวจสอบข้าม ระบบต้องแบ่งข้อมูลเป็นพับที่เหมาะสม คำถามที่มีประโยชน์ไม่ได้เพียงว่าการดำเนินการนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกการดำเนินการนี้ออกจากการทดสอบหลายโมเดลบนชุดทดสอบสุดท้ายและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกันได้
การส่งต่อเข้าสู่ขั้นตอนการตรวจสอบข้ามนี้เริ่มจากวัตถุประสงค์ที่ระบุและควรสิ้นสุดด้วยผลลัพธ์ที่สามารถสนับสนุนการฝึกบนข้อมูลทั้งหมดยกเว้นหนึ่งพับ บันทึกความไม่แน่นอน, ทางเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่นำไปใช้ที่ขอบเขตนั้น ติดตามนี้เป็นที่ที่ทีมสามารถตรวจจับได้ว่าพับสุ่มทั่วไปอาจไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา, กลุ่ม, หรือเชิงพื้นที่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
2. ฝึกบนข้อมูลทั้งหมดยกเว้นหนึ่งพับ: การแทนค่า หรือการตัดสินใจในการตรวจสอบข้าม
ในขั้นตอนนี้ของการตรวจสอบข้าม ระบบต้องฝึกบนข้อมูลทั้งหมดยกเว้นหนึ่งพับ คำถามที่มีประโยชน์ไม่ได้เพียงว่าการดำเนินการนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกการดำเนินการนี้ออกจากการทดสอบหลายโมเดลบนชุดทดสอบสุดท้ายและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกันได้
การส่งต่อเข้าสู่ขั้นตอนการตรวจสอบข้ามนี้เริ่มจากการแบ่งข้อมูลเป็นพับที่เหมาะสมและควรสิ้นสุดด้วยผลลัพธ์ที่สามารถสนับสนุนการประเมินบนพับที่ถือเป็นข้อมูลทดสอบ บันทึกความไม่แน่นอน, ทางเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่นำไปใช้ที่ขอบเขตนั้น ติดตามนี้เป็นที่ที่ทีมสามารถตรวจจับได้ว่าพับสุ่มทั่วไปอาจไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา, กลุ่ม, หรือเชิงพื้นที่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
3. ประเมินบนส่วนที่ถือไว้: การแปลงที่โดดเด่นใน Cross-Validation
ในขั้นตอนนี้ของ Cross-validation ระบบต้องประเมินบนส่วนที่ถือไว้ คำถามที่สำคัญไม่ใช่แค่การดำเนินการนั้นเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้ สถานะใดที่มันเปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกแยะการดำเนินการนี้จากการทดสอบโมเดลหลาย ๆ ตัวบนชุดทดสอบสุดท้ายและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกันได้
การส่งต่อเข้าสู่ขั้นตอน Cross-validation นี้เริ่มด้วยการฝึกบนทุกส่วนยกเว้นหนึ่งส่วนและควรสิ้นสุดด้วยผลลัพธ์ที่สามารถสนับสนุนการหมุนจนทุกส่วนได้ทำหน้าที่เป็นการตรวจสอบ บันทึกความไม่แน่นอน ตัวเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่ถูกนำไปใช้ที่ขอบเขตนั้น ร่องรอยนี้คือจุดที่ทีมสามารถตรวจจับได้ว่าการแบ่งส่วนแบบสุ่มทั่วไปไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา กลุ่ม หรือเชิงพื้นที่ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
4. หมุนจนทุกส่วนทำหน้าที่เป็นการตรวจสอบ: ข้อจำกัดและขอบเขตการตรวจสอบใน Cross-Validation
ในขั้นตอนนี้ของ Cross-validation ระบบต้องหมุนจนทุกส่วนทำหน้าที่เป็นการตรวจสอบ คำถามที่สำคัญไม่ใช่แค่การดำเนินการนั้นเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้ สถานะใดที่มันเปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกแยะการดำเนินการนี้จากการทดสอบโมเดลหลาย ๆ ตัวบนชุดทดสอบสุดท้ายและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกันได้
การส่งต่อเข้าสู่ขั้นตอน Cross-validation นี้เริ่มด้วยการประเมินบนส่วนที่ถือไว้และควรสิ้นสุดด้วยผลลัพธ์ที่สามารถสนับสนุนการสรุปคะแนนรวมและความแปรปรวน บันทึกความไม่แน่นอน ตัวเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่ถูกนำไปใช้ที่ขอบเขตนั้น ร่องรอยนี้คือจุดที่ทีมสามารถตรวจจับได้ว่าการแบ่งส่วนแบบสุ่มทั่วไปไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา กลุ่ม หรือเชิงพื้นที่ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
5. รวมคะแนนและความแปรปรวน: ผลลัพธ์, ข้อเสนอแนะ, และกฎการหยุดใน Cross-Validation
ในขั้นตอนนี้ของ Cross-validation ระบบต้องสรุปคะแนนและความแปรปรวน คำถามที่สำคัญไม่ใช่แค่การดำเนินการนั้นเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้ สถานะใดที่มันเปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกแยะการดำเนินการนี้จากการทดสอบโมเดลหลาย ๆ ตัวบนชุดทดสอบสุดท้ายและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกันได้
การส่งต่อเข้าสู่ขั้นตอน Cross-validation นี้เริ่มด้วยการหมุนจนทุกส่วนทำหน้าที่เป็นการตรวจสอบและควรสิ้นสุดด้วยผลลัพธ์ที่สามารถสนับสนุนการเฝ้าติดตามหรือการตัดสินใจขั้นสุดท้าย บันทึกความไม่แน่นอน ตัวเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่ถูกนำไปใช้ที่ขอบเขตนั้น ร่องรอยนี้คือจุดที่ทีมสามารถตรวจจับได้ว่าการแบ่งส่วนแบบสุ่มทั่วไปไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา กลุ่ม หรือเชิงพื้นที่ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
อ่านแผนที่ Cross-validation ไปข้างหน้าเพื่อเข้าใจการผลิตและย้อนกลับเพื่อวินิจฉัยความล้มเหลว การวิเคราะห์แบบไปข้างถามว่าขั้นตอนหนึ่งส่งต่ออะไรให้ขั้นตอนต่อไป การวิเคราะห์แบบย้อนกลับเริ่มจากผลลัพธ์ที่ไม่ถูกต้อง ช้า มีค่าใช้จ่ายสูง หรือไม่ปลอดภัยและตามรอยว่าความเชื่อใดในขั้นตอนก่อนหน้าที่ทำให้เกิดผลนั้น เส้นทางย้อนกลับมักเป็นที่ที่ทีมค้นพบว่าข้อผิดพลาดสำคัญเกิดขึ้นก่อนที่โมเดลจะสร้างผลลัพธ์ใด ๆ
ตัวอย่างการทำ Cross-Validation
ชุดข้อมูลการแพทย์ขนาดเล็กสามารถใช้การแบ่งส่วนแบบกลุ่มเพื่อให้บันทึกของผู้ป่วยแต่ละคนอยู่ด้วยกัน
ตัวอย่างนี้ให้ข้อมูลที่เป็นประโยชน์เพราะ Cross-validation สามารถเชื่อมโยงกับอินพุตที่สังเกตได้ สถานะกลาง และผลลัพธ์ แทนที่จะประเมินผ่านการสาธิตที่ทำให้ดูดี การทดสอบที่เข้มงวดจะสร้างกรณีทั่วไป ยาก และตั้งใจทำให้เข้าใจผิดรอบสถานการณ์ รักษา baseline ที่ไม่มีเทคนิคนี้และบันทึกทั้งประสิทธิภาพเฉลี่ยและความรุนแรงของความล้มเหลวแต่ละกรณี
เปลี่ยนสมมติฐานหนึ่งในตัวอย่าง Cross-validation แล้วทำการวิเคราะห์ซ้ำ ลบอินพุตที่จำเป็น แทรกสัญญาณขัดแย้ง จำกัดการคำนวณ ปรับเปลี่ยนกลุ่มผู้ใช้ หรือบังคับให้ระบบละเลย กลไกที่สำเร็จเพียงในสาธิตที่จัดเตรียมอย่างระมัดระวังเท่านั้นไม่ได้แสดงว่ามันจะทั่วไปต่อสภาพแวดล้อมการทำงาน
Cross-Validation กับวิธีลัดที่พบบ่อยที่สุด
Cross-validation มักถูกย่อให้เป็นการทดสอบโมเดลหลาย ๆ ตัวบนชุดทดสอบสุดท้าย การย่อแบบนี้ทำให้ขอบเขตที่กำหนดแนวคิดหายไป มันอาจทำให้ผู้ซื้อเปรียบเทียบผลิตภัณฑ์ที่ไม่เหมือนกัน นักวิจัยอ้างอ้างเกินจริงในสิ่งที่การทดลองแสดง และผู้ปฏิบัติการเฝ้าติดตามสัญญาณที่ผิดหลังการเปิดใช้งาน
| เลนส์ | คำตอบเชิงปฏิบัติ |
|---|---|
| คำนิยาม | Cross-validation ทำการหมุนชุดข้อมูลที่ถือไว้เป็นการทดสอบซ้ำ ๆ เพื่อให้ทีมสามารถประเมินประสิทธิภาพและความแปรปรวนได้เมื่อการแบ่ง validation เพียงครั้งเดียวอาจไม่เสถียร |
| ความสับสน | ทดสอบโมเดลหลายตัวบนชุดทดสอบสุดท้าย |
| ความเสี่ยง | การแบ่งข้อมูลแบบสุ่มทั่วไปไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา, กลุ่ม, หรือเชิงพื้นที่ |
การเปรียบเทียบควรระบุหน่วยการวิเคราะห์ด้วย บทความเกี่ยวกับ Cross-validation อาจแยกโมเดลหรืออัลกอริทึมออกมา ในขณะที่บริการที่เปิดใช้งานจริงต้องเพิ่มการดึงข้อมูล, การกำหนดเส้นทาง, แคช, นโยบาย, การยืนยันตัวตน, ส่วนติดต่อผู้ใช้ และการเฝ้าติดตาม ผลิตภัณฑ์สองตัวอาจใช้คำหลักเดียวกันแต่ดำเนินการส่วนต่างของสแต็กนั้นต่างกัน ควรถามว่าองค์ประกอบใดทำการแปลงที่กำหนดและองค์ประกอบอื่นใดจำเป็นต่อผลลัพธ์ที่รายงาน
ทำไม Cross-Validation ถึงสำคัญในระบบ AI ปัจจุบัน
Cross-validation มีความสำคัญในขณะนี้เนื่องจากระบบ AI กำลังได้รับบริบทที่ใหญ่ขึ้น, โหมดหลายรูปแบบ, การคำนวณแบบเรียลไทม์ที่มากขึ้น, การเข้าถึงเครื่องมือที่กว้างขวางขึ้น, และการเชื่อมต่อที่ลึกซึ้งกับการตัดสินใจขององค์กร ภายใต้เงื่อนไขเหล่านี้ สิ่งที่เคยดูเหมือนเป็นรายละเอียดการวิจัยอาจกำหนดความหน่วง, ความปลอดภัย, การเข้าถึง, ต้นทุนด้านสิ่งแวดล้อม, คุณภาพของผลิตภัณฑ์, หรือความรับผิดชอบทางกฎหมาย
มาตรการที่เกี่ยวข้องไม่ได้เป็นว่าการทำ Cross-validation สามารถสร้างผลลัพธ์ที่น่าประทับใจหนึ่งครั้งหรือไม่ แต่เป็นว่ามันช่วยปรับปรุงผลลัพธ์ที่สำคัญในสภาวะที่เป็นตัวแทนและทำได้อย่างมีประสิทธิภาพกว่าฐานเส้นง่าย ๆ รายงานการกระจาย, ประเภทของความล้มเหลว, ความหน่วงส่วนท้าย, การใช้ทรัพยากร, และกลุ่มผู้ใช้ที่ได้รับผลกระทบ แทนการบีบอัดผลลัพธ์ทั้งหมดเป็นค่าเฉลี่ยเดียว
เลือกกระบวนการจากโครงสร้างของข้อมูลและต้นทุนของการตัดสินใจ รักษากลุ่มและเวลา, ประมาณความไม่แน่นอน, ตรวจสอบส่วนย่อย, ล็อกการทดสอบสุดท้าย, และตรวจสอบว่าผลประโยชน์แบบออฟไลน์ยังคงอยู่เมื่อนำไปใช้จริง การประยุกต์โดยเฉพาะกับ Cross-validation ทำให้หลักฐานสามารถพกพาได้: ทีมอื่นสามารถตัดสินใจว่าการเพิ่มประสิทธิภาพที่อ้างอิงนั้นมีโอกาสอยู่รอดในโมเดล, ภาษา, แพลตฟอร์มฮาร์ดแวร์, ชุดข้อมูล, ประชากรผู้ใช้, หรือระดับความเสี่ยงที่ต่างออกไปหรือไม่
ประโยชน์ที่ Cross-Validation สามารถมอบให้
เหตุผลที่แข็งแกร่งที่สุดในการใช้ Cross-validation คือมันสามารถแก้ไขคอขวดที่ตั้งใจไว้โดยตรง ขึ้นอยู่กับการนำไปใช้ ประโยชน์อาจปรากฏเป็นการทำให้พื้นฐานมั่นคงขึ้น, การเป็นตัวแทนที่ตรงตามความเป็นจริงมากขึ้น, การทั่วไปที่ดีขึ้น, ความหน่วงที่ต่ำลง, การเคลื่อนย้ายหน่วยความจำที่ลดลง, ความรับผิดชอบที่ชัดเจนขึ้น, หรือขอบเขตที่ปลอดภัยยิ่งขึ้นระหว่างข้อเสนอโมเดลและการกระทำจริง
ประโยชน์ควรถูกแสดงเป็นการตัดสินใจและการวัดผล “ฉลาดกว่า” ไม่ใช่มาตรฐานการยอมรับสำหรับ Cross-validation เป้าหมายที่มีประโยชน์อาจระบุอัตราความผิดพลาดในกรณียาก, การกู้คืนหลังจากข้อมูลขัดแย้ง, ต้นทุนที่เปอร์เซ็นไทล์ของปริมาณการใช้งาน, เวลาในการตรวจสอบโดยมนุษย์, การปรับเทียบ, หรือเปอร์เซ็นต์ของการกระทำที่คงอยู่ภายในขอบเขตอำนาจที่กำหนด
โหมดความล้มเหลวที่กำหนด Cross-Validation
ข้อจำกัดหลักคือการแบ่งข้อมูลแบบสุ่มทั่วไปไม่ถูกต้องเมื่อข้อมูลมีการพึ่งพาเชิงเวลา, กลุ่ม, หรือเชิงพื้นที่ ความล้มเหลวนี้ไม่ได้เป็นเรื่องที่คิดตามมาภายหลังเมื่อการพัฒนาเสร็จสิ้น แต่ควรกำหนดการเก็บรวบรวมข้อมูล, สถาปัตยกรรม, สิทธิ์การเข้าถึง, การประเมิน, ประตูการปล่อย, และการเฝ้าติดตามสำหรับ Cross-validation ตั้งแต่ต้น
การควบคุมสำหรับ Cross-validation มีประโยชน์เฉพาะเมื่อทำงานก่อนผลลัพธ์ที่มีค่าใช้จ่ายสูงหรือไม่สามารถย้อนกลับได้ ระบุสัญญาณเตือนล่วงหน้าที่สังเกตได้แรกสุดของความล้มเหลว, ตั้งค่าเกณฑ์หรือกฎ, มอบหมายเจ้าของที่รับผิดชอบ, และทดสอบการกู้คืน ขึ้นอยู่กับกรณีการใช้งาน การกู้คืนอาจหมายถึงการละเว้น, การย้อนกลับไปสู่ระบบที่ง่ายกว่า, การขอหลักฐานเพิ่มเติม, การส่งต่อให้บุคคล, การย้อนกลับโมเดล, หรือการหยุดการกระทำทั้งหมด
แผนการประเมินสำหรับ Cross-Validation
เริ่มการประเมินการทำ Cross‑validation ด้วยการเขียนข้อสรุปที่หลักฐานต้องสนับสนุน กำหนดประชากรเป้าหมาย ผลลัพธ์ที่อาจผิดพลาด ข้อมูลที่มีจริงในเวลาตัดสินใจ และทางเลือกที่เชื่อถือได้ที่ง่ายที่สุด สิ่งนี้ช่วยป้องกันไม่ให้เกณฑ์มาตรฐานกลายเป็นเป้าหมายเพียงเพราะทำได้ง่าย
ใช้ชุดทดสอบที่ยังไม่ถูกใช้สำหรับการเปรียบเทียบที่ควบคุมได้ แล้วตรวจสอบ Cross‑validation ในสภาพแวดล้อมการทำงานแบบขั้นตอน การประเมินแบบออฟไลน์ทำให้ตัวแปรต่าง ๆ สามารถเปรียบเทียบกันได้; โหมดเงา, canaries, การจำกัดอัตรา, หรือประตูอนุมัติจะเผยให้เห็นว่าการจราจรจริง, วงจรตอบกลับ, และผู้ใช้เปลี่ยนพฤติกรรมอย่างไร ขั้นตอนการเปิดใช้งานควรมีเงื่อนไขการหยุดอย่างชัดเจน แทนการสมมติว่าการปรับปรุงทุกอย่างสมควรเปิดใช้เต็มรูปแบบ
กำหนดเวอร์ชันของอินพุตที่จำเป็นต่อการทำซ้ำ Cross‑validation ได้แก่ ข้อมูลต้นทาง, การเตรียมข้อมูล, ตัวแยกโทเค็นหรือเอ็นโค้ดเดอร์, น้ำหนักโมเดล, การตั้งค่า, พรอมต์หรือโพลิซี, ดัชนีการดึงข้อมูล, ชุดประเมิน, สมมติฐานฮาร์ดแวร์, และโค้ดการให้บริการตามที่เกี่ยวข้อง หากไม่มีร่องรอยการสืบทอด ทีมงานจะไม่สามารถบอกได้ว่าผลลัพธ์ที่เปลี่ยนแปลงมาจากเทคนิค, สภาพแวดล้อม, หรือการแก้ไขใน pipeline ที่ไม่ได้สังเกต
สุดท้าย ให้ถามว่าการค้นหาอะไรจะทำให้ข้ออ้างว่า Cross‑validation ช่วยได้เป็นเท็จ หากไม่มีผลลัพธ์ใดที่สามารถย้อนกลับการตัดสินใจนำไปใช้ การประเมินก็เป็นการตลาด การกำหนดเกณฑ์การยอมรับล่วงหน้าและชุดยืนยันที่เก็บไว้ทำให้การฝึกฝนกลายเป็นหลักฐาน
คำถามที่ควรถามก่อนนำ Cross‑validation ไปใช้
- วัตถุประสงค์: ข้อจำกัดที่วัดได้ใดที่ Cross‑validation ตั้งใจจะแก้ไข?
- กลไก: ขั้นตอนใดในห้าขั้นตอนที่มีการแปลงที่โดดเด่น?
- ฐานเปรียบเทียบ: มันเปรียบเทียบอย่างไรกับการทดสอบหลายโมเดลบนชุดทดสอบสุดท้ายหรือทางเลือกที่ง่ายกว่าอื่น ๆ?
- หลักฐาน: กรณีทั่วไป, ยาก, ปรับตัวต่อการโจมตี, และกลุ่มย่อยใดบ้างที่ได้ทำการทดสอบ?
- การดำเนินงาน: ความหน่วง, หน่วยความจำ, การคำนวณ, พลังงาน, การบำรุงรักษา, และค่าใช้จ่ายในการตรวจสอบใดที่ปรากฏเมื่อขยายขนาด?
- ความเสี่ยง: ทีมจะตรวจจับได้อย่างไรเมื่อการแบ่งแบบสุ่มทั่วไปไม่ถูกต้องในกรณีที่ข้อมูลมีการพึ่งพาเชิงเวลา, กลุ่ม, หรือเชิงพื้นที่?
- การกู้คืน: ระบบสามารถละเว้น, ย้อนกลับ, ยกเลิก, หรือเพิ่มระดับก่อนเกิดอันตรายได้หรือไม่?
แหล่งข้อมูลหลักสำหรับการศึกษา Cross‑validation
จุดเริ่มต้นที่เชื่อถือได้สำหรับส่วนของสแตก AI ที่เกี่ยวกับการทำ Cross‑validation ได้แก่ คู่มือการเลือกโมเดลของ scikit-learn, กฎการเรียนรู้ของเครื่องของ Google, กรอบการจัดการ AI ของ NIST. อ่านเอกสารเหล่านี้พร้อมกับเอกสารประกอบของโมเดล, ชุดข้อมูล, ฮาร์ดแวร์, และเขตอำนาจศาลที่เกี่ยวข้อง. แหล่งข้อมูลทั่วไปสามารถกำหนดกลไกได้, แต่เพียงหลักฐานที่เฉพาะเจาะจงต่อการใช้งานจริงเท่านั้นที่สามารถยืนยันว่าการนำไปใช้เฉพาะกรณีนั้นเหมาะสม
สิ่งที่ควรจำเกี่ยวกับ Cross‑validation
Cross‑validation เป็นกลไกที่กำหนดไว้ภายในระบบสังคม‑เทคนิคที่ใหญ่ขึ้น มูลค่าของมันมาจากการปรับปรุงผลลัพธ์เฉพาะภายใต้เงื่อนไขที่ชัดเจน ไม่ได้มาจากป้ายชื่อเอง แผนที่ห้าขั้นตอนทำให้การไหลของข้อมูลเป็นที่มองเห็นได้ การเปรียบเทียบระบุสิ่งที่มันไม่ใช่ และเส้นทางการควบคุมแสดงจุดที่ผู้ปฏิบัติหน้าที่ที่รับผิดชอบสามารถแทรกแซงได้
กฎปฏิบัติสำหรับ Cross‑validation คือการกำหนดวัตถุประสงค์, เปรียบเทียบกับฐานเปรียบเทียบที่เชื่อถือได้, ทดสอบความล้มเหลวที่สำคัญที่สุด, และเก็บหลักฐานที่จำเป็นต่อการตรวจสอบการเปลี่ยนแปลง เมื่อมีส่วนเหล่านี้ครบ คอนเซ็ปต์จะกลายเป็นตัวเลือกด้านวิศวกรรมและการกำกับดูแลที่สามารถประเมินได้ หากไม่มีส่วนเหล่านี้ มันยังคงเป็นชื่อที่น่าสนใจแต่ผูกติดกับความเสี่ยงการดำเนินงานที่ไม่ทราบ


