
มุมมองของ Anderson
ลบวัตถุออกจากวิดีโอได้อย่างมีประสิทธิภาพยิ่งขึ้นด้วยการเรียนรู้ของเครื่อง

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
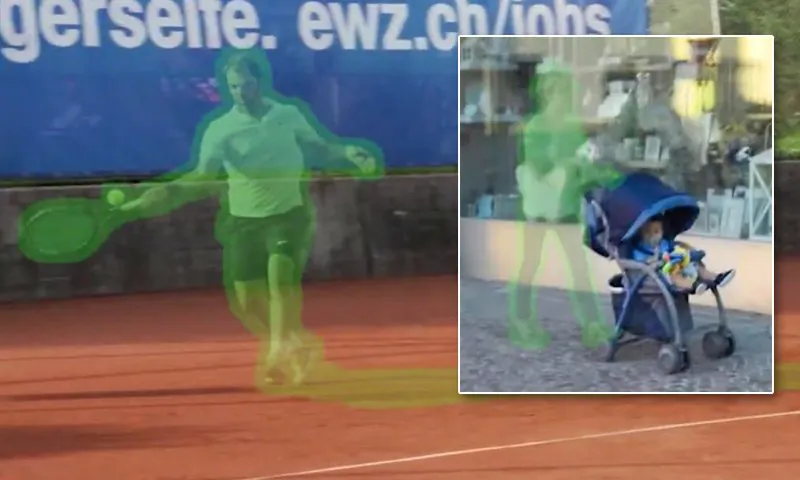
การวิจัยใหม่จากประเทศจีนรายงานผลลัพธ์ที่ดีที่สุดในระดับแนวหน้าของสาขา – เช่นเดียวกับการปรับปรุงประสิทธิภาพที่น่าประทับใจ – สำหรับระบบการเติมวิดีโอที่ใหม่ซึ่งสามารถลบวัตถุออกจากภาพได้อย่างชำนาญ
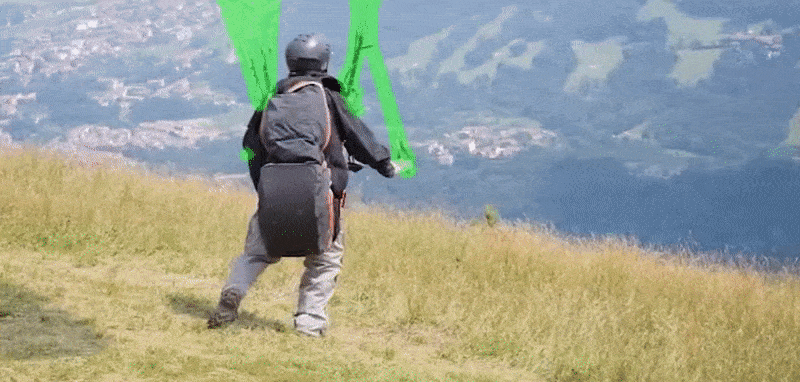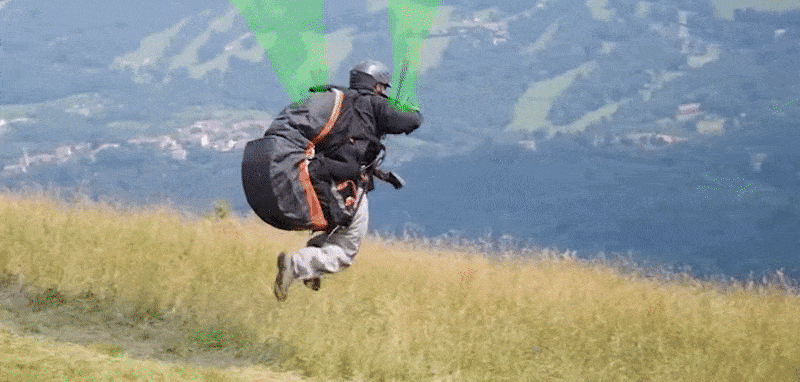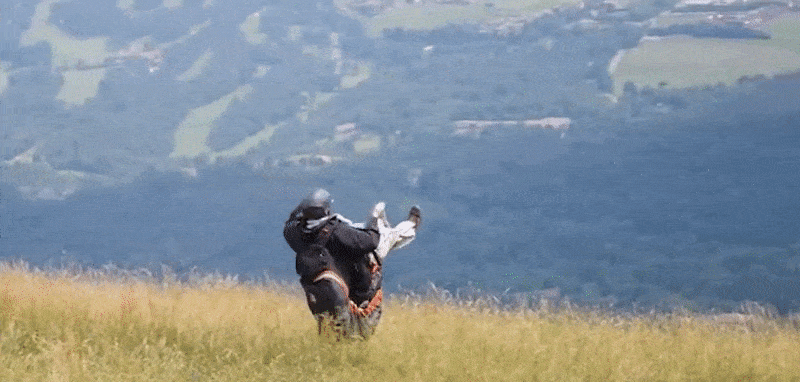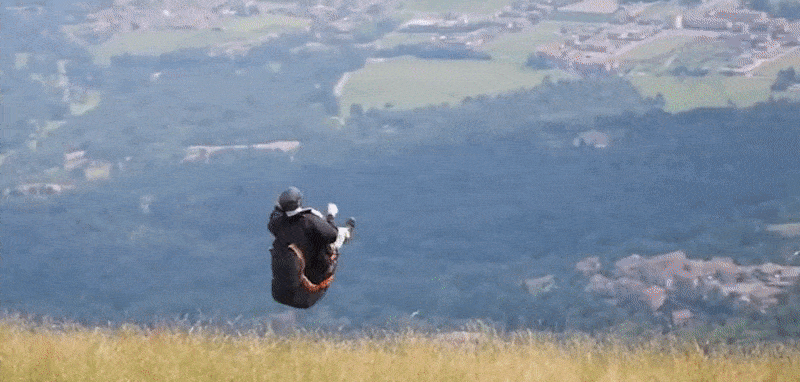
สายรัดตัวของนักร่อนเดลตาถูกลบออกจากภาพด้วยวิธีการใหม่นี้ ดูวิดีโอต้นฉบับสำหรับการแสดงผลที่ดีกว่าและตัวอย่างเพิ่มเติม Source: https://www.youtube.com/watch?v=N–qC3T2wc4
เทคนิคนี้เรียกว่า End-to-End framework for Flow-Guided video Inpainting (E2FGVI) ยังสามารถลบลายน้ำและสิ่งบดบังประเภทอื่นๆ ออกจากเนื้อหาวิดีโอได้
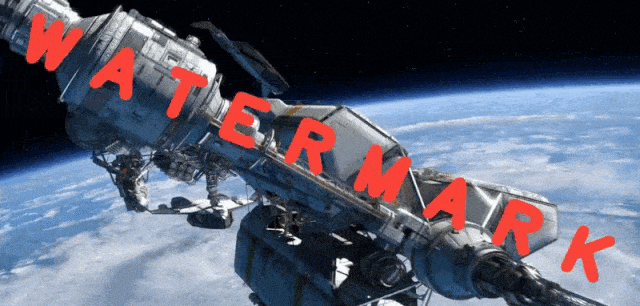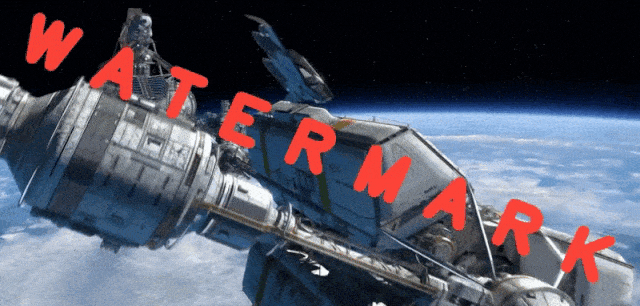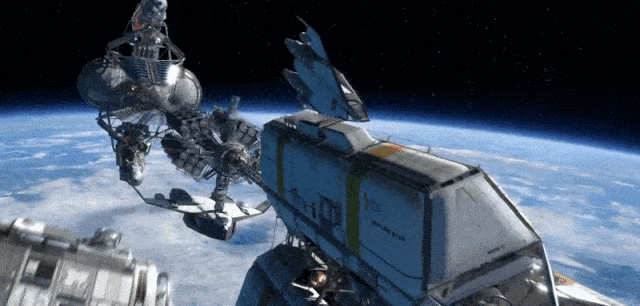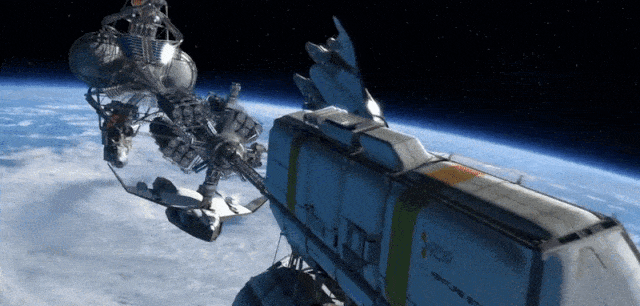
E2FGVI คำนวณการคาดการณ์สำหรับเนื้อหาที่อยู่เบื้องหลังการบดบัง ทำให้สามารถลบลายน้ำที่เห็นเด่นชัดและลบออกได้ยาก Source: https://github.com/MCG-NKU/E2FGVI
(เพื่อดูตัวอย่างที่มีการแสดงผลที่ดีกว่า ดู วิดีโอ)
แม้ว่าโมเดลที่อยู่ในเอกสารที่ตีพิมพ์จะถูกฝึกฝนในวิดีโอที่มีขนาด 432px x 240px (ขนาดการเข้าข้อมูลที่ต่ำซึ่งถูกจำกัดโดยพื้นที่ GPU ที่มีอยู่เทียบกับขนาดแบตช์ที่เหมาะสมและปัจจัยอื่นๆ) แต่นักวิจัยได้เผยแพร่ E2FGVI-HQ ซึ่งสามารถจัดการวิดีโอได้ที่ความละเอียดใดๆ ก็ตาม
โค้ดสำหรับเวอร์ชันปัจจุบันสามารถ พบได้ที่ GitHub ในขณะที่เวอร์ชัน HQ ซึ่งเผยแพร่เมื่อวันอาทิตย์ที่ผ่านมา สามารถดาวน์โหลดได้จาก Google Drive และ Baidu Disk

เด็กยังคงอยู่ในภาพ
E2FGVI สามารถประมวลผลวิดีโอขนาด 432×240 ได้ที่ 0.12 วินาทีต่อเฟรมบน Titan XP GPU (12GB VRAM) และนักวิจัยรายงานว่าระบบทำงานเร็วกว่าวิธีการระดับแนวหน้าก่อนหน้านี้ที่ใช้ การไหลของแสง ถึง 15 เท่า
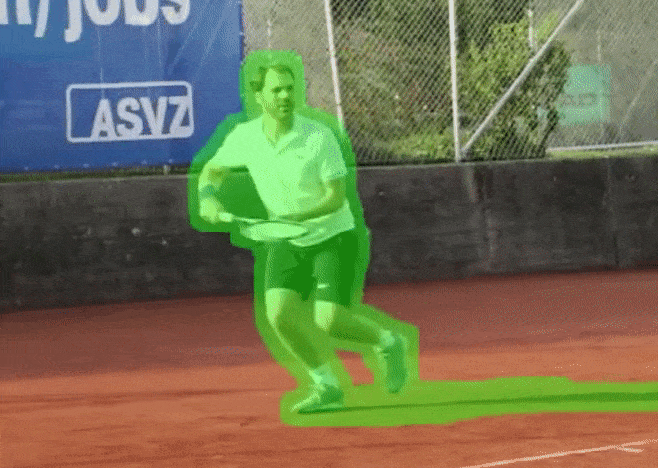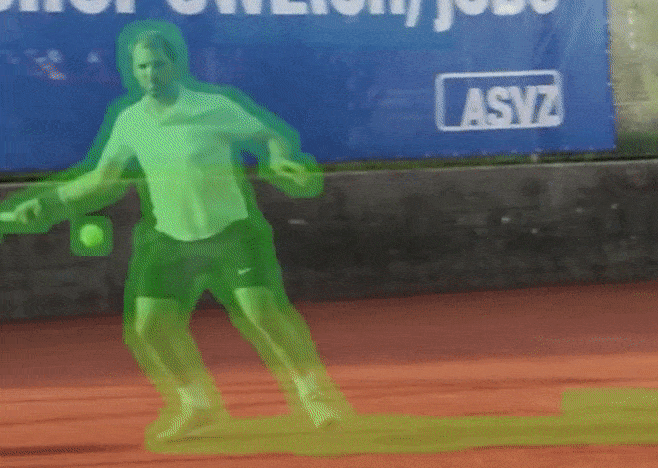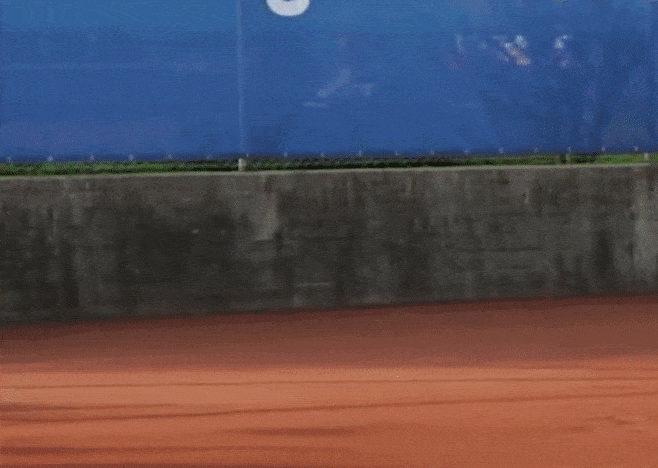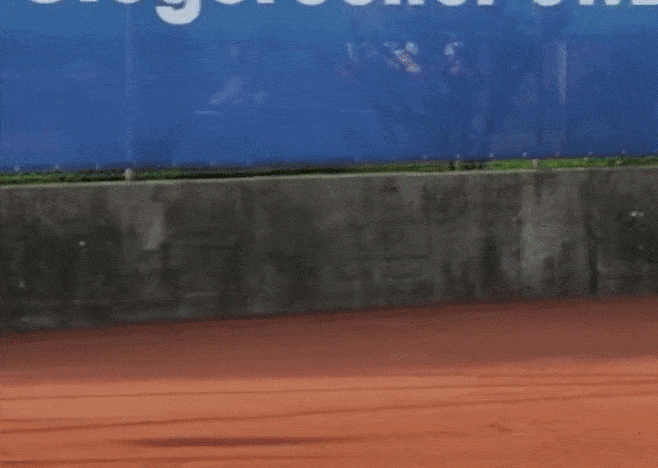
นักกีฬาเทนนิสออกจากภาพอย่างไม่คาดคิด
เมื่อทดสอบบนชุดข้อมูลมาตรฐานสำหรับการวิจัยสังเคราะห์ภาพนี้ ระบบใหม่สามารถเอาชนะคู่แข่งในรอบการประเมินเชิงคุณภาพและเชิงปริมาณ

การทดสอบกับวิธีการก่อนหน้า Source: https://arxiv.org/pdf/2204.02663.pdf
งานวิจัย มีชื่อเรื่องว่า Towards An End-to-End Framework for Flow-Guided Video Inpainting และเป็นผลงานร่วมกันระหว่างนักวิจัยสี่คนจาก Nankai University และนักวิจัยหนึ่งคนจาก Hisilicon Technologies
สิ่งที่หายไปในภาพนี้
นอกเหนือจากการประยุกต์ใช้ด้านวิชวลเอฟเฟกต์ที่เห็นได้ชัดแล้ว การเติมวิดีโอคุณภาพสูงกำลังจะกลายเป็นคุณลักษณะที่กำหนดใหม่ของเทคโนโลยีการสังเคราะห์ภาพและเปลี่ยนแปลงภาพที่ใช้ AI
สิ่งนี้เป็นกรณีโดยเฉพาะสำหรับการประยุกต์ใช้แฟชั่นที่เปลี่ยนแปลงร่างกาย และเฟรมเวิร์กอื่นๆ ที่ พยายามจะ ‘ทำให้บาง’ หรือเปลี่ยนแปลงฉากในภาพและวิดีโอ ในกรณีดังกล่าว จำเป็นต้อง ‘เติม’ พื้นหลังที่ถูกเปิดเผยโดยการสังเคราะห์

จากเอกสารล่าสุด อัลกอริทึม ‘เปลี่ยนแปลงรูปร่าง’ มีหน้าที่เติมพื้นหลังที่เพิ่งเผยออกมาเมื่อตัวบุคคลในภาพถูกปรับขนาด บริเวณที่ขาดหายนี้แสดงด้วยเส้นกรอบสีแดง ซึ่งเป็นพื้นที่ที่บุคคลรูปร่างอวบกว่าในภาพจริงเคยอยู่ (ดูภาพด้านซ้าย) Based on source material from https://arxiv.org/pdf/2203.10496.pdf
การไหลเชิงแสงที่สอดคล้องกัน
การไหลของแสง (OF) ได้กลายเป็นเทคโนโลยีหลักในการพัฒนาการลบวัตถุจากวิดีโอ เช่น แอตลาส OF ให้แผนที่ของลำดับภาพตามเวลาได้ในครั้งเดียว โดยมักใช้วัดความเร็วในงานคอมพิวเตอร์วิทัศน์ นอกจากนี้ยังช่วยให้เติมภาพได้อย่างสอดคล้องกันตามเวลา โดยพิจารณางานทั้งหมดได้ในครั้งเดียว แทนการจัดการทีละเฟรมแบบการ์ตูนดิสนีย์ ซึ่งย่อมทำให้เกิดความไม่ต่อเนื่องตามเวลา
วิธีการเติมวิดีโอที่มีอยู่จนถึงปัจจุบันเน้นไปที่กระบวนการที่มีสามขั้นตอน: การเติมการไหล โดยที่วิดีโอมีการทำแผนที่ออกเป็นหน่วยที่แยกจากกันและสามารถสำรวจได้; การแพร่กระจายพิกเซล โดยที่รูใน ‘วิดีโอที่เสียหาย’ ถูกเติมด้วยการแพร่กระจายพิกเซลไปในทิศทางทั้งสอง; และ การสร้างเนื้อหาขึ้นมาใหม่ (การ ‘คิดค้น’ พิกเซลที่คุ้นเคยจาก deepfakes และเฟรมเวิร์ก text-to-image เช่น DALL-E) โดยที่เนื้อหาที่ ‘หายไป’ ถูกคาดการณ์และแทรกเข้าไปในวิดีโอ
นวัตกรรมหลักของ E2FGVI คือการรวมขั้นตอนเหล่านี้เข้าด้วยกันเป็นระบบแบบ end-to-end ทำให้ไม่จำเป็นต้องดำเนินการด้วยมือบนเนื้อหาหรือกระบวนการ

เอกสารระบุว่าความจำเป็นในการแทรกแซงด้วยมือทำให้กระบวนการเก่าไม่สามารถใช้ GPU ได้ ทำให้ใช้เวลานาน จากเอกสาร*:
‘การนำ DFVI เป็นตัวอย่าง การเติมวิดีโอที่มีขนาด 432 × 240 จาก DAVIS ซึ่งมีประมาณ 70 เฟรม ต้องใช้เวลาประมาณ 4 นาที ซึ่งไม่เหมาะสมสำหรับการใช้งานจริงส่วนใหญ่ นอกจากนี้ นอกเหนือจากข้อเสียที่กล่าวมาข้างต้น การใช้เพียงเครือข่ายการเติมภาพที่ฝึกฝนไว้ล่วงหน้าในขั้นตอนการสร้างเนื้อหาขึ้นมาใหม่ ทำให้ละเลยความสัมพันธ์ของเนื้อหาที่อยู่ติดกันในเชิงเวลา ซึ่งนำไปสู่เนื้อหาที่ถูกสร้างขึ้นมาใหม่ไม่สอดคล้องกันในวิดีโอ’
โดยการรวมขั้นตอนสามขั้นตอนของการเติมวิดีโอ E2FGVI สามารถแทนที่ขั้นตอนที่สอง การแพร่กระจายพิกเซล ด้วยการแพร่กระจายคุณลักษณะ ในกระบวนการที่แยกจากกันของงานก่อนหน้า คุณลักษณะไม่ได้พร้อมใช้งานมากนัก เนื่องจากแต่ละขั้นตอนมีความเป็นเอกเทศและเวิร์กโฟลว์เป็นแบบกึ่งอัตโนมัติเท่านั้น
นอกจากนี้ นักวิจัยได้สร้าง โมเดลทรานส์ฟอร์เมอร์แบบโฟกัสตามเวลา สำหรับขั้นตอนการสร้างเนื้อหาขึ้นมาใหม่ ซึ่งพิจารณาไม่เพียงแต่เพื่อนบ้านโดยตรงของพิกเซลในเฟรมปัจจุบัน (เช่น สิ่งที่เกิดขึ้นในบริเวณนั้นของเฟรมในภาพก่อนหน้าหรือภาพถัดไป) แต่ยังรวมถึงเพื่อนบ้านที่อยู่ห่างออกไปหลายเฟรม ซึ่งยังส่งผลต่อความสอดคล้องโดยรวมของการดำเนินการใดๆ ที่ดำเนินการในวิดีโอทั้งหมด

สถาปัตยกรรมของ E2FGVI.
ส่วนกลางของกระบวนการที่ใช้คุณลักษณะเป็นหลักสามารถใช้กระบวนการระดับคุณลักษณะและค่าชดเชยตำแหน่งการสุ่มตัวอย่างที่เรียนรู้ได้ ในขณะที่ทรานส์ฟอร์เมอร์แบบโฟกัสตัวใหม่ของโครงการนี้ ตามที่ผู้เขียนระบุ ขยายขนาดของหน้าต่างโฟกัส ‘จาก 2D เป็น 3D’
การทดสอบและการรวบรวมข้อมูล
ในการทดสอบ E2FGVI นักวิจัยประเมินระบบกับชุดข้อมูลการแบ่งส่วนวัตถุในวิดีโอสองชุด: YouTube-VOS และ DAVIS YouTube-VOS มีคลิปวิดีโอที่ใช้ในการฝึกฝน 3741 คลิป คลิปที่ใช้ในการตรวจสอบ 474 คลิป และคลิปที่ใช้ในการทดสอบ 508 คลิป ในขณะที่ DAVIS มีคลิปวิดีโอที่ใช้ในการฝึกฝน 60 คลิป และคลิปที่ใช้ในการทดสอบ 90 คลิป
E2FGVI ถูกฝึกฝนบน YouTube-VOS และประเมินบนชุดข้อมูลทั้งสอง ในระหว่างการฝึกฝน มาสก์วัตถุ (พื้นที่สีเขียวในภาพด้านบนและ วิดีโอ YouTube ประกอบ) ถูกสร้างขึ้นเพื่อจำลองการเติมวิดีโอ
สำหรับเมตริก นักวิจัยใช้ Peak signal-to-noise ratio (PSNR), Structural similarity (SSIM), Video-based Fréchet Inception Distance (VFID) และ Flow Warping Error – ซึ่งใช้เพื่อวัดความเสถียรเชิงเวลาในวิดีโอที่ได้รับผลกระทบ
สถาปัตยกรรมก่อนหน้าที่ระบบถูกทดสอบกับ ได้แก่ VINet, DFVI, LGTSM, CAP, FGVC, STTN และ FuseFormer

จากส่วนผลลัพธ์เชิงปริมาณของเอกสาร สัญลักษณ์ ^ และ v หมายความว่าค่ามากกว่าหรือน้อยกว่าคือดีกว่า E2FGVI ได้รับคะแนนสูงสุดในทุกด้าน วิธีการต่างๆ ประเมินตามแนวทางของ FuseFormer แต่ DFVI, VINet และ FGVC ไม่ใช่ระบบแบบ end-to-end จึงไม่สามารถประมาณค่า FLOPs ของระบบเหล่านั้นได้
นอกเหนือจากการได้รับคะแนนสูงสุดเหนือระบบที่แข่งขันกันทั้งหมด นักวิจัยยังได้ทำการศึกษาผู้ใช้เชิงคุณภาพ โดยที่วิดีโอที่ถูกแปลงด้วยวิธีการตัวแทนห้าวิธีถูกนำเสนอทีละรายการแก่ผู้เข้าร่วมทดสอบ 20 คน ซึ่งถูกขอให้ให้คะแนนตามคุณภาพการแสดงผล

แกนแนวตั้งแสดงถึงเปอร์เซ็นต์ของผู้เข้าร่วมที่ชอบผลลัพธ์ของ E2FGVI ในด้านคุณภาพการแสดงผล
นักวิจัยสังเกตว่าแม้ว่าจะมีการชอบ E2FGVI อย่างเป็นเอกฉันท์ แต่หนึ่งในผลลัพธ์ FGVC ไม่สะท้อนผลลัพธ์เชิงปริมาณ และพวกเขาสันนิษฐานว่านี่อาจบ่งบอกได้ว่า E2FGVI อาจสร้าง ‘ผลลัพธ์ที่ดูน่าพอใจกว่า’ โดยอาจเป็นภาพที่ชวนให้เข้าใจผิด
ในด้านประสิทธิภาพ นักวิจัยสังเกตว่าระบบของพวกเขาลดจำนวนการคำนวณเลขทศนิยมแบบจุดลอยตัวต่อวินาที (FLOPs) อย่างมาก และเวลาการอนุมานบน GPU Titan ตัวเดียวบนชุดข้อมูล DAVIS และสังเกตว่าผลลัพธ์แสดงให้เห็นว่า E2FGVI ทำงานเร็วกว่าวิธีการที่ใช้การไหลของแสงถึง 15 เท่า
พวกเขากล่าวว่า:
‘[E2FGVI] มีค่า FLOPs ต่ำที่สุดเมื่อเทียบกับวิธีการอื่นๆ ซึ่งบ่งชี้ว่าวิธีการที่เสนอเป็นไปได้อย่างมีประสิทธิภาพสำหรับการเติมวิดีโอ’
*การแปลงอ้างอิงแบบแทรกของฉันให้เป็นลิงก์
ตีพิมพ์ครั้งแรกเมื่อวันที่ 19 พฤษภาคม 2022
แก้ไขเมื่อวันอังคารที่ 28 ตุลาคม 2025 เพื่อลบการฝังวิดีโอที่มีข้อบกพร่องและแก้ไขอ้างอิงถึงวิดีโอที่ฝังไว้ในเนื้อหาของบทความ


