
มุมมองของ Anderson
โมเดลการกระจาย eDiffi ของ NVIDIA ช่วยให้ ‘วาดภาพด้วยคำพูด’ และอื่นๆ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
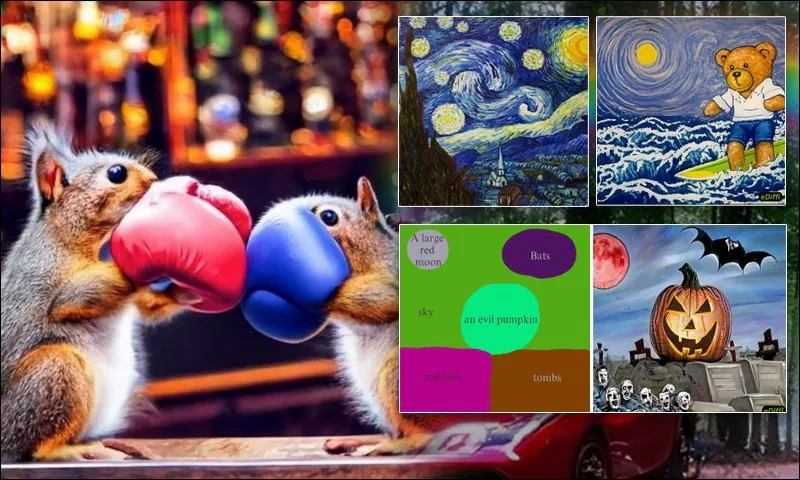
ประเด็นสำคัญNVIDIA eDiffi…
ดูเพิ่มเติม
- NVIDIA eDiffi ใช้กลุ่มผู้เชี่ยวชาญด้านการลดสัญญาณรบกวนเพื่อควบคุมการสร้างภาพจากข้อความที่เหนือกว่า
- โมเดลนี้รวมตัวเข้ารหัส T5 และ CLIP เพื่อปรับปรุงรายละเอียดปลีกย่อยและองค์ประกอบโดยรวม
- eDiffi ช่วยให้วาดภาพด้วยคำศัพท์โดยการจับคู่สีกับองค์ประกอบในคำสั่งเพื่อการจัดวางที่แม่นยำ
การพยายามสร้างองค์ประกอบที่แม่นยำด้วยโมเดลการสร้างภาพแบบการกระจายแบบแฝง เช่น Stable Diffusion อาจเหมือนกับการดูแลแมว เพราะอำนาจที่จินตนาการและตีความที่ทำให้ระบบสามารถสร้างรายละเอียดพิเศษและสร้างภาพพิเศษจากคำสั่งพื้นฐานได้ ยังเป็นสิ่งที่ยากที่จะปิดเมื่อคุณกำลังมองหาการควบคุมระดับ Photoshop เหนือการสร้างภาพ
ตอนนี้ วิธีการใหม่จาก NVIDIA (NVDA ) research ที่เรียกว่า ensemble diffusion for images (eDiffi) ใช้การผสมผสานวิธีการฝังและตีความหลายวิธี (แทนที่จะใช้วิธีเดียวกันทั้งหมดผ่านกระบวนการ) เพื่อให้สามารถควบคุมเนื้อหาที่สร้างได้มากขึ้น ในตัวอย่างด้านล่าง เราจะเห็นผู้ใช้วาดองค์ประกอบที่แต่ละสีแทนคำเดียวจากคำสั่งพื้นฐาน:
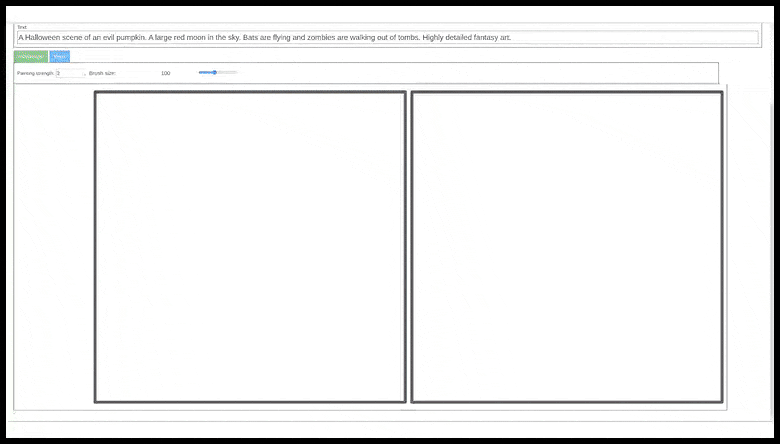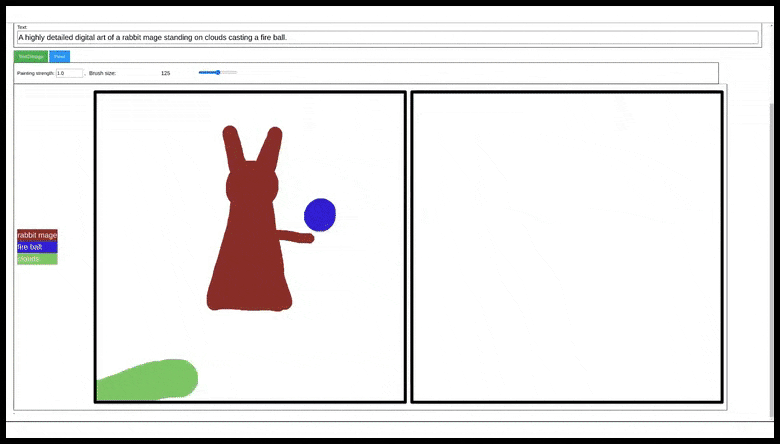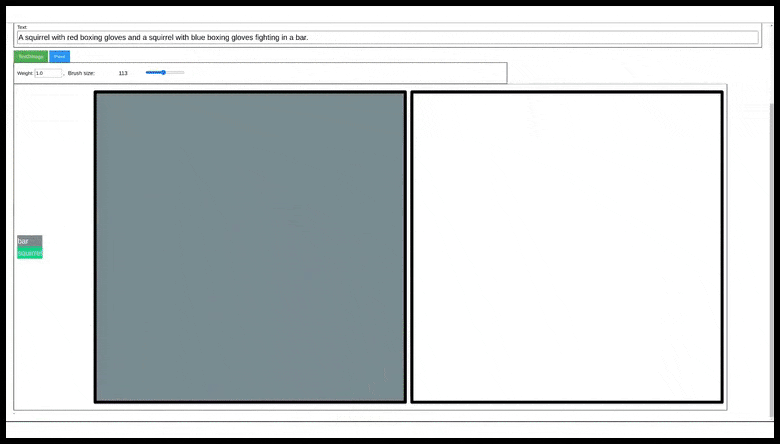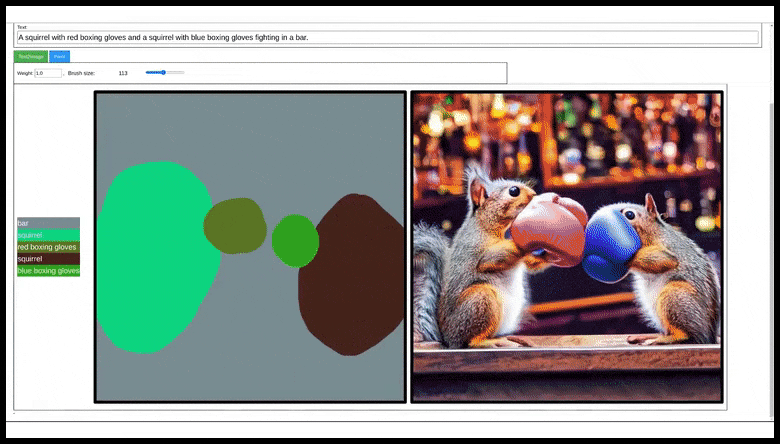
‘วาดภาพด้วยคำพูด’ เป็นหนึ่งในความสามารถใหม่สองอย่างในโมเดลการกระจาย eDiffi ของ NVIDIA แต่ละสีที่วาดแทนคำจากคำสั่งพื้นฐาน (ดูสิ่งเหล่านี้ปรากฏทางด้านซ้ายระหว่างการสร้าง) และพื้นที่สีที่ใช้จะประกอบด้วยองค์ประกอบนั้นเท่านั้น ดูวิดีโออย่างเป็นทางการสำหรับตัวอย่างเพิ่มเติมและความละเอียดที่ดีกว่าได้ที่ https://www.youtube.com/watch?v=k6cOx9YjHJc
โดยพื้นฐานแล้ว นี่คือ ‘วาดภาพด้วยมาสก์’ และกลับกับ กระบวนทัศน์ inpainting ใน Stable Diffusion ซึ่งอาศัยการแก้ไขภาพที่เสียหายหรือไม่สมบูรณ์ หรือการขยายภาพที่อาจเป็นขนาดที่ต้องการตั้งแต่แรก
ในทางกลับกัน ขอบของป้ายสีแต่ละส่วนจะกำหนดขอบเขตโดยประมาณที่อนุญาตสำหรับองค์ประกอบหนึ่งจากแนวคิดหนึ่ง ผู้ใช้จึงกำหนดขนาดผืนภาพสุดท้ายได้ตั้งแต่ต้น แล้วเพิ่มองค์ประกอบแต่ละส่วนแยกกัน

ตัวอย่างจากเอกสารใหม่ Source: https://arxiv.org/pdf/2211.01324.pdf
วิธีการหลากหลายที่ใช้ใน eDiffi ยังหมายความว่าระบบสามารถรวมองค์ประกอบทุกอย่างในคำสั่งพื้นฐานที่ยาวและละเอียดได้ดีกว่า ในขณะที่ Stable Diffusion และ OpenAI’s DALL-E 2 มักจะจัดลำดับความสำคัญของบางส่วนของคำสั่งพื้นฐานขึ้นอยู่กับว่าคำเป้าหมายปรากฏเร็วเพียงใดในคำสั่ง หรือปัจจัยอื่นๆ เช่น ความยากในการแยกองค์ประกอบที่จำเป็นสำหรับการสร้างภาพที่สมบูรณ์:

จากเอกสาร: eDiffi สามารถวนซ้ำคำสั่งพื้นฐานได้จนกว่าจะได้จำนวนองค์ประกอบสูงสุดที่เป็นไปได้ แม้ว่าผลลัพธ์ที่ดีขึ้นของ eDiffi (คอลัมน์ขวาสุด) จะถูกเลือกอย่างดี แต่ภาพที่เปรียบเทียบจาก Stable Diffusion และ DALL-E 2 ก็ถูกเลือกอย่างดีเช่นกัน
นอกจากนี้ การใช้ T5 text-to-text encoder ที่อุทิศให้กับการประมวลผลข้อความ ทำให้ eDiffi สามารถสร้างข้อความภาษาอังกฤษที่เข้าใจได้ ไม่ว่าจะเป็นคำสั่งพื้นฐานที่ขอโดยไม่ชัดเจน (เช่น ภาพประกอบข้อความ [x]) หรือคำสั่งพื้นฐานที่ขอโดยชัดเจน (เช่น เสื้อเชิ้ตมีข้อความ ‘Nvidia Rocks’):

การประมวลผลข้อความสู่ข้อความโดยเฉพาะใน eDiffi ทำให้แสดงข้อความในภาพได้ตรงตามต้นฉบับ แทนการส่งผ่านเฉพาะชั้นตีความข้อความสู่ภาพซึ่งทำให้ผลลัพธ์ผิดเพี้ยน
การเพิ่มเติมอีกอย่างหนึ่งสำหรับเฟรมเวิร์กใหม่นี้คือสามารถใช้ภาพเดียวเป็นคำสั่งอ้างอิงสไตล์ได้ แทนที่จะต้องฝึกโมเดล DreamBooth หรือการฝังข้อความหลายตัวอย่างในแนวหรือ รูปแบบ

การถ่ายโอนรูปแบบสามารถใช้จากภาพอ้างอิงไปยังคำสั่งพื้นฐาน-ภาพ หรือแม้กระทั่งภาพ-ภาพ
เอกสารใหม่ ใหม่ มีชื่อเรื่อง eDiffi: Text-to-Image Diffusion Models with an Ensemble of Expert Denoisers และ
เครื่องมือ T5 Text Encoder
การใช้ Google’s Text-to-Text Transfer Transformer (T5) เป็นองค์ประกอบสำคัญในการปรับปรุงผลลัพธ์ที่แสดงใน eDiffi กระบวนการดิฟฟิวชันในปริภูมิแฝงโดยทั่วไปมุ่งเน้นไปที่ความสัมพันธ์ระหว่างภาพที่ฝึกและคำบรรยายที่มาพร้อมกับภาพเมื่อถูกเก็บจากอินเทอร์เน็ต (หรือปรับเปลี่ยนด้วยตนเองในภายหลัง ซึ่งเป็นการแทรกแซงที่มีค่าใช้จ่ายสูงและหายาก)

จากเอกสาร กรกฎาคม 2020 สำหรับ T5 – การแปลงข้อความซึ่งสามารถช่วยกระบวนการสร้างภาพใน eDiffi (และอาจเป็นโมเดลการกระจายแบบแฝงอื่นๆ) Source: https://arxiv.org/pdf/1910.10683.pdf
โดยการเขียนคำสั่งพื้นฐานใหม่และรันโมดูล T5 สามารถได้ความสัมพันธ์และการแสดงผลที่แม่นยำกว่าที่ฝึกไว้ในโมเดลเดิม โดยคล้ายกับการระบุฉลากด้วยตนเองแบบ post facto หรือภายหลัง โดยมีความเฉพาะเจาะจงและความสามารถในการตอบสนองคำสั่งพื้นฐานได้ดีขึ้น
ผู้เขียนอธิบายว่า:
‘ในงานที่มีอยู่ส่วนใหญ่เกี่ยวกับโมเดลการกระจาย โมเดลขจัดสัญญาณรบกวนเดียวกันจะถูกใช้ร่วมกันทุกระดับสัญญาณรบกวน และการเปลี่ยนแปลงเชิงเวลาแสดงโดยการฝังเวลาแบบง่ายที่ถูกส่งไปยังโมเดลขจัดสัญญาณรบกวนผ่านเครือข่าย MLP เราแย้งว่าการเปลี่ยนแปลงเชิงเวลาที่ซับซ้อนของการกระจายลดเสียงอาจไม่ได้รับการเรียนรู้จากข้อมูลอย่างมีประสิทธิภาพโดยใช้โมเดลที่มีความสามารถจำกัด
‘แทนที่นั้น เราเสนอให้เพิ่มความสามารถของโมเดลขจัดสัญญาณรบกวนโดยการแนะนำโมเดลขจัดสัญญาณรบกวนผู้เชี่ยวชาญหลายตัว ตัวขจัดสัญญาณรบกวนผู้เชี่ยวชาญแต่ละตัวเป็นตัวขจัดสัญญาณรบกวนที่เชี่ยวชาญสำหรับช่วงระดับสัญญาณรบกวนเฉพาะ ด้วยวิธีนี้ เราเพิ่มความจุของโมเดลได้โดยไม่ทำให้การสุ่มตัวอย่างช้าลง เพราะความซับซ้อนในการคำนวณเพื่อประเมินองค์ประกอบที่ประมวลผลในแต่ละระดับสัญญาณรบกวนยังคงเท่าเดิม ‘

สถาปัตยกรรมแนวคิดสำหรับ eDiffi
โมดูลการเข้ารหัส CLIP ที่มีอยู่ใน DALL-E 2 และ Stable Diffusion ก็มีความสามารถในการค้นหาการตีความภาพอื่นๆ สำหรับข้อความที่เกี่ยวข้องกับคำสั่งพื้นฐานของผู้ใช้ แต่พวกมันถูกฝึกด้วยข้อมูลที่คล้ายกับโมเดลเดิม และไม่ได้ถูกใช้เป็นชั้นการแปลที่แยกออกมาในลักษณะเดียวกับ T5 ใน eDiffi
ผู้เขียนระบุว่า eDiffi เป็นครั้งแรกที่ทั้ง T5 และ CLIP encoder ถูกนำมาใช้ในกระบวนการเดียวกัน:
’เนื่องจากตัวเข้ารหัสทั้งสองนี้ถูกฝึกด้วยวัตถุประสงค์ที่แตกต่างกัน การฝังของพวกมันจึงช่วยให้เกิดรูปแบบภาพที่แตกต่างกันสำหรับข้อความพื้นฐานเดียวกัน แม้การฝังข้อความ CLIP จะช่วยกำหนดภาพรวมของภาพที่สร้าง แต่ผลลัพธ์มักตกหล่นรายละเอียดปลีกย่อยในข้อความ
ในทางกลับกัน ภาพที่สร้างจากการฝังข้อความ T5 เพียงอย่างเดียวสะท้อนวัตถุแต่ละชิ้นตามข้อความได้ดีกว่า แต่ภาพรวมมีความแม่นยำน้อยกว่า การใช้ทั้งสองร่วมกันให้ผลการสร้างภาพดีที่สุดในโมเดลของเรา
การหยุดชะงักและการเพิ่มกระบวนการการกระจาย
เอกสารระบุว่าโมเดลการกระจายแบบแฝงโดยทั่วไปจะเริ่มต้นการเดินทางจากสัญญาณรบกวนล้วนไปสู่ภาพโดยอาศัยข้อความในขั้นตอนแรกของการสร้าง
เมื่อสัญญาณรบกวนเริ่มเป็นโครงร่างหยาบที่สะท้อนข้อความสั่ง ส่วนที่อาศัยข้อความนำทางจะค่อยๆ ลดบทบาท และกระบวนการที่เหลือจะมุ่งเสริมรายละเอียดภาพ
สิ่งนี้หมายความว่าองค์ประกอบใดๆ ที่ไม่ได้รับการแก้ไขในขั้นตอนแรกของการสร้างจะยากที่จะใส่เข้าไปในภาพในภายหลัง เนื่องจากกระบวนการทั้งสอง (ข้อความสู่โครงร่าง และโครงร่างสู่ภาพ) มีการทับซ้อนกันไม่มาก และรูปร่างภาพที่สร้างขึ้นจะถูกผูกไว้กับกระบวนการสร้างภาพ

จากเอกสาร: แผนที่ความสนใจของส่วนต่างๆ ในกระบวนการการกระจายแบบแฝงเมื่อกระบวนการสร้างภาพดำเนินไป เราสามารถเห็นการลดลงของอิทธิพล CLIP ต่อภาพในแถวล่าง ในขณะที่ T5 ยังคงมีอิทธิพลต่อภาพลึกเข้าไปในกระบวนการสร้างภาพมากกว่า
ศักยภาพทางอาชีพ
ตัวอย่างบนหน้าโครงการและวิดีโอ YouTube เน้นภาพน่ารักแบบมีมที่เหมาะแก่การประชาสัมพันธ์ เช่นเคย งานวิจัยของ NVIDIA ลดการกล่าวถึงศักยภาพในการปรับปรุงเวิร์กโฟลว์ภาพสมจริงและ VFX รวมถึงภาพและวิดีโอ deepfake
ในตัวอย่าง ผู้ใช้ใหม่หรือผู้ใช้ที่ไม่มีประสบการณ์จะวาดเส้นรอบรูปขององค์ประกอบที่จะวางไว้ ในขณะที่ในกระบวนการสร้างภาพที่มีระบบมากกว่า อาจเป็นไปได้ที่จะใช้ eDiffi เพื่อตีความหลายเฟรมของวิดีโอโดยใช้ข้อความ-ภาพ โดยที่เส้นรอบรูปขององค์ประกอบจะถูกกำหนดไว้อย่างชัดเจนและอาศัยตัวแบบที่มีพื้นหลังที่ถูกตัดออกโดยใช้เทคนิคกรีนสกรีนหรือการประมวลผลอัลกอริทึม

Runway ML มีระบบโรโตสโคปด้วย AI แล้ว ในตัวอย่างนี้ กรีนสกรีนรอบตัวแบบแทนชั้นอัลฟา และการแยกตัวแบบทำด้วยการเรียนรู้ของเครื่อง ไม่ใช่การลบพื้นหลังสีเขียวจริงด้วยอัลกอริทึม แหล่งที่มา: https://twitter.com/runwayml/status/1330978385028374529
การใช้โมเดล DreamBooth ที่ฝึกไว้และกระบวนการภาพ-ภาพโดยใช้ eDiffi อาจเป็นไปได้ที่จะแก้ไขปัญหาหนึ่งของโมเดลดิฟฟิวชันในปริภูมิแฝงทุกแบบ: ความเสถียรของเวลา ในกรณีนี้ ทั้งพื้นที่และเนื้อหาของภาพจะถูก ‘ล็อค’ ไว้กับพื้นผิวของผู้ใช้ โดยมีการรักษาความต่อเนื่องของเนื้อหาที่สร้างขึ้น (เช่น การเปลี่ยนผู้ฝึกไทเก็กในโลกจริงเป็นหุ่นยนต์) โดยใช้โมเดล DreamBooth ที่มีการฝึกอบรมและ ‘จดจำ’ ข้อมูลการฝึกอบรม – ซึ่งไม่ดีสำหรับการตีความ แต่ดีต่อความสามารถในการทำซ้ำ ความเที่ยงตรง และความต่อเนื่อง
วิธีการ ข้อมูล และการทดสอบ
เอกสารระบุว่าโมเดล eDiffi ถูกฝึกด้วย ‘ชุดข้อมูลสาธารณะและเอกชน’ ที่ถูกกรองโดยโมเดล CLIP ที่ฝึกไว้ล่วงหน้า เพื่อลบภาพที่อาจทำให้คะแนนภาพโดยรวมลดลง ชุดข้อมูลสุดท้ายประกอบด้วย ‘ประมาณหนึ่งพันล้าน’ คู่ข้อความ-ภาพ ขนาดของภาพที่ฝึกมีด้านที่สั้นที่สุดมากกว่า 64 พิกเซล
หลายโมเดลถูกฝึกสำหรับกระบวนการนี้ โดยทั้งโมเดลฐานและโมเดลความละเอียดสูงถูกฝึกด้วยตัวปรับเหมาะ AdamW ที่อัตราการเรียนรู้ 0.0001 โดยมีการลดความสำคัญของน้ำหนัก 0.01 และขนาดแบตช์ 2048
โมเดลฐานถูกฝึกด้วย 256 GPU A100 ของ NVIDIA และโมเดลความละเอียดสูงสองตัวถูกฝึกด้วย 128 GPU A100 ของ NVIDIA สำหรับแต่ละโมเดล
ระบบนี้ใช้ไลบรารี PyTorch ของ NVIDIA ที่เรียกว่า Imaginaire ชุดข้อมูล COCO และ Visual Genome ถูกใช้ในการประเมิน แต่ไม่ได้ถูกรวมเข้ากับโมเดลสุดท้าย โดยใช้ชุดข้อมูล MS-COCO สำหรับการทดสอบ ระบบที่เป็นคู่แข่งที่ถูกทดสอบ ได้แก่ GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion และสองระบบของ Google คือ Imagen กับ Parti
ตามงานก่อนหน้า ก่อนหน้า นี้ ใช้ zero-shot FID-30K เป็นตัวชี้วัดการประเมิน ในการประเมินนี้ 30,000 คำบรรยายถูกสุ่มจากชุดข้อมูลการตรวจสอบ COCO (ไม่ใช่ภาพหรือข้อความที่ใช้ในการฝึก) และใช้เป็นคำสั่งพื้นฐานสำหรับการสังเคราะห์ภาพ
ระยะทาง Fréchet Inception (FID) ระหว่างภาพที่สร้างและภาพที่แท้จริงถูกคำนวณ นอกเหนือจากการบันทึกคะแนน CLIP สำหรับภาพที่สร้างขึ้น

ผลการทดสอบ zero-shot FID เทียบกับแนวทางชั้นนำบนชุดตรวจสอบ COCO 2014 โดยค่าต่ำกว่าหมายถึงดีกว่า
ในผลลัพธ์ eDiffi สามารถได้คะแนน FID ที่ต่ำที่สุด (ดีที่สุด) แม้จะเทียบกับระบบที่มีพารามิเตอร์มากกว่า เช่น Parti ที่มี 20 พันล้านพารามิเตอร์ เมื่อเทียบกับ 9.1 พันล้านพารามิเตอร์ในโมเดล eDiffi รุ่นที่มีสเปกสูงสุดซึ่งฝึกสำหรับการทดสอบ
สรุป
eDiffi ของ NVIDIA เป็นทางเลือกที่น่ายินดีแทนการเพิ่มข้อมูลและความซับซ้อนให้ระบบเดิมอย่างต่อเนื่อง โดยใช้แนวทางที่ชาญฉลาดและแบ่งเป็นชั้นเพื่อแก้ปัญหาที่ยุ่งยากเรื่ององค์ประกอบที่พัวพันกันและข้อจำกัดในการแก้ไขภาพของระบบสร้างภาพด้วยดิฟฟิวชันในปริภูมิแฝง
มีการอภิปรายแล้วใน subreddit และ Discord ของ Stable Diffusion เกี่ยวกับการนำโค้ด eDiffi ที่อาจจะเผยแพร่มาใช้หรือการนำหลักการของ eDiffi มาใช้ในการนำไปใช้ใหม่ กระบวนการใหม่นี้แตกต่างมาก จนกระทั่งถ้าจะนำไปใช้กับ Stable Diffusion จะต้องมีการเปลี่ยนแปลงครั้งใหญ่ โดยที่อาจต้องสละความเข้ากันได้แบบย้อนหลัง แต่จะให้การควบคุมที่ดีขึ้นมากในการสร้างภาพสุดท้าย โดยไม่ต้องสละอำนาจจินตนาการของการกระจายแบบแฝง
เผยแพร่ครั้งแรกเมื่อวันที่ 3 พฤศจิกายน 2022


