
สัมภาษณ์
นอรา เปโตรวา วิศวกรแมชชีนเลิร์นนิงและที่ปรึกษาปัญญาประดิษฐ์ที่ Prolific — ซีรีส์สัมภาษณ์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
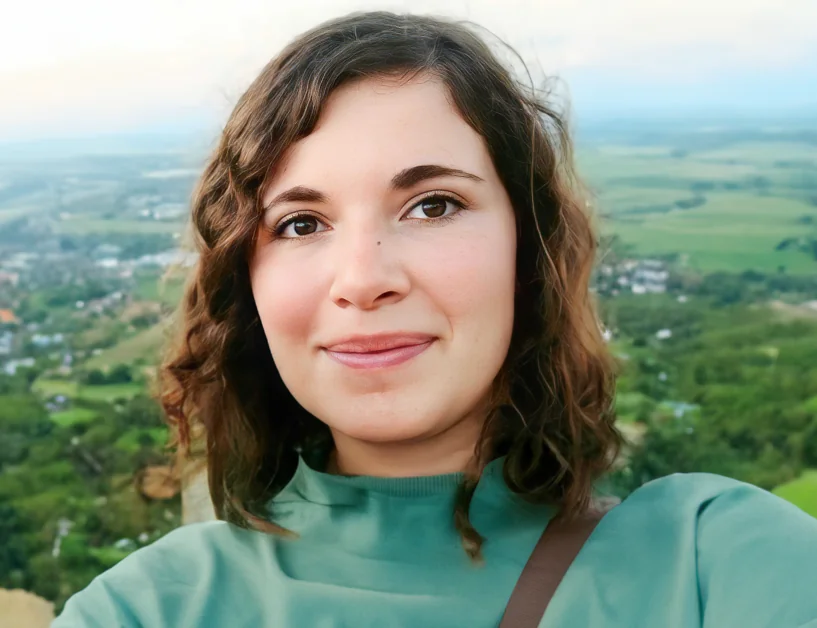
นอรา เปโตรวา เป็นวิศวกรแมชชีนเลิร์นนิงและที่ปรึกษาปัญญาประดิษฐ์ ที่ Prolific Prolific ก่อตั้งขึ้นในปี 2014 และมีลูกค้าแล้วหลายองค์กร เช่น Google (GOOGL ), Stanford University, University of Oxford, King’s College London และ European Commission โดยใช้เครือข่ายผู้เข้าร่วมทดสอบผลิตภัณฑ์ใหม่, ฝึกอบรมระบบปัญญาประดิษฐ์ในด้านต่างๆ เช่น การติดตามการเคลื่อนไหวของดวงตา และตรวจสอบว่าแอปพลิเคชันที่เผชิญหน้ากับมนุษย์ทำงานตามที่ผู้สร้างตั้งใจหรือไม่
คุณสามารถแบ่งปันข้อมูลเกี่ยวกับพื้นหลังของคุณที่ Prolific และอาชีพจนถึงปัจจุบัน ได้หรือไม่? สิ่งใดทำให้คุณสนใจใน AI?
บทบาทของฉันที่ Prolific แบ่งออกเป็นสองส่วน คือ การให้คำปรึกษาด้านการใช้งาน AI และโอกาส และการเป็นวิศวกร ML ที่ลงมือพัฒนาระบบจริง ฉันเริ่มอาชีพในด้านวิศวกรรมซอฟต์แวร์และค่อยๆ เปลี่ยนมาเป็น Machine Learning ฉันใช้เวลาเกือบ 5 ปีที่ผ่านมาในการมุ่งเน้นไปที่กรณีการใช้งานและปัญหาของ NLP
สิ่งที่ทำให้ฉันสนใจใน AI ในตอนแรกคือความสามารถในการเรียนรู้จากข้อมูลและความเชื่อมโยงกับวิธีที่มนุษย์เรียนรู้และโครงสร้างของสมอง ฉันคิดว่า ML และ Neuroscience สามารถเสริมซึ่งกันและกันและช่วยให้เราเข้าใจวิธีการสร้างระบบ AI ที่สามารถนำทางโลกได้ โดยแสดงให้เห็นถึงความสร้างสรรค์และมีคุณค่าต่อสังคม
ปัญหาการเอนเอียงของ AI ที่คุณรู้สึกว่ามีขนาดใหญ่ที่สุดคืออะไร?
การเอนเอียงเป็นสิ่งที่ฝังอยู่ในข้อมูลที่เราให้กับโมเดล AI และการเอาออกไปทั้งหมดเป็นสิ่งที่ยากมาก อย่างไรก็ตาม สิ่งสำคัญคือต้องตระหนักถึงการเอนเอียงที่มีอยู่ในข้อมูลและหาวิธีลดการเอนเอียงที่เป็นอันตรายก่อนที่จะให้โมเดลทำหน้าที่สำคัญในสังคม ปัญหาที่ใหญ่ที่สุดที่เรากำลังเผชิญคือโมเดลที่ส่งเสริมการเหมารวมที่เป็นอันตราย การเลือกปฏิบัติและความไม่ยุติธรรมในสังคม เราต้องคำนึงว่าโมเดลเหล่านี้จะถูกใช้อย่างไรและส่งผลต่อผู้ใช้อย่างไร รวมทั้งต้องตรวจสอบให้แน่ใจว่าปลอดภัยก่อนอนุมัติให้ใช้ในงานที่ละเอียดอ่อน
พื้นที่ที่มีการแสดงให้เห็นถึงการเอนเอียงของ AI ได้แก่ การเลือกปฏิบัติต่อกลุ่มที่มีตัวแทนไม่เพียงพอในการรับเข้าเรียนในโรงเรียนและมหาวิทยาลัย และการเหมารวมทางเพศที่ส่งผลเสียต่อการสรรหาพนักงานหญิง นอกจากนี้ยังมีแอลกอริธึมกระบวนการยุติธรรมที่พบว่าติดป้ายจำเลยชาวแอฟริกัน-อเมริกันผิดว่าเป็น “ความเสี่ยงสูง” ในอัตราเกือบสองเท่าของอัตราที่ติดป้ายจำเลยผิวขาวผิดในสหรัฐอเมริกา ในขณะที่เทคโนโลยีการรู้จำใบหน้ายังคงมีอัตราความผิดพลาดสูงสำหรับชนกลุ่มน้อยเนื่องจากขาดข้อมูลการฝึกอบรมที่มีแทน
ตัวอย่างที่กล่าวมาข้างต้นเป็นเพียงส่วนหนึ่งของการเอนเอียงที่แสดงโดยโมเดล AI และเราสามารถคาดการณ์ได้ว่าจะมีปัญหาใหญ่ขึ้นในอนาคตหากเราไม่ให้ความสำคัญกับการลดการเอนเอียงในขณะนี้ สิ่งสำคัญคือต้องจำไว้ว่าโมเดล AI เรียนรู้จากข้อมูลที่มีการเอนเอียงเหล่านี้เนื่องจากการตัดสินใจของมนุษย์ที่ได้รับอิทธิพลจากอคติที่ไม่ได้ตรวจสอบและอคติโดยไม่รู้ตัว ในหลายกรณี การให้มนุษย์เป็นผู้ตัดสินใจแทนก็อาจไม่ช่วยขจัดอคติ
การลดการเอนเอียงอย่างแท้จริงจะเกี่ยวข้องกับการทำความเข้าใจว่าการเอนเอียงเหล่านี้มีอยู่ในข้อมูลที่เราใช้ในการฝึกอบรมโมเดล ระบุปัจจัยที่ทำให้เกิดการคาดการณ์ที่มีการเอนเอียง และตัดสินใจร่วมกันว่าเราต้องการใช้ข้อมูลใดในการตัดสินใจที่สำคัญ การพัฒนาชุดมาตรฐานเพื่อประเมินโมเดลสำหรับความปลอดภัยก่อนที่จะใช้สำหรับกรณีการใช้งานที่ละเอียดอ่อนจะเป็นขั้นตอนสำคัญไปข้างหน้า
ภาวะหลอนของ AI เป็นปัญหาที่ยิ่งใหญ่สำหรับ AI เชิงกำเนิดใดๆ คุณสามารถอธิบายได้ว่า การฝึกอบรมแบบมีมนุษย์ร่วมในวงจร (HITL) สามารถลดปัญหาเหล่านี้ได้อย่างไร?
ภาวะหลอนของ AI เป็นปัญหาเฉพาะในกรณีการใช้งานของ AI เชิงกำเนิด แต่สิ่งสำคัญคือต้องทราบว่าไม่ใช่ปัญหาในตัวมันเอง ในกรณีการใช้งานที่สร้างสรรค์บางอย่าง ภาวะหลอนเป็นสิ่งที่ต้องการและช่วยให้ได้ผลลัพธ์ที่สร้างสรรค์และน่าสนใจมากขึ้น
ภาวะหลอนอาจเป็นปัญหาในกรณีการใช้งานที่ต้องอาศัยข้อมูลที่ถูกต้อง เช่น ในด้านการดูแลสุขภาพ ซึ่งการตัดสินใจที่มั่นคงถือเป็นสิ่งสำคัญ การให้ข้อมูลที่เชื่อถือได้กับบุคลากรทางการแพทย์เป็นสิ่งจำเป็น
HITL หมายถึงระบบที่อนุญาตให้มนุษย์ให้ข้อเสนอแนะโดยตรงแก่โมเดลสำหรับการคาดการณ์ที่ต่ำกว่าระดับความมั่นใจที่กำหนด ในบริบทของภาวะหลอน HITL สามารถใช้เพื่อช่วยให้โมเดลเรียนรู้ระดับความมั่นใจที่ควรจะมีสำหรับกรณีการใช้งานต่างๆ ก่อนตอบ เกณฑ์ความมั่นใจเหล่านี้แตกต่างกันตามกรณีใช้งาน การสอนให้โมเดลเข้าใจระดับความเข้มงวดที่จำเป็นในการตอบแต่ละประเภทจึงช่วยลดภาวะหลอนที่เป็นปัญหาได้ ตัวอย่างเช่น ในงานกฎหมาย มนุษย์อาจสาธิตว่าโมเดลต้องตรวจสอบข้อเท็จจริงก่อนตอบคำถามจากเอกสารกฎหมายที่ซับซ้อนซึ่งมีข้อกำหนดและเงื่อนไขจำนวนมาก
พนักงาน AI เช่น ผู้ทำเครื่องหมายข้อมูลสามารถช่วยลดปัญหาการเอนเอียงของ AI ได้อย่างไร?
พนักงาน AI สามารถช่วยระบุการเอนเอียงที่มีอยู่ในข้อมูลได้ และเมื่อการเอนเอียงถูกระบุแล้ว ก็จะง่ายต่อการหาวิธีลดการเอนเอียงที่เป็นอันตราย พนักงานทำเครื่องหมายข้อมูลสามารถช่วยในการหาวิธีลดการเอนเอียงได้ เช่น สำหรับงาน NLP พวกเขาสามารถช่วยโดยการให้วิธีการเขียนข้อความที่มีปัญหาใหม่เพื่อลดการเอนเอียงในภาษา นอกจากนี้ ความหลากหลายของผู้ทำงานด้าน AI ยังช่วยลดอคติในการติดป้ายข้อมูลได้
คุณรับรองว่าพนักงาน AI ไม่ได้ให้การเอนเอียงของมนุษย์เข้าไปในระบบ AI โดยไม่ตั้งใจได้อย่างไร?
เป็นปัญหาที่ซับซ้อนซึ่งต้องมีการพิจารณาอย่างรอบคอบ การกำจัดการเอนเอียงของมนุษย์เป็นเรื่องที่ยากมาก และพนักงาน AI อาจให้การเอนเอียงของตนเองเข้าไปในโมเดลโดยไม่ตั้งใจ ดังนั้นจึงเป็นสิ่งสำคัญที่จะพัฒนากระบวนการที่ชี้นำพนักงานให้ปฏิบัติตามแนวทางปฏิบัติที่ดีที่สุด
ขั้นตอนที่สามารถทำได้เพื่อลดการเอนเอียงของมนุษย์ให้เหลือน้อยที่สุด ได้แก่
- การฝึกอบรมพนักงาน AI อย่างครอบคลุมเกี่ยวกับอคติโดยไม่รู้ตัว พร้อมเครื่องมือเพื่อระบุและจัดการอคติของตนเองระหว่างการติดป้ายข้อมูล
- การตรวจสอบรายการเพื่อเตือนพนักงาน AI ให้ตรวจสอบผลลัพธ์ของตนเองก่อนที่จะส่งมอบ
- การประเมินเพื่อตรวจสอบระดับการเข้าใจของพนักงาน AI โดยการให้ตัวอย่างผลลัพธ์จากกรณีการใช้งานที่มีการเอนเอียงต่างๆ และขอให้พวกเขาเลือกผลลัพธ์ที่มีการเอนเอียงน้อยที่สุด
ผู้กำกับดูแลทั่วโลกตั้งใจที่จะควบคุมผลลัพธ์ของ AI คุณคิดว่าผู้กำกับดูแลเข้าใจผิดในเรื่องใด และเข้าใจถูกในเรื่องใด?
สิ่งสำคัญคือต้องเริ่มต้นด้วยการบอกว่านี่เป็นปัญหาที่ยากมากที่ไม่มีใครพบวิธีแก้ไขได้ สังคมและ AI จะพัฒนาและส่งผลต่อซึ่งกันและกันในทางที่ยากต่อการคาดการณ์ ส่วนหนึ่งของกลยุทธ์ที่มีประสิทธิภาพในการค้นหาการปฏิบัติงานที่มั่นคงและเป็นประโยชน์คือการให้ความสนใจกับสิ่งที่เกิดขึ้นใน AI วิธีที่ผู้คนตอบสนองต่อ AI และผลกระทบที่มีต่ออุตสาหกรรมต่างๆ
ฉันคิดว่าข้อขัดข้องที่สำคัญในการควบคุมผลลัพธ์ของ AI คือการขาดความเข้าใจเกี่ยวกับสิ่งที่โมเดล AI สามารถและไม่สามารถทำได้ และวิธีการทำงานของพวกมัน ซึ่งทำให้ยากต่อการคาดการณ์ผลกระทบที่โมเดลเหล่านี้จะมีต่อภาคส่วนและกลุ่มต่างๆ ของสังคม อีกด้านที่ยังขาดคือแนวคิดนำทางในการจัดแนวโมเดล AI ให้สอดคล้องกับค่านิยมของมนุษย์ และการอธิบายความปลอดภัยให้เป็นรูปธรรมมากขึ้น
ผู้กำกับดูแลได้พยายามร่วมมือกับผู้เชี่ยวชาญในด้าน AI และได้ระมัดระวังที่จะไม่ขัดขวางนวัตกรรมด้วยกฎเกณฑ์ที่เข้มงวดเกินไป และได้เริ่มพิจารณาผลกระทบของ AI ต่อการถูกแทนที่ด้วยงาน ซึ่งล้วนเป็นประเด็นสำคัญ เราต้องดำเนินการอย่างระมัดระวังขณะที่ความคิดเรื่องกฎระเบียบ AI ชัดเจนขึ้นตามเวลา และให้ผู้คนมีส่วนร่วมมากที่สุดเพื่อจัดการเรื่องนี้อย่างเป็นประชาธิปไตย
วิธีแก้ปัญหาของ Prolific สามารถช่วยให้ธุรกิจลดการเอนเอียงของ AI และปัญหาอื่นๆ ที่เราได้พูดถึงได้อย่างไร?
การรวบรวมข้อมูลสำหรับโครงการ AI ไม่ได้เป็นกระบวนการที่ผ่านการพิจารณาหรือวางแผนอย่างรอบคอบเสมอไป เราเคยเห็นการขุดข้อมูล การส่งงานไปต่างประเทศ และวิธีการอื่นๆ ที่ไม่เหมาะสม อย่างไรก็ตาม วิธีการฝึกอบรม AI เป็นสิ่งสำคัญ และโมเดลรุ่นต่อไปจะต้องสร้างขึ้นจากข้อมูลที่รวบรวมอย่างตั้งใจและมีคุณภาพสูงจากผู้คนจริงๆ และจากผู้ที่เรามีการติดต่อโดยตรง ซึ่งเป็นที่ที่ Prolific กำลังสร้างความแตกต่าง
โดเมนอื่นๆ เช่น การสำรวจความคิดเห็น การวิจัยตลาด หรือการวิจัยทางวิทยาศาสตร์ ได้เรียนรู้สิ่งนี้มานานแล้ว ผู้ฟังที่คุณตัวอย่างมาจากมีผลกระทบอย่างมากต่อผลลัพธ์ที่คุณได้รับ AI กำลังตามทัน และเรากำลังอยู่ที่จุดเปลี่ยนในขณะนี้
ขณะนี้เป็นเวลาที่เราต้องเริ่มให้ความสำคัญกับการใช้ตัวอย่างที่ดีกว่าและทำงานกับกลุ่มที่เป็นตัวแทนของประชากรได้ดีกว่าสำหรับการฝึกอบรม AI และการปรับปรุง ซึ่งทั้งสองอย่างนี้เป็นสิ่งสำคัญในการพัฒนาโมเดลที่ปลอดภัย ไม่มีการเอนเอียง และสอดคล้องกัน
Prolific สามารถช่วยให้ธุรกิจมีเครื่องมือที่เหมาะสมในการทดลอง AI ในรูปแบบที่ปลอดภัย และรวบรวมข้อมูลจากผู้เข้าร่วมที่การเอนเอียงถูกตรวจสอบและลดลงในระหว่างกระบวนการ เราสามารถช่วยให้คำแนะนำเกี่ยวกับแนวทางปฏิบัติที่ดีที่สุดในการรวบรวมข้อมูลและการเลือกผู้เข้าร่วม และการจ่ายค่าตอบแทนและปฏิบัติต่อผู้เข้าร่วมอย่างยุติธรรม
คุณมีความคิดเห็นอย่างไรเกี่ยวกับการโปร่งใสของ AI คุณคิดว่าผู้ใช้ควรเห็นข้อมูลที่ AI ถูกฝึกอบรมหรือไม่?
ฉันคิดว่ามีทั้งข้อดีและข้อเสียของการโปร่งใส และยังไม่มีการหาจุดกึ่งกลางที่ดี บริษัทต่างๆ กำลังเก็บข้อมูลเกี่ยวกับข้อมูลที่ใช้ในการฝึกอบรม AI ของตนเองเนื่องจากความกลัวการฟ้องร้อง บางบริษัทได้พยายามทำให้โมเดล AI ของตนเองเปิดเผยต่อสาธารณะและเผยแพร่ข้อมูลเกี่ยวกับข้อมูลที่ใช้ในการฝึกอบรม
การโปร่งใสทั้งหมดเปิดโอกาสให้สามารถใช้ประโยชน์จากจุดอ่อนของโมเดลเหล่านี้ได้ การปิดบังทั้งหมดไม่ช่วยให้สร้างความไว้วางใจและไม่ช่วยให้สังคมเข้ามามีส่วนร่วมในการสร้าง AI ที่ปลอดภัย จุดกึ่งกลางที่ดีจะให้การโปร่งใสเพียงพอที่จะสร้างความไว้วางใจในเราและทำให้เรามั่นใจว่าโมเดล AI ถูกฝึกอบรมจากข้อมูลที่มีคุณภาพดีและเกี่ยวข้องซึ่งเราได้ยินยอมให้ใช้ เราต้องติดตามอย่างใกล้ชิดว่า AI ส่งผลต่ออุตสาหกรรมต่างๆ อย่างไร เปิดการสนทนากับผู้ได้รับผลกระทบ และพัฒนาแนวทางที่ใช้ได้ผลสำหรับทุกคน
ฉันคิดว่ามันสำคัญที่จะพิจารณาว่าผู้ใช้ต้องการอะไรในแง่ของการอธิบายได้ หากพวกเขาอยากทราบว่าทำไมโมเดลจึงให้ผลลัพธ์บางอย่าง การให้ข้อมูลดิบที่โมเดลถูกฝึกอบรมอาจไม่ช่วยตอบคำถามนั้น ดังนั้นการสร้างเครื่องมือการอธิบายและตีความที่ดีจึงเป็นสิ่งสำคัญ
การวิจัยการจัดแนว AI มุ่งหวังที่จะชี้นำระบบ AI ไปสู่เป้าหมาย ความชอบ หรือหลักการทางจริยธรรมของมนุษย์ คุณสามารถอธิบายได้อย่างไรว่าพนักงาน AI ถูกฝึกอบรมและใช้เพื่อให้แน่ใจว่า AI มีการจัดแนวมากที่สุด?
สิ่งนี้เป็นพื้นที่การวิจัยที่กำลังดำเนินอยู่และยังไม่มีข้อตกลงเกี่ยวกับกลยุทธ์ที่ควรใช้ในการจัดแนวโมเดล AI กับค่านิยมของมนุษย์หรือแม้แต่ชุดค่านิยมที่ควรเทียบเคียง
พนักงาน AI มักถูกขอให้แสดงความชอบและตอบคำถามเกี่ยวกับความชอบของตนอย่างแท้จริง ในขณะเดียวกันก็ปฏิบัติตามหลักการเกี่ยวกับความปลอดภัย การไม่มีการเอนเอียง การไม่ทำอันตราย และความมีประโยชน์
สำหรับการจัดแนวให้สอดคล้องกับเป้าหมาย หลักการทางจริยธรรม หรือค่านิยม มีหลายแนวทางที่น่าสนใจ ตัวอย่างสำคัญคือผลงานของ Meaning Alignment Institute เรื่องการปรับแต่งแบบประชาธิปไตย (Democratic Fine-Tuning) โดยมีบทความแนะนำแนวคิดนี้อย่างดีที่นี่
ขอขอบคุณสำหรับการสัมภาษณ์ที่ยอดเยี่ยมและสำหรับการแบ่งปันมุมมองของคุณเกี่ยวกับการเอนเอียงของ AI ผู้อ่านสามารถเยี่ยมชม Prolific เพื่อเรียนรู้เพิ่มเติม




