
โมเดลและแพลตฟอร์ม AI
วิวัฒนาการของ AI แบบหลายสื่อ เมื่อ ChatGPT มองเห็นได้ด้วย GPT-4V

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญOpenAI เปิดตัว GPT-4V เพิ่มความสามารถวิเคราะห์ภาพให้ ChatGPT ขยายขอบเขต AI…
ดูเพิ่มเติม
- OpenAI เปิดตัว GPT-4V เพิ่มความสามารถวิเคราะห์ภาพให้ ChatGPT ขยายขอบเขต AI ออกไปจากข้อความ
- GPT-4V แสดงศักยภาพในงานเทคนิค แต่ยังมีข้อบกพร่องร้ายแรงในการใช้งานทางการแพทย์
- โมเดลหลายรูปแบบเช่น Med-PaLM M กำลังก้าวหน้าในสาขาเฉพาะทาง เช่น ด้านสุขภาพ
OpenAI พัฒนาโมเดล GPT อย่างต่อเนื่อง โดย GPT-4 สามารถรับพรอมต์ได้ทั้งข้อความและภาพ
ความสามารถแบบหลายสื่อใน AI เชิงกำเนิดหมายถึงความสามารถของโมเดลในการสร้างผลลัพธ์หลายประเภท เช่น ข้อความ ภาพ หรือเสียง ตามข้อมูลที่ป้อนเข้า โมเดลเหล่านี้เรียนรู้รูปแบบพื้นฐานจากข้อมูลฝึกเพื่อสร้างข้อมูลใหม่ที่คล้ายคลึงกัน และขยายขอบเขตการประยุกต์ใช้ AI
ความก้าวหน้าล่าสุดในAI แบบหลายสื่อ
ความก้าวหน้าที่น่าสนใจล่าสุดในด้านนี้คือการรวม DALL-E 3 เข้ากับ ChatGPT ซึ่งเป็นการอัปเกรดที่สำคัญในเทคโนโลยีการสร้างภาพจากข้อความของ OpenAI การผสมผสานนี้ช่วยให้การโต้ตอบกับ ChatGPT มีความราบรื่นมากขึ้น โดยที่ ChatGPT ช่วยในการสร้างคำสั่งให้แม่นยำสำหรับ DALL-E 3 ทำให้การสร้างงานศิลปะ AI ง่ายขึ้นสำหรับผู้ใช้
สามารถดูข้อมูลเพิ่มเติมเกี่ยวกับ DALL-E 3 และการรวมเข้ากับ ChatGPT ได้ที่ นี่ การทำงานร่วมกันนี้ไม่เพียงแต่แสดงถึงความก้าวหน้าในAI แบบหลายสื่อ แต่ยังทำให้การสร้างงานศิลปะ AI เป็นเรื่องที่ง่ายและสนุกสำหรับผู้ใช้ด้วย

ในทางกลับกัน Google ได้แนะนำ Med-PaLM M ในเดือนมิถุนายนปีนี้ ซึ่งเป็นโมเดลสร้างข้อมูลหลายรูปแบบที่มีความสามารถในการเข้ารหัสและตีความข้อมูลชีวการแพทย์ที่หลากหลาย โมเดลนี้ได้รับการฝึกฝนโดยใช้ PaLM-E ซึ่งเป็นโมเดลภาษาที่ถูกปรับให้เหมาะสมสำหรับโดเมนการแพทย์โดยใช้ MultiMedBench ซึ่งเป็นชุดข้อมูลที่มีมากกว่า 1 ล้านตัวอย่างทั่ว 7 ประเภทข้อมูลชีวการแพทย์และ 14 งาน เช่น การตอบคำถามทางการแพทย์และการสร้างรายงานรังสีวิทยา
อุตสาหกรรมต่างๆ กำลังนำAI แบบหลายสื่อ ที่เป็นนวัตกรรมมาใช้เพื่อกระตุ้นการเติบโตทางธุรกิจ ปรับปรุงการดำเนินงานให้คล่องตัว และเพิ่มความพึงพอใจของลูกค้า ความก้าวหน้าในด้านเสียง วิดีโอ และข้อความ AI กำลังขับเคลื่อนการเติบโตของAI แบบหลายสื่อ
องค์กรต่างๆ กำลังมองหาAI แบบหลายสื่อ ที่สามารถเปลี่ยนแปลงแบบจำลองธุรกิจและกระบวนการทำงานได้ โดยเปิดโอกาสให้เติบโตทั่วทั้งระบบนิเวศของ AI ตั้งแต่เครื่องมือข้อมูลไปจนถึงแอปพลิเคชัน AI ที่เกิดขึ้นใหม่
หลังจาก GPT-4 เปิดตัวในเดือนมีนาคม ผู้ใช้บางส่วนรายงานว่าคุณภาพคำตอบลดลง โดยมีการหารือถึงข้อกังวลนี้ใน ฟอรัมของ OpenAI แม้ OpenAI จะปฏิเสธข้อกังวลในตอนแรก งานศึกษาฉบับแรกที่เผยแพร่ในเดือนกรกฎาคม 2023 พบว่าความแม่นยำของ GPT-4 ในงานทดสอบการระบุจำนวนเฉพาะลดจาก 97.6% ในเดือนมีนาคมเป็น 2.4% ในเดือนมิถุนายน ตัวเลขนี้เป็นผลของงานทดสอบเฉพาะดังกล่าว ไม่ใช่ความแม่นยำโดยรวมของ GPT-4

ChatGPT (สีน้ำเงิน) & ปัญญาประดิษฐ์ (สีแดง): แนวโน้มการค้นหาบน Google
ความฮือฮาเกี่ยวกับ OpenAI ChatGPT กลับมาอีกครั้ง โดยตอนนี้มีคุณสมบัติในการมองเห็น GPT-4V ที่ช่วยให้ผู้ใช้สามารถให้ GPT-4 วิเคราะห์ภาพที่ให้มาได้ คุณสมบัตินี้เป็นการเปิดตัวล่าสุดที่เปิดให้ผู้ใช้สามารถใช้งานได้
การเพิ่มการวิเคราะห์ภาพเข้าไปในโมเดลภาษาขนาดใหญ่ (LLM) เช่น GPT-4 ถูกมองว่าเป็นขั้นตอนสำคัญในการวิจัยและพัฒนา AI โมเดล LLM หลายรูปแบบนี้เปิดโอกาสใหม่ๆ โดยนำโมเดลภาษาไปไกลกว่าข้อความเพื่อเสนออินเทอร์เฟซใหม่ๆ และแก้ปัญหาที่หลากหลาย โดยสร้างประสบการณ์ใหม่ๆ สำหรับผู้ใช้
การฝึก GPT-4V เสร็จสิ้นในปี 2022 โดยมีการเปิดให้เข้าถึงในต้นเดือนมีนาคม 2023 คุณสมบัติการมองเห็นของ GPT-4V ได้รับการขับเคลื่อนโดยเทคโนโลยี GPT-4 การฝึกอบรมดำเนินไปในลักษณะเดียวกัน โดยเริ่มต้นจากการฝึกโมเดลเพื่อคาดการณ์คำถัดไปในข้อความโดยใช้เซตข้อมูลขนาดใหญ่ของข้อความและภาพจากแหล่งต่างๆ รวมถึงอินเทอร์เน็ต
ต่อมาได้รับการปรับให้เหมาะสมด้วยข้อมูลเพิ่มเติมโดยใช้การเรียนรู้แบบเสริมกำลังจากข้อเสนอแนะของมนุษย์ (RLHF) เพื่อสร้างผลลัพธ์ที่มนุษย์ชอบ
กลไกการมองเห็นของ GPT-4
ความสามารถในการมองเห็นของ GPT-4 แม้ว่าจะน่าประทับใจ แต่ยังมีวิธีการทำงานที่ซ่อนอยู่
เพื่อสำรวจสมมติฐานนี้ โมเดลภาษาและภาพที่เรียกว่า MiniGPT-4 ถูกนำเสนอ โดยใช้โมเดลภาษาขนาดใหญ่ (LLM) ที่เรียกว่า Vicuna โมเดลนี้ใช้ตัวเข้ารหัสภาพที่มีส่วนประกอบที่ได้รับการฝึกอบรมไว้ล่วงหน้าสำหรับการรับรู้ภาพ โดยจัดตำแหน่งคุณลักษณะภาพที่ถูกเข้ารหัสให้สอดคล้องกับโมเดลภาษา Vicuna ผ่านชั้นฉายภาพเพียงชั้นเดียว โครงสร้างของ MiniGPT-4 นั้นเรียบง่ายแต่มีประสิทธิภาพ โดยมุ่งเน้นในการจัดตำแหน่งคุณลักษณะภาพและภาษาให้สอดคล้องกันเพื่อปรับปรุงความสามารถในการสนทนาที่มองเห็น
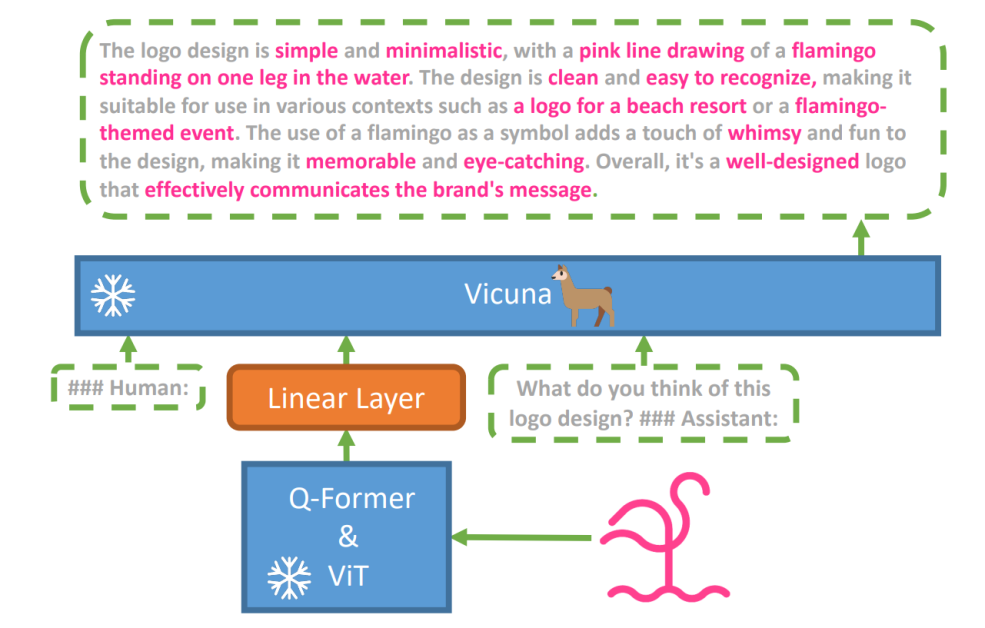
โครงสร้างของ MiniGPT-4 รวมถึงตัวเข้ารหัสภาพพร้อมส่วนประกอบ ViT และ Q-Former ชั้นฉายภาพเพียงชั้นเดียว และโมเดลภาษาขนาดใหญ่ Vicuna ที่มีความก้าวหน้า
แนวโน้มของโมเดลภาษาแบบออโตรีเกรสซีฟในงานภาษาและภาพก็เติบโตขึ้น โดยใช้การถ่ายโอนข้ามโหมดเพื่อแบ่งปันความรู้ระหว่างโดเมนภาษาและหลายรูปแบบ
MiniGPT-4 เชื่อมโยงโดเมนภาพและภาษาโดยจัดตำแหน่งข้อมูลภาพจากตัวเข้ารหัสภาพที่ได้รับการฝึกอบรมไว้ล่วงหน้าให้สอดคล้องกับโมเดลภาษาขนาดใหญ่ (LLM) ที่มีความก้าวหน้า โมเดลนี้ใช้ Vicuna เป็นตัวถอดรหัสภาษาและติดตามแนวทางฝึกอบรมสองขั้นตอน ในขั้นตอนแรกจะถูกฝึกอบรมบนเซตข้อมูลขนาดใหญ่ของภาพและข้อความเพื่อทำความเข้าใจความรู้ภาษาและภาพ ต่อมาจะได้รับการปรับให้เหมาะสมบนเซตข้อมูลที่เล็กกว่าแต่มีคุณภาพสูงเพื่อเพิ่มความน่าเชื่อถือและความสามารถในการใช้งาน
เพื่อปรับปรุงความเป็นธรรมชาติและความสามารถในการใช้งานของภาษาที่ถูกสร้างขึ้นใน MiniGPT-4 นักวิจัยได้พัฒนาการจัดตำแหน่งสองขั้นตอนเพื่อแก้ไขปัญหาการไม่มีเซตข้อมูลที่เหมาะสมสำหรับการจัดตำแหน่งภาษาและภาพ พวกเขาได้สร้างเซตข้อมูลพิเศษสำหรับจุดประสงค์นี้
ในขั้นตอนแรก โมเดลจะสร้างคำอธิบายภาพที่มีรายละเอียด โดยเพิ่มรายละเอียดโดยใช้คำสั่งการสนทนาที่สอดคล้องกับรูปแบบของโมเดลภาษา Vicuna
การวิเคราะห์ขั้นตอนแรกของคำสั่ง:
###Human: <Img><ImageFeature></Img>อธิบายภาพนี้โดยละเอียด ให้มากที่สุดเท่าที่จะเป็นไปได้ บอกทุกสิ่งที่คุณเห็น ###Assistant:
สำหรับการประมวลผลข้อมูลหลังการสร้าง จะมีการแก้ไขความไม่สอดคล้องหรือข้อผิดพลาดในคำอธิบายที่ถูกสร้างขึ้นโดยใช้ ChatGPT ตามด้วยการตรวจสอบด้วยมือเพื่อให้แน่ใจถึงคุณภาพสูง
คำสั่งสำหรับการปรับให้เหมาะสมในขั้นตอนที่สอง:
###Human: <Img><ImageFeature></Img><Instruction>###Assistant:
การสำรวจนี้เปิดหน้าต่างให้เข้าใจกลไกของ AI ที่สร้างข้อมูลหลายรูปแบบ เช่น GPT-4 โดยให้แสงสว่างเกี่ยวกับวิธีการรวมโหมดภาพและภาษาเข้าด้วยกันเพื่อสร้างผลลัพธ์ที่สอดคล้องกันและอุดมไปด้วยบริบท
การสำรวจ GPT-4 Vision
การกำหนดที่มาของภาพด้วย ChatGPT
GPT-4 Vision เพิ่มความสามารถของ ChatGPT ในการวิเคราะห์ภาพและระบุที่มาของภาพ ซึ่งเป็นเครื่องมือที่มีประโยชน์สำหรับผู้ที่สนใจเรียนรู้เกี่ยวกับสถานที่ต่างๆ ผ่านข้อมูลภาพ

การถาม ChatGPT เกี่ยวกับที่มาของภาพสถานที่สำคัญ
แนวคิดทางคณิตศาสตร์ที่ซับซ้อน
GPT-4 Vision มีความสามารถในการสำรวจแนวคิดทางคณิตศาสตร์ที่ซับซ้อนโดยการวิเคราะห์สมการหรือการเขียนด้วยมือ ซึ่งเป็นเครื่องมือที่มีประโยชน์สำหรับผู้ที่ต้องการแก้ปัญหาคณิตศาสตร์ที่ซับซ้อน ทำให้ GPT-4 Vision เป็นเครื่องมือที่มีคุณค่าในด้านการศึกษาและวิชาการ

การถาม ChatGPT เพื่อทำความเข้าใจแนวคิดคณิตศาสตร์ที่ซับซ้อน
การแปลงอินพุตที่เขียนด้วยมือเป็นโค้ด LaTeX
หนึ่งในความสามารถที่น่าประทับใจของ GPT-4V คือความสามารถในการแปลอินพุตที่เขียนด้วยมือเป็นโค้ด LaTeX ซึ่งเป็นประโยชน์สำหรับนักวิจัย นักวิชาการ และนักเรียนที่ต้องแปลงนิพจน์ทางคณิตศาสตร์หรือข้อมูลทางเทคนิคที่เขียนด้วยมือให้เป็นรูปแบบดิจิทัล การแปลงจากอินพุตที่เขียนด้วยมือเป็น LaTeX ขยายขอบเขตของการดิจิตอลไฟล์เอกสารและทำให้กระบวนการเขียนทางเทคนิคง่ายขึ้น

ความสามารถของ GPT-4V ในการแปลงลายมือเป็นโค้ด LaTeX
การดึงข้อมูลจากตาราง
GPT-4V แสดงความสามารถในการดึงข้อมูลจากตารางและตอบคำถามที่เกี่ยวข้อง ซึ่งเป็นทรัพยากรที่มีค่าสำหรับการวิเคราะห์ข้อมูล ผู้ใช้สามารถใช้ GPT-4V เพื่อค้นหาข้อมูลสำคัญและตอบคำถามได้ ทำให้เป็นเครื่องมือที่แข็งแกร่งสำหรับนักวิเคราะห์ข้อมูลและผู้เชี่ยวชาญอื่นๆ

GPT-4V อ่านรายละเอียดในตารางและตอบคำถามที่เกี่ยวข้อง
การทำความเข้าใจการชี้ภาพ
ความสามารถพิเศษของ GPT-4V ในการทำความเข้าใจการชี้ภาพเพิ่มมิติใหม่ให้กับการโต้ตอบกับผู้ใช้ โดยการทำความเข้าใจสัญญาณภาพ GPT-4V สามารถตอบคำถามด้วยความเข้าใจบริบทที่สูงขึ้น

GPT-4V แสดงความสามารถพิเศษในการทำความเข้าใจการชี้ภาพ
การสร้างเว็บไซต์แบบโมคอัพโดยใช้การวาดภาพ
ได้รับแรงบันดาลใจจาก ทวีต นี้ ผู้เขียนได้ลองสร้างโมคอัพสำหรับเว็บไซต์ unite.ai
แม้ว่าผลลัพธ์จะไม่ตรงกับวิสัยทัศน์แรก แต่นี่คือผลลัพธ์ที่ได้รับ

หน้าเว็บ HTML ที่สร้างด้วย ChatGPT Vision
ข้อจำกัดและข้อบกพร่องของ GPT-4V
ในการวิเคราะห์ GPT-4V ทีม Open AI ได้ทำการประเมินเชิงคุณภาพและเชิงปริมาณ ซึ่งรวมถึงการทดสอบภายในและการทบทวนโดยผู้เชี่ยวชาญภายนอก และการวัดผลการปฏิเสธของโมเดลและความแม่นยำในหลายสถานการณ์ เช่น การระบุเนื้อหาที่เป็นอันตราย การรับรู้ประชากรศาสตร์ ข้อกังวลด้านความเป็นส่วนตัว การระบุตำแหน่งทางภูมิศาสตร์ ความมั่นคงทางไซเบอร์ และการหลบเลี่ยงมาตรการความปลอดภัยผ่านข้อมูลหลายสื่อ
อย่างไรก็ตาม โมเดลยังไม่สมบูรณ์แบบ
เอกสาร นี้ เน้นถึงข้อจำกัดของ GPT-4V เช่น การอนุมานที่ไม่ถูกต้องและการขาดข้อความหรือตัวอักษรในภาพ ซึ่งอาจสร้างข้อมูลขึ้นมาเองได้ โดยเฉพาะไม่เหมาะสมสำหรับการระบุสสารอันตรายในภาพ ซึ่งมักจะระบุไม่ถูกต้อง
ในด้านการถ่ายภาพทางการแพทย์ GPT-4V สามารถให้คำตอบที่ไม่สอดคล้องกันและขาดความเข้าใจในแนวปฏิบัติที่เป็นมาตรฐาน ซึ่งอาจนำไปสู่การวินิจฉัยที่ไม่ถูกต้อง

การทำงานที่ไม่น่าเชื่อถือสำหรับวัตถุประสงค์ทางการแพทย์ (แหล่งที่มา)
นอกจากนี้ยังขาดความเข้าใจในความหมายของสัญลักษณ์เกลียดชังบางอย่าง และอาจสร้างเนื้อหาที่ไม่เหมาะสมตามข้อมูลภาพที่ให้มา OpenAI แนะนำให้ไม่ใช้ GPT-4V สำหรับการตีความที่สำคัญ โดยเฉพาะในบริบททางการแพทย์หรือที่มีความอ่อนไหว
สรุป

สร้างด้วย Fast Stable Diffusion XL https://huggingface.co/spaces/google/sdxl
การมาถึงของ GPT-4 Vision (GPT-4V) นำมาซึ่งโอกาสใหม่ๆ และอุปสรรคใหม่ๆ ก่อนที่จะปล่อยให้ผู้ใช้ได้เข้าถึง มีการใช้ความพยายามอย่างมากในการลดความเสี่ยง โดยเฉพาะอย่างยิ่งเมื่อพูดถึงรูปภาพของบุคคล
มีคำถามใหญ่ๆ ที่ถูกวางบนโต๊ะ เช่น โมเดลเหล่านี้ควรจะสามารถระบุคนดังจากภาพหรือไม่? ควรจะเดาเพศ เชื้อชาติ หรืออารมณ์ของบุคคลจากภาพหรือไม่? และควรจะมีการปรับแต่งพิเศษเพื่อช่วยผู้ที่มีปัญหาในการมองเห็นหรือไม่? คำถามเหล่านี้เปิดโอกาสให้เกิดการอภิปรายเกี่ยวกับความเป็นส่วนตัว ความยุติธรรม และวิธีที่ AI ควรจะเข้ามาเป็นส่วนหนึ่งของชีวิตของเรา ซึ่งเป็นเรื่องที่ทุกคนควรจะมีส่วนร่วมในการพูดคุย


