
สัมภาษณ์
ไมค์ แคปส์ ผู้ร่วมก่อตั้งและซีอีโอของ Diveplane – ชุดสัมภาษณ์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
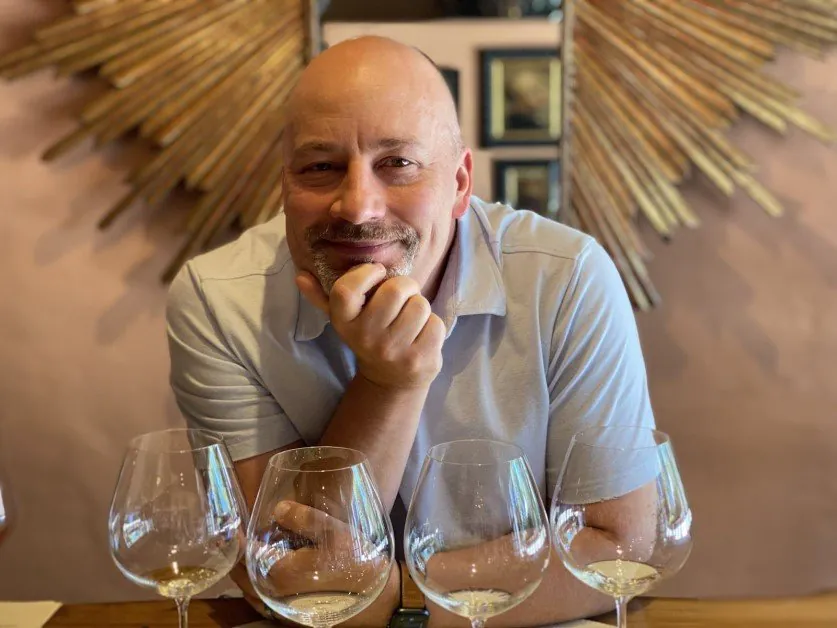
ดร. ไมเคิล แคปส์ เป็นนักเทคโนโลยีที่มีชื่อเสียงและซีอีโอของ Diveplane Corporation ก่อนร่วมก่อตั้ง Diveplane ไมค์มีอาชีพอันโดดเด่นในอุตสาหกรรมวิดีโอเกมในฐานะประธานของ Epic Games ผู้สร้างเกมยอดนิยมอย่าง Fortnite และ Gears of War ช่วงที่เขาดำรงตำแหน่งครอบคลุมรางวัลเกมแห่งปีหนึ่งร้อยรางวัล การกล่าวปาฐกถาหลักในงานประชุมหลายสิบครั้ง รางวัลความสำเร็จตลอดชีวิต และการต่อสู้เพื่อคุ้มครองเสรีภาพในการแสดงออกของวิดีโอเกมในศาลสูงสุดสหรัฐฯ ที่ประสบความสำเร็จDiveplane นำเสนอโซลูชันธุรกิจที่ขับเคลื่อนด้วย AI ในหลายอุตสาหกรรม ด้วยสิทธิบัตรที่อนุมัติแล้วหกรายการและที่อยู่ระหว่างการพิจารณาอีกหลายรายการ AI ที่เข้าใจได้ของ Diveplane ช่วยให้เข้าใจการตัดสินใจอย่างครบถ้วนและมองเห็นกระบวนการตัดสินใจอย่างโปร่งใส เพื่อสนับสนุนนโยบาย AI ที่มีจริยธรรมและกลยุทธ์ความเป็นส่วนตัวของข้อมูลคุณเกษียณจากอาชีพที่ประสบความสำเร็จในวงการวิดีโอเกมที่ Epic Games อะไรเป็นแรงบันดาลใจให้กลับมาทำงานโดยมุ่งเน้นที่ AI?
การสร้างเกมสนุกมาก แต่อย่างน้อยในเวลานั้นก็ไม่ใช่อาชีพที่เหมาะนักสำหรับคนที่เพิ่งเริ่มมีครอบครัว ผมมีงานในคณะกรรมการและบทบาทที่ปรึกษาให้ทำอยู่เสมอ แต่ไม่ได้รู้สึกเติมเต็ม ผมจึงทำรายการปัญหาใหญ่ของโลกสามเรื่องที่ผมอาจช่วยเปลี่ยนแปลงได้ หนึ่งในนั้นคือการแพร่หลายของระบบ AI แบบกล่องดำ ผมวางแผนจะใช้เวลาศึกษาแต่ละเรื่องหนึ่งปี แต่เพียงไม่กี่สัปดาห์ต่อมา คริส ฮาซาร์ด เพื่อนผู้ปราดเปรื่องของผม บอกว่าเขากำลังพัฒนาแพลตฟอร์ม AI ที่โปร่งใสและอธิบายได้อย่างครบถ้วนอย่างลับๆ และนั่นทำให้เรามาถึงจุดนี้
Diveplane เริ่มต้นด้วยภารกิจนำความเป็นมนุษย์มาสู่ AI คุณช่วยขยายความได้ไหมว่าหมายถึงอะไร?
ได้ครับ ในที่นี้เราใช้ความเป็นมนุษย์ในความหมายของความมีมนุษยธรรมหรือความเห็นอกเห็นใจ การจะทำให้โมเดล AI สะท้อนสิ่งที่ดีที่สุดของมนุษย์นั้น ไม่ใช่แค่ฝึกโมเดล ทดสอบเล็กน้อย แล้วหวังว่าทุกอย่างจะเรียบร้อย
เราต้องตรวจสอบข้อมูลขาเข้า ตัวโมเดล และผลลัพธ์ของโมเดลอย่างรอบคอบ เพื่อให้แน่ใจว่าสะท้อนสิ่งที่ดีที่สุดของมนุษย์ ระบบส่วนใหญ่ที่ฝึกจากข้อมูลในอดีตหรือข้อมูลโลกจริงจะไม่ถูกต้องตั้งแต่ครั้งแรก และไม่จำเป็นต้องปราศจากอคติด้วย เราเชื่อว่าวิธีเดียวที่จะขจัดความเอนเอียงในโมเดล ทั้งความผิดพลาดทางสถิติและอคติ คือการผสานความโปร่งใส ความสามารถในการตรวจสอบ และคำอธิบายที่มนุษย์เข้าใจได้
เทคโนโลยีหลักของ Diveplane เรียกว่า REACTOR อะไรทำให้เป็นแนวทางใหม่ในการทำให้การเรียนรู้ของเครื่องอธิบายได้?
โดยทั่วไป การเรียนรู้ของเครื่องใช้ข้อมูลสร้างโมเดลที่ตัดสินใจประเภทหนึ่ง การตัดสินใจอาจเป็นมุมเลี้ยวล้อรถ การอนุมัติหรือปฏิเสธการซื้อหรือระบุว่าเป็นการฉ้อโกง หรือผลิตภัณฑ์ที่ควรแนะนำให้บุคคลหนึ่ง หากต้องการทราบว่าโมเดลตัดสินใจอย่างไร โดยทั่วไปต้องให้โมเดลตัดสินใจในกรณีคล้ายกันหลายครั้ง แล้วพยายามคาดการณ์ว่าโมเดลจะทำอะไร เทคนิคการเรียนรู้ของเครื่องมีข้อจำกัดด้านประเภทของข้อมูลเชิงลึกที่ให้ได้ ด้านความสอดคล้องของคำอธิบายกับสิ่งที่โมเดลทำจริงเพื่อตัดสินใจ หรือด้านความแม่นยำที่ต่ำกว่า
การใช้ REACTOR แตกต่างออกไปมาก REACTOR อธิบายลักษณะความไม่แน่นอนของข้อมูล และข้อมูลของคุณกลายเป็นตัวโมเดล แทนที่จะสร้างโมเดลหนึ่งสำหรับการตัดสินใจแต่ละประเภท คุณเพียงถาม REACTOR ว่าต้องการให้ตัดสินใจเรื่องใด ซึ่งเป็นอะไรก็ได้ที่เกี่ยวข้องกับข้อมูล แล้ว REACTOR จะค้นว่าต้องใช้ข้อมูลใดสำหรับการตัดสินใจนั้น REACTOR แสดงข้อมูลที่ใช้ ความเกี่ยวข้องกับคำตอบ ความไม่แน่นอนทุกแง่มุม การให้เหตุผลเชิงสถานการณ์สมมติที่ขัดกับข้อเท็จจริง และตอบคำถามเพิ่มเติมได้แทบทุกข้อ เนื่องจากข้อมูลคือตัวโมเดล คุณจึงแก้ไขข้อมูลแล้ว REACTOR จะอัปเดตทันที ระบบแสดงได้ว่ามีข้อมูลที่ดูผิดปกติเข้ามามีส่วนในการตัดสินใจหรือไม่ และติดตามการแก้ไขข้อมูลทุกครั้งรวมถึงแหล่งที่มาได้ REACTOR ใช้ทฤษฎีความน่าจะเป็นตลอดกระบวนการ จึงระบุหน่วยวัดของการทำงานแต่ละส่วนได้ สุดท้าย คุณสามารถทำซ้ำและตรวจสอบการตัดสินใจใดๆ ได้ด้วยข้อมูลที่นำไปสู่การตัดสินใจนั้นและค่าความไม่แน่นอน โดยใช้คณิตศาสตร์ที่ค่อนข้างตรงไปตรงมา แม้ไม่ใช้ REACTOR เลยก็ตาม
REACTOR ทำทั้งหมดนี้ได้พร้อมรักษาความแม่นยำที่แข่งขันได้สูง โดยเฉพาะกับชุดข้อมูลขนาดเล็กและข้อมูลที่กระจัดกระจาย
GEMINAI สร้างฝาแฝดดิจิทัลของชุดข้อมูล หมายความว่าอย่างไร และช่วยรักษาความเป็นส่วนตัวของข้อมูลอย่างไร?
เมื่อป้อนชุดข้อมูลให้ GEMINAI ระบบจะทำความเข้าใจรูปร่างทางสถิติของข้อมูลอย่างลึกซึ้ง คุณสามารถใช้สร้างฝาแฝดสังเคราะห์ที่มีโครงสร้างคล้ายข้อมูลต้นฉบับ แต่ระเบียนทั้งหมดสร้างขึ้นใหม่ โดยยังคงรูปร่างทางสถิติเดิม เช่น อัตราการเต้นหัวใจเฉลี่ยของผู้ป่วยในทั้งสองชุดจะใกล้เคียงกัน เช่นเดียวกับสถิติอื่นๆ ดังนั้นการวิเคราะห์ข้อมูลด้วยฝาแฝดจะให้คำตอบเช่นเดียวกับข้อมูลต้นฉบับ รวมถึงการฝึกโมเดลการเรียนรู้ของเครื่อง
หากบุคคลหนึ่งมีระเบียนในข้อมูลต้นฉบับ จะไม่มีระเบียนของบุคคลนั้นในฝาแฝดสังเคราะห์ เราไม่ได้เพียงลบชื่อ แต่ทำให้แน่ใจว่าไม่มีระเบียนใหม่ที่อยู่ใกล้ระเบียนของบุคคลนั้นหรือระเบียนอื่นๆ ในปริภูมิข้อมูล กล่าวคือ ไม่มีระเบียนที่จดจำได้ว่าเป็นระเบียนเดียวกันทั้งในชุดต้นฉบับและชุดสังเคราะห์
นั่นหมายความว่าชุดข้อมูลสังเคราะห์แบ่งปันได้อย่างอิสระมากขึ้น โดยไม่เสี่ยงเปิดเผยข้อมูลลับอย่างไม่เหมาะสม ไม่ว่าจะเป็นธุรกรรมการเงินส่วนบุคคล ข้อมูลสุขภาพผู้ป่วย หรือข้อมูลที่จัดชั้นความลับ ตราบใดที่สถิติของข้อมูลไม่เป็นความลับ ฝาแฝดสังเคราะห์ก็ไม่เป็นความลับ
เหตุใด GEMINAI จึงเป็นโซลูชันที่ดีกว่าการใช้ความเป็นส่วนตัวเชิงอนุพันธ์?
ความเป็นส่วนตัวเชิงอนุพันธ์เป็นกลุ่มเทคนิคที่จำกัดความน่าจะเป็นที่บุคคลใดบุคคลหนึ่งจะส่งผลต่อสถิติมากกว่าระดับเล็กน้อย และเป็นองค์ประกอบพื้นฐานของโซลูชันความเป็นส่วนตัวของข้อมูลแทบทุกแบบ อย่างไรก็ตาม หากใช้เพียงความเป็นส่วนตัวเชิงอนุพันธ์ ต้องบริหารงบความเป็นส่วนตัวของข้อมูลและเติมสัญญาณรบกวนให้เพียงพอในทุกคำค้น เมื่อใช้งบหมดแล้ว จะนำข้อมูลมาใช้อีกไม่ได้หากไม่ยอมรับความเสี่ยงด้านความเป็นส่วนตัว
วิธีหนึ่งในการก้าวข้ามข้อจำกัดนี้คือใช้งบความเป็นส่วนตัวทั้งหมดในครั้งเดียว เพื่อฝึกโมเดลการเรียนรู้ของเครื่องให้สร้างข้อมูลสังเคราะห์ แนวคิดคือโมเดลที่ฝึกด้วยความเป็นส่วนตัวเชิงอนุพันธ์นี้จะใช้งานได้ค่อนข้างปลอดภัย แต่การนำความเป็นส่วนตัวเชิงอนุพันธ์ไปใช้อย่างถูกต้องอาจซับซ้อน โดยเฉพาะเมื่อแต่ละบุคคลมีปริมาณข้อมูลต่างกัน และมีความสัมพันธ์ที่ซับซ้อน เช่น คนที่อยู่บ้านเดียวกัน อีกทั้งข้อมูลสังเคราะห์ที่โมเดลสร้างอาจบังเอิญมีข้อมูลจริงซึ่งบุคคลหนึ่งอ้างว่าเป็นของตนได้เพราะคล้ายกันมากเกินไป
GEMINAI แก้ปัญหาเหล่านี้และปัญหาอื่นๆ ด้วยการรวมเทคนิคความเป็นส่วนตัวหลายแบบขณะสังเคราะห์ข้อมูล ระบบใช้ความเป็นส่วนตัวเชิงอนุพันธ์ในรูปแบบที่เหมาะกับการใช้งานจริงและรองรับข้อมูลได้หลากหลายประเภท โดยสร้างบนเอนจิน REACTOR จึงทราบความน่าจะเป็นที่ข้อมูลแต่ละส่วนจะสับสนกับข้อมูลอื่น และสร้างข้อมูลสังเคราะห์ให้แตกต่างจากข้อมูลต้นฉบับที่คล้ายที่สุดอย่างเพียงพอเสมอ นอกจากนี้ยังถือว่าทุกเขตข้อมูลและทุกชิ้นข้อมูลอาจมีความละเอียดอ่อนหรือระบุตัวตนได้ จึงใช้รูปแบบความเป็นส่วนตัวเชิงอนุพันธ์ที่เหมาะสมกับเขตข้อมูลที่ตามปกติไม่ถือว่าอ่อนไหว แต่อาจระบุตัวบุคคลได้เฉพาะเจาะจง เช่น ธุรกรรมเพียงรายการเดียวในร้านที่เปิดตลอด 24 ชั่วโมงระหว่างตีสองถึงตีสาม เรามักเรียกสิ่งนี้ว่าการทำลายข้อมูลระบุตัวตนแบบตัดขวาง
GEMINAI ให้ความแม่นยำสูงสำหรับแทบทุกวัตถุประสงค์ โดยข้อมูลดูคล้ายต้นฉบับ แต่ป้องกันไม่ให้ใครค้นพบข้อมูลสังเคราะห์ที่คล้ายกับข้อมูลสังเคราะห์มากเกินไป
Diveplane มีบทบาทสำคัญในการร่วมก่อตั้ง Data & Trust Alliance พันธมิตรนี้คืออะไร?
เป็นกลุ่มซีอีโอบริษัทเทคโนโลยีที่ยอดเยี่ยมอย่างยิ่ง ซึ่งร่วมมือกันพัฒนาและนำแนวปฏิบัติด้านข้อมูลและ AI ที่มีความรับผิดชอบมาใช้ ประกอบด้วยองค์กรระดับโลก เช่น IBM, Johnson&Johnson, Mastercard (MA ), UPS, Walmart (WMT ) และ Diveplane เราภูมิใจมากที่ได้มีส่วนร่วมตั้งแต่ช่วงแรก และภูมิใจกับผลงานที่เราร่วมกันทำในโครงการต่างๆ
Diveplane เพิ่งระดมทุนรอบ Series A ได้สำเร็จ สิ่งนี้มีความหมายอย่างไรต่ออนาคตของบริษัท?
เราโชคดีที่ประสบความสำเร็จกับโครงการระดับองค์กร แต่การเปลี่ยนโลกทีละองค์กรเป็นเรื่องยาก เราจะใช้การสนับสนุนนี้สร้างทีม เผยแพร่สารของเรา และนำ AI ที่เข้าใจได้ไปสู่สถานที่ต่างๆ ให้มากที่สุด!
มีอะไรเกี่ยวกับ Diveplane ที่คุณอยากแบ่งปันเพิ่มเติมหรือไม่?
Diveplane มุ่งทำให้แน่ใจว่า AI ถูกพัฒนาและใช้อย่างเหมาะสมขณะที่แพร่หลายออกไป เราสนับสนุน AI ที่เป็นธรรม โปร่งใส และเข้าใจได้ โดยแสดงเชิงรุกว่าอะไรขับเคลื่อนการตัดสินใจ และก้าวออกจากแนวคิดแบบกล่องดำใน AI ซึ่งอาจไม่เป็นธรรม ผิดจริยธรรม และมีอคติ เราเชื่อว่าความสามารถในการอธิบายได้คืออนาคตของ AI และยินดีที่จะมีบทบาทสำคัญในการผลักดันอนาคตนั้น!ขอบคุณสำหรับการสัมภาษณ์ที่ยอดเยี่ยม ผู้อ่านที่ต้องการทราบข้อมูลเพิ่มเติมสามารถเยี่ยมชม Diveplane.



