
สัมภาษณ์
มาร์ลอส ซี. มาชาโด้ อาจารย์สมทบแห่งมหาวิทยาลัยอัลเบอร์ตา นักวิจัย Amii และผู้ดำรงตำแหน่งศาสตราจารย์วิจัยด้าน AI ของ CIFAR – ชุดบทสัมภาษณ์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
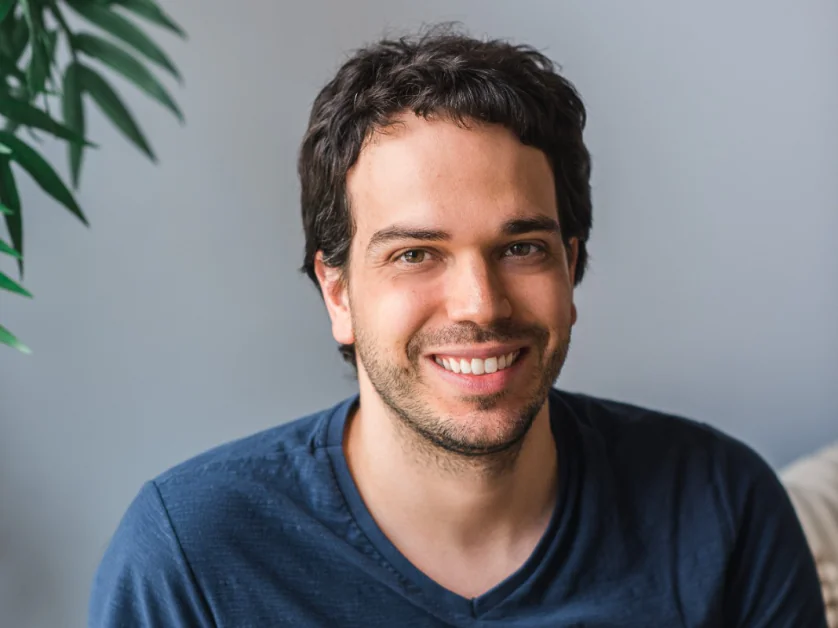
มาร์ลอส ซี. มาชาโด้ เป็นนักวิจัยประจำโครงการ Fellow in Residence ที่ Alberta Machine Intelligence Institute (Amii) อาจารย์สมทบแห่งมหาวิทยาลัยอัลเบอร์ตา และนักวิจัย Amii ผู้ดำรงตำแหน่งศาสตราจารย์วิจัย Canada CIFAR AI งานของเขาเน้นการเรียนรู้แบบเสริมกำลัง เขาจบปริญญาตรีและโทจาก UFMG ในบราซิล และปริญญาเอกจากมหาวิทยาลัยอัลเบอร์ตา ซึ่งเขาช่วยเผยแพร่แนวคิดการสำรวจที่ขยายช่วงเวลาโดยใช้สิ่งที่เรียกว่า options
เขาเป็นนักวิจัยที่ DeepMind ระหว่างปี 2021–2023 และ Google (GOOGL ) Brain ระหว่างปี 2019–2021 มีส่วนสำคัญในการพัฒนาการเรียนรู้แบบเสริมกำลัง โดยเฉพาะการใช้การเรียนรู้แบบเสริมกำลังเชิงลึกควบคุมบอลลูนของ Loon ในชั้นสตราโตสเฟียร์ ผลงานของเขาเผยแพร่ในวารสารและการประชุมชั้นนำ เช่น Nature, JMLR, JAIR, NeurIPS, ICML, ICLR และ AAAI และปรากฏใน BBC, Bloomberg TV, The Verge และ Wired
เราสัมภาษณ์กันที่การประชุม AI ประจำปี Upper Bound ปี 2023 ในเอดมันตัน รัฐแอลเบอร์ตา จัดโดย Amii หรือ Alberta Machine Intelligence Institute
คุณเน้นการเรียนรู้แบบเสริมกำลัง อะไรดึงดูดคุณสู่แมชชีนเลิร์นนิงแบบนี้?
ผมชอบแนวคิดการเรียนรู้ผ่านปฏิสัมพันธ์ มันเป็นธรรมชาติและในบางแง่คล้ายวิธีที่คนเรียนรู้ ผมไม่อยากทำให้ AI ดูเหมือนมนุษย์ แต่โดยสัญชาตญาณเราลองทำบางอย่าง พบผลที่ดีและไม่ดี แล้วเรียนรู้ทำสิ่งที่ให้ผลดีกว่า สิ่งที่น่าทึ่งคือเอเจนต์โต้ตอบกับโลกจริง ๆ ตั้งสมมติฐานและทดสอบได้
จึงค้นพบพฤติกรรมใหม่ได้ ตัวอย่างดังคือหมากที่ 37 ของ AlphaGo ที่สารคดีเรียกว่าสร้างสรรค์ ไม่เคยเห็นมาก่อนและทำให้ทุกคนตกตะลึง ไม่ได้มาจากข้อมูลสำเร็จรูป แต่ค้นพบผ่านปฏิสัมพันธ์ เราเห็นคล้ายกันในโครงการบอลลูนสตราโตสเฟียร์ของผม
เกิดพฤติกรรมที่ไม่มีใครคิดแต่ยอดเยี่ยม การเรียนรู้แบบเสริมกำลังเหมาะกับการค้นพบอย่างนี้เพราะโต้ตอบได้ คำถามที่ยากคือสมมติย้อนเหตุการณ์ว่า ถ้าทำอีกอย่างจะเกิดอะไรขึ้น? ในงานแมชชีนเลิร์นนิงหลายบริบททดสอบไม่ได้ แต่ที่นี่ลองทางเลือกในครั้งหน้าที่พบสถานการณ์เดิมได้ ผมชอบความโต้ตอบนี้มาก
แน่นอนว่าไม่ปฏิเสธแรงดึงดูดของการใช้งานที่น่าสนใจ แม้แต่ความสำเร็จสำคัญช่วงแรกเมื่อหลายสิบปีก่อนก็ทำให้สาขานี้น่าดึงดูด
การใช้งานยุคแรกที่คุณชอบที่สุดคืออะไร?
มีสองตัวอย่างดัง คือเฮลิคอปเตอร์ที่ Stanford ควบคุมด้วยการเรียนรู้แบบเสริมกำลัง และโปรแกรมแบ็กแกมมอน TD-Gammon ซึ่งเป็นแชมป์โลกในทศวรรษ 1990 ตอนทำปริญญาเอกผมจึงตั้งใจไปฝึกงานที่ IBM กับ Gerald Tesauro ผู้เป็นหัวหน้าโครงการ TD-Gammon มันยอดเยี่ยมมาก
ที่ตลกคือช่วงแรกผมยังไม่รู้ชัดว่าการเรียนรู้แบบเสริมกำลังคืออะไร ตอนสมัครเรียนต่อผมแค่อยากทำแมชชีนเลิร์นนิงทั่วไป อ่านคำอธิบายงานวิจัยในเว็บไซต์อาจารย์หลายคนและสนใจบางเรื่อง มองย้อนกลับไป ผมเลือกอาจารย์ดังในสาขานี้โดยไม่รู้จักสาขา ไม่ใช่เพราะชื่อเสียง แต่เพราะคำอธิบายงานน่าสนใจ เห็นเว็บไซต์ดีก็อยากทำงานกับเจ้าของ
คุณจึงค้นพบพวกเขาอย่างเป็นธรรมชาติ
ใช่ เมื่อย้อนดู พวกเขาคือคนที่ผมเคยสมัครไปทำงานด้วยนานแล้ว แม้ก่อนรู้ว่าตัวเองจะทำอะไร เมื่ออ่านคำอธิบายงานของคนอื่นในบทความ ผมก็คิดว่าควรอ่านต่อ ความสนใจพากลับสู่การเรียนรู้แบบเสริมกำลังเสมอ
ที่ Google Brain คุณทำการนำทางอัตโนมัติของบอลลูนสตราโตสเฟียร์ ทำไมจึงเหมาะกับการให้เน็ตในพื้นที่เข้าถึงยาก?
ผมไม่ใช่ผู้เชี่ยวชาญด้านนี้ นั่นเป็นแนวคิดของ Loon บริษัทลูกของ Alphabet (GOOG ) ปกติสร้างเสาอากาศ เช่น ในเอดมันตัน ให้ครอบคลุมรัศมีห้าหรือหกกิโลเมตร กลางนิวยอร์กอาจบริการหลายล้านคน แต่ชุมชนในป่าแอมะซอนที่มีสัก 50 คนอาจไม่คุ้มต้นทุนเสา และการเข้าพื้นที่ก็ยาก
ลงทุนโครงสร้างพื้นฐานใหญ่ในพื้นที่ห่างไกลคนเบาบางไม่คุ้มทางเศรษฐกิจ จึงคิดว่าถ้าเสาสูงมาก สัก 20 กิโลเมตรล่ะ? เราสร้างไม่ได้ แต่เอาบอลลูนขึ้นไปได้ รัศมีสิบเท่าหมายถึงพื้นที่ร้อยเท่า บอลลูนกลางป่าอาจบริการหลายชุมชนที่เดิมต้องมีเสาแยกกัน
นี่คือแรงจูงใจหนึ่ง ผมจำได้ว่าสโลแกน Loon ไม่ใช่เน็ตสำหรับพันล้านคนถัดไป แต่สำหรับพันล้านคนสุดท้าย ผู้เข้าถึงยากที่สุด เป็นความทะเยอทะยานสูง
คุณต้องแก้ปัญหาการนำทางอะไร?
บอลลูนไม่มีแรงขับ นำทางคล้ายบอลลูนลมร้อน ขึ้นหรือลงเพื่อหากระแสลมที่ไปทิศต้องการแล้วลอยตาม หากเปลี่ยนทิศก็เปลี่ยนระดับหาลมใหม่ แต่บอลลูนเหล่านี้ไม่ใช่ลมร้อน เป็นแบบปริมาตรคงที่บินในสตราโตสเฟียร์
ด้านการนำทางทำได้เพียงขึ้น ลง หรืออยู่ระดับเดิม แล้วหาลมที่เหมาะสม ความท้าทายมากมาย ต้องอยู่ในพื้นที่บริการอินเทอร์เน็ตพร้อมรักษาพลังงานจากแสงอาทิตย์ เป็นการหาค่าที่เหมาะสมหลายเป้าหมาย ทั้งตำแหน่งและประสิทธิภาพพลังงาน
คุณรู้ลมตรงที่อยู่ แต่ไม่รู้ลมสูงขึ้นไป 500 เมตร เรียกว่าการสังเกตได้เพียงบางส่วน มีพยากรณ์แต่ทิศอาจผิดถึง 90 องศา ปัญหามีมิติสูงมาก ทั้งชั้นลมหลายร้อย ความเร็ว ทิศ การจำลอง และความเชื่อมั่นหรือความไม่แน่นอนของพยากรณ์
เข้าใจยากและบอกให้คนอื่นเห็นความยากก็ยาก ไม่เห็นทุกมิติในหน้าจอ ต้องคิดลมและเวลาที่วัดครั้งล่าสุด พร้อมพลังงาน เวลาของวัน และจุดที่ต้องการไป มีมากพร้อมกัน
ระบบแมชชีนเลิร์นนิงศึกษาอะไร แค่รูปแบบลมและอุณหภูมิหรือ?
มีโมเดลลมที่ใช้แมชชีนเลิร์นนิง แต่ไม่ใช่การเรียนรู้แบบเสริมกำลัง Loon สร้างจากข้อมูลในอดีตที่ระดับต่างกันก่อน Google Brain เข้าร่วม ผมไม่ได้ทำส่วนนั้น โมเดลต้องประมาณค่าระหว่างระดับความสูงด้วย
อาจรู้ลมเมื่อสองปีก่อนที่ระดับหนึ่ง แต่ไม่รู้สูงขึ้นอีกสิบเมตร จึงเพิ่มกระบวนการเกาส์เซียน และมีบทความเรื่องคุณภาพโมเดล ฝั่งการเรียนรู้แบบเสริมกำลังเรามีตัวจำลองพลวัตบอลลูนที่ดีและตัวจำลองลมนี้ สมมติว่าอยู่ในปี 2010 ได้ มีข้อมูลลมทั่วโลกแบบหยาบของปีนั้น แล้วเพิ่มโมเดลและกระบวนการเกาส์เซียนเพื่อเติมค่าลม สามารถเพิ่มสัญญาณรบกวนหรือปรับรูปแบบอื่น
พลวัตบอลลูน ลม และการสมมติย้อนเวลา จึงรวมเป็นตัวจำลอง
เหมือนดิจิทัลทวินย้อนเวลา
ถูกต้อง เราออกแบบฟังก์ชันรางวัลให้คงใกล้เป้าหมายและใช้พลังงานมีประสิทธิภาพพอสมควร บอลลูนเรียนรู้โดยโต้ตอบกับโลกนี้ ทำได้ด้วยการใช้ข้อมูลอดีต เพราะอย่างอื่นเราไม่รู้วิธีจำลองสภาพอากาศและลมอย่างสมบูรณ์ จึงเรียนรู้ว่าควรขึ้น ลง หรืออยู่ เมื่อคำนึงสิ่งรอบตัว สุดท้ายเป้าหมายคือให้เน็ตแก่พื้นที่
การนำการเรียนรู้แบบเสริมกำลังไปใช้ในโลกจริงยากกว่าในเกมอย่างไร?
มีหลายเรื่อง ไม่จำเป็นต้องเป็นเกมเทียบโลกจริง แต่เป็นวิจัยพื้นฐานเทียบประยุกต์ เกมที่ส่งถึงผู้ใช้หลายล้านก็มีวิจัยประยุกต์ได้ ความยากหลักหนึ่งคืองานวิศวกรรม เกมใช้วิจัยเพราะมีคุณสมบัติที่สนใจภายใต้ขอบเขตชัดกว่า จึงวิจัยและตรวจสอบการเรียนรู้ในสภาพที่จำกัดและเข้าใจได้ดี
วิจัยไม่จำเป็นต้องต่างหมด แต่โลกจริงเพิ่มเรื่องเช่นความปลอดภัย ต้องแน่ใจว่าบอลลูนไม่ทำอะไรโง่ ๆ และเอเจนต์ไม่เรียนพฤติกรรมคาดไม่ถึงที่ส่งผลร้าย นี่คือความกังวลสูงสุดอย่างหนึ่ง ในเกมเลวร้ายสุดมักแค่แพ้
มีระบบเทคนิคทั้งผลิตภัณฑ์ด้วย นักวิจัยคนเดียวทดลองในเกมได้ง่าย แต่ในผลิตภัณฑ์ทำตามใจไม่ได้ ต้องเข้าใจส่วนอื่น ขนาดทีมก็ต่าง Loon มีหลายสิบหรืออาจหลายร้อยคน เราติดต่อไม่กี่คน แต่มีห้องควบคุมสื่อสารกับเจ้าหน้าที่การบิน
จึงมีผู้เกี่ยวข้องมากขึ้น นอกเหนือวิศวกรรมและความปลอดภัย สมมติฐานหลายอย่างของอัลกอริทึมไม่จริงในโลกจริงและต้องจัดการ โลกไม่เป็นมิตรเท่าเกมขอบเขตแคบที่คุณทำเอง
ตัวอย่างที่ชอบคือเราได้สิ่งจำเป็น ทำงานสัปดาห์หรือสอง แล้วกลับไปบอกวิศวกร Loon ว่าแก้ได้ด้วยความแม่นยำ 100% พวกเขายิ้มอย่างไม่เชื่อ บอกว่าเป็นไปไม่ได้เพราะบางครั้งไม่มีลมที่จำเป็น
พบว่าอัลกอริทึมพาบอลลูนไปกลางพื้นที่ แล้วขึ้นสูงจนแตก มันตกและอยู่ในพื้นที่ตลอดไป แน่นอนไม่ใช่สิ่งที่ต้องการ เกิดในตัวจำลอง หนึ่งในวิธีแก้คือห้ามสูงเกินระดับที่จะแตก
ข้อจำกัดจริงและการสัมพันธ์กับสิ่งอื่นอย่างนี้มองข้ามง่ายเมื่อวิจัยแค่เกม ในโลกจริงการกระทำมีผลและต้องรู้ นี่คือความยากหลัก
รอบทดลองยาวกว่ามาก เกมกดเล่นและอย่างช้าได้ผลในสัปดาห์ แต่ในสตราโตสเฟียร์ต้องทำสิ่งที่ผมเรียกว่าการทดสอบ A/B ของสตราโตสเฟียร์ เมื่อเชื่อมั่นในโซลูชันแล้วต้องพิสูจน์ว่าดีกว่าในทางสถิติ ผมคิดว่าเราให้บอลลูน 13 ลูกบินเหนือแปซิฟิกมากกว่าหนึ่งเดือนเพื่อตรวจสอบ ช่วงเวลายาวจึงมีโอกาสลองน้อยกว่า
ไม่เหมือนเกมที่รันหนึ่งล้านการทดลองแบบเดียวกันพร้อมกันได้
ใช่ ตอนฝึกใช้ตัวจำลอง แม้ช้ากว่าเกมมากแต่จัดการทางวิศวกรรมได้ ในโลกจริงต่างออกไป
ตอนนี้คุณวิจัยอะไร?
ผมอยู่มหาวิทยาลัยอัลเบอร์ตา มีกลุ่มวิจัยและนักศึกษาหลายคนที่ช่วยให้ทำเรื่องหลากหลาย สิ่งที่สนใจมากคือการเรียนรู้อย่างต่อเนื่อง ปกติคำนวณด้วยตัวจำลองหรือชุดข้อมูล ฝึกโมเดล นำไปใช้ แล้วหวังว่าดี บ่อยครั้งเหมาะสมแล้ว แต่บางครั้งโลกซับซ้อนเกินกว่าโมเดลใหญ่แค่ไหนจะรวมทุกอย่าง จึงต้องปรับตัว
โครงการหนึ่งคือโรงบำบัดน้ำ จะให้การเรียนรู้แบบเสริมกำลังช่วยมนุษย์ตัดสินใจหรือควบคุมเองอย่างไร? เรามีข้อมูล แต่คุณภาพน้ำเปลี่ยนในไม่กี่ชั่วโมง แม้ฝึกทุกวันด้วยข้อมูลเมื่อวาน โมเดลอาจใช้ไม่ได้ภายในไม่กี่ชั่วโมง เพราะการกระจายข้อมูลเปลี่ยน ไม่คงที่ อาจมีไฟป่าต้นน้ำหรือหิมะเริ่มละลาย ถ้าจะครอบคลุมทั้งหมดต้องจำลองทั้งโลก
ไม่มีใครทำอย่างนั้น มนุษย์ก็ไม่ เราปรับตัวและเรียนใหม่เมื่อวิธีเก่าไม่ทำงาน หลายงานจริงต้องเรียนตลอด แต่ปกติพูดถึงการคำนวณก้อนใหญ่ ใช้โมเดล แล้วอัปเดตในอีกหลายวันหรือสัปดาห์ บางครั้งช่วงเวลานั้นไม่เหมาะ
คำถามคือจะเรียนตลอดไป ปรับปรุงและปรับตัวอย่างไร? ยากมาก เรามีบทความเรื่องนี้และวิธีปัจจุบันยังไม่พอ แม้โซลูชันชั้นนำก็แย่ลงเร็วหากเรียนต่อแทนหยุดฝึกและใช้โมเดลคงที่ หลังความสำเร็จของโมเดลคงที่ ซึ่งจะใช้ต่อไป การเรียนต่อเนื่องคือแนวหน้าวิจัยหนึ่ง
การเรียนรู้แบบเสริมกำลังเหมาะเพราะอัลกอริทึมหลายแบบประมวลข้อมูลขณะเข้ามา จึงเข้ากับการเรียนต่อเนื่องโดยธรรมชาติ ไม่ได้แปลว่าทำได้หรือทำดีแล้ว มีคำถามวิจัยน่าสนใจมาก
การใช้งานการเรียนรู้ต่อเนื่องในอนาคตแบบใดน่าตื่นเต้นที่สุด?
นี่คือคำถามพันล้านดอลลาร์ เพราะผมกำลังมองหาการใช้งานนั้น การตั้งคำถามถูกคือมากกว่าครึ่งของวิจัย ผมชอบให้ปัญหานำ เช่น มีบอลลูนห้าลูกในสตราโตสเฟียร์ จะทำอย่างไร? ระหว่างทางเกิดความก้าวหน้าวิทยาศาสตร์ ผมทำกับ Adam White และ Martha White ในโครงการบำบัดน้ำที่พวกเขาเป็นผู้นำ น่าสนใจเพราะแค่บรรยายด้วยภาษายังยาก ความสำเร็จด้านภาษาปัจจุบันใช้ตรง ๆ ไม่ได้
ความขุ่นและอุณหภูมิน้ำเปลี่ยนบ่อยและต่างช่วงเวลา จำเป็นต้องเรียนต่อเนื่อง ผลทางสังคมมหาศาล ยากจะคิดสิ่งสำคัญกว่าน้ำดื่ม ในพื้นที่คนเบาบางอย่างตอนเหนือแคนาดา บางครั้งไม่มีคนเดินระบบด้วยซ้ำ ไม่ใช่จำเป็นต้องแทนที่คน แต่ทำให้สิ่งที่ขาดบุคลากรหรือกำลังทำได้
เป็นปัญหาวิจัยยากมากและมีโอกาสส่งผลต่อสังคม เราไม่มีตัวจำลองหรือทรัพยากรหา จึงต้องใช้ข้อมูลให้ดีที่สุดและเรียนเมื่อข้อมูลมา อีกเรื่องที่ผมยังไม่ได้ทำมากคือการทำความเย็นอาคาร เกี่ยวกับอากาศและการเปลี่ยนภูมิอากาศด้วย จะตัดสินอย่างไร? วันนี้ที่นี่มีหลายร้อยคน ไม่เหมือนสัปดาห์ก่อน ต้องใช้นโยบายเดิมไหม? มักมีอย่างมากแค่เทอร์โมสตัท เราฉลาดและปรับตัวได้มากขึ้น รวมทั้งเมื่อห้องหนึ่งคนมาก อีกห้องคนน้อย
ระบบควบคุมมิติสูงที่คิดตามยากแบบนี้มีโอกาสทำได้ดีกว่าวิธีมาตรฐานปัจจุบันมาก
บางพื้นที่ไฟฟ้าถึง 75% ใช้กับเครื่องปรับอากาศ จึงสมเหตุสมผลมาก
ใช่ มีผลิตภัณฑ์ในบ้านที่ใช้แมชชีนเลิร์นนิงและเรียนจากลูกค้าอยู่แล้ว ในอาคารใหญ่ทำได้ละเอียดขึ้น ฟลอริดา บราซิล และหลายที่ต้องการ การทำความเย็นศูนย์ข้อมูลเป็นอีกตัวอย่างที่บางบริษัทเริ่มทำ ฟังเหมือนนิยายวิทยาศาสตร์ แต่การเรียนและปรับตามความต้องการตลอดส่งผลมากต่อปัญหาควบคุมมิติสูง
ในโครงการบอลลูนเราแสดงว่าการเรียนรู้แบบเสริมกำลัง โดยเฉพาะเชิงลึก เรียนการตัดสินใจจากเซนเซอร์ที่ซับซ้อนกว่ามนุษย์ออกแบบได้ คนอาจใช้เส้นตอบสนองเชิงเส้นหรือกำลังสอง แต่โครงข่ายประสาทเรียนความไม่เป็นเชิงเส้นทั้งหมดและให้การตัดสินใจละเอียดและบางครั้งมีประสิทธิภาพมาก
ขอบคุณสำหรับการสัมภาษณ์ที่ยอดเยี่ยม ผู้อ่านที่ต้องการรู้เพิ่มเติมเยี่ยมชมแหล่งข้อมูลต่อไปนี้ได้:


