
โมเดลและแพลตฟอร์ม AI
ปัญญาประดิษฐ์เชิงกำเนิด: แนวคิดเบื้องหลัง ChatGPT, Dall-E, Midjourney และอื่น ๆ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญแบบจำลอง AI สร้างสรรค์ เช่น GPT-4 สร้างเนื้อหาใหม่จากรูปแบบข้อมูล…
ดูเพิ่มเติม
- แบบจำลอง AI สร้างสรรค์ เช่น GPT-4 สร้างเนื้อหาใหม่จากรูปแบบข้อมูล แทนที่จะเพียงทำนายผลลัพธ์
- กลไกความสนใจ (attention mechanism) ของโครงสร้างทรานส์ฟอร์มเมอร์ ช่วยให้ AI โฟกัสส่วนข้อความที่เกี่ยวข้อง เพื่อสร้างภาษาที่ดีเยี่ยม
- แบบจำลองดิฟฟิวชัน เช่น DALL-E 2 ปรับแต่งสัญญาณรบกวนให้เป็นภาพอย่างต่อเนื่อง โดยใช้ข้อความชี้นำ
โลกศิลปะ การสื่อสาร และวิธีที่เรารับรู้ความจริงกำลังเปลี่ยนอย่างรวดเร็ว หากมองประวัติศาสตร์นวัตกรรมมนุษย์ เราอาจเห็นการประดิษฐ์ล้อหรือการค้นพบไฟฟ้าเป็นก้าวกระโดดสำคัญ วันนี้มีการปฏิวัติใหม่ที่เชื่อมความคิดสร้างสรรค์ของมนุษย์กับการคำนวณของเครื่องจักร นั่นคือ Generative AI หรือปัญญาประดิษฐ์เชิงกำเนิด
โมเดลเชิงกำเนิดทำให้เส้นแบ่งระหว่างมนุษย์กับเครื่องจักรพร่าเลือน GPT-4 ซึ่งใช้โมดูล Transformer ทำให้เราเข้าใกล้การสร้างภาษาที่เป็นธรรมชาติและเข้าใจบริบทมากขึ้น ความก้าวหน้านี้นำไปสู่การสร้างเอกสาร ระบบสนทนา และแม้แต่การแต่งเพลงสังเคราะห์
การตัดสินใจล่าสุดของบริษัทเทคโนโลยียักษ์ใหญ่ยืนยันความสำคัญนี้ Microsoft (MSFT ) กำลังยุติแอป Cortanaในเดือนนี้ เพื่อให้ความสำคัญกับนวัตกรรม Generative AI ใหม่ เช่น Bing Chat ขณะที่ Tim Cook ซีอีโอ Apple (AAPL ) ระบุว่าบริษัทจัดสรรส่วนสำคัญของงบวิจัยและพัฒนา 22.6 พันล้านดอลลาร์ให้กับ Generative AI
ยุคใหม่ของโมเดล: โมเดลเชิงกำเนิดกับโมเดลจำแนก
เรื่องราวของ Generative AI ไม่ได้มีเพียงการใช้งาน แต่รวมถึงกลไกภายในด้วย ในระบบนิเวศ AI มีโมเดลสองประเภท คือแบบจำแนกและแบบเชิงกำเนิด
โมเดลจำแนกเป็นสิ่งที่ผู้คนพบในชีวิตประจำวัน อัลกอริทึมรับข้อความหรือภาพ แล้วเชื่อมกับผลลัพธ์เป้าหมาย เช่น คำแปลหรือการวินิจฉัยโรค เน้นการจับคู่และพยากรณ์
โมเดลเชิงกำเนิดเป็นผู้สร้าง ไม่เพียงตีความหรือพยากรณ์ แต่สร้างผลลัพธ์ใหม่ที่ซับซ้อนจากเวกเตอร์ตัวเลข ซึ่งบ่อยครั้งไม่ได้สัมพันธ์โดยตรงกับค่าในโลกจริง

เทคโนโลยีเบื้องหลังโมเดลเชิงกำเนิด
โมเดลเชิงกำเนิดอาศัยโครงข่ายประสาทเทียมเชิงลึก ซึ่งออกแบบให้เลียนแบบการทำงานของสมอง โครงข่ายเหล่านี้จับและประมวลผลความหลากหลายหลายมิติในข้อมูล จึงเป็นแกนหลักของโมเดลจำนวนมาก
โดยทั่วไปจะสร้างด้วยโครงข่ายที่ปรับให้เหมาะกับความหลากหลายของข้อมูล ตัวอย่างสำคัญคือเครือข่ายเชิงกำเนิดแบบปฏิปักษ์ (GAN) ซึ่งมีสองโครงข่าย ได้แก่ ตัวสร้างและตัวจำแนก ที่แข่งขันและเรียนรู้จากกันในความสัมพันธ์แบบครูกับนักเรียน ตั้งแต่ภาพวาด การถ่ายโอนสไตล์ การแต่งเพลง จนถึงการเล่นเกม โมเดลเหล่านี้พัฒนาในแบบที่เคยยากจะจินตนาการ
นอกจาก GAN ยังมีVariational Autoencoder (VAE) ซึ่งเป็นอีกกลุ่มสำคัญ สามารถสร้างภาพเสมือนจริงจากตัวเลขที่ดูเหมือนสุ่ม โดยประมวลผลตัวเลขผ่านเวกเตอร์แฝงเพื่อสร้างภาพที่สะท้อนความซับซ้อนของสุนทรียภาพมนุษย์
ประเภท Generative AI: ข้อความเป็นข้อความ และข้อความเป็นภาพ
Transformer และโมเดลภาษาขนาดใหญ่
บทความ “Attention Is All You Need” ของ Google (GOOGL ) Brain เปลี่ยนแนวคิดการสร้างโมเดลข้อความ แทนสถาปัตยกรรมซับซ้อนที่ประมวลผลตามลำดับ เช่น RNN หรือ CNN โมเดล Transformer เสนอ attention ซึ่งมุ่งที่ส่วนต่าง ๆ ของข้อความตามบริบท ข้อดีสำคัญคือทำงานขนานได้ง่าย ต่างจาก RNN ที่ประมวลผลทีละส่วนและขยายขนาดได้ยาก Transformer จัดการหลายส่วนพร้อมกันได้ จึงฝึกด้วยข้อมูลขนาดใหญ่ได้เร็วและมีประสิทธิภาพขึ้น

- โมเดล Transformer: สถาปัตยกรรม
ข้อความยาวไม่ได้มีทุกคำหรือทุกประโยคสำคัญเท่ากัน บริบททำให้บางส่วนต้องได้รับความสนใจมากกว่า กลไก attention เลียนแบบการเปลี่ยนจุดสนใจตามความเกี่ยวข้องนี้
ลองดูประโยค “Unite AI Publish AI and Robotics news” การพยากรณ์คำถัดไปต้องเข้าใจว่าส่วนใดในบริบทสำคัญ “Robotics” อาจบอกว่าจะกล่าวถึงความก้าวหน้าหรือเหตุการณ์ด้านหุ่นยนต์ ขณะที่ “Publish” อาจชี้ถึงสิ่งพิมพ์หรือบทความล่าสุด
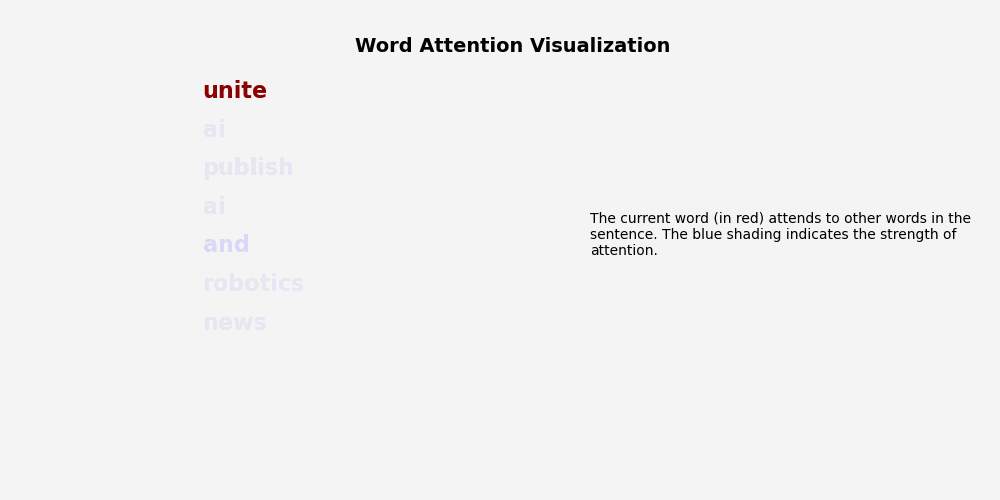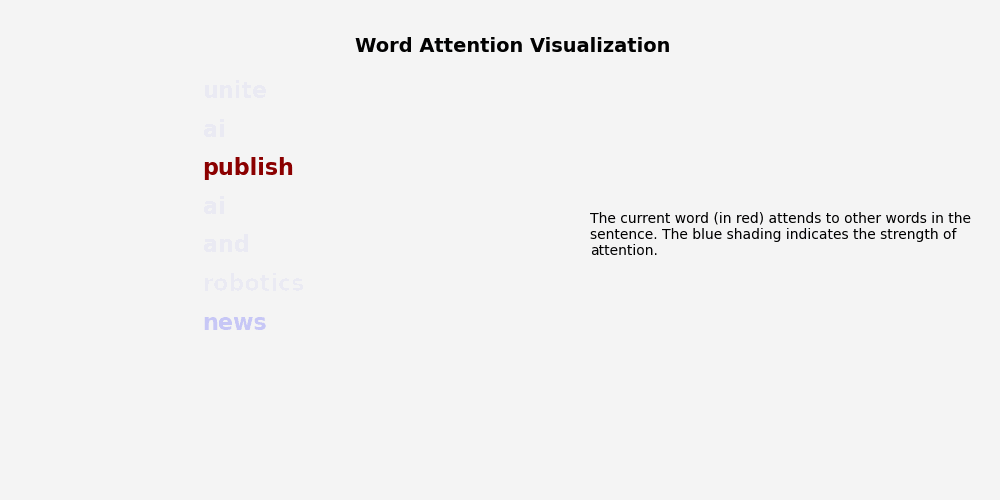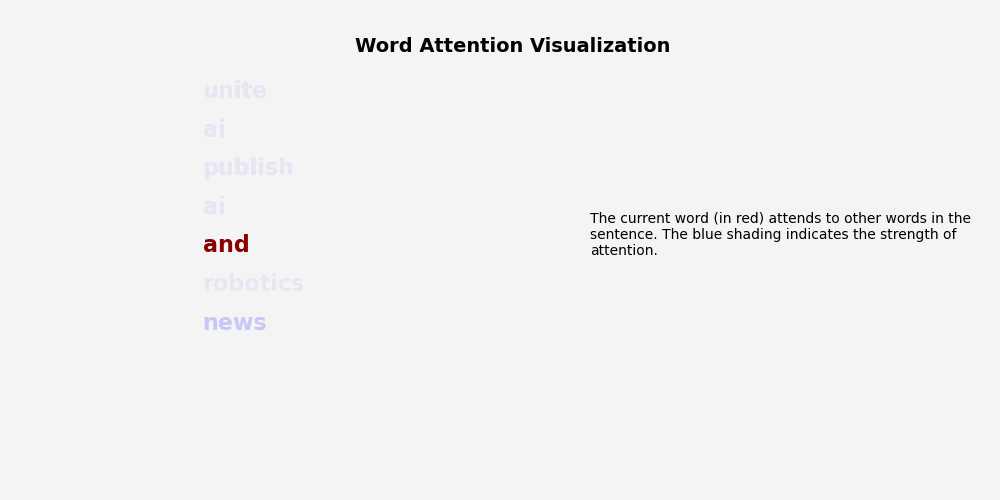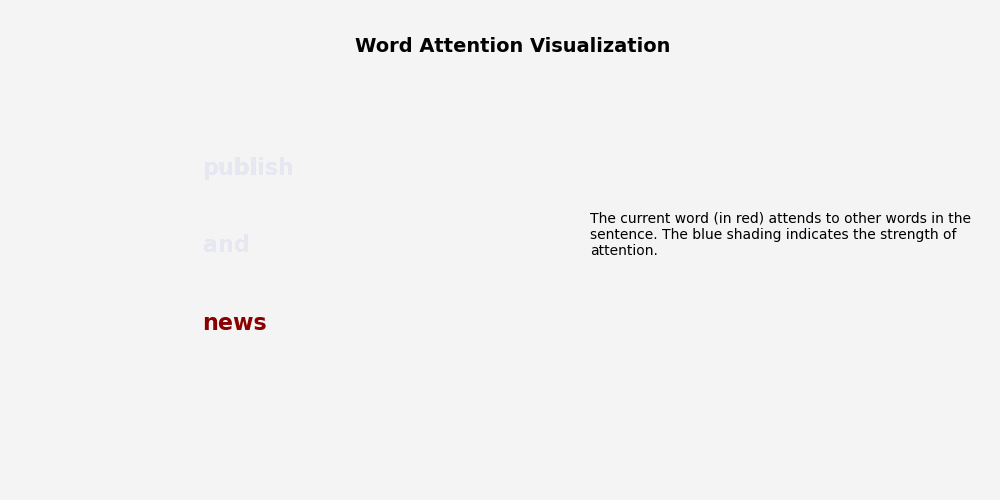
- ภาพอธิบายกลไก Self-Attention
Attention ใน Transformer ประเมินความสำคัญของส่วนต่าง ๆ ของข้อความ และเลือกว่าจะ “มอง” ที่ไหนเมื่อสร้างคำตอบ ต่างจาก RNN รุ่นเก่าที่พยายามอัดใจความทั้งหมดไว้ในสถานะหรือความจำเดียว
การทำงานคล้ายระบบค้นคืนแบบคีย์และค่า เมื่อต้องพยากรณ์คำถัดไป คำก่อนหน้าแต่ละคำให้คีย์ที่บอกความเกี่ยวข้อง หากคีย์เข้ากับบริบทปัจจุบันหรือ query ก็จะให้ค่าหรือน้ำหนักต่อการพยากรณ์
โมเดลดีปเลิร์นนิงเหล่านี้อยู่ในหลายแอปพลิเคชัน ตั้งแต่ BERT ที่ปรับปรุงการค้นหาของ Google ไปจนถึง GitHub Copilot ที่ใช้ LLM เปลี่ยนส่วนโค้ดง่าย ๆ เป็นซอร์สโค้ดที่ทำงานได้
LLM เช่น GPT-4, Bard และ LLaMA ถูกสร้างให้เข้าใจและสร้างภาษามนุษย์ โค้ด และเนื้อหาอื่น ๆ ขนาดตั้งแต่หลายพันล้านถึงล้านล้านพารามิเตอร์เป็นลักษณะสำคัญ โมเดลรับข้อความมหาศาลเพื่อเรียนรู้ความละเอียดของภาษา และมีความสามารถเด่นด้านการเรียนรู้แบบ “ใช้ตัวอย่างน้อย” ต่างจากโมเดลเดิมที่ต้องมีข้อมูลฝึกเฉพาะงานจำนวนมาก LLM สามารถสรุปแบบแผนจากตัวอย่างเพียงไม่กี่รายการได้
สถานะโมเดลภาษาขนาดใหญ่หลังช่วงกลางปี 2023
| ชื่อโมเดล | ผู้พัฒนา | จำนวนพารามิเตอร์ | ความพร้อมใช้งานและการเข้าถึง | คุณสมบัติสำคัญและหมายเหตุ |
| GPT-4 | OpenAI | 1.5 ล้านล้าน | ไม่ใช่โอเพนซอร์ส เข้าถึงผ่าน API เท่านั้น | ทำงานได้ดีในหลายประเภท ประมวลผลภาพและข้อความได้ รองรับข้อมูลเข้ายาวสูงสุด 32,768 โทเคน |
| GPT-3 | OpenAI | 175 พันล้าน | ไม่ใช่โอเพนซอร์ส เข้าถึงผ่าน API เท่านั้น | แสดงความสามารถเรียนรู้จากตัวอย่างน้อยและไม่มีตัวอย่าง เติมข้อความภาษาธรรมชาติได้ |
| BLOOM | BigScience | 176 พันล้าน | ดาวน์โหลดโมเดลได้ และมี API ที่ให้บริการบนเซิร์ฟเวอร์ | LLM หลายภาษาที่พัฒนาจากความร่วมมือทั่วโลก รองรับ 13 ภาษาโปรแกรม |
| LaMDA | 173 พันล้าน | ไม่ใช่โอเพนซอร์ส ไม่มี API หรือการดาวน์โหลด | ฝึกจากบทสนทนา สามารถเรียนรู้ที่จะสนทนาได้แทบทุกเรื่อง | |
| MT-NLG | Nvidia /Microsoft | 530 พันล้าน | เข้าถึง API โดยยื่นคำขอ | ใช้สถาปัตยกรรม Megatron ที่อิง Transformer สำหรับงานประมวลผลภาษาธรรมชาติหลายประเภท |
| LLaMA | Meta AI | 7–65 พันล้าน | ดาวน์โหลดได้โดยยื่นคำขอ | มุ่งเปิดโอกาสเข้าถึง AI แก่นักวิจัย ภาครัฐ และวงการวิชาการ |
LLM ใช้งานอย่างไร?
ใช้งานได้หลายแบบ เช่น:
- ใช้โดยตรง: นำ LLM ที่ฝึกแล้วมาสร้างหรือประมวลผลข้อความ เช่น ใช้ GPT-4 เขียนบทความบล็อกโดยไม่ปรับแต่งเพิ่มเติม
- ปรับแต่งเฉพาะงาน: ปรับโมเดลที่ฝึกแล้วให้เหมาะกับงานหนึ่ง เป็นวิธีที่เรียกว่าการเรียนรู้แบบถ่ายโอน เช่น ปรับ T5 ให้สรุปเอกสารในอุตสาหกรรมเฉพาะ
- ค้นคืนข้อมูล: ใช้ BERT หรือ GPT เป็นส่วนหนึ่งของสถาปัตยกรรมใหญ่ เพื่อสร้างระบบค้นหาและจัดหมวดหมู่ข้อมูล

- สถาปัตยกรรมการปรับแต่ง ChatGPT
Multi-Head Attention: ทำไมต้องมีเพียงหัวเดียวเมื่อมีหลายหัวได้?
Attention กลไกเดียวอาจมีข้อจำกัด คำหรือข้อความแต่ละช่วงมีความเกี่ยวข้องหลายแบบ Multi-head attention ใช้น้ำหนักหลายชุดแทนชุดเดียว จึงจับความสัมพันธ์ในข้อมูลได้หลากหลายขึ้น แต่ละหัวมุ่งคนละส่วนหรือคนละแง่มุม แล้วรวมความรู้เพื่อสร้างการพยากรณ์สุดท้าย
ChatGPT: เครื่องมือ Generative AI ที่ได้รับความนิยมสูงสุด
GPT ในปี 2018 มี 12 ชั้น 12 หัว attention และ 120 ล้านพารามิเตอร์ ฝึกหลัก ๆ ด้วย BookCorpus เป็นจุดเริ่มต้นที่แสดงอนาคตของโมเดลภาษา
GPT-2 ในปี 2019 เพิ่มจำนวนชั้นและหัว attention สี่เท่า และมี 1.5 พันล้านพารามิเตอร์ ฝึกด้วย WebText ซึ่งมีข้อความ 40 GB จากลิงก์ Reddit หลายแหล่ง
GPT-3 เปิดตัวเดือนพฤษภาคม 2020 มี 96 ชั้น 96 หัว attention และ 175 พันล้านพารามิเตอร์ ใช้ข้อมูลหลากหลาย ได้แก่ CommonCrawl, WebText, Wikipedia ภาษาอังกฤษ คลังหนังสือ และแหล่งอื่น รวม 570 GB
รายละเอียดการทำงาน ChatGPT ยังเป็นความลับ แต่ทราบว่าการเรียนรู้แบบเสริมกำลังจากข้อเสนอแนะของมนุษย์หรือ RLHF มีบทบาทสำคัญ เทคนิคที่มาจากโครงการ ChatGPT ก่อนหน้านี้ช่วยปรับ GPT-3.5 ให้ทำตามคำสั่งลายลักษณ์อักษรได้ดีขึ้น
การฝึก ChatGPT มีสามขั้น:
- การปรับแต่งแบบมีผู้สอน: คัดเลือกข้อความสนทนาขาเข้าและขาออกที่มนุษย์เขียน เพื่อปรับโมเดล GPT-3.5 พื้นฐาน
- การสร้างโมเดลรางวัล: มนุษย์จัดอันดับคุณภาพผลลัพธ์ เพื่อฝึกโมเดลที่ให้คะแนนคำตอบโดยคำนึงถึงบริบทสนทนา
- การเรียนรู้แบบเสริมกำลัง: โมเดลพื้นฐานเสนอคำตอบตามบริบท โมเดลรางวัลประเมินคำตอบ และปรับปรุงกระบวนการด้วยอัลกอริทึม Proximal Policy Optimization หรือ PPO
ผู้เริ่มใช้ ChatGPT ดูคู่มือเบื้องต้นได้ที่นี่ ส่วนผู้ที่สนใจการเขียนพรอมป์เชิงลึก เรามีคู่มือเทคนิคล่าสุดและขั้นสูงชื่อ “ChatGPT และการเขียนพรอมป์ขั้นสูง: ขับเคลื่อนวิวัฒนาการ AI”
โมเดล Diffusion และโมเดลหลายรูปแบบ
VAE และ GAN สร้างผลลัพธ์ในการประมวลผลรอบเดียวจึงผูกกับผลนั้น แต่โมเดล diffusion ใช้แนวคิด “ปรับปรุงซ้ำ” โดยกลับไปแก้ข้อผิดพลาดจากขั้นก่อนหน้าและค่อย ๆ ได้ผลลัพธ์ที่ดีขึ้น
แกนหลักคือ “การทำให้ข้อมูลเสียสภาพ” และการฟื้นสภาพ ระหว่างฝึกจะค่อย ๆ เติม noise ให้ภาพในระดับต่าง ๆ แล้วให้โมเดลกำจัด noise การทำซ้ำช่วยให้เรียนรู้การคืนสภาพและเข้าใจความผิดเพี้ยนทั้งเล็กและใหญ่

- ภาพที่สร้างด้วย Midjourney
หลังฝึก การสร้างภาพเริ่มจากข้อมูลสุ่มทั้งหมด แล้วค่อยปรับด้วยการพยากรณ์ของโมเดล เป้าหมายคือได้ภาพสะอาดด้วยจำนวนขั้นน้อยที่สุด ตาราง noise ควบคุมปริมาณ noise ในแต่ละช่วง ตัวจัดตารางในไลบรารี เช่น “diffusers” กำหนดลักษณะข้อมูลที่มี noise ตามอัลกอริทึมที่วางไว้
สถาปัตยกรรมสำคัญของหลายโมเดล diffusion คือU-Net ซึ่งเป็นโครงข่ายประสาทแบบคอนโวลูชันสำหรับงานที่ผลลัพธ์ต้องสะท้อนมิติเชิงพื้นที่ของข้อมูลเข้า ประกอบด้วยชั้นลดและเพิ่มความละเอียดที่เชื่อมกันเพื่อรักษาข้อมูลความละเอียดสูง ซึ่งสำคัญต่อภาพ
DALL-E 2 ของ OpenAI เป็นตัวอย่างการผสาน AI ด้านข้อความและภาพ โดยมีสถาปัตยกรรมสามขั้น:
- ตัวเข้ารหัสข้อความ: เปลี่ยนพรอมป์เป็นเวกเตอร์แนวคิดในปริภูมิแฝง ไม่ได้เริ่มจากศูนย์ แต่อาศัยข้อมูล Contrastive Language–Image Pre-training หรือ CLIP ของ OpenAI CLIP เชื่อมข้อมูลภาพกับข้อความ โดยเรียนรู้แนวคิดภาพผ่านภาษาธรรมชาติ และใช้การเรียนรู้แบบเปรียบต่างเพื่อจับคู่ภาพกับคำบรรยาย
- โมเดล prior: เปลี่ยนเวกเตอร์ข้อความเป็นเวกเตอร์ภาพ DALL-E 2 ทดลองทั้งวิธี autoregressive และ diffusion โดย diffusion ให้ผลดีกว่า โมเดล autoregressive เช่น Transformer และ PixelCNN สร้างผลลัพธ์ตามลำดับ ส่วน diffusion ของ DALL-E 2 เปลี่ยน noise สุ่มเป็นเวกเตอร์ภาพที่พยากรณ์ โดยมีเวกเตอร์ข้อความช่วยกำกับ
- ตัวถอดรหัส: สร้างภาพสุดท้ายจากพรอมป์และเวกเตอร์ภาพในขั้นก่อนหน้า สถาปัตยกรรมอาศัยGLIDE ซึ่งสร้างภาพสมจริงจากข้อความได้เช่นกัน

- สถาปัตยกรรม DALL-E แบบย่อ
ผู้ใช้ Python ที่สนใจLangChain สามารถดูบทเรียนละเอียดตั้งแต่พื้นฐานจนถึงเทคนิคขั้นสูงของเรา
การประยุกต์ Generative AI
ด้านข้อความ
แชตบอต เช่นChatGPT เปลี่ยนแปลง Generative AI ด้านข้อความอย่างมาก อาศัย NLP และ LLM เพื่อสร้างโค้ด แปลภาษา สรุป และวิเคราะห์ความรู้สึก ChatGPT มีผู้ใช้นับล้าน ขณะที่แพลตฟอร์มสนทนาที่ใช้ GPT-4, PaLM และ BLOOM สามารถสร้างข้อความ ช่วยเขียนโปรแกรม และให้เหตุผลทางคณิตศาสตร์
ในเชิงธุรกิจ โมเดลเหล่านี้มีคุณค่าในการบริหารความเสี่ยง ปรับสินค้าคงคลัง และพยากรณ์อุปสงค์ ตัวอย่างสำคัญคือ Bing AI, Google BARD และ ChatGPT API
ศิลปะ
Generative AI เปลี่ยนโลกภาพอย่างมาก โดยเฉพาะหลัง DALL-E 2 เปิดตัวในปี 2022 การสร้างภาพจากข้อความมีผลทั้งต่อศิลปะและงานอาชีพ Midjourney ใช้เทคโนโลยีนี้สร้างภาพสมจริงอย่างน่าประทับใจ คู่มือล่าสุดของเราอธิบาย Midjourney และเทคนิคพรอมป์อย่างละเอียด ส่วน Alpaca AI และ Photoroom AI ใช้ Generative AI เพื่อแก้ไขภาพขั้นสูง เช่น ลบพื้นหลัง ลบวัตถุ และฟื้นฟูใบหน้า
การผลิตวิดีโอ
แม้ยังเป็นช่วงเริ่มต้น แต่ Generative AI สำหรับวิดีโอมีพัฒนาการน่าสนใจ Imagen Video, Meta Make A Video และ Runway Gen-2 กำลังขยายขอบเขต แม้ผลลัพธ์สมจริงอย่างแท้จริงยังต้องพัฒนาต่อ โมเดลเหล่านี้ช่วยสร้างวิดีโอบุคคลดิจิทัล เช่น Synthesia และ SuperCreator ส่วน Tavus AI มีจุดเด่นในการปรับวิดีโอให้เหมาะกับผู้ชมแต่ละคน ซึ่งมีประโยชน์ต่อธุรกิจ
การสร้างโค้ด
การเขียนโค้ดซึ่งสำคัญต่อโลกดิจิทัลก็ได้รับอิทธิพลจาก Generative AI นอกจาก ChatGPT ยังมี GitHub Copilot, Alphacode และ CodeComplete เป็นผู้ช่วยเขียนโค้ดและสร้างโค้ดจากข้อความได้ เครื่องมือเหล่านี้ปรับตัวได้ เช่น Codex ที่อยู่เบื้องหลัง GitHub Copilot สามารถปรับให้เข้ากับสไตล์การเขียนโค้ดของแต่ละคน แสดงศักยภาพด้านการปรับเฉพาะบุคคล
สรุป
การผสานความคิดสร้างสรรค์ของคนกับการคำนวณของเครื่องทำให้ Generative AI เป็นเครื่องมือที่มีคุณค่า ChatGPT และ DALL-E 2 ขยายขอบเขตสิ่งที่เป็นไปได้ ตั้งแต่สร้างข้อความจนถึงผลงานภาพ การใช้งานกว้างและหลากหลาย
เช่นเดียวกับทุกเทคโนโลยี ผลด้านจริยธรรมสำคัญมาก แม้จะเปิดโอกาสสร้างสรรค์ไร้ขอบเขต ก็ต้องใช้อย่างรับผิดชอบ โดยตระหนักถึงอคติที่อาจเกิดและพลังของการบิดเบือนข้อมูล
เมื่อ ChatGPT และเครื่องมืออื่นเข้าถึงได้ง่ายขึ้น นี่เป็นเวลาที่ดีที่จะทดลอง ไม่ว่าจะเป็นศิลปิน นักเขียนโค้ด หรือผู้สนใจเทคโนโลยี Generative AI มีโอกาสให้สำรวจมากมาย การปฏิวัติไม่ได้อยู่ไกล แต่มาถึงแล้ว เริ่มลองกันได้เลย!


