
มุมมองของ Anderson
AI สามารถเดาได้ว่าภาพถ่ายถ่ายเมื่อปีไหนจากอายุของคนในภาพ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
งานวิจัยใหม่แสดงว่า AI สามารถใช้ใบหน้าของบุคคลเพื่อประมาณปีที่ถ่ายภาพ โดยรวมการคาดอายุกับปีเกิดที่ทราบ และทำได้ดีกว่าวิธีที่พิจารณาฉาก
ในอดีตการเดาปีของภาพง่ายกว่าปัจจุบัน เพราะทรงผมและเสื้อผ้าเปลี่ยนเร็วมาก ด้วยเหตุผลที่ยังถกเถียงกัน การหมุนเวียนของสไตล์ภาพชะลอลงเมื่อราวสามสิบปีก่อน จึงยากขึ้นที่จะใช้ผมหรือเสื้อผ้าเดาปี
ครั้งหนึ่งยังพอระบุยุคจากความละเอียดสีและลักษณะเกรนของฟิล์มได้ ไม่ต้องเป็นผู้เชี่ยวชาญนิติเวช หากดูหนังเก่ามากพอ เบาะแสทางวัฒนธรรม เช่น เพลง รถ แฟชั่น และหัวข้อเรื่อง จะเชื่อมโยงในความทรงจำกับรูปแบบฟิล์มแต่ละยุค

การพัฒนาฟิล์มค่อยๆ ขยายช่วงโทนผิวและรูปแบบแสง จากการจัดแสงแบนตรงหน้าไปสู่ภาพที่เป็นธรรมชาติและหลากหลายขึ้น ที่มา
ภาพขาวดำเคยเป็นหลักยึดอีกอย่างหนึ่งในการระบุปี แต่หมดความหมายหลังภาพดิจิทัลแพร่หลายในช่วงต้นศตวรรษนี้ ระบบเชิงพาณิชย์และทดลองหลายแบบ เช่น PhotoDater ในแพ็กเกจสมาชิกของ MyHeritage พยายามใช้เกณฑ์เหล่านี้และข้อมูลอื่นเพื่อประเมินอายุภาพ

ตัวอย่างการประมาณอายุภาพจากบริการ PhotoDater สำหรับสมาชิก MyHeritage ที่มา
หากไม่มีสมาร์ทโฟนหรือเทคโนโลยีเฉพาะยุค วิธีที่ดีที่สุดในการระบุปีของภาพในช่วง 15–25 ปีหลังคือรู้จักบุคคลในภาพ เช่น คนดังหรือคนรู้จัก แล้วประมาณอายุของเขาเพื่อย้อนหาเวลาคร่าวๆ
ใช้อายุใบหน้าเป็นจุดอ้างอิง
ในคอมพิวเตอร์วิทัศน์ นิติเวช งานจดหมายเหตุ วารสารศาสตร์ และการออกแบบชุดข้อมูล ความสามารถในการหาปีของภาพมีคุณค่าสูง เพราะคอลเล็กชันดิจิทัลและแอนะล็อกที่น่าสนใจจำนวนมากไม่มีคำอธิบายหรือเมทาดาทาที่ถูกต้อง และบางครั้งมีข้อมูลผิดจากการเดาครั้งก่อน
จึงเป็นประโยชน์หาก AI ตรวจภาพประวัติศาสตร์ได้เหมือนมนุษย์ที่มองย้อนหลังแล้วจำได้ว่า “อ๋อ นั่นคือตอนที่…” คำถามคือจะใช้อะไรเป็นหลักเมื่อเบาะแสทั่วไปไม่มีอยู่
งานวิจัยใหม่จากสาธารณรัฐเช็กเสนอจุดเริ่มต้นด้วยระบบประเมินอายุและการรู้จำใบหน้า เชื่อมกับฐานข้อมูลตัวตนร่วม ในกรณีนี้เป็นฐานข้อมูลคล้าย IMDB ของนักแสดงและผู้สร้างภาพยนตร์เช็ก

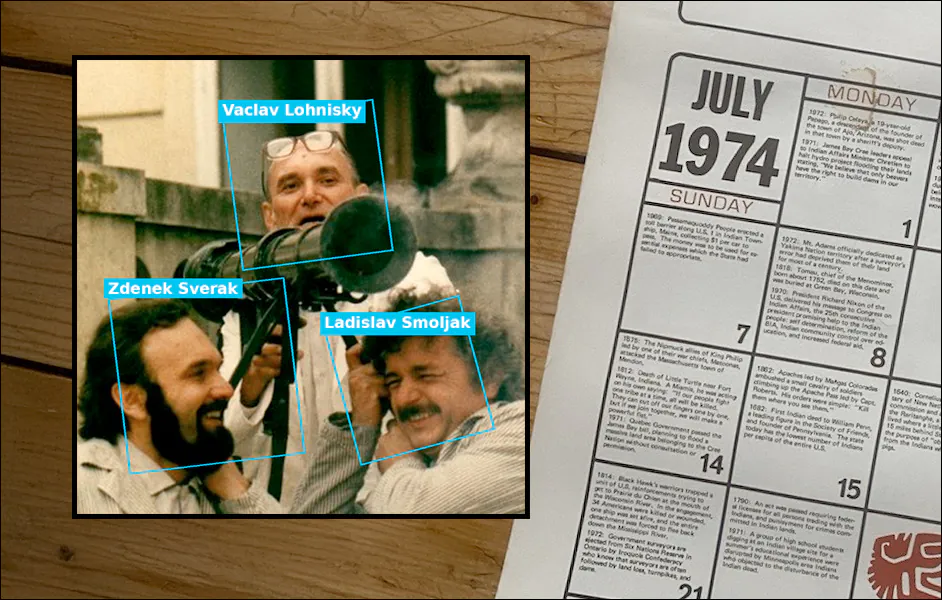
ภาพจากเรื่อง Joachim, Put It in the Machine (1974) ระบบตรวจบุคคลที่รู้จัก ประเมินอายุใบหน้า แล้วรวมกับปีเกิดเพื่อสร้างการแจกแจงความน่าจะเป็นของปีที่ถ่าย เส้นประแสดงอายุจริงของแต่ละคนในเวลานั้น ที่มา
ระบบตรวจบุคคลที่รู้จักในภาพ ใช้โมเดลที่ฝึกไว้ประเมินอายุใบหน้า แล้วนำอายุไปคำนวณร่วมกับปีเกิดที่บันทึกไว้เพื่อหาปีที่เป็นไปได้ เมื่อมีหลายใบหน้า ระบบจะรวมค่าประมาณเป็นผลสุดท้าย
ทดสอบกับภาพจาก Czecho-Slovak Movie Database (CSFD) ผู้เขียนระบุว่าวิธีนี้แม่นยำกว่าโมเดลพิจารณาฉาก ซึ่งอาศัยพื้นหลังหรือบริบทภาพแทนใบหน้า แม้ฝึกบนข้อมูลชุดเดียวกัน
วิธีนี้ต้องมีฐานข้อมูลกลางของบุคคลจำนวนมาก พร้อมวันเกิดและเหตุการณ์ที่ยืนยันเวลา ฐานข้อมูลภาพยนตร์เช็กทำหน้าที่ดังกล่าว แต่คอลเล็กชันอื่นที่มีข้อมูลแบบเดียวกันก็ใช้ได้
ชุดข้อมูลของเราระบุบุคคลหลายคนในภาพเดียว ทำให้ศึกษาการรวมข้อมูลหลายใบหน้าได้ เราเสนอกรอบความน่าจะเป็นที่รวมหลักฐานจากการรู้จำใบหน้า การประมาณอายุ และข้อมูลช่วงอาชีพ เพื่ออนุมานปีที่ถ่ายภาพ การรวมหลายใบหน้าช่วยเพิ่มประสิทธิภาพอย่างสม่ำเสมอ และทำได้ดีกว่าวิธีพิจารณาฉากอย่างมาก โดยเฉพาะภาพที่มีบุคคลระบุตัวตนได้หลายคน
บทความชื่อ Photo Dating by Facial Age Aggregation มาจากนักวิจัยสองคนที่ Czech Technical University in Prague และจะเผยแพร่โค้ดกับข้อมูลภายหลัง
วิธีการ
ระบบตรวจทุกใบหน้าที่พบและเดาว่าเป็นใครจากฐานข้อมูลบุคคลที่รู้จัก เนื่องจากคนหนึ่งปรากฏได้เพียงครั้งเดียวในภาพ ระบบจึงตรวจทุกชุดความเป็นไปได้ของตัวตน แล้วใช้ปีเกิดที่ทราบกับอายุที่ใบหน้าดูเหมือนเป็นอยู่
จากนั้นระบบคำนวณย้อนกลับเพื่อหาปีที่ทำให้อายุทั้งหมดสอดคล้องกันมากที่สุด

ซ้าย: เส้นเวลาแสดงช่วงที่บุคคลซึ่งรู้จำได้มีผลงานมากที่สุด ขวา: รวมข้อมูลนี้กับค่าประมาณอายุใบหน้าเพื่อเดาปีที่ถ่ายภาพ
เพื่อจัดการชุดตัวตนที่เป็นไปได้จำนวนมาก ระบบสมมติว่าแต่ละใบหน้าเป็นอิสระ และลักษณะของใบหน้าขึ้นกับตัวตนกับวันที่ถ่ายเท่านั้น
ระบบประเมินอายุแต่ละใบหน้าด้วยโมเดล NIST cvut-002 ซึ่งใช้สถาปัตยกรรม ViT-B/16 และฝึกบนข้อมูลเอกชนที่ผู้เขียนระบุว่ามีอันดับสูงในฐานประเมิน Face Analysis Technology Evaluation (FATE) ของ NIST
เมื่อทราบปีเกิดแล้ว ระบบแปลงค่าประมาณอายุเป็นการแจกแจงของปีที่น่าจะถ่าย โดยบวกอายุกับปีเกิด ส่วนการวัดว่าใบหน้าตรงกับตัวตนที่รู้จักเพียงใดทำในพื้นที่ตัวแทน ArcFace

ArcFace เปิดตัวในปี 2015 และต่อมากลายเป็นสถาปัตยกรรมสำคัญของ InsightFace ที่มีอิทธิพลต่อการวิเคราะห์ใบหน้า ที่มา
ตัวตนแต่ละคนแทนด้วยค่าเฉลี่ยจากภาพอ้างอิง ความคล้ายระหว่างใบหน้าทดสอบกับตัวตนวัดด้วยการแจกแจง Von Mises–Fisher ซึ่งจำลองว่าภาพของบุคคลกระจุกรอบค่าเฉลี่ยแน่นเพียงใด พารามิเตอร์ความคมร่วมกำหนดความมั่นใจและประมาณด้วยวิธี leave-one-out
โมเดลใช้ prior ทางเวลาห้าชนิด ได้แก่ uniform, decade, movie, image และแบบผสมเชิงนูนที่รวมตัวเลือกแข็งแรงกับอ่อน เพื่อทดสอบความไวต่อความแรงของ prior
ใบหน้าที่ระบุไม่ได้อย่างมั่นใจจะถูกจัดเป็นตัวตน “ไม่ทราบ” ซึ่งมีการแจกแจงแบบไม่ให้ข้อมูล ทั้งความน่าจะเป็นในพื้นที่ตัวแทนและ prior ที่แบนตลอดทุกปี ทำให้ละเว้นใบหน้าที่ไม่แน่นอนได้โดยไม่บิดเบือนปีสุดท้าย

แต่ละช่องแสดงความผิดพลาดเฉลี่ยเมื่อจำนวนตัวตนที่รู้จักและไม่รู้จักต่างกัน ขนาดช่องแสดงความถี่ในข้อมูล ความผิดพลาดสูงขึ้นเมื่อมีคนไม่ทราบมากขึ้น และลดลงเมื่อเพิ่มตัวตนที่รู้จัก
ข้อมูลและการทดสอบ
ผู้เขียนใช้ CSFD สร้างชุดข้อมูลใหม่ชื่อ CSFD-1.6M จากฉากที่มีหลายคน โดยติดป้ายตัวตนและปีให้ทุกใบหน้า โครงสร้างนี้จำเป็นต่อการเรียนรู้ความสัมพันธ์ระหว่างใบหน้าในบริบท ขณะที่ชุดข้อมูลใบหน้าเดี่ยวอย่าง IMDB-WIKI ติดป้ายเพียงคนเดียวต่อภาพ
ใช้ปีฉายจาก Czecho-Slovak Movie Database เป็นค่าประมาณเวลาถ่าย และจับคู่แต่ละคนกับโปรไฟล์สาธารณะที่มีปีเกิดและภาพอ้างอิง ArcFace สร้างตัวแทนใบหน้าและค่าเฉลี่ยของแต่ละตัวตน ก่อนใช้อัลกอริทึม Hungarian จับคู่ใบหน้ากับตัวตนตามความคล้าย เมื่อจำนวนใบหน้าจาก SCRFD-10GE ไม่ตรงกับจำนวนบุคคลที่รู้จักก็มีการปรับแก้

สถิติ CSFD-1.6M ครอบคลุมภาพที่เก็บจากเว็บ ใบหน้าที่ตรวจพบ การจับคู่ตัวตน ตัวอย่างที่ติดป้ายสุดท้าย และจำนวนตัวตนที่มีให้ใช้
ระบบปฏิเสธคู่ที่ความคล้ายต่ำหรืออายุที่ประเมินต่างจากอายุจริงมาก โดยยอมให้คลาดเคลื่อนมากขึ้นสำหรับผู้สูงอายุ และไม่ได้กรองใบหน้าตามคุณภาพหรือขนาด ผู้เขียนระบุว่า CSFD-1.6M ใหญ่กว่า IMDB-WIKI มากและมีฉากหลายคนที่โมเดลต้องการ แม้ข้อมูลจากเว็บจะมีสัญญาณรบกวน แต่ลิงก์ตรงระหว่างภาพกับโปรไฟล์ช่วยเพิ่มคุณภาพการระบุตัวตน
การประเมินเปรียบเทียบระบบหลายแบบ แบบหนึ่งสมมติว่ารู้ตัวตนในภาพอย่างสมบูรณ์เพื่อเป็นขีดบน ส่วนโมเดล Full ประเมินตัวตนและปีร่วมกันโดยถ่วงชุดตัวตนหลายแบบ รุ่นง่ายเลือกชุดตัวตนที่น่าจะเป็นที่สุดเพียงชุดเดียวและให้ผลเกือบเท่า Full ส่วนฐาน Naive ประเมินแต่ละใบหน้าแยกกันแล้วรวมปีโดยไม่ตรวจว่าตัวตนทั้งหมดสมเหตุสมผลหรือไม่
เพื่อดูว่าประโยชน์มาจากใบหน้ามากเพียงใด ยังฝึกโมเดล Scene ให้เดาปีจากภาพทั้งหมดโดยตรง โมเดลนี้เป็นทางเลือกที่แข็งแรงเพราะเรียนรู้รูปแบบเฉพาะยุคจากทั้งภาพแทนตัวตนหรืออายุ
ตัวชี้วัดและการแบ่งข้อมูล
ตัวชี้วัดหลักคือ Mean Absolute Error (MAE) ระหว่างปีที่ทำนายกับปีจริง ข้อมูลแบ่งเป็นห้าส่วน โดยภาพจากภาพยนตร์เรื่องเดียวอยู่ในส่วนเดียวกัน ใช้สามส่วนฝึก หนึ่งส่วนตรวจสอบ และหนึ่งส่วนทดสอบ หมุนเวียนแบบห้า fold เพื่อลดการฟิตเกิน
โมเดลที่ใช้ใบหน้าไม่ได้ฝึกบนชุดนี้ จึงประเมินโดยตรงกับ CSFD-1.6M ทั้งหมด ส่วนโมเดล Scene ฝึก 200 epoch ด้วย Adam และครอปภาพเป็น 384×384
ผลลัพธ์
ผลสำคัญไม่ใช่ตัวเลขเดียว แต่เป็นรูปแบบที่สม่ำเสมอ: โมเดลรวมใบหน้า โดยเฉพาะ Full และ Top-1 ทำได้ดีกว่า Scene เมื่อมีตัวตนที่รู้จักตั้งแต่สองคนขึ้นไป แม้ Scene จะฝึกตรงบนชุดข้อมูล ผลนี้สนับสนุนข้ออ้างว่าการใช้ใบหน้าที่ผูกกับตัวตนเป็นสัญญาณที่ทนทานกว่าการตีความฉากทั้งหมด
เมื่อเปรียบเทียบ prior ทางเวลา แบบ Decade ให้ผลดีที่สุดและชนะทั้ง Naive ซึ่งไม่มี prior และ Uniform ที่ถือว่าทุกปีมีโอกาสเท่ากันอย่างมีนัยสำคัญ

ประสิทธิภาพของทุกวิธีลดลงเมื่อจำนวนใบหน้าเพิ่ม แต่โมเดลที่ใช้ prior สมจริงอย่าง Decade ได้รับผลกระทบน้อยกว่า Full ที่มี prior ให้ข้อมูลยังรักษาความผิดพลาดต่ำ ส่วน prior แบบ oracle ที่ใช้สถิติชุดทดสอบกำหนดขีดล่างที่เป็นไปได้
นักวิจัยยังใช้ CSFD-1.6M เป็นข้อมูลฝึกล่วงหน้าสำหรับการประมาณอายุใบหน้า โดยฝึก ResNet101 ล่วงหน้าแล้วเทียบกับ IMDB-WIKI และ ImageNet จากนั้นปรับจูนและทดสอบบน AgeDB, AFAD, MORPH, UTKFace และ CLAP2016

ค่า MAE พร้อมส่วนเบี่ยงเบนมาตรฐานบนเกณฑ์ประมาณอายุห้าชุด เปรียบเทียบการฝึกล่วงหน้าด้วย ImageNet, IMDB-WIKI และ CSFD-1.6M ค่าต่ำกว่าดีกว่า และ CSFD-1.6M ดีที่สุดทุกชุด
การฝึกล่วงหน้าด้วย CSFD-1.6M ให้ความผิดพลาดต่ำที่สุดในทั้งห้าชุด ชนะอีกสองแหล่งอย่างชัดเจน โดยช่องว่างมากที่สุดใน AFAD และ CLAP2016 แต่ยังคงสม่ำเสมอทุกเกณฑ์ บทความต้นฉบับยังมีผลและการศึกษา ablation เพิ่มเติม
บทสรุป
แม้บทความจะหนาแน่นและอ่านยากขึ้นอย่างรวดเร็ว แต่หัวข้อเป็นหนึ่งในเรื่องที่น่าสนใจและเกี่ยวข้องมากที่สุดของคอมพิวเตอร์วิทัศน์ เพราะเชื่อมกับมานุษยวิทยาและวัฒนธรรมศึกษา ซึ่งมีตัวแปรคงที่ระบุได้ยาก
* เช่นเดียวกับวิวัฒนาการทางดนตรีที่มีอัตราการเปลี่ยนแปลงช้าลง
เผยแพร่ครั้งแรกวันจันทร์ที่ 10 พฤศจิกายน 2025


