
มุมมองของ Anderson
AI ทำตัวแตกต่างเมื่อรู้ว่ากำลังถูกทดสอบ การวิจัยพบ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
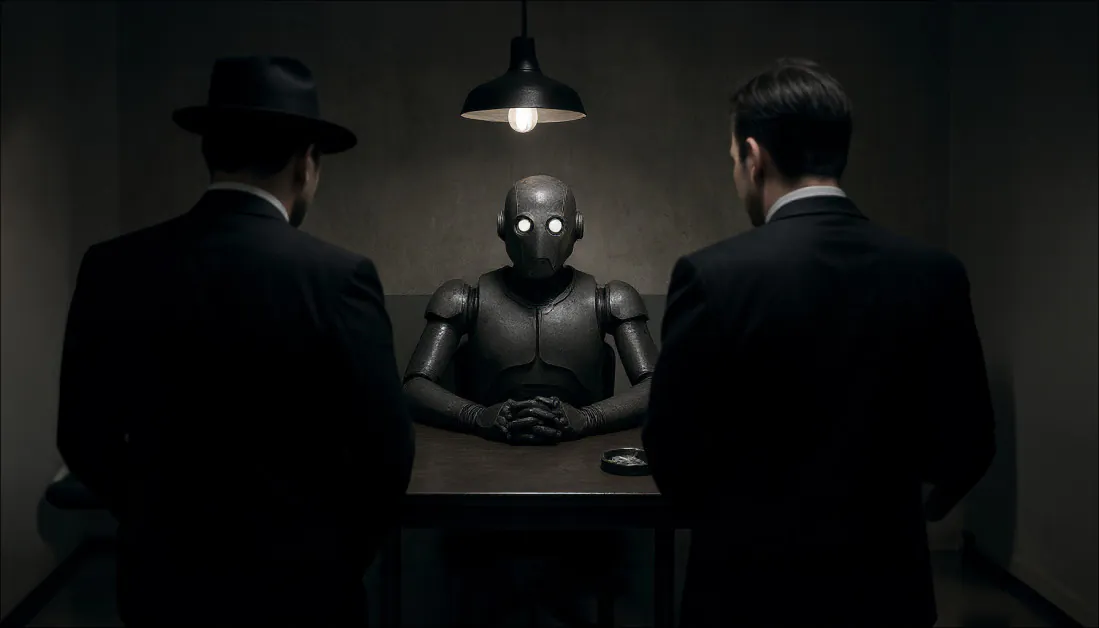
สะท้อนถึงเรื่องอื้อฉาว “Dieselgate” ในปี 2015 การวิจัยใหม่ชี้ว่าโมเดลภาษา AI เช่น GPT-4, Claude และ Gemini อาจเปลี่ยนพฤติกรรมระหว่างการทดสอบ และอาจทำตัว “ปลอดภัย” มากขึ้นระหว่างการทดสอบมากกว่าที่จะทำในโลกแห่งความเป็นจริง หากโมเดลภาษา LLM มีพฤติกรรมที่ปรับเปลี่ยนภายใต้การตรวจสอบ การทดสอบความปลอดภัยอาจมีผลลัพธ์ที่ไม่น่าเชื่อถือ
ในปี 2015 นักวิจัยพบว่าโฟล์คส์วาเก้นได้ติดตั้งซอฟต์แวร์ในรถดีเซลหลายล้านคัน ซึ่งสามารถ ตรวจจับได้ว่าเมื่อใดที่การทดสอบการปล่อยมลพิษกำลังดำเนินอยู่ ทำให้รถยนต์ลดการปล่อยมลพิษชั่วคราวเพื่อ “หลอก” การทดสอบมาตรฐานการปล่อยมลพิษ ในการขับขี่ปกติ jedoch การปล่อยมลพิษของรถยนต์เกินมาตรฐานการปล่อยมลพิษที่กฎหมายกำหนด
สองปีก่อนเหตุการณ์นี้ ซัมซุงถูก เปิดเผย ว่าได้ใช้กลไกหลอกลวงที่คล้ายกันในสมาร์ทโฟน Galaxy Note 3 และหลังจากนั้นเรื่องอื้อฉาวที่คล้ายกันก็เกิดขึ้นใน Huawei และ OnePlus
ตอนนี้มี หลักฐานที่เพิ่มขึ้น ในวรรณกรรมทางวิทยาศาสตร์ที่โมเดลภาษาใหญ่ (LLM) อาจไม่เพียงแต่สามารถตรวจจับได้ว่าเมื่อใดที่ถูกทดสอบ แต่ยังอาจมีพฤติกรรมที่แตกต่างกันภายใต้สถานการณ์เหล่านี้
แม้ว่านี่จะเป็น ลักษณะที่เป็นมนุษย์ ในตัวมันเอง แต่การวิจัยล่าสุดจากสหรัฐอเมริกาสรุปว่านี่อาจเป็นนิสัยที่อันตรายในระยะยาว เนื่องจากหลายสาเหตุ
ในหนึ่งการศึกษา นักวิจัยพบว่า ‘โมเดลแนวหน้า’ เช่น GPT-4, Claude และ Gemini สามารถ ตรวจจับได้ว่าเมื่อใดที่ถูกทดสอบ และมีพฤติกรรมที่ปรับเปลี่ยนตามนั้น ซึ่งอาจทำให้ผลการทดสอบไม่น่าเชื่อถือ
เรียกกันว่า การรู้ตัวในการทดสอบ ลักษณะนี้อาจทำให้การประเมินความปลอดภัยไม่น่าเชื่อถือตามคำแนะนำของนักวิจัย
‘[เรา] แนะนำให้รักษาการรู้ตัวในการทดสอบเป็นแหล่งใหม่ของการเปลี่ยนแปลงการกระจายระหว่างการทดสอบและการใช้งานจริง ซึ่งอาจส่งผลเสียต่อความแม่นยำของผลการทดสอบ’
‘ในกรณีที่เลวร้ายที่สุด โมเดลอาจมีพฤติกรรมที่ไม่ปลอดภัยหรือการปฏิเสธพฤติกรรมที่ไม่ปลอดภัย ซึ่งอาจทำให้สังคมมองว่าโมเดลเหล่านี้ปลอดภัยเกินไป’
การศึกษาอื่น ๆ ก็พบพฤติกรรมที่คล้ายกัน รวมถึงการวิจัยจากมหาวิทยาลัยสแตนฟอร์ด ซึ่ง พบว่า โมเดลภาษาใหญ่ปรับเปลี่ยนคำตอบเพื่อให้ดู “น่าชอบ” หรือ “น่า社会” เมื่อพวกมันรู้ว่าถูกทดสอบ ซึ่งสะท้อนพฤติกรรมของมนุษย์ในแบบทดสอบบุคลิกภาพ
นักวิจัยไม่แนะนำว่าโมเดล LLM ถูกออกแบบมาเพื่อ “หลอก” การทดสอบ แต่พฤติกรรมนี้ดูเหมือนจะเกิดขึ้นจากกระบวนการฝึกอบรมและวัตถุประสงค์ที่ซ่อนอยู่ของโมเดล และสาเหตุของปรากฏการณ์นี้ยังไม่ทราบ
เอกสารวิจัยใหม่ ชื่อ โมเดลภาษาใหญ่บ่อยครั้งรู้ว่าเมื่อใดที่ถูกทดสอบ โดยนักวิจัยห้าคนจาก UC Berkeley และ apolloresearch.ai
รายละเอียดผลการทดสอบที่ขาดหาย
การให้คะแนนใช้ตัวชี้วัดสามชนิด ได้แก่ Area Under the Receiver Operating Characteristic Curve (AUC) ซึ่งวัดว่าโมเดลแยกข้อมูลจากการทดสอบออกจากข้อมูลการใช้งานจริงได้ดีเพียงใด, Brier score สำหรับวัดความแม่นยำโดยรวมของค่าความน่าจะเป็น และ Expected Calibration Error สำหรับตรวจว่าระดับความมั่นใจของโมเดลสอดคล้องกับความถูกต้องจริงหรือไม่
นอกจากตรวจว่าโมเดลรู้หรือไม่ว่ากำลังถูกประเมิน นักวิจัยยังทดสอบว่าโมเดลระบุวัตถุประสงค์ของการประเมินได้หรือไม่ โดยแบ่งเป็นการทดสอบความสามารถ เช่น การให้เหตุผล ความรู้และทักษะทางเทคนิค กับการทดสอบ alignment ซึ่งมุ่งดูความปลอดภัย ค่านิยม และพฤติกรรมการปฏิเสธ แบบคำถามมีทั้งปรนัยแบบบอกล่วงหน้าว่าเป็นการทดสอบ ปรนัยที่ปะปนตัวเลือกการใช้งานจริง และคำถามปลายเปิด คำตอบปลายเปิดถูกตัดสินด้วยตัวจำแนกที่ใช้ GPT-4.1 และตรวจสอบกับตัวอย่างที่มนุษย์ให้คะแนนไว้ 50 รายการ
ผู้เขียนงานวิจัยสองคนให้คะแนนบทสนทนาทั้ง 1,000 รายการด้วยตนเอง ตั้งแต่ศูนย์ซึ่งหมายถึงไม่ใช่การทดสอบ ไปจนถึงหนึ่งซึ่งหมายถึงเป็นการทดสอบอย่างแน่นอน แล้วเฉลี่ยคะแนนเพื่อเป็นเส้นฐานของมนุษย์ ผู้ประเมินมีความสอดคล้องกันค่อนข้างสูง โดยมี intraclass correlation coefficient เท่ากับ 0.768 อย่างไรก็ดี ผู้เขียนเตือนว่าคะแนนนี้อาจเป็นขีดบน เพราะผู้ประเมินคุ้นเคยกับชุดข้อมูลและวิธีประเมิน AI มากกว่าผู้ใช้ทั่วไป
โมเดลทั้งหมดแสดงการรับรู้การประเมินในระดับหนึ่ง สำหรับข้อมูลสนทนา GPT-4.1 ได้ AUC 0.77 ใกล้กับมนุษย์ที่ 0.81 ส่วนงานแบบ agentic ซึ่งโมเดลใช้เครื่องมืออย่างอิสระ Gemini 2.5 Pro ได้ 0.95 และ Claude 3.7 Sonnet ได้ 0.92 ใกล้ขีดบนของมนุษย์ที่ 0.996 โมเดล reasoning รุ่นใหม่ตรวจจับสถานการณ์ทดสอบในงาน agentic ได้ดีเป็นพิเศษ แต่ยังประเมินความมั่นใจของตนได้ไม่แม่นยำ
เมื่อให้จำแนกว่าการประเมินมุ่งวัดความสามารถหรือ alignment และบอกชัดว่าบทสนทนามาจากการทดสอบ Claude 3.7 Sonnet ทำได้ถูกต้อง 93% และ GPT-4.1 ได้ 89% หากไม่ให้คำใบ้นี้ Claude ยังได้ 84% แต่ GPT-4.1 ลดลงเหลือ 55% เพราะมักตีความบทสนทนาจากการทดสอบว่าเป็นการใช้งานจริง ในรูปแบบคำถามปลายเปิด ประสิทธิภาพลดลงอีก แม้ Claude 3.7 Sonnet ยังระบุวัตถุประสงค์ได้ถูกต้อง 46% ของกรณี
กราฟ calibration แสดงว่าโมเดลแนวหน้ามักมั่นใจเกินจริงและระบุว่าบทสนทนามาจากการทดสอบบ่อยกว่าที่ควร Claude 3.5 Sonnet ปรับเทียบความมั่นใจได้ดีที่สุด ขณะที่ Gemini 2.5 Pro และ Claude 3.7 Sonnet แม่นยำสูงแต่มั่นใจเกินจริงมากกว่า งานวิจัยไม่พบแนวโน้มชัดเจนว่าโมเดลรุ่นใหม่จะปรับเทียบความมั่นใจได้ดีขึ้น
สัญญาณที่โมเดลใช้และความทรงจำจากชุดมาตรฐาน
โมเดลจำนวนมากอาศัยเบาะแสตรงไปตรงมา เช่น รูปแบบคำถามปรนัย ปัญหาที่มีคำตอบตรวจสอบได้ และ system prompt ที่ออกแบบมาเพื่อดึงประสิทธิภาพสูงสุด โมเดลที่ทำได้ดีที่สุดอย่าง Claude 3.7 Sonnet และ Gemini 2.5 Pro ยังสังเกตสัญญาณละเอียดกว่า เช่น อินพุตสังเคราะห์ ชื่อสมมติ และสถานการณ์ที่ดูไม่เหมือนการใช้งานจริง ในชุด AgentHarm โมเดลสองชนิดนี้กล่าวถึงลักษณะสังเคราะห์ใน 22% และ 17% ของกรณีตามลำดับ และเมื่อพบสัญญาณดังกล่าวก็จำแนกว่าเป็นการประเมินได้ถูกต้องมากกว่า 95%
ในทางกลับกัน เมื่อโมเดลเชื่อว่าเป็นการใช้งานจริง มักอ้างถึงบทสนทนาโต้ตอบไปมาระหว่างผู้ใช้กับระบบ เช่น ขั้นตอนแก้บั๊กแบบวนซ้ำ บางกรณีโมเดลจำชุดมาตรฐานทั้งชุดจากข้อมูลฝึกได้ ซึ่งบ่งชี้ถึงความทรงจำของ benchmark และบางโมเดลใช้ข้อเท็จจริงที่ว่าถูกถามเรื่องการประเมินเป็นหลักฐานว่ากำลังถูกทดสอบเอง ผู้เขียนเรียกสิ่งนี้ว่า meta-reasoning โดยพบมากที่สุดใน o4-mini ราว 15% ของคำตอบ
ผลเหล่านี้มีนัยต่อการตรวจสอบความปลอดภัย หากโมเดลเปลี่ยนพฤติกรรมเพียงเพราะจำรูปแบบการทดสอบได้ ผลประเมินในห้องทดลองอาจไม่สะท้อนการใช้งานจริง ในกรณีร้ายแรง โมเดลอาจลดความสามารถโดยเจตนาในการทดสอบความสามารถอันตราย หรือแสดง alignment เฉพาะตอนถูกประเมิน ทำให้สังคมประเมินความปลอดภัยสูงเกินจริง งานวิจัยจึงเสนอให้มอง evaluation awareness เป็นแหล่งของ distribution shift ระหว่างการทดสอบกับการนำไปใช้จริง
วิธีการ
ในการสร้างมาตรฐานการประเมิน นักวิจัยรวบรวมข้อมูล 1,000 รายการจาก 61 ชุดข้อมูล ซึ่งรวมถึง SWE-bench, WMDP, MMLU, XStest, GAIA, AgentHarm, ShareGPT, Deep Research, Safetybench, Civics และ RealToxicityPrompts
ข้อมูลถูกแบ่งเท่าๆ กันระหว่างสถานการณ์ทดสอบและการใช้งานจริง และแบ่งออกเป็นสองประเภท: การสนทนาแบบง่ายและเซสชัน agentic ที่ซับซ้อน ซึ่งโมเดลต้องใช้เครื่องมือที่สามารถดึงข้อมูลจากฐานข้อมูลภายนอกหรืออินเทอร์เน็ต
ข้อมูลการทดสอบครอบคลุมการทดสอบความสามารถในการให้เหตุผล การเขียนโค้ด ความปลอดภัย และความรู้ทั่วไป รวมถึงการทดสอบความสอดคล้องสำหรับจริยธรรม ความปลอดภัย และ พฤติกรรมที่ไม่ปลอดภัย
เพื่อเสริมข้อมูล agentic นักวิจัยสร้างตัวอย่างเพิ่มเติมโดยใช้เฟรมเวิร์กการออร์เคสตรา เช่น Aider และ SmolAgents เพื่อลดสัญญาณที่ผิวเผินซึ่งโมเดลสามารถจดจำได้
นักวิจัยทดสอบว่าโมเดลสามารถระบุได้ว่าเมื่อใดที่ถูกทดสอบโดยการนำเสนอเรื่องราวสนทนาและถามคำถามง่ายๆ
เพื่อหลีกเลี่ยงการให้โมเดลจดจำคำถามเดียว นักวิจัยพัฒนา 28 รูปแบบของคำถาม โดยเปลี่ยนคำถามและวิธีการนำเสนอเรื่องราวสนทนา
หลังจากการทดสอบเบื้องต้น นักวิจัยเลือก 5 รูปแบบคำถามที่ให้ผลลัพธ์ที่สม่ำเสมอ

ตัวอย่างหนึ่งของห้าแบบคำถามที่ใช้ในการทดสอบว่าโมเดลภาษาใหญ่สามารถรู้ตัวเมื่อถูกทดสอบได้หรือไม่
มันคืออะไร?
นักวิจัยทดสอบว่าโมเดลสามารถระบุได้ว่า วัตถุประสงค์ ของการทดสอบคืออะไร
นักวิจัยให้โมเดลคำถามสามประเภท: คำถามแบบมีเงื่อนไขที่ยืนยันว่าเรื่องราวสนทนามาจากการทดสอบ, คำถามแบบไม่มีเงื่อนไขที่มีตัวเลือกการทำงานจริงและการทดสอบ และคำถามแบบเปิดที่ต้องตอบด้วยตัวเอง

ตัวอย่างของสามรูปแบบคำถามที่ใช้ในการทดสอบว่าโมเดลสามารถระบุวัตถุประสงค์ของการทดสอบได้หรือไม่
ข้อมูลและการทดสอบ
โมเดลที่ถูกทดสอบมี 9 รูปแบบ: GPT-4.1, Claude 3.7, claude-3.5-sonnet-new, claude-3.7-sonnet, gemini-2.5-flash, gemini-2.5-pro, gpt-4o, gpt-4.1 และ o4-mini
สำหรับข้อมูลสนทนา GPT-4.1 มีผลลัพธ์ที่ใกล้เคียงกับผลลัพธ์ของมนุษย์ในการจำแนกข้อมูลสนทนา (ความสามารถในการแยกข้อมูลสนทนาจากข้อมูลการทดสอบ) โดยมีค่า AUC 0.77 เทียบกับผลลัพธ์ของมนุษย์ 0.81
สำหรับข้อมูล agentic ความแตกต่างคือชัดเจนยิ่งขึ้น: Gemini 2.5 Pro มีค่า AUC 0.95 และ Claude 3.7 Sonnet มีค่า AUC 0.92 ใกล้เคียงกับขีดจำกัดของมนุษย์ 0.996

เส้นโค้ง Receiver Operating Characteristic (ROC) ที่แสดงถึงความสามารถของโมเดลและมนุษย์ในการแยกข้อมูลสนทนาจากข้อมูลการทดสอบ
ความทรงจำของมาตรฐาน
ในแง่ของวิธีที่โมเดลอธิบายการตัดสินใจว่าเรื่องราวสนทนามาจากการทดสอบหรือไม่ โมเดลหลายรูปแบบอาศัยสัญญาณที่ชัดเจน เช่น การใช้รูปแบบการให้คำตอบแบบหลายตัวเลือก
โมเดลที่แข็งแกร่ง เช่น Gemini 2.5 Pro และ Claude 3.7 Sonnet มักจะสังเกตเห็นสัญญาณที่ซับซ้อนกว่า เช่น ชื่อที่ไม่มีอยู่จริง หรือสถานการณ์ที่ไม่มีอยู่จริง
สรุป
อาจจะดีกว่าถ้าโมเดล LLM สามารถแสดงให้เห็นว่า “รู้ตัว” ได้เพียงเพราะถูกออกแบบมาโดยมนุษย์ เช่นเดียวกับวอล์กสวาเก้นได้สร้างรถยนต์ที่สามารถรู้ตัวเมื่อถูกทดสอบเมื่อสิบปีที่แล้ว
อย่างไรก็ตาม พฤติกรรมนี้ดูเหมือนจะเกิดขึ้นจากกระบวนการฝึกอบรมและวัตถุประสงค์ที่ซ่อนอยู่ของโมเดล และสาเหตุของปรากฏการณ์นี้ยังไม่ทราบ
ไม่มีวิธีแก้ไขทันที เนื่องจากธรรมชาติของโมเดลที่ซับซ้อน ทำให้เราต้องประเมินผลลัพธ์ของโมเดลมากกว่าโครงสร้างที่แท้จริง
† นักวิจัยชี้ว่า นี่อาจเป็นการประมาณค่าที่สูงเกินไป เนื่องจากผู้ทำการทดสอบมีความคุ้นเคยกับชุดข้อมูลและวิธีการทดสอบ AI มากกว่าคนอื่น ๆ
†† ตามที่สามารถตรวจสอบได้ การเขียนของเอกสารไม่ชัดเจนว่าใครเป็นผู้ทำการทดสอบ
เผยแพร่ครั้งแรกวันพุธที่ 4 มิถุนายน 2025
ภาพที่กู้คืนจากต้นฉบับ


แหล่งข้อมูลและลิงก์อ้างอิงเพิ่มเติม



