Grunderna i AI
Vad är ett datatyg?

 Lägg till Unite.AI bland dina föredragna källor på Google
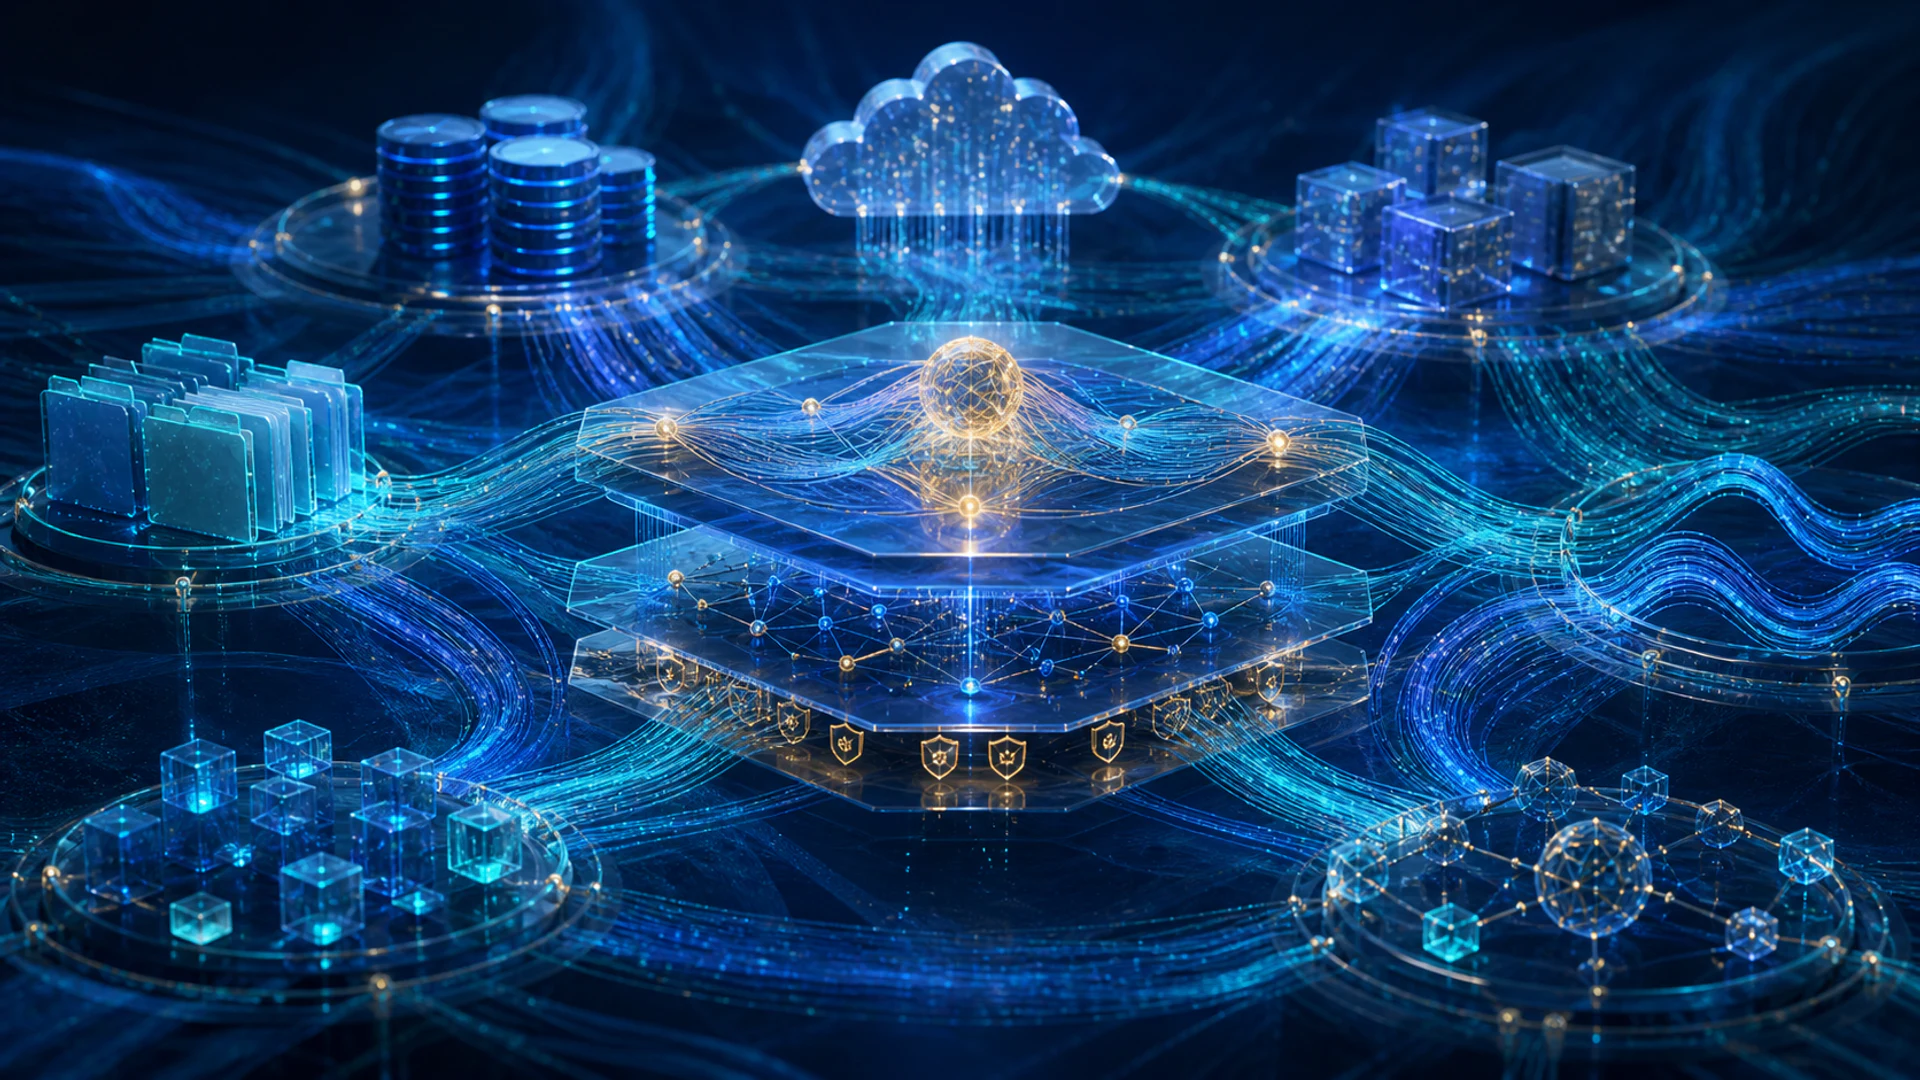
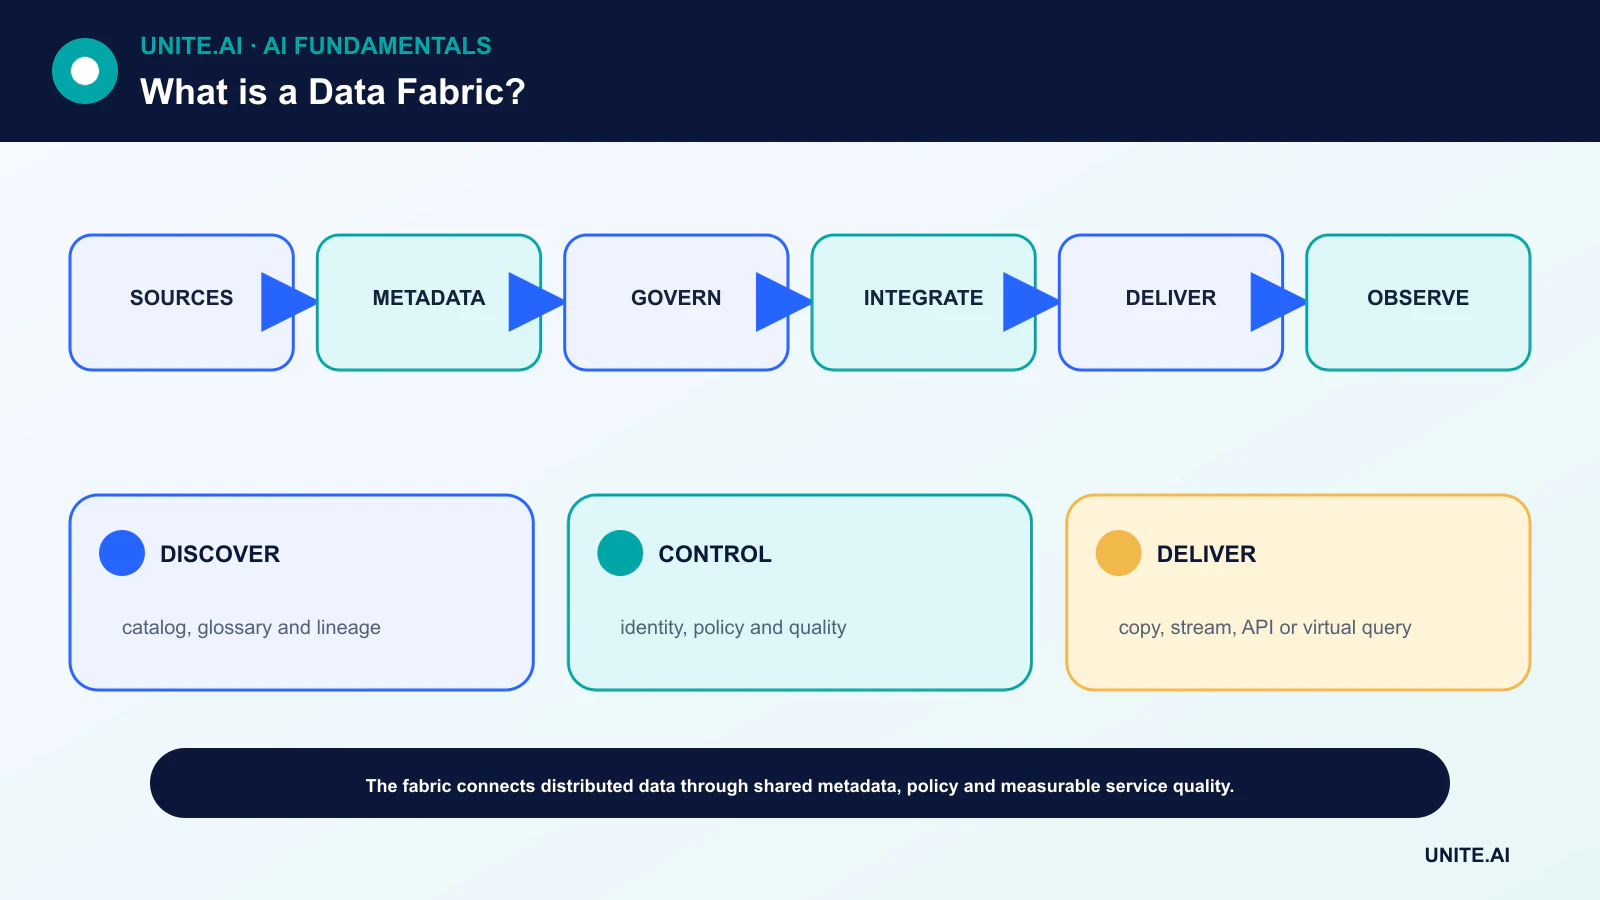
Ett datatyg är ett arkitekturmönster för att upptäcka, ansluta, styra och leverera data över distribuerade system. Det tillhandahåller ett gemensamt metadata‑ och kontrollskikt så att människor och applikationer kan hitta pålitlig data utan att tvinga varje dataset till ett enda fysiskt lager.
Ett datatyg är inte en enskild produkt och det suddar inte ut skillnaderna mellan källsystemen. Dess värde beror på korrekt metadata, tydligt ägarskap, verkställbara policyer, pålitlig integration och bevis på att konsumenterna får data som passar deras syfte.
Viktiga slutsatser
- Ett metadata‑rikt kontrollplan kopplar samman kataloger, härstamning, kvalitet, policy och åtkomst.
- Data kan förbli distribuerade och kopieras, strömmas, transformeras eller virtualiseras beroende på arbetsbelastningen.
- Datatyg är teknikorienterat; data‑mesh betonar domänägarskap och data‑som‑produkt.
- Automatisering hjälper till att skala styrning, men ansvariga ägare definierar fortfarande betydelse, kvalitet och tillåten användning.
Kontrollplanet och dataplanet
Dataplanet innehåller databaser, filer, strömmar, API:er och de pipelines som flyttar eller frågar dem. Kontrollplanet registrerar teknisk och affärsmetadata: scheman, ägare, klassificeringar, kvalitetsmått, härstamning, policyer och användning.
En katalog eller kunskapsgraf kan koppla ihop dessa fakta så att en konsument kan upptäcka ett dataset och förstå dess sammanhang. Tygnet använder sedan metadata för att styra åtkomst, transformation, observerbarhet och policy‑verkställning över heterogena plattformar.
Integration utan ett obligatoriskt lager
Vissa arbetsbelastningar kopierar data via ETL; andra använder change‑data capture, händelseströmmar, API:er eller frågevirtualisering. Det rätta mönstret beror på aktualitet, prestanda, konsistens, suveränitet, kostnad och begränsningar i källsystemet.
Virtuell åtkomst kan minska duplicering men kan utsätta konsumenter för källlatens och tillgänglighet. Fysisk materialisering förbättrar prestanda och reproducerbarhet men skapar synkroniserings‑ och livscykelansvar.
Styrning, semantik och kvalitet
En affärsglossarium ger gemensam betydelse åt termer som kund, order eller aktivt konto. Härstamning visar var ett fält härstammar och hur det förändrats. Klassificering och policy bestämmer vem som kan komma åt känsliga poster och i vilket syfte.
Kvalitetsregler bör knytas till specifika användningsfall. Fullständighet som räcker för en instrumentpanel kan vara osäker för automatiserade beslut. Ett tyg bör visa aktualitet, valideringshistorik och kända begränsningar snarare än att bara märka en resurs som certifierad.
Datatyg, mesh och lakehouse
Data‑mesh är ett sociotekniskt tillvägagångssätt som tilldelar domänteam ansvar för interoperabla dataprodukter. Ett datatyg betonar gemensamma tekniska tjänster och metadata‑automatisering. Organisationer kan kombinera dem: domänägarskap kan fungera genom ett gemensamt tyg.
Ett lakehouse kombinerar data‑lake‑flexibilitet med lager‑liknande hantering och frågefunktioner. Det kan vara en deltagande plattform, men det är inte hela tvärsystem‑tyget. På samma sätt ger ett lager eller en katalog ensamt inte alla integrations‑ och policyfunktioner.
Implementering och utvärdering
Börja med ett värdefullt tvärsystem‑användningsfall och inventera de minsta källorna, ägarna, policyerna och service‑nivåförväntningarna. Etablera identitet, metadata‑standarder, avtal, testning och observerbarhet innan automatiserade rekommendationer läggs till.
Mät upptäckts‑tid, tid för åtkomst‑godkännande, incidentfrekvens, data‑aktualitet, återanvändning och konsumentförtroende. Koppla tygnet till styrning av strukturerad och ostrukturerad data samt cybersäkerhet; anslutning utan kontroll kan öka exponeringen.
Datatyg‑arkitektur och metadata‑plan
Ett datatyg är ett arkitekturtillvägagångssätt för att koppla distribuerad data via gemensam metadata, styrning, integration och åtkomsttjänster. Det är inte en enda databas eller produkt. Källor kan förbli i lager, sjöar, operativa system, strömmar och SaaS‑plattformar medan kataloger beskriver dataset, härstamning spårar transformationer, policyer styr åtkomst och semantiska definitioner gör begrepp återanvändbara. Virtualisering, replikering, API:er och pipelines är kompletterande leveransmetoder som väljs utifrån latens, skala, källkapacitet och konsistensbehov.
Aktiv metadata fångar scheman, ägarskap, användning, kvalitet, klassificeringar, härstamning, frågemönster och operativa händelser och kan driva automatisering. En kunskapsgraf kan koppla affärskoncept till fysiska fält och policyer. Automatisering kan rekommendera join‑operationer, upptäcka drift, sprida klassificeringar eller dirigera incidenter, men härledd metadata kräver förtroende och förvaltning. En katalog som inte är kopplad till leverans och kontroll blir dokumentationsskuld; automatiserad integration utan semantiskt ägarskap skapar snabbare inkonsekvens.
Integration, styrning och dataprodukter
Batch‑ETL, change‑data capture, strömmar, federation och reverse‑ETL har olika aktualitets‑ och fel‑semantiker. Definiera auktoritativa källor, identifierare, avtal, händelsetid, försenad data, radering och avstämning. Virtuella frågor undviker kopior men beror på källprestanda och tillgänglighet; materialisering förbättrar hastigheten men skapar skyldigheter gällande aktualitet och lagring. Känslig policy måste följas eller omprövas för härledd data, cache, inbäddningar och export.
Behandla högvärdiga dataset som produkter med ägare, användare, dokumentation, serviceförväntningar, tester och support. Federerat ägarskap låter domäner hantera betydelse medan gemensamma standarder bevarar interoperabilitet. Centrala team tillhandahåller plattformsfunktioner och styrning, inte ägande av varje fält. Mät upptäckts‑tid, återanvändning, datakvalitet, åtkomst‑ledtid, incidentlösning, antagande av betrodda mått och kostnad. Antalet katalogposter eller anslutningar är inte bevis på att människor kan hitta och använda pålitlig data.
Implementeringsstrategi
Börja med en tvärdomän‑resa vars förseningar och risker är kända. Inventera källor och avtal, etablera identitet och klassificering, koppla ihop härstamning och kvalitet, och automatisera återkommande kontroller. Undvik ett flerårigt försök att modellera hela företaget innan värde levereras. Testa källavbrott, schemaändring, återkallad åtkomst, sena händelser och katastrofåterställning. Ett datatyg lyckas när distribuerad data blir enklare att styra och använda utan att sudda ut de operativa realiteterna och ansvarigheten i de system där den härstammar.
Arbetsexempel: ett kunddatatyg
Ett företag kopplar ihop handel, support, marknadsföring och produktdata samtidigt som operativa system förblir auktoritativa. En gemensam katalog länkar kund-, konto-, order-, samtycke- och interaktionsdefinitioner till fysiska fält. Change‑data capture levererar styrda produkter, medan virtualisering hanterar lågvolymens aktuella uppslag och materialiserade tabeller stödjer analys. Identitet, härstamning, kvalitet och policy implementeras innan ett AI‑personalisering lager får använda datan.
En återkallelse av samtycke sprids genom lager‑tabeller, sökindex, inbäddningar och aktiveringssystem, med bevis på slutförande. Schemakontrakt och avstämningstester upptäcker källförändringar. Ägare publicerar förväntningar på aktualitet och kvalitet, och användningsmetadata hjälper till att avveckla oanvända kopior. Pilotprojektet mäter åtkomst‑ledtid, återanvändning av betrodda mått, incidentlösning och efterlevnad av sekretess. Tygnet anses framgångsrikt eftersom en tvärdomän‑resa blir pålitlig och styrbar – inte för att en leverantör kopplat det största antalet källor.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera de avsedda användarna, driftsmiljön, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, sekretess och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela befogenhet för release, undantag, förändringar, återgång och avveckling. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska verkliga bevis efter utrullning istället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återställning, incidentlärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Flyttar ett datatyg all data till ett ställe?
Nej. Det kan samordna data som förblir distribuerade och välja fysisk förflyttning eller virtualisering per arbetsbelastning.
Är ett datatyg detsamma som en data‑mesh?
Nej. Tygnet beskriver främst möjliggörande arkitektur och automatisering; mesh beskriver främst decentraliserat domänägarskap och ansvar för dataprodukter. De kan samexistera.
Primära referenser