
Grunderna i AI
Generativa vs. diskriminativa maskininlärningsmodeller

 Lägg till Unite.AI bland dina föredragna källor på Google
Generativ och diskriminativ beskriver vad en modell lär sig om data och mål. Vid klassisk övervakad klassificering lär en generativ modell sig en gemensam fördelning såsom P(x, y) eller klass‑villkorlig P(x|y), medan en diskriminativ modell lär sig P(y|x) eller en direkt beslutsgräns.
Distinktionen är användbar, men moderna system kombinerar ofta mål. En modell kan lära sig generativa representationer och senare finjusteras för diskriminativ prediktion, eller dela en gemensam bas mellan generering och klassificering.
Viktiga slutsatser
- Generativa klassificerare modellerar hur indata och etiketter uppstår; diskriminativa klassificerare modellerar etiketten givet indata eller en gräns.
- Generativa antaganden kan hjälpa när märkta data är begränsade, men kan också vara felaktiga.
- Diskriminativa metoder fokuserar ofta kapaciteten på prediktionsuppgiften och kan uppnå lägre asymptotiskt klassificeringsfel.
- GAN‑ar, VAE‑er och språkmodeller är generativa system, men ”generativ” betyder inte att varje komponent är en generativ klassificerare.
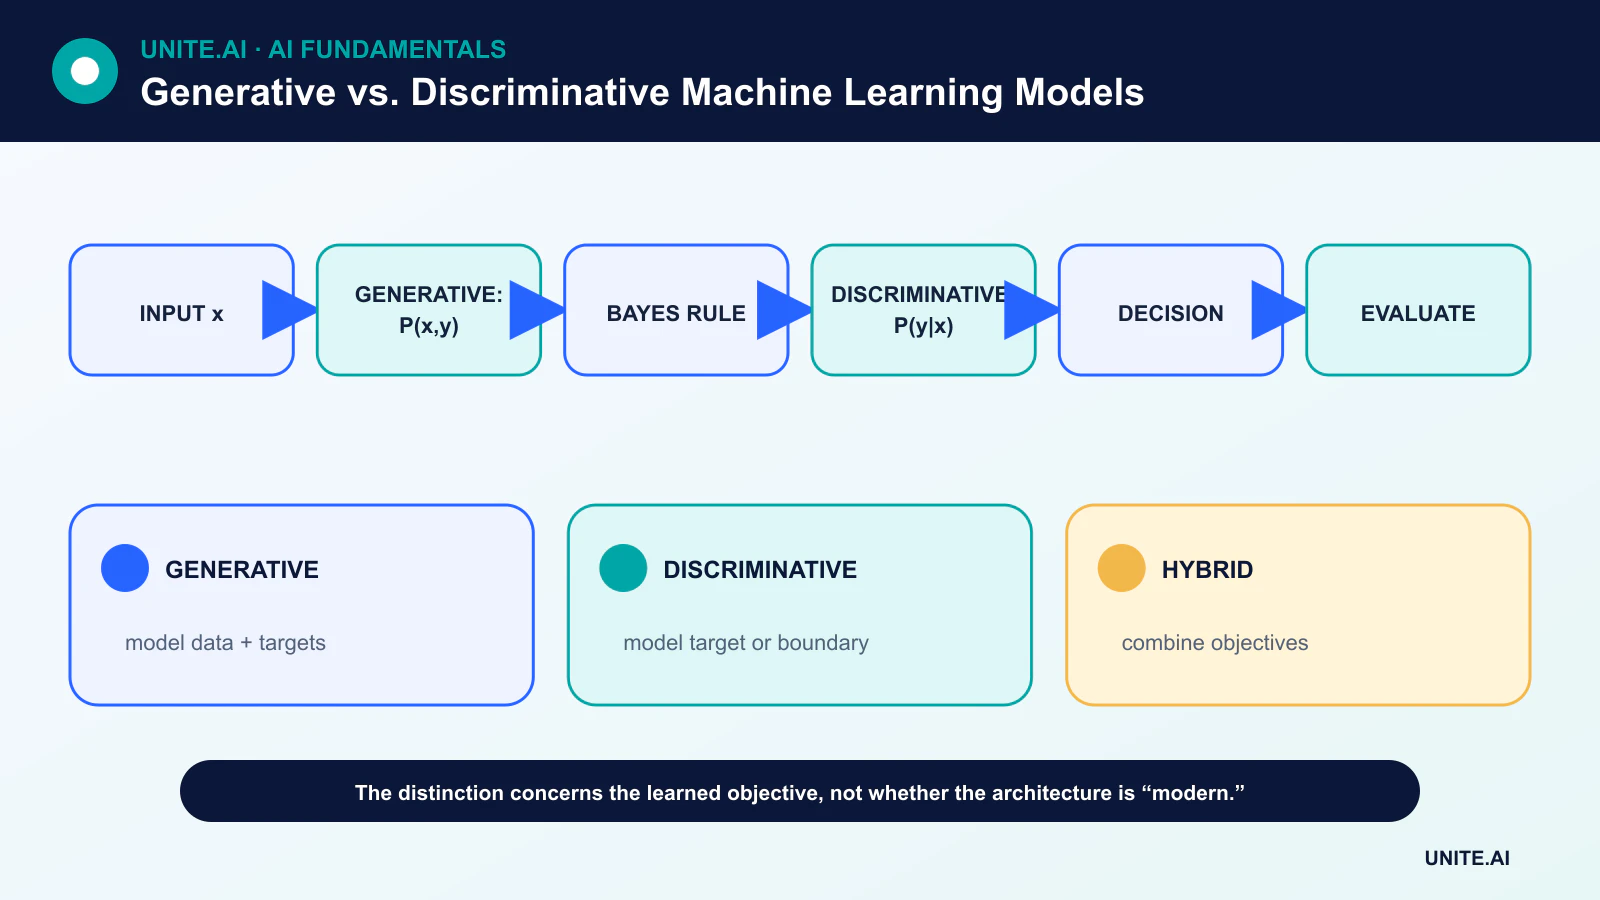
Sannolikhetsfaktorisering
En generativ klassificerare kan uppskatta P(x|y) och P(y) och sedan använda Bayes sats för att härleda P(y|x). Naiv Bayes är ett klassiskt exempel. En diskriminativ klassificerare såsom logistisk regression uppskattar P(y|x) direkt; en SVM lär sig en separerande gräns.
Att modellera P(x,y) är en bredare uppgift än att förutsäga y från x. Den extra strukturen kan stödja sampling eller resonemang kring saknade data, men kräver också antaganden om indatafördelningen.
Dataeffektivitet och asymptotiskt beteende
Ng och Jordans jämförelse av Naiv Bayes och logistisk regression visade en användbar avvägning: under deras antaganden kan den generativa modellen närma sig sin begränsande prestanda med färre exempel, medan den diskriminativa modellen kan uppnå ett lägre asymptotiskt fel.
Detta är ingen universell rangordning. Resultaten beror på om modellfamiljen passar data, dimensionen, regularisering, optimering och etikettkvalitet. Empirisk jämförelse på en representativ valideringsdesign förblir avgörande.
Representativa modellfamiljer
Generativa modeller inkluderar klass‑villkorliga fördelningar, dolda Markov‑modeller, blandningsmodeller, variational autoencoders, autoregressiva språkmodeller, diffusionsmodeller och GAN‑ar.
Diskriminativa modeller inkluderar logistisk regression, besluts‑träd, villkorliga randomfält, supportvektormaskiner och neurala klassificerare. Samma neurala bas kan delta i båda kategorierna beroende på dess träningsmål och output.
Hybrid‑ och själv‑superviserade system
En förtränad språk‑ eller bildmodell kan lära sig från omärkta data med ett generativt eller själv‑supervisoriskt mål, och sedan få ett diskriminativt huvud för en måluppgift. Halv‑superviserade metoder kan optimera märkt klassificering och ett omärkt‑data‑mål samtidigt.
Hybridisering gör arkitektur‑etiketter mindre informativa än hela träningspipeline. Dokumentation bör ange mål, data, utdata och avsedd inferens – inte bara kalla en modell generativ.
Att välja mellan tillvägagångssätt
Använd uppgiften för att besluta. Om målet är en kalibrerad gräns med rikligt med etiketter är en diskriminativ modell ett naturligt grundläggande alternativ. Om sampling, täthetsuppskattning, saknad‑datstruktur eller omärkta data är centrala kan en generativ komponent vara till hjälp.
Jämför robusthet, prov‑effektivitet, beräkningskostnad, sannolikhet eller kalibrering efter behov. Ett bra genererat prov bevisar inte en bra klassificerare, och en hög‑noggrann klassificerare innebär inte en realistisk modell av indatafördelningen.
Riktningar för sannolikhet och modelleringsmål
En diskriminativ modell lär sig en gräns eller villkorlig fördelning P(y|x): givet funktioner x, förutsäga etikett y. Logistisk regression, supportvektormaskiner, villkorliga randomfält och många klassificerare är diskriminativa. En generativ modell lär sig en gemensam fördelning P(x,y), en klass‑villkorlig fördelning P(x|y) eller en ovillkorlig datadistribution, vilket möjliggör sampling eller sannolikhetsrelaterade uppgifter. Naiv Bayes och linjär diskriminantanalys är generativa klassificerare; GAN‑ar, variational autoencoders, diffusionsmodeller och autoregressiva modeller genererar data genom olika mål.
Distinktionen gäller vilken fördelning eller beslutsregel som modelleras, inte huruvida ett neuralt nätverk används. En generativ språkmodell kan promptas att klassificera, medan en diskriminativ omranker kan styra generering. Generativa antaganden kan förbättra dataeffektivitet eller hantera saknade variabler men medför risk för felaktig modellering. Diskriminativa metoder excellerar ofta med rikligt med märkta data eftersom de fokuserar direkt på prediktionsgränsen. Jämför familjer under lika funktioner, data, fininställning och beräkningsresurser snarare än att betrakta en kategori som universellt överlägsen.
Träning och utvärdering per användningsfall
Klassificeringsutvärdering använder precision, återkallelse, kalibrering, robusthet och felkostnad. Generativ utvärdering måste ta hänsyn till trovärdighet, mångfald, täckning, sannolikhet eller uppgiftens nytta, memorering och säkerhet. En modell kan producera attraktiva prover samtidigt som den missar vissa lägen, eller uppnå god sannolikhet med dålig perceptuell output. Nyttan av syntetiska data bör testas genom att träna och utvärdera nedströmsmodeller på oberoende verkliga data, inklusive sällsynta grupper. Håll testdata utanför genereringspromptar och urval.
Vid halv‑supervised inlärning kan en generativ modell utnyttja omärkt struktur; vid avvikelsedetektion kan sannolikhet misslyckas när data utanför fördelningen får hög densitet av irrelevanta skäl. Vid återhämtnings‑förstärkt generering bildar en generativ svarmodell och en diskriminativ återhämtare eller omranker en hybrid. Diagnostisera steg separat så att flytande output inte döljer återhämtningsfel. Välj den dekomposition som gör bevis och kontroll observerbara.
Driftsättning och styrning
Generativa system tillför risker för innehålls‑ursprung, immateriella rättigheter, personifiering, prompt‑injektion och output‑moderering; diskriminativa system tillför risker för tröskel, förnekelse och ojämna fel. Båda kräver datarättigheter, säkra artefakter, versionshantering, representativa tester, övervakning och mänsklig myndighet proportionell mot konsekvensen. Följ det exakta målet och output‑semantiken i dokumentationen. Generativ kontra diskriminativ är en användbar statistisk distinktion, men verkliga system kombinerar dem ofta, och tillförlitlighet beror på hela data‑ och besluts‑pipeline.
Arbetsexempel: klassificering och generering av support‑svar
En supportplattform använder en diskriminativ klassificerare för att identifiera ärendetyp och brådska samt en generativ modell för att utarbeta ett svar utifrån godkända policyer. Klassificeraren utvärderas med klass‑specifik återkallelse och kalibrering; återhämtaren med evidens‑återkallelse; generatorn med förankring, korrekthet och avslag. Varje steg har ett okänt utfall, och den generativa modellen kan inte förändra klassificering eller kundens rättigheter genom övertygande text.
Agenten ser den förutsagda rutten, källorna och utkastet och godkänner eller korrigerar innan utskick. Behörighetsfilter tillämpas före återhämtning, och prompt‑injektion i kundtext kan inte auktorisera verktyg. Övervakning separerar routningsfel, återhämtningsluckor, icke‑stödda påståenden och agentredigeringar. En policyändring uppdaterar källorna omedelbart och triggar regressionstester; fininställning reserveras för stabilt beteende. Den hybrida designen utnyttjar diskriminativa och generativa styrkor samtidigt som den bevarar bevis och mänsklig auktoritet.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning före fininställning. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från ett attraktivt prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indatakvalitet, output‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larm‑trösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incident‑lärande, raderings‑ och behållningsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är en GAN‑s diskriminator en diskriminativ modell?
Den utför diskriminering under träning, men den övergripande GAN‑en är ett generativt ramverk vars output produceras av generatorn.
Är diskriminativ inlärning alltid övervakad?
Nej. Begreppet beskriver den modellerade relationen eller gränsen, medan övervakning beskriver träningssignalen. Moderna mål kan sudda ut kategorierna.
Primära referenser












