

AI-modeller och plattformar
AniPortrait: Audio-Driven Synthesis of Fotorealistiska Porträttanimationer

 Lägg till Unite.AI bland dina föredragna källor på Google
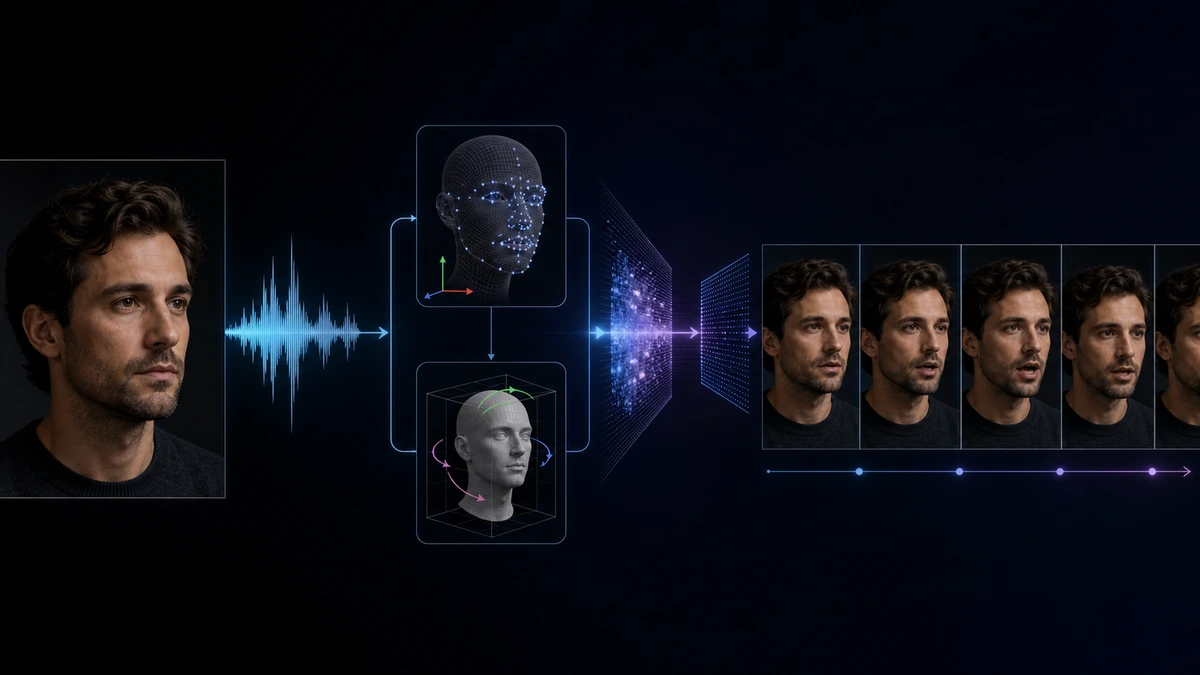
Under åren har skapandet av realistiska och uttrycksfulla porträttanimationer från statiska bilder och ljud funnit en rad tillämpningar, inklusive spel, digitala medier, virtuell verklighet och mycket mer. Trots dess potentiala tillämpning är det fortfarande svårt för utvecklare att skapa ramverk som kan generera högkvalitativa animationer som upprätthåller tidsmässig konsekvens och är visuellt tilltalande. En stor orsak till komplexiteten är behovet av intrikat samordning av läpprörelser, huvudpositioner och ansiktsuttryck för att skapa en visuellt tilltalande effekt.
I den här artikeln kommer vi att prata om AniPortrait, ett nytt ramverk som är utformat för att generera högkvalitativa animationer som drivs av en referensporträttbild och en ljudprov. AniPortraits ramverk är indelat i två faser. Först extraherar AniPortraits ramverk de mellanliggande 3D-representationerna från ljudproven och projicerar dem sedan till en sekvens av 2D-ansiktslandmärken. Därefter använder ramverket en robust diffusionsmodell kombinerad med en rörelsemodul för att omvandla landmärkessekvensen till tidsmässigt konsekventa och fotorealistiska animationer. De experimentella resultaten visar AniPortraits ramverks överlägsenhet och förmåga att generera högkvalitativa animationer med exceptionell visuell kvalitet, posdiversitet och ansiktsnaturlighet, vilket erbjuder en förbättrad och berikad perceptuell upplevelse. Dessutom har AniPortraits ramverk ett remarkabelt potential i termer av kontrollerbarhet och flexibilitet, och kan tillämpas effektivt inom områden som ansiktsreenactment, ansiktsrörelseredigering och mer. Den här artikeln syftar till att täcka AniPortraits ramverk i djupet, och vi utforskar mekanismen, metodiken, arkitekturen i ramverket samt dess jämförelse med state-of-the-art-ramverk. Så låt oss komma igång.
AniPortrait: Fotorealistiska Porträttanimationer
Att skapa realistiska och uttrycksfulla porträttanimationer har varit fokus för forskare under en längre tid på grund av dess otroliga potential och tillämpningar som sträcker sig från digitala medier och virtuell verklighet till spel och mer. Trots år av forskning och utveckling är det fortfarande en betydande utmaning att producera högkvalitativa animationer som upprätthåller tidsmässig konsekvens och är visuellt tilltalande. En stor hinder för utvecklare är behovet av intrikat samordning mellan huvudpositioner, visuella uttryck och läpprörelser för att skapa en visuellt tilltalande effekt. Existerande metoder har misslyckats med att tackla dessa utmaningar, främst eftersom de flesta av dem förlitar sig på begränsade kapacitetsgenererare som NeRF, rörelsebaserade avkodare och GAN för visuell innehållsskapelse. Dessa nätverk visar begränsad generaliseringsförmåga och är instabila vid generering av högkvalitativt innehåll. Men den nyliga uppkomsten av diffusionsmodeller har möjliggjort generering av högkvalitativa bilder, och vissa ramverk byggda på diffusionsmodeller tillsammans med tidsmässiga moduler har möjliggjort skapandet av övertygande videor, vilket gör att diffusionsmodellerna kan utmärka sig.
Genom att bygga på de senaste framstegen inom diffusionsmodeller syftar AniPortraits ramverk till att generera högkvalitativa animerade porträtt med hjälp av en referensbild och ett ljudprov. AniPortraits ramverk är indelat i två faser. I den första fasen använder AniPortraits ramverk transformer-baserade modeller för att extrahera en sekvens av 3D-ansiktsnät och huvudpose från ljudinmatning, och projicerar dem sedan till en sekvens av 2D-ansiktslandmärken. Den första fasen möjliggör för AniPortraits ramverk att fånga läpprörelser och subtila uttryck från ljudet, samt huvudrörelser som synkroniserar med rytmen i ljudprovet. Den andra fasen använder AniPortraits ramverk en robust diffusionsmodell och integrerar den med en rörelsemodul för att omvandla landmärkessekvensen till en fotorealistisk och tidsmässigt konsekvent animerad porträtt. För att vara mer specifik bygger AniPortraits ramverk på nätverksarkitekturen från den existerande AnimateAnyone-modellen, som använder Stable Diffusion 1.5, en potent diffusionsmodell, för att generera livliga och flytande rörelser baserat på en referensbild och en kroppsrörelsesekvens. Vad som är värt att notera är att AniPortraits ramverk inte använder poseguidermodulen inom detta nätverk, som den är implementerad i AnimateAnyone-ramverket, men omformar den, vilket möjliggör för AniPortraits ramverk att inte bara upprätthålla en lättviktig design utan också visa förbättrad precision vid generering av läpprörelser.
De experimentella resultaten visar AniPortraits ramverks överlägsenhet vid skapandet av animationer med imponerande ansiktsnaturlighet, utmärkt visuell kvalitet och varierande poser. Genom att använda 3D-ansiktsrepresentationer som mellanliggande funktioner vinner AniPortraits ramverk flexibiliteten att modifiera dessa representationer enligt dess behov. Den betydande flexibiliteten förbättrar avsevärt tillämpbarheten av AniPortraits ramverk inom områden som ansiktsreenactment och ansiktsrörelseredigering.
AniPortrait: Arbete och Metodik
Det föreslagna AniPortraits ramverk består av två moduler, nämligen Lmk2Video och Audio2Lmk. Audio2Lmk-modulen försöker extrahera en sekvens av landmärken som fångar intrikata läpprörelser och ansiktsuttryck från ljudinmatning, medan Lmk2Video-modulen använder denna landmärkessekvens för att generera högkvalitativa porträttvideor med tidsmässig stabilitet. Följande figur presenterar en översikt av AniPortraits ramverks funktion. Som det kan observeras extraherar AniPortraits ramverk först 3D-ansiktsnätet och huvudposen från ljudet och projicerar dessa två element till 2D-nyckelpunkter. I den andra fasen använder ramverket en diffusionsmodell för att omvandla 2D-nyckelpunkterna till en porträttvideo, med två faser som tränas samtidigt inom nätverket.

Audio2Lmk
För en given sekvens av talutklipp är det primära målet för AniPortraits ramverk att förutsäga den motsvarande 3D-ansiktsnätsekvensen med vektorrepresentationer av translation och rotation. AniPortraits ramverk använder den förtränade wav2vec-metoden för att extrahera ljudfunktioner, och modellen visar en hög grad av generaliseringsförmåga och är kapabel att känna igen intonation och uttal från ljudet på ett korrekt sätt, vilket spelar en avgörande roll vid generering av realistiska ansiktsanimationer. Genom att utnyttja de erhållna robusta tal funktionerna kan AniPortraits ramverk effektivt använda en enkel arkitektur bestående av två fc-lager för att omvandla dessa funktioner till 3D-ansiktsnät. AniPortraits ramverk observerar att denna enkla design som implementeras av modellen inte bara förbättrar effektiviteten i inferensprocessen, utan också säkerställer noggrannhet. När det gäller att omvandla ljud till pose använder AniPortraits ramverk samma wav2vec-nätverk som bakkroppen, även om modellen inte delar vikt med ljud-till-mesh-modulen. Det är huvudsakligen på grund av att posen är associerad mer med ton och rytm som finns i ljudet, vilket har en annan betoning jämfört med ljud-till-mesh-uppgifter. För att ta hänsyn till effekten av tidigare tillstånd använder AniPortraits ramverk en transformer-dekoder för att dekodera possekvensen. Under denna process integrerar ramverket ljudfunktionerna i dekodern med hjälp av cross-attention-mekanismer, och för båda modulerna tränar ramverket dem med hjälp av L1-förlust. När modellen erhåller pose- och nätsekvensen använder den perspektivprojektion för att omvandla dessa sekvenser till en 2D-sekvens av ansiktslandmärken som sedan används som inmatningssignaler för den efterföljande fasen.
Lmk2Video
För en given referensporträttbild och en sekvens av ansiktslandmärken skapar Lmk2Video-modulen en tidsmässigt konsekvent porträttanimation, och denna animation synkroniserar rörelsen med landmärkessekvensen, och upprätthåller ett utseende som är konsekvent med referensbilden, och slutligen representerar porträttanimationen som en sekvens av porträttbilder. Lmk2Videos nätverksstruktur söker inspiration från den existerande AnimateAnyone-ramverket. AniPortraits ramverk använder Stable Diffusion 1.5, en extremt potent diffusionsmodell, som dess bakkropp, och integrerar en tidsmässig rörelsemodul som effektivt omvandlar multifram-noise-inmatningar till en sekvens av video-ramar. Samtidigt använder en ReferencenNet-nätverkskomponent samma struktur som Stable Diffusion 1.5, och använder den för att extrahera utseendefunktioner från referensbilden, och integrerar dem i bakkroppen. Den strategiska designen säkerställer att ansikts-ID förblir konsekvent genom hela utgångsvideon. Till skillnad från AnimateAnyone-ramverket förbättrar AniPortraits ramverk komplexiteten i PoseGuiders design. Den ursprungliga versionen av AnimateAnyone-ramverket består endast av ett fåtal convolution-lager efter vilka landmärkesfunktionerna sammanfogas med latenter i ingångslagret till bakkroppen. AniPortraits ramverk upptäcker att designen brister i att fånga intrikata rörelser av läpparna, och för att tackla detta problem antar ramverket den multi-skala-strategin i ConvNet-arkitekturen, och integrerar landmärkesfunktioner av motsvarande skalor i olika block i bakkroppen. Dessutom introducerar AniPortraits ramverk en ytterligare förbättring genom att inkludera landmärkena från referensbilden som en extra inmatning. Cross-attention-modulen i PoseGuider-komponenten möjliggör interaktionen mellan mål-landmärkena för varje ram och referens-landmärkena. Denna process ger nätverket ytterligare ledtrådar för att förstå korrelationen mellan utseende och ansiktslandmärken, vilket hjälper till att generera porträttanimationer med mer exakt rörelse.
AniPortrait: Implementering och Resultat
För Audio2Lmk-fasen använder AniPortraits ramverk wav2vec2.0-komponenten som dess bakkropp, och utnyttjar MediaPipe-arkitekturen för att extrahera 3D-nät och 6D-poser för annoteringar. Modellen hämtar träningsdata för Audio2Mesh-komponenten från sin interna dataset som består av nästan 60 minuters högkvalitativa taldata från en enskild talare. För att säkerställa att 3D-nätet som extraheras av MediaPipe-komponenten är stabilt instrueras röstskådespelaren att möta kameran och upprätthålla en stabil huvudposition under hela inspelningen. För Lmk2Video-modulen implementerar AniPortraits ramverk en två-stegs-träningsansats. I den första fasen fokuserar ramverket på att träna ReferenceNet och PoseGuider, den 2D-komponenten i bakkroppen, och lämnar ut rörelsemodulen. I den andra fasen fryser ramverket alla andra komponenter och koncentrerar sig på att träna rörelsemodulen. För denna fas använder ramverket två stora högkvalitativa ansiktsvideo-dataset för att träna modellen, och bearbetar all data med hjälp av MediaPipe-komponenten för att extrahera 2D-ansiktslandmärken. Dessutom, för att förbättra känsligheten för nätverket mot läpprörelser, differentierar AniPortraits modell de övre och nedre läpparna med olika färger när den renderar pose-bilden från 2D-landmärken.
Som visas i följande bild genererar AniPortraits ramverk en serie animationer som visar överlägsen kvalitet och realism.

Ramverket använder sedan en mellanliggande 3D-representation som kan redigeras för att manipulera utgången enligt behov. Till exempel kan användare extrahera landmärken från en viss källa och ändra dess ID, vilket möjliggör för AniPortraits ramverk att skapa en ansiktsreenactment-effekt.
Slutliga Tankar
I den här artikeln har vi talat om AniPortrait, ett nytt ramverk som är utformat för att generera högkvalitativa animationer som drivs av en referensporträttbild och ett ljudprov. Genom att enkelt mata in en referensbild och ett ljudklipp kan AniPortraits ramverk generera en porträttvideo som visar naturlig rörelse av huvudet och smidig läpprörelse. Genom att utnyttja den robusta generaliseringsförmågan hos diffusionsmodellen genererar AniPortraits ramverk animationer som visar imponerande realistisk bildkvalitet och livliknande rörelse. AniPortraits ramverks funktion är indelat i två faser. Först extraherar AniPortraits ramverk de mellanliggande 3D-representationerna från ljudproven och projicerar dem sedan till en sekvens av 2D-ansiktslandmärken. Därefter använder ramverket en robust diffusionsmodell kombinerad med en rörelsemodul för att omvandla landmärkessekvensen till tidsmässigt konsekventa och fotorealistiska animationer. De experimentella resultaten visar AniPortraits ramverks överlägsenhet och förmåga att generera högkvalitativa animationer med exceptionell visuell kvalitet, posdiversitet och ansiktsnaturlighet, vilket erbjuder en förbättrad och berikad perceptuell upplevelse. Dessutom har AniPortraits ramverk ett remarkabelt potential i termer av kontrollerbarhet och flexibilitet, och kan tillämpas effektivt inom områden som ansiktsreenactment, ansiktsrörelseredigering och mer.


