
Andersons vinkel
En forensisk data metod för en ny generation av deepfakes

 Lägg till Unite.AI bland dina föredragna källor på Google

Även om deepfaking av privata individer har blivit ett växande allmänt problem och alltmer kriminaliseras i olika regioner, är det fortfarande extremt svårt att bevisa att en användarskapad modell – såsom en som möjliggör hämndporr – specifikt har tränats på en viss persons bilder.
För att sätta problemet i perspektiv: en nyckelelement i en deepfake-attack är att falskeligen påstå att en bild eller video föreställer en specifik person. Att enbart påstå att någon i en video är identitet #A, snarare än bara en lookalike, är tillräckligt för att skapa skada, och ingen AI är nödvändig i detta scenario.
Men om en angripare genererar AI-bilder eller videor med hjälp av modeller som tränats på riktiga personers data, kommer sociala medier och sökmotors ansiktsigenkänningssystem automatiskt att koppla den fejkade innehållet till offret – utan att kräva namn i inlägg eller metadata. De AI-genererade visuella ensam säkerställer associationen.
Ju mer distinkt personens utseende är, desto mer oundvikligt blir detta, tills den fejkade innehållet dyker upp i bildsökningar och slutligen når offret.
Ansikte mot ansikte
Den vanligaste metoden för att sprida identitetsfokuserade modeller är för närvarande genom Low-Rank Adaptation (LoRA), där användaren tränar en liten mängd bilder under några timmar mot vikterna i en mycket större grundmodell som Stable Diffusion (för statiska bilder, mest) eller Hunyuan Video, för video-deepfakes.
De vanligaste målen för LoRAs, inklusive den nya generationen av video-baserade LoRAs, är kvinnliga kändisar, vars berömmelse utsätter dem för denna typ av behandling med mindre allmän kritik än i fallet med ‘okända’ offer, på grund av antagandet att sådana derivatverk omfattas av ‘fair use’ (åtminstone i USA och Europa).

Kvinnliga kändisar dominerar LoRA- och Dreambooth-listorna på civit.ai-portalen. Den mest populära LoRA har för närvarande över 66 000 nedladdningar, vilket är betydande med tanke på att denna användning av AI fortfarande ses som en ‘fringe’-aktivitet.
Det finns ingen offentlig plattform för de icke-kända offren för deepfaking, som bara dyker upp i media när åtal väcks eller offren uttalar sig i populära kanaler.
Men i båda scenarierna har modellerna som används för att fejka målidentiteterna “destillerat” sin träningsdata så fullständigt in i latentrummet i modellen att det är svårt att identifiera de källbilder som användes.
Om det var möjligt att göra detta inom en acceptabel felmarginal, skulle detta möjliggöra åtal mot dem som delar LoRAs, eftersom det inte bara bevisar avsikt att deepfake en specifik identitet (dvs. en viss ‘okänd’ persons), utan också utsätter uppladdaren för upphovsrättsintrång, där tillämpligt.
Det sistnämnda skulle vara användbart i jurisdiktioner där lagreglering av deepfaking-teknologier saknas eller ligger efter.
Överexponerad
Målet med att träna en grundmodell, såsom den flera gigabyte stora grundmodell som en användare kan ladda ner från Hugging Face, är att modellen ska bli väl-generaliserad och formbar. Detta innebär att träna på ett tillräckligt antal olika bilder och med lämpliga inställningar, och avsluta träningen innan modellen “överanpassar” sig till data.
En överanpassad modell har sett data så många gånger (i överkant) under träningsprocessen att den tenderar att reproducera bilder som är mycket lika, vilket exponerar källan till träningsdata.

Identiteten ‘Ann Graham Lotz’ kan nästan perfekt återskapas i Stable Diffusion V1.5-modellen. Rekonstruktionen är nästan identisk med träningsdata (till vänster i bilden ovan). Källa: https://arxiv.org/pdf/2301.13188
Men överanpassade modeller kasseras vanligtvis av sina skapare snarare än distribueras, eftersom de i alla fall är olämpliga för ändamålet. Därför är detta en osannolik forensisk “vinst”. I alla fall gäller principen mer för den dyra och högvolymsträningen av grundmodeller, där flera versioner av samma bild som har letat sig in i en stor källdatabas kan göra vissa träningsbilder lätta att åberopa (se bild och exempel ovan).
Saker och ting är lite annorlunda i fallet med LoRA- och Dreambooth-modeller (även om Dreambooth har fallit ur mode på grund av dess stora filstorlek). Här väljer användaren ett mycket begränsat antal olika bilder av ett ämne och använder dem för att träna en LoRA.

Till vänster, utdata från en Hunyuan Video LoRA. Till höger, de data som gjorde likheten möjlig (bilder använda med tillstånd av den avbildade personen).
Ofta har LoRA en tränad utlösande ord, såsom [namnet på kändisen]. Men ofta dyker den specifikt tränade ämnet upp i genererad utdata även utan sådana prompter, eftersom även en välbalanserad (dvs. inte överanpassad) LoRA är något “fixerad” vid det material den tränats på och tenderar att inkludera det i all utdata.
Denna predisposition, kombinerad med det begränsade antalet bilder som är optimalt för en LoRA-databas, utsätter modellen för forensisk analys, som vi strax ska se.
Avslöja datat
Dessa frågor behandlas i en ny artikel från Danmark, som erbjuder en metod för att identifiera källbilder (eller grupper av källbilder) i en svart låda Medlemskapsinferensattack (MIA). Metoden omfattar i viss mån användning av anpassat tränade modeller som är utformade för att hjälpa till att avslöja källdata genom att generera sina egna “deepfakes”:

Exempel på ‘falska’ bilder genererade av den nya metoden, vid alltmer ökande nivåer av Classifier-Free Guidance (CFG), upp till förstöring. Källa: https://arxiv.org/pdf/2502.11619
Även om arbetet, med titeln Medlemskapsinferensattacker för ansiktsbilder mot fine-tuned latent difussion-modeller, är ett mycket intressant bidrag till litteraturen kring detta specifika ämne, är det också en otillgänglig och knapphändigt skriven artikel som behöver avkodas. Därför kommer vi att täcka åtminstone de grundläggande principerna bakom projektet här, samt ett urval av de resultat som erhållits.
I själva verket, om någon finjusterar en AI-modell på ditt ansikte, kan författarnas metod hjälpa till att bevisa det genom att leta efter avslöjande tecken på memorering i modellens genererade bilder.
I första hand finjusteras en målmodell på en dataset med ansiktsbilder, vilket gör den mer benägen att reproducera detaljer från dessa bilder i sin utdata. Därefter tränas en klassificeringsattackmodell med hjälp av AI-genererade bilder från målmodellen som “positiva” exempel (misstänkta medlemmar i träningsuppsättningen) och andra bilder från en annan dataset som “negativa” exempel (icke-medlemmar).
Genom att lära sig de subtila skillnaderna mellan dessa grupper kan attackmodellen förutsäga om en given bild var en del av den ursprungliga finjusteringsdataseten.
Attacken är mest effektiv i fall där AI-modellen har finjusterats omfattande, vilket innebär att ju mer en modell specialiseras, desto lättare är det att upptäcka om vissa bilder användes. Detta gäller i allmänhet för LoRAs som är utformade för att återskapa kändisar eller privata individer.
Författarna fann också att tillägg av synliga vattenmärken till träningsbilder gör upptäckt lättare. Dolda vattenmärken hjälper dock inte så mycket.
Impressivt är att metoden testas i en svart låda-miljö, vilket innebär att den fungerar utan tillgång till modellens interna detaljer, endast dess utdata.
Metoden som används är beräkningsintensiv, som författarna medger; men värdet av detta arbete ligger i att visa riktningen för ytterligare forskning, och att bevisa att data kan extraheras till en acceptabel tolerans; därför, med tanke på dess banbrytande natur, behöver det inte köras på en smartphone i detta skede.
Metod/Databas
Flera dataset från Danmarks Tekniska Universitet (DTU, värdinstitutionen för artikelförfattarnas tre forskare) användes i studien, för att finjustera målmodellen och för att träna och testa attackmodellen.
Databaser som användes var hämtade från DTU Orbit:
DseenDTU Den grundläggande bildsamlingen.
DDTU Bilder skrapade från DTU Orbit.
DseenDTU En partition av DDTU som användes för att finjustera målmodellen.
DunseenDTU En partition av DDTU som inte användes för att finjustera någon bildgenereringsmodell, utan istället användes för att testa eller träna attackmodellen.
wmDseenDTU En partition av DDTU med synliga vattenmärken som användes för att finjustera målmodellen.
hwmDseenDTU En partition av DDTU med dolda vattenmärken som användes för att finjustera målmodellen.
DgenDTU Bilder genererade av en Latent Diffusion Model (LDM) som har finjusterats på DseenDTU-bildsamlingen.
Databaser som användes för att finjustera målmodellen bestod av bild-textpar som kapitelades av BLIP-modellen (kanske inte av en slump en av de mest populära ocensurerade modellerna i den informella AI-gemenskapen).
BLIP ställdes in för att lägga till frasen ‘en dtu-huvudbild av en’ till varje beskrivning.
Flera dataset från Aalborgs universitet (AAU) användes också i testerna, alla hämtade från AU VBN-korpuset:
DAAU Bilder skrapade från AAU vbn.
DseenAAU En partition av DAAU som användes för att finjustera målmodellen.
DunseenAAU En partition av DAAU som inte användes för att finjustera någon bildgenereringsmodell, utan istället användes för att testa eller träna attackmodellen.
DgenAAU Bilder genererade av en LDM som har finjusterats på DseenAAU-bildsamlingen.
Ekvivalent med de tidigare uppsättningarna, användes frasen ‘en aau-huvudbild av en’. Detta säkerställde att alla etiketter i DTU-databasen följde formatet ‘en dtu-huvudbild av en (…)’, vilket förstärkte databasens kärnegenskaper under finjustering.
Tester
Flera experiment genomfördes för att utvärdera hur väl medlemskapsinferensattackerna fungerade mot målmodellen. Varje test syftade till att avgöra om det var möjligt att utföra en lyckad attack inom det schema som visas nedan, där målmodellen finjusteras på en bild-dataset som erhållits utan auktorisering.

Schema för metoden.
Med den finjusterade modellen som frågades för att generera utdata-bilder, användes dessa bilder som positiva exempel för att träna attackmodellen, medan ytterligare orelaterade bilder inkluderades som negativa exempel.
Attackmodellen tränades med hjälp av övervakad inlärning och testades sedan på nya bilder för att avgöra om de ursprungligen var en del av dataseten som användes för att finjustera målmodellen. För att utvärdera attackens noggrannhet, avsattes 15% av testdatat för validering.
Eftersom målmodellen finjusteras på en känd dataset, är den faktiska medlemsstatusen för varje bild redan etablerad när träningsdatat för attackmodellen skapas. Detta kontrollerade setup möjliggör en tydlig utvärdering av hur effektivt attackmodellen kan skilja mellan bilder som var en del av finjusteringsdataseten och de som inte var det.
För dessa tester användes Stable Diffusion V1.5. Även om denna ganska gamla modell dyker upp mycket i forskning på grund av behovet av konsekvent testning och den omfattande samlingen av tidigare arbete som använder den, är detta ett lämpligt användningsfall; V1.5 förblev populär för LoRA-skapande i Stable Diffusion-hobbyistgemenskapen under lång tid, trots flera efterföljande versionssläpp, och även trots introduktionen av Flux – eftersom modellen är helt ocensurerad.
Forskarnas attackmodell baserades på Resnet-18, med modellens förtränade vikter behållna. ResNet-18:s 1000-neurons sista lager ersattes med ett fullständigt anslutet lager med två neuroner. Träningsförlust var kategorisk korsentropi, och Adam-optimisatorn användes.
För varje test tränades attackmodellen fem gånger med olika slumptal för att beräkna 95% konfidensintervall för nyckelmetrikerna. Zero-shot-klassificering med CLIP-modellen användes som baslinjen.
(Observera att den ursprungliga primära resultattabellen i artikeln är knapphändig och ovanligt svår att förstå. Därför har jag omformulerat den nedan i en mer användarvänlig form. Klicka på bilden för att se den i bättre upplösning)
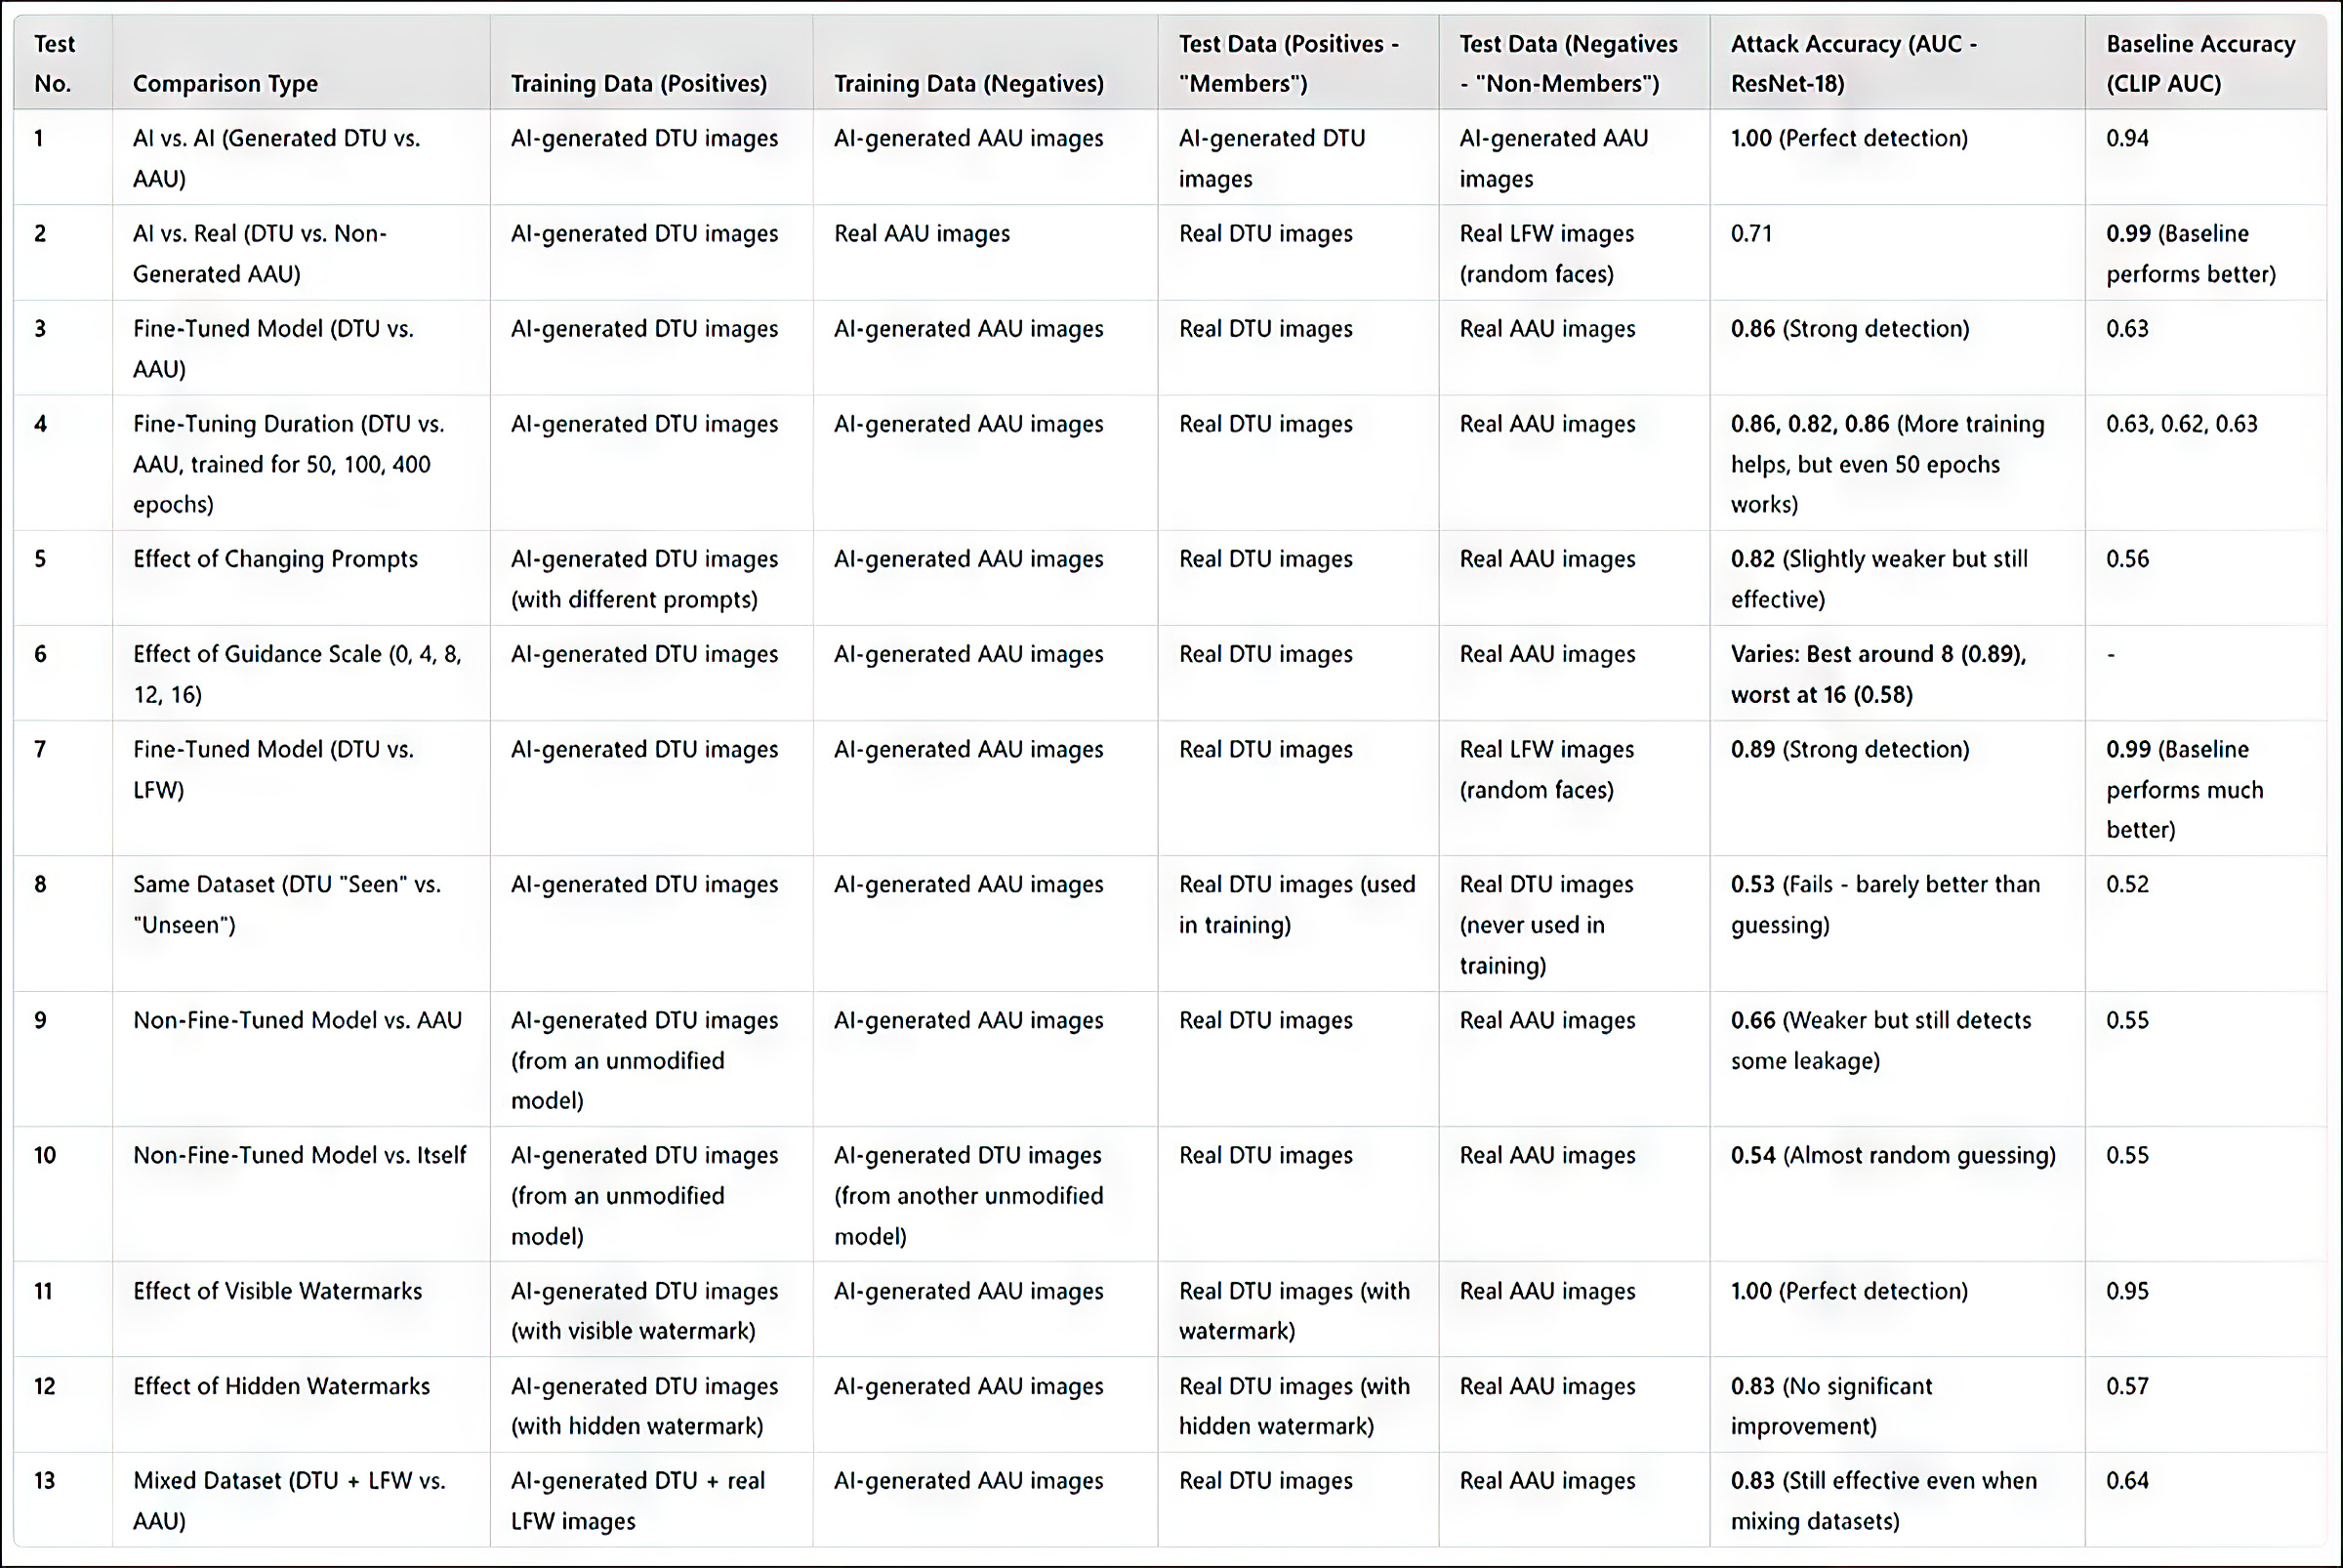
Sammanfattning av resultat från alla tester. Klicka på bilden för att se den i högre upplösning
Forskarnas attackmetod visade sig vara mest effektiv när den riktades mot finjusterade modeller, särskilt de som tränats på en specifik uppsättning bilder, såsom en persons ansikte. Men medan attacken kan avgöra om en dataset användes, har den svårt att identifiera enskilda bilder inom den dataseten.
I praktiska termer är det sistnämnda inte nödvändigtvis ett hinder för att använda en metod som denna forensiskt; medan det finns relativt liten värde i att fastställa att en känd dataset som ImageNet användes i en modell, tenderar en angripare mot en privat person (inte en kändis) att ha mycket mindre val av källdata och behöver fullt utnyttja tillgängliga datagrupper som sociala mediealbum och andra online-samlingar. Dessa skapar i princip en “hash” som kan avslöjas av de metoder som beskrivs.
Artikeln påpekar att ett annat sätt att förbättra noggrannheten är att använda AI-genererade bilder som “icke-medlemmar”, snarare än att enbart förlita sig på riktiga bilder. Detta förhindrar konstgjorda höga framgångsgrader som annars kan vilseleda resultaten.
En ytterligare faktor som påverkar upptäckt avsevärt, noterar författarna, är vattenmärkning. När träningsbilder innehåller synliga vattenmärken, blir attacken mycket effektiv, medan dolda vattenmärken erbjuder liten eller ingen fördel.

Den högra figuren visar det faktiska ‘dolda’ vattenmärket som användes i testerna.
Slutligen spelar nivån av vägledning i text-till-bild-generering också en roll, med den ideala balansen funnen vid en vägledningsskala på cirka 8. Även när ingen direkt prompt används, tenderar en finjusterad modell fortfarande att producera utdata som liknar dess träningsdata, vilket förstärker attackens effektivitet.
Slutsats
Det är synd att denna intressanta artikel har skrivits på ett sådant sätt att den är svår att nå, eftersom den borde vara av intresse för både integritetsförespråkare och informella AI-forskare.
Även om medlemskapsinferensattacker kan visa sig vara ett intressant och fruktbart forensiskt verktyg, är det kanske viktigare för denna forskningssträng att utveckla tillämpliga breda principer, för att förhindra att den hamnar i samma “whack-a-mole”-spel som har inträffat för deepfake-identifiering i allmänhet, när utgåvan av en nyare modell negativt påverkar identifiering och liknande forensiska system. Sedan det finns viss bevisning för en högre nivå av vägledande princip som rengjorts i denna nya forskning, kan vi hoppas på att se mer arbete i denna riktning.
Publicerad första gången fredag, 21 februari 2025


