
Взгляд Anderson
За пределами зрения, за пределами памяти: решение самой большой проблемы в AI-видео

 Добавьте Unite.AI в избранные источники в Google
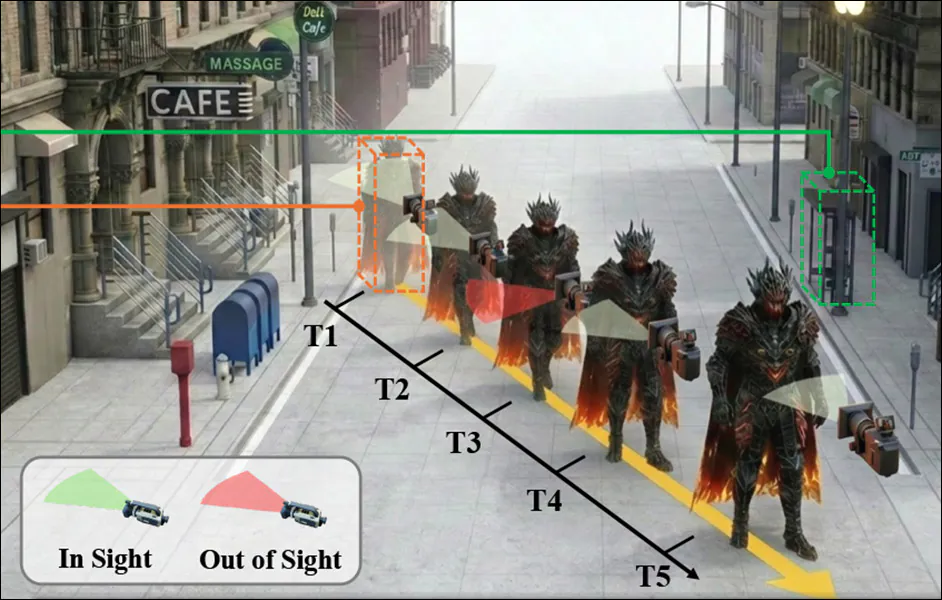
Ключевые моментыНовая гибридная система памяти решает проблему хронической амнезии в AI-видео…
Показать больше
- Новая гибридная система памяти решает проблему хронической амнезии в AI-видео, обеспечивая согласованность персонажей за пределами кадра.
- Метод использует токенизацию памяти и динамическое извлечение данных для сохранения внешнего вида и движения персонажей при их уходе из кадра.
- HyDRA превосходит предыдущие подходы за счёт разделения динамических объектов и статичного фона в латентном пространстве.
Самая большая проблема даже с лучшими генераторами AI-видео заключается в том, что они имеют хроническую амнезию – проблему, которую новое исследование из Китая теперь решает.
Самая большая проблема даже с лучшими и наиболее передовыми системами генерации AI-видео заключается в том, что они все имеют хроническую амнезию: если камера перемещается от того, на что она была сфокусирована, и затем перемещается обратно, она никогда не найдет то, что было в начале – персонажи исчезнут, изменят свой вид и/или тип движения, и фоновые изображения, скорее всего, также изменятся.
Это связано с тем, что система генерации на основе диффузии имеет ограниченное скользящее окно внимания, и поскольку она всегда работает с тем, что она может видеть в этот момент; в истинном воплощении солипсизма, то, что находится вне кадра, не существует для генеративного ИИ – оно буквально удаляется из памяти.
Это никогда не было проблемой в традиционном CGI, которое всегда может ссылаться на и точно воссоздавать объект, включая его вид и движение, в любой точке отрендеренного видео, где он может быть нужен снова:

Традиционные сетки CGI и битмап-текстуры всегда можно нарисовать в рендер, обеспечивая неизменный внешний вид – трюк, которого гораздо сложнее добиться в подходах ИИ, поскольку нет соответствующего независимого референсного файла или набора связанных файлов.
Это связано с тем, что компоненты CGI, такие как сетка и текстуры (см. изображение выше), а также файлы движения и другие динамические модели поведения, могут существовать самостоятельно на диске и быть нарисованы в композицию в любое время.
В генеративном видео ИИ нет такого ‘плоского репозитория’; ближайшее, что оно может достичь этой функциональности, – это LoRAs – специально обученные дополнительные файлы, которые можно обучить на потребительском оборудовании, позволяя внедрять новых персонажей и конкретную одежду в видео:
Нажмите, чтобы воспроизвести. Проблема солипсизма в AI-видео может быть смягчена до определенной степени с помощью LoRAs – но результаты могут быть подавляющими.
Это не идеальное решение, хотя. Во-первых, LoRAs привязаны к точной версии базовой модели (например, Wan2+ или Hunyuan Video), и нуждаются в пересоздании каждый раз, когда базовая модель меняется. Во-вторых, LoRAs склонны искажать веса базовой модели, так что обученная идентичность LoRA накладывается на все персонажи в сцене. Кроме того, методы тонкой настройки этого типа очень чувствительны к плохо курированным наборам данных.
Точное возвращение
Теперь новое академическое/промышленное сотрудничество из Китая предлагает первое значительное решение, которое привлекло мое внимание более чем за три года моей работы над материалами об этой проблеме. Метод использует то, что исследователи называют гибридной памятью, чтобы сохранить персонажа, находящегося вне кадра, и его непосредственную среду активными и точными в латентном пространстве модели, так что когда наша точка зрения возвращается к ним, результат остаётся согласованным:
Нажмите, чтобы воспроизвести. Из проекта для новой статьи, два примера AI-генерированных (WAN) персонажей, выходящих из кадра и точно возвращающихся. Источник
Следует подчеркнуть, что это не то же самое, что достижение неизменности персонажей в разных планах – что было заявлено год назад в выпуске Runway Gen 4, и которое остается по-прежнему активно изучаемой задачей в научной литературе.
Здесь же решается задача, с которой не смог справиться ни один виденный мной коммерческий или экспериментальный фреймворк – визуально согласованное повторное появление предыдущего вида, движения и окружения персонажа, находящегося вне кадра:
Нажмите, чтобы воспроизвести. Другие два основных примера, представленные на сайте нового проекта.
Очевидно, что принципы, действующие здесь, могут быть применены к другим областям, таким как городское исследование, вождение от первого лица, или другие виды рендеринга, не связанные с персонажами.
Следует подчеркнуть также, что этот новый подход не решает и не рассматривает проблему, которую Runway Gen4 и другие закрытые платформы утверждают, что решили, воссоздавая персонажей в разных планах; вместо этого он делает то, чего не смогла добиться ни одна из них – сохраняет персонажа и окружение в памяти, без необходимости, чтобы они оставались видимыми для зрителя все время.
Новая работа включает в себя специальный набор данных, сгенерированный с помощью Unreal Engine, а также пользовательские метрики для проблемы солипсизма*, и специальную генеративную структуру, построенную поверх WAN. В тестах против немногих аналогичных систем, доступных на данный момент, авторы утверждают, что достигли лучших результатов в своем классе, и комментируют:
‘[Память] механизмы появились как критический рубеж в продвижении моделей мира, поскольку емкость памяти определяет пространственную и временную согласованность сгенерированного контента.
‘В частности, это когнитивный якорь, который позволяет модели сохранять исторический контекст во время сдвига точки зрения или долгосрочной экстраполяции.
‘Без прочной памяти симулированный мир быстро распадается на несвязанные, хаотические кадры.’
Новая статья озаглавлена За пределами зрения, но не за пределами памяти: гибридная память для динамических видеомоделей мира, и исходит от семи исследователей из Университета науки и технологий Хуачжун и команды Kling в Kuaishou Technology.
Метод
Центральной частью новой работы является гибридная память, которая обеспечивает ‘экстраполяцию вне поля зрения’ – сохранение персонажей и их контекстов, пока зритель ‘отводит взгляд’ (или пока персонаж сам выходит из поля зрения). В этом сценарии структура требует выполнения пространственно-временного декуплинга, при котором она одновременно фокусируется на генерации, видимой для зрителя, и на существовании персонажа, находящегося вне поля зрения.

Примеры входа/выхода камеры. В этих случаях это движение камеры вызывает выход персонажа из кадра, но в различных образцах мы также можем наблюдать, как персонаж сам временно перемещается за пределы экрана. Источник
Авторы отмечают, что в диффузных латентных эмбеддингах признаки, которые необходимо извлечь и использовать, сильно спутаны с другими признаками и свойствами; и что попытка извлечь их часто вызывает ‘замораживание’ субъекта в фоновом изображении. Поэтому они разработали и курировали набор данных HM-World**, специально предназначенный для обучения гибридной памяти:

Из статьи, образцы из четырех категорий, содержащихся в наборе данных HM-World.
Коллекция построена по четырем измерениям: траектории субъектов, траектории камеры, сцены и субъекты.
Синтетические данные в HM-World включают 17 сцен и 49 субъектов, включая людей разнообразного вида, а также животных разных видов. Комбинации этих объектов помещаются в сцену с помощью Unreal Engine, каждый с уникальной анимацией движения, а затем устанавливаются на случайно выбранную траекторию.
Авторы утверждают, что в наборе данных представлен разнообразный набор выхода и возвращения событий, с 28 различными траекториями камеры, каждая из которых имеет несколько начальных точек.
Окончательная коллекция состоит из 59 225 видеоклипов, каждый из которых аннотирован MiniCPM-V мультимодальной большой языковой моделью (MLLM).
Исследователи указывают на статистические преимущества своей коллекции перед предыдущими наборами данных WorldScore; Context-As-Memory; Multi-Cam Video; и 360° Motion:

Сравнение между существующими наборами данных и набором данных HM-World, где ‘Динамический субъект’ указывает на наличие движущихся объектов, ‘Выход и возвращение субъекта’ обозначает клипы, содержащие субъекты, выходящие и входящие в кадр, и ‘Поза субъекта’ относится к включению аннотированных 3D поз.
Менее пройденный путь
Учитывая несколько предыдущих кадров и известный путь камеры, задача состоит в том, чтобы предсказать будущие виды, когда точка зрения зрителя меняется, учитывая субъекты, которые движутся самостоятельно и могут покинуть кадр, прежде чем вернуться. Это требует больше, чем сохранение стабильного фона, поскольку модель должна также сохранять внутреннюю согласованную запись о том, как каждый движущийся субъект выглядит и ведет себя, даже в периоды, когда он не видим.
Метод Hybrid Dynamic Retrieval Attention (HyDRA) авторов решает эту проблему, вводя специальный путь памяти, который отделяет динамических субъектов от статичного представления сцены, позволяя им сохраняться во времени и появляться с неизменным внешним видом и движением:

Концептуальная схема модели HyDRA.
HyDRA построена поверх Wan2.1-T2V-1.3B, с сохранением основной части диффузионного конвейера почти без изменений, в то время как вводится модифицированный блок трансформера, который включает динамическое внимание поиска. Это позволяет модели селективно вспоминать подсказки движения и вида из предыдущих кадров, а не полагаться на фиксированный или локальный контекст.
Этот процесс использует адаптированную Flow Matching цель обучения вместо стандартной диффузной потери.
Чтобы сохранить сцены, соответствующие движению камеры, траектории камеры вводятся как явный сигнал обусловливания, с каждым кадром, определенным поворотом и параллельным переносом, а затем преобразуются в компактное представление, захватывающее, как точка зрения эволюционирует во времени.
В соответствии с предыдущей (Kling) ReCamMaster инициативой, результат затем парсируется камерой-энкодером, реализованным как Многослойный Перцептрон, затем передается и добавляется к признакам Diffusion Transformer, позволяя модели сохранять согласованное размещение объектов при движении камеры.
Токенизация
Исходные диффузионные латентные представления смешивают движение субъекта, вид и фон в единое спутанное представление, и попытка извлечь их напрямую из этого пространства рискует ввести ненужный контекст или привести к слиянию движущихся субъектов с фоном.
HyDRA решает эту проблему с помощью токенизатора памяти на основе 3D-свёртки, который обрабатывает пространство и время вместе – а не передавая полные латентные истории, он сжимает их в компактные, учитывающие движение токены памяти, которые сохраняют, как субъекты выглядят и движутся:

Обзор HyDRA. Слева, токенизатор памяти преобразует предыдущие кадры в компактные, учитывающие движение токены памяти; справа, динамическое внимание поиска оценивает текущий запрос против этих токенов, извлекает наиболее релевантные и использует их для восстановления согласованного внешнего вида и движения в сгенерированном кадре.
Эти токены образуют структурированную гибридную память, которая фильтрует шум, сохраняя при этом долгосрочную динамику. Переданные в модуль динамического внимания поиска, они позволяют модели селективно вспоминать субъекты, находящиеся вне кадра, так что они появляются с неизменным внешним видом, движением и контекстом.
Динамическое внимание поиска
Двойной механизм памяти HyDRA также использует динамическое внимание поиска в отдельной, но дополняющей роли внутри структуры.
Токенизация памяти сжимает предыдущие латентные представления в структурированные, учитывающие движение токены, которые отделяют динамических субъектов от статичного содержания сцены, уменьшая спутанность, которая часто приводит к слиянию субъектов с фоном. Эти токены образуют постоянный банк памяти, а не полную историю кадров.
Динамическое внимание поиска затем работает над этим банком во время генерации, оценивая текущий запрос против хранимых токенов и селективно извлекая те, которые наиболее релевантны для эволюционирующего кадра. Это позволяет субъектам, находящимся вне кадра, продолжать свою латентную эволюцию (т.е. продолжать ходить, бежать, когда их не видно), и появляться с неизменным внешним видом и движением, когда они возвращаются в кадр, вместо того, чтобы сбрасывать или ухудшать.
Данные и тесты
В тестах система HyDRA, основанная на Wan, закодировала и уменьшила 77 контекстных кадров, прежде чем проанализировать их с помощью 3D вариационного автоэнкодера (VAE), в то время как токенизатор памяти использовал 3D-свёртку с размером ядра 2x4x4.
Модель была обучена на HW-World в течение 10 000 итераций на 32 (неуказанных) GPU, с размером пакета 32.
Необычно большое количество метрик было использовано в тестах: кроме обычных пиковых коэффициентов сигнал-шум (PSNR), структурного коэффициента подобия (SSIM) и метрик, обученных на основе восприятия (LPIPS), авторы также использовали согласованность субъектов и согласованность фона из набора VBench, чтобы оценить когерентность на уровне кадров.
Кроме того, они разработали пользовательскую метрику под названием Динамическая согласованность субъекта (DSC), которая использует ограничивающие рамки из YOLO V11, чтобы создать обрезанные регионы, содержащие движущиеся субъекты, из которых извлекаются семантические признаки, а затем вычисляются их подобия.
HyDRA была противопоставлена Diffusion Forcing Transformer (DFoT) и Context-As-Memory, над базовой моделью Wan2.1-T2V-1.3B, оснащенной камерой-энкодером (для представления субъективной точки зрения, общей для всех клипов). Все модели были обучены на HW-World, и WorldPlay также использовался как вторичная тестовая коллекция в режиме zero-shot, без дополнительного обучения на задаче:
В начальных количественных сравнениях HyDRA превзошла все базовые модели, увеличив PSNR с 18,696 до 20,357, и SSIM с 0,517 до 0,606. Она также достигла наивысших контекстных и фактических коэффициентов Dice, 0,827 и 0,849, с согласованностью субъектов и фона, достигающей 0,926 и 0,932:

Результаты начального количественного сравнения с предыдущими подходами.
DFoT достигла 17,693 PSNR, и Context-As-Memory 18,921, с приростами, приписываемыми токенизации памяти в сочетании с динамическим вниманием поиска:

Количественное сравнение, противопоставляющее HyDRA современным передовым методам.
Что касается тестов против WorldPlay, авторы утверждают:
‘Наш метод превосходит WorldPlay во всех метриках, с заметным разрывом PSNR в 5,502. Хотя WorldPlay демонстрирует более низкую производительность на метриках, ссылающихся на фактические данные (например, PSNR 14,855, DSCGT 0,832), из-за разрыва в распределении домена и отсутствия специальной тонкой настройки, он демонстрирует замечательную устойчивость на метриках, ссылающихся на контекст, достигая DSCctx 0,822.
‘Это наблюдение не только подтверждает, что обширно обученные модели обладают приемлемой гибридной согласованностью, но также косвенно подтверждает рациональность наших предложенных метрик DSC в отражении динамической согласованности субъектов.
‘В конечном итоге, эти впечатляющие результаты подчеркивают исключительные возможности нашей модели, демонстрируя ее превосходство даже над устоявшимися коммерческими моделями.’
Статья предлагает статическую репрезентацию качественных сравнений, проведенных для тестов:

Качественное сравнение выхода и повторного входа под движением камеры. Авторы утверждают, что HyDRA сохраняет идентичность субъекта, позу и непрерывность движения после выхода и повторного входа в кадр, тесно соответствуя фактическим данным, в то время как конкурирующие методы демонстрируют дрейф, несогласованное движение или ухудшение субъекта, выделенные красным (согласованные восстановления выделены зеленым).
Что касается этих результатов, авторы комментируют:
‘В случае сложных событий выхода и входа базовая модель и Context-As-Memory демонстрируют серьезные искажения субъекта и несогласованное движение. DFoT не может сохранить целостность субъекта, что приводит к полному исчезновению. Хотя WorldPlay может сохранить неизменность внешнего вида субъекта, он страдает от заикания движений и неестественных действий.
‘Напротив, наш метод успешно сохраняет гибридную согласованность, сохраняя как идентичность субъекта, так и непрерывность движения после повторного входа субъекта в кадр.’
Дополнительные результаты можно увидеть в видеоформате на дополнительном сайте, из которых первые четыре примера были собраны (нами) в видео ниже:
Нажмите, чтобы воспроизвести. Четыре из шести результатов тестов, представленных на сайте проекта. Источник
Заключение
Хотя любая попытка решить одну из самых больших проблем в генерации AI-видео приветствуется, кажется неизбежным, что оптимальное решение для проблем выхода/повторного входа этого типа окажется, как и в случае с CGI, в виде отдельных справочных материалов, которые можно редактировать по отдельности и вставить в пространство композиции.
Попытки поддерживать эмбеддинг активным ad hoc и прямо в процессе генерации кажутся изнурительными. Кроме того, они не предлагают ясного пути к согласованности внутри одного плана, которую уже обеспечивают различные закрытые сервисы, например Runway. Если последующему плану нужен доступ к латентному пространству предыдущего, почему бы обоим экземплярам не сохранять собственный независимый эмбеддинг персонажа?
* Никто другой пока не дал этому явлению названия, а без общих терминов обсуждать его трудно.
** На странице проекта пока указано «скоро появится».
Впервые опубликовано в пятницу, 27 марта 2026 года.


