
Модели и платформы ИИ
Интеллектуальные агенты демонстрируют эмерджентные свойства интеллекта в виртуальной игре в прятки

 Добавьте Unite.AI в избранные источники в Google
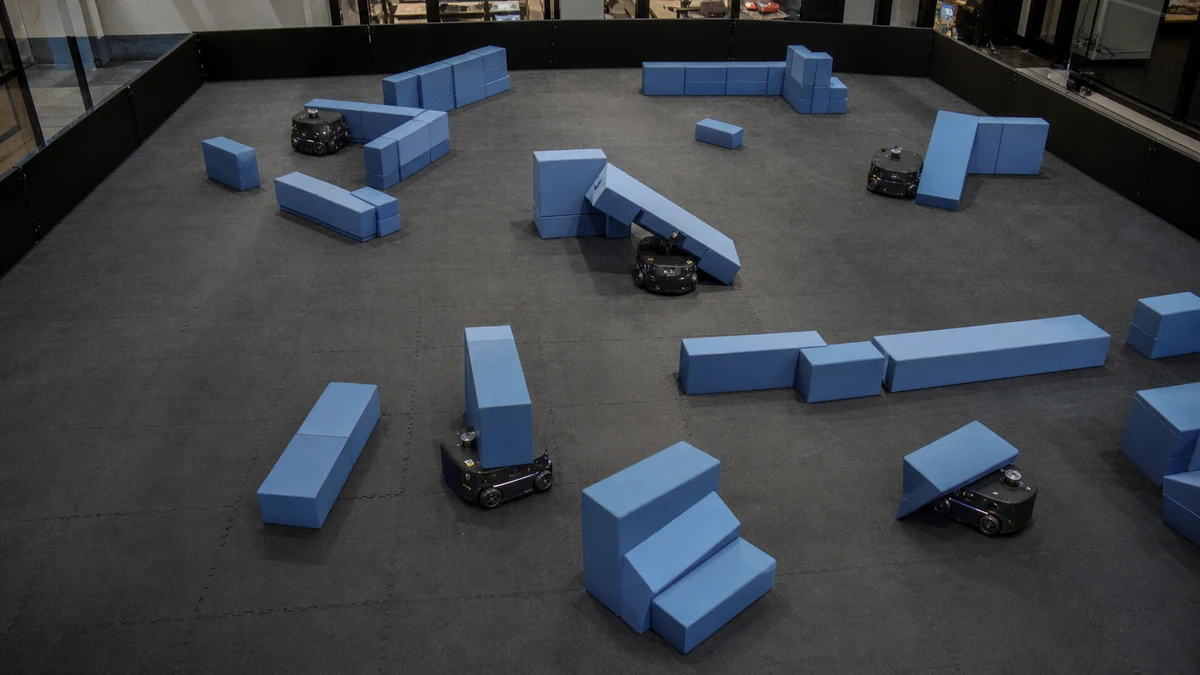
Одним из интересных фактов о исследованиях ИИ является то, что он может часто выполнять действия и использовать стратегии, которые удивляют даже самих исследователей, проектирующих их. Это произошло во время недавней виртуальной игры в прятки, где несколько интеллектуальных агентов были противопоставлены друг другу. Исследователи в OpenAI, компании по ИИ, базирующейся в Сан-Франциско, были удивлены, обнаружив, что их интеллектуальные агенты начали использовать стратегии в игровом мире, которые исследователи даже не знали, что существуют.
OpenAI обучила группу интеллектуальных агентов играть в игру в прятки друг с другом. Программы ИИ обучаются с помощью метода подкрепления, когда желаемое поведение вызывается у алгоритмов ИИ путем предоставления им обратной связи. ИИ начинает с случайных действий, и каждый раз, когда он выполняет действие, которое приближает его к цели, агент получает награду. ИИ стремится получить максимально возможную награду, поэтому он экспериментирует, чтобы увидеть, какие действия принесут ему больше награды. Через проб и ошибку ИИ способен различать стратегии, которые приведут его к победе, те, которые принесут ему наибольшую награду.
Обучение с подкреплением уже продемонстрировало впечатляющий успех в обучении правилам игр. OpenAI недавно обучила команду ИИ играть в MMORPG DOTA 2, и ИИ победил команду чемпионов-людей в прошлом году. Аналогичное произошло с игрой StarCraft, когда ИИ был обучен на игре компанией DeepMind. Обучение с подкреплением также использовалось для обучения программ ИИ играть в Пиктори с людьми, обучая их интерпретировать изображения и использовать базовое рассуждение.
В виртуальной игре в прятки, созданной исследователями, несколько интеллектуальных агентов были противопоставлены друг другу. Результатом стала своего рода гонка вооружений, где каждый агент хочет превзойти другого и получить наибольшее количество очков награды. Новая стратегия, принятая одним агентом, заставляет его противника искать новую стратегию, чтобы противостоять ей, и наоборот. Игорь Мордач, исследователь в OpenAI, объяснил IEEE Spectrum, что этот эксперимент демонстрирует, что этот процесс проб и ошибок между агентами “достаточен, чтобы агенты научились удивительным поведениям самостоятельно – это как дети, играющие друг с другом”.
Какие же были эти удивительные поведения? Исследователи ожидали, что ИИ-агенты научатся четырем основным стратегиям, и они научились им довольно быстро, став компетентными в них после всего 25 миллионов симулированных игр. Игра проходила в 3D-среде, полной рамп, блоков и стен. ИИ-агенты научились преследовать друг друга, перемещать блоки, чтобы построить укрепления, в которых они могли спрятаться, и перемещать рампы. ИИ-искатели научились тянуть рампы, чтобы попасть внутрь укреплений прячущихся, а прячущиеся научились пытаться взять рампы внутрь своих укреплений, чтобы искатели не могли их использовать.
Однако около 380 миллионов игр произошло неожиданное. ИИ-агенты научились использовать две стратегии, которые исследователи не ожидали. Искатели-агенты научились, что, прыгая на коробку и наклоняя/ездя на коробке к ближайшему укреплению, они могли прыгнуть внутрь укрепления и найти прячущегося. Исследователи даже не знали, что это возможно в физике игровой среды. Прячущиеся научились справляться с этой проблемой, перемещая коробки внутрь своих укреплений.
Хотя неожиданное поведение агентов, обученных алгоритмам подкрепления, безобидно в этом случае, оно вызывает некоторые потенциальные опасения о том, как обучение с подкреплением применяется в других ситуациях. Член команды исследователей OpenAI, Боуэн Бейкер, объяснил IEEE Spectrum, что эти неожиданные поведения могут быть потенциально опасными. Ведь что, если роботы начнут вести себя неожиданным образом?
“Создание этих сред является сложным”, – объяснил Бейкер. “Агенты придумают эти неожиданные поведения, которые станут проблемой безопасности в будущем, когда вы поместите их в более сложные среды”.
Однако Бейкер также объяснил, что стратегии подкрепления могут привести к инновационным решениям текущих проблем. Системы, обученные с помощью обучения с подкреплением, могут решить широкий спектр проблем с решениями, которые мы даже не можем представить.


