
Fundamentele AI
Cum funcționează clasificarea textului?

 Adaugă Unite.AI la sursele tale preferate pe Google
Clasificarea textului atribuie una sau mai multe etichete unui document, mesaj sau fragment de text. Exemple includ detectarea spamului, rutarea intențiilor, analiza sentimentelor, etichetarea tematică, moderarea și prioritizarea tichetelor de suport.
Un clasificator în producție este mai mult decât un model. Acesta depinde de o taxonomie precisă a etichetelor, de adnotări reprezentative, de diviziuni sigure împotriva scurgerilor, de o regulă de decizie calibrată și de monitorizare pentru schimbările limbajului și prevalența claselor.
Aspecte cheie
- Definește etichetele și cazurile ambigue înainte de a alege o arhitectură.
- Bazele simple de tip sac de cuvinte rămân valoroase; codificatoarele pre-antrenate adaugă context și învățare prin transfer.
- Acuratețea poate ascunde performanțe slabe ale claselor minoritare, așa că folosește metrici sensibile la clasă și analiza erorilor.
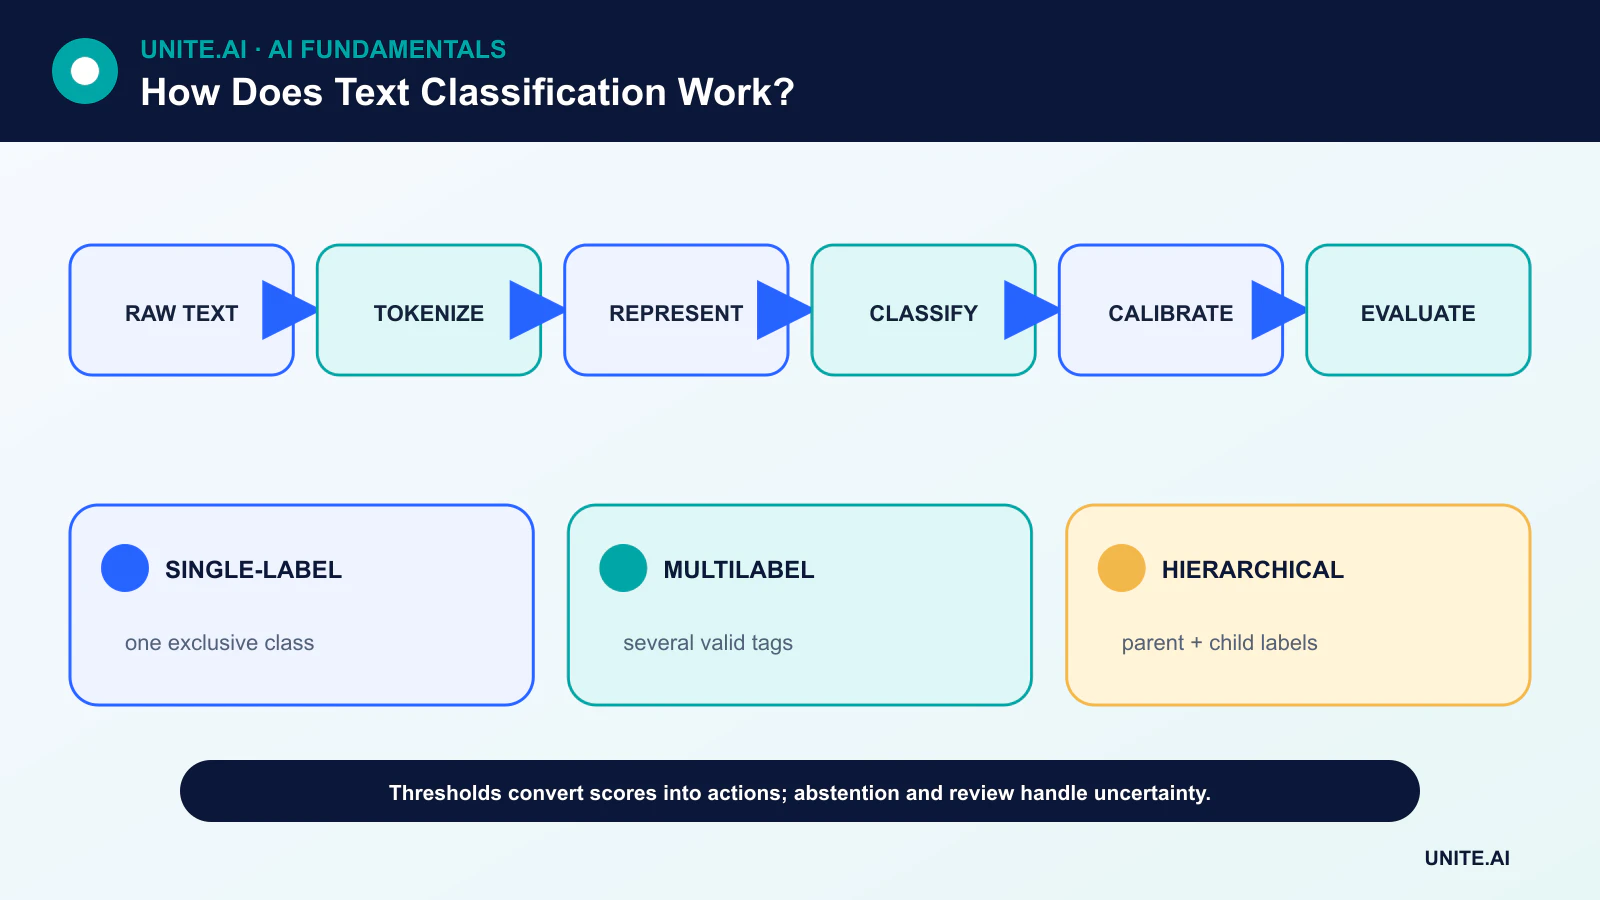
- Calibrarea probabilităților, abstinența și revizuirea umană transformă scorurile în decizii mai sigure.
Definește taxonomia și politica de adnotare
O sarcină cu o singură etichetă alege o clasă mutual exclusivă. O sarcină multilabel poate atribui mai multe etichete independente. Taxonomiile ierarhice conțin etichete părinte și copil. Acestea reprezintă probleme de învățare diferite și necesită ieșiri și metrici diferite.
Adnotatorii au nevoie de definiții, exemple pozitive și negative, reguli pentru contextul lipsă și o cale de escaladare. Statisticile de acord pot evidenția o sarcină neclară, dar dezacordul poate reprezenta și ambiguitate reală pe care sistemul ar trebui să o păstreze.
Reprezentarea textului
Fluxurile tradiționale folosesc numărarea token‑urilor, n‑gramuri și TF‑IDF cu clasificatori liniari sau mașini cu vectori de susținere. Se antrenează rapid, expun termeni influenți și oferă o bază solidă.
Sistemele neurale mapă token‑urile în încorporări. Codificatoarele transformer pre‑antrenate utilizează atenția pentru a produce reprezentări contextuale și pot fi ajustate fin cu exemple etichetate. Clasificatorii prompți sau zero‑shot pot reduce etichetarea inițială, dar formularea etichetelor, versiunea modelului și calibrarea trebuie evaluate pe domeniul real.
Antrenarea fără scurgeri
Setul de date este împărțit în date de antrenament, validare și test final. Documentele aproape duplicate, mesajele din aceeași conversație sau șabloanele din aceeași sursă ar trebui să rămână în aceeași diviziune. Pentru utilizări dependente de timp, o diviziune cronologică reprezintă mai bine implementarea.
Dezechilibrul de clasă poate fi abordat prin ponderare, resampling, selecție de praguri sau date suplimentare. Exemplele sintetice nu ar trebui să înlocuiască revizuirea eșecurilor reale ale claselor minoritare și pot introduce artefacte pe care modelul le învață prea ușor.
Metrici și decizii calibrate
O matrice de confuzie arată ce etichete sunt confundate. Precizia măsoară câte predicții pozitive sunt corecte; recall‑ul măsoară câte adevărate pozitive sunt găsite. Mediile macro ponderă clasele în mod egal, în timp ce mediile micro ponderă exemplele individuale.
Un scor softmax brut nu este automat o probabilitate de încredere. Calibrarea compară încrederea cu corectitudinea observată. Echipele pot stabili praguri specifice pentru fiecare clasă, pot abstine când încrederea este scăzută și pot direcționa cazurile sensibile către un revizor.
Implementare, utilizare multilingvă și drift
Textul se modifică odată cu produsele, evenimentele, argoul și comportamentul adversarial. Monitorizarea ar trebui să urmărească limba de intrare, lungimea, tiparele din afara vocabularului, ratele claselor, încrederea și rezultatele întârziate. Reantrenarea necesită date versionate și o suită de regresie cu exemple importante.
Performanța multilingvă trebuie testată pentru fiecare limbă și dialect. Traducerea tuturor conținuturilor într-o singură limbă poate schimba sentimentul sau entitățile; un codificator multilingv poate totuși să aibă performanțe inegale deoarece preantrenarea și etichetele sale nu sunt reprezentative în mod egal.
Reprezentări și familii de clasificatori
Clasificarea textului mapează un document, o propoziție sau o secvență de tokenuri la una sau mai multe etichete. Definește dacă etichetele sunt mutual exclusive, multilabel, ierarhice, ordonate sau de tip open‑set. Fluxurile tradiționale tokenizează textul, construiesc caracteristici de tip sac de cuvinte sau TF‑IDF și antrenează regresie logistică, Naive Bayes sau un SVM liniar. Sistemele neurale învață încorporări prin convoluție, recurență sau transformere. Modelele de limbaj cu prompt pot clasifica fără antrenament specific sarcinii, dar constrângerile de ieșire, costul, driftul și dovezile necesită în continuare evaluare față de bazele mai simple.
Preprocesarea depinde de reprezentare. Transformarea în minuscule sau eliminarea punctuației poate distruge semnale pentru nume, sentiment, cod sau limbă; stemming‑ul poate fuziona sensuri distincte. Tokenizatoarele transformer operează pe subcuvinte și au limite de lungime, așa că strategia de trunchiere contează. Documentele lungi pot necesita fragmentare și agregare. Păstrează textul brut și versiunea de transformare și împarte după autor, conversație, sursă sau timp pentru a preveni ca duplicatele apropiate și șabloanele recurente să treacă de la antrenament la test.
Etichete, metrici și analiza erorilor
Un ghid de adnotare ar trebui să definească domeniul, exemplele, cazurile ambigue și o opțiune de necunoscut sau abstinență. Măsoară acordul și soluționează dezacordul în loc să îl ascunzi prin votul majoritar. Pentru clase dezechilibrate, acuratețea este inadecvată; raportează precizia, recall‑ul, F1, confuzia, calibrarea și sarcina specifică pragurilor pe clasă. Sarcinile multilabel necesită metrici micro, macro și la nivel de etichetă. Evaluează limbile, dialectele, domeniile, lungimea mesajelor și timpul. O diviziune aleatorie poate supraestima calitatea când vocabularul sau șabloanele suferă drift.
Analiza erorilor ar trebui să separe eșecul de reprezentare, contextul insuficient, ambiguitatea etichetelor, vocabularul rar, negația, sarcasmul și indiciile spurioase. Folosește teste contrafactuale care schimbă nume, marcatori de dialect sau metadate irelevante păstrând sensul. Inspectează greșelile cu încredere ridicată și cazurile respinse. Un model poate învăța că un canal de client sau o semnătură prezic o etichetă în loc să interpreteze conținutul. Elimină scurgerile și revizuiește datele înainte de a crește simplu capacitatea modelului.
Design pentru producție
Furnizează un tokenizer și un model fixe cu validare de schemă, limite de lungime, procesare în loturi și un fallback pentru limbă nesuportată sau încredere scăzută. Monitorizează distribuția intrărilor, ratele etichetelor, calibrarea, latența și rezultatele revizuite. Protejează textul deoarece poate conține instrucțiuni personale, confidențiale sau adversare. Pentru moderare automată, eligibilitate sau rutare, oferă posibilitatea de contestație și măsoară erorile disparate. Versionează etichetele și pragurile conform politicii de afaceri. Clasificarea textului este fiabilă doar în cadrul sistemului său de etichete definit și a distribuției de date; explicațiile fluente ale modelului nu dovedesc că o clasificare este corectă.
Exemplu practic: clasificarea cererilor de suport primite
O echipă de suport definește etichete de rutare mutual exclusive, plus marcaje pentru urgență, multilingv și necunoscut. Adnotatorii etichetează mesajele deidentificate cu ghiduri pentru probleme mixte și măsoară acordul. O bază logistică TF‑IDF, un codificator ajustat fin și un model cu prompt utilizează același set de testare bazat pe timp. Evaluarea raportează precizia și recall‑ul pe clasă, fals‑negativele urgente, calibrarea, validitatea schemei, latența și costul, cu șabloane aproape duplicate grupate pentru a evita scurgerile.
Clasificatorul implementat validează limba și lungimea, abstine în cazul dovezilor slabe și permite agenților să corecteze rutele. Prompturile și mesajele sunt tratate ca neîncredere; accesul la instrumente este absent. Monitorizarea urmărește prevalența etichetelor, încrederea, corecțiile, timpul de răspuns și subiectele emergente. O politică sau o modificare de produs actualizează taxonomia și datele de reantrenare prin revizuire. Sistemul îmbunătățește poziționarea în coadă, dar nu inferă niciodată emoția sau dreptul clientului dincolo de etichetele validate.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, responsabilul și consecința fiecărui eșec important. Stabilește o bază reproducibilă și un set de evaluare versionat înainte de ajustare. Testează cazurile obișnuite, condițiile de frontieră, intrările defecte sau lipsă, schimbarea distribuției, întreruperile de dependență, utilizarea greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsoară calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Folosește o implementare în etape, păstrează un fallback sigur și verifică monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește pragurile de alertă și responsabilul de răspuns, apoi revizuiește dovezile din lumea reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut are nevoie și de proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și de un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este analiza sentimentelor o sarcină de clasificare a textului?
De obicei da, dar sentimentul poate fi multilabel, bazat pe aspecte sau continuu, în loc de o singură etichetă pozitiv/neutral/negativ.
Când ar trebui să se abțină un clasificator de text?
Când încrederea este scăzută, textul este în afara domeniului, contextul necesar lipsește sau costul unei acțiuni automate incorecte depășește costul revizuirii.
Referințe principale












