
Fundamentele AI
Ce este un depozit de date? Arhitectură, ETL și cazuri de utilizare

 Adaugă Unite.AI la sursele tale preferate pe Google
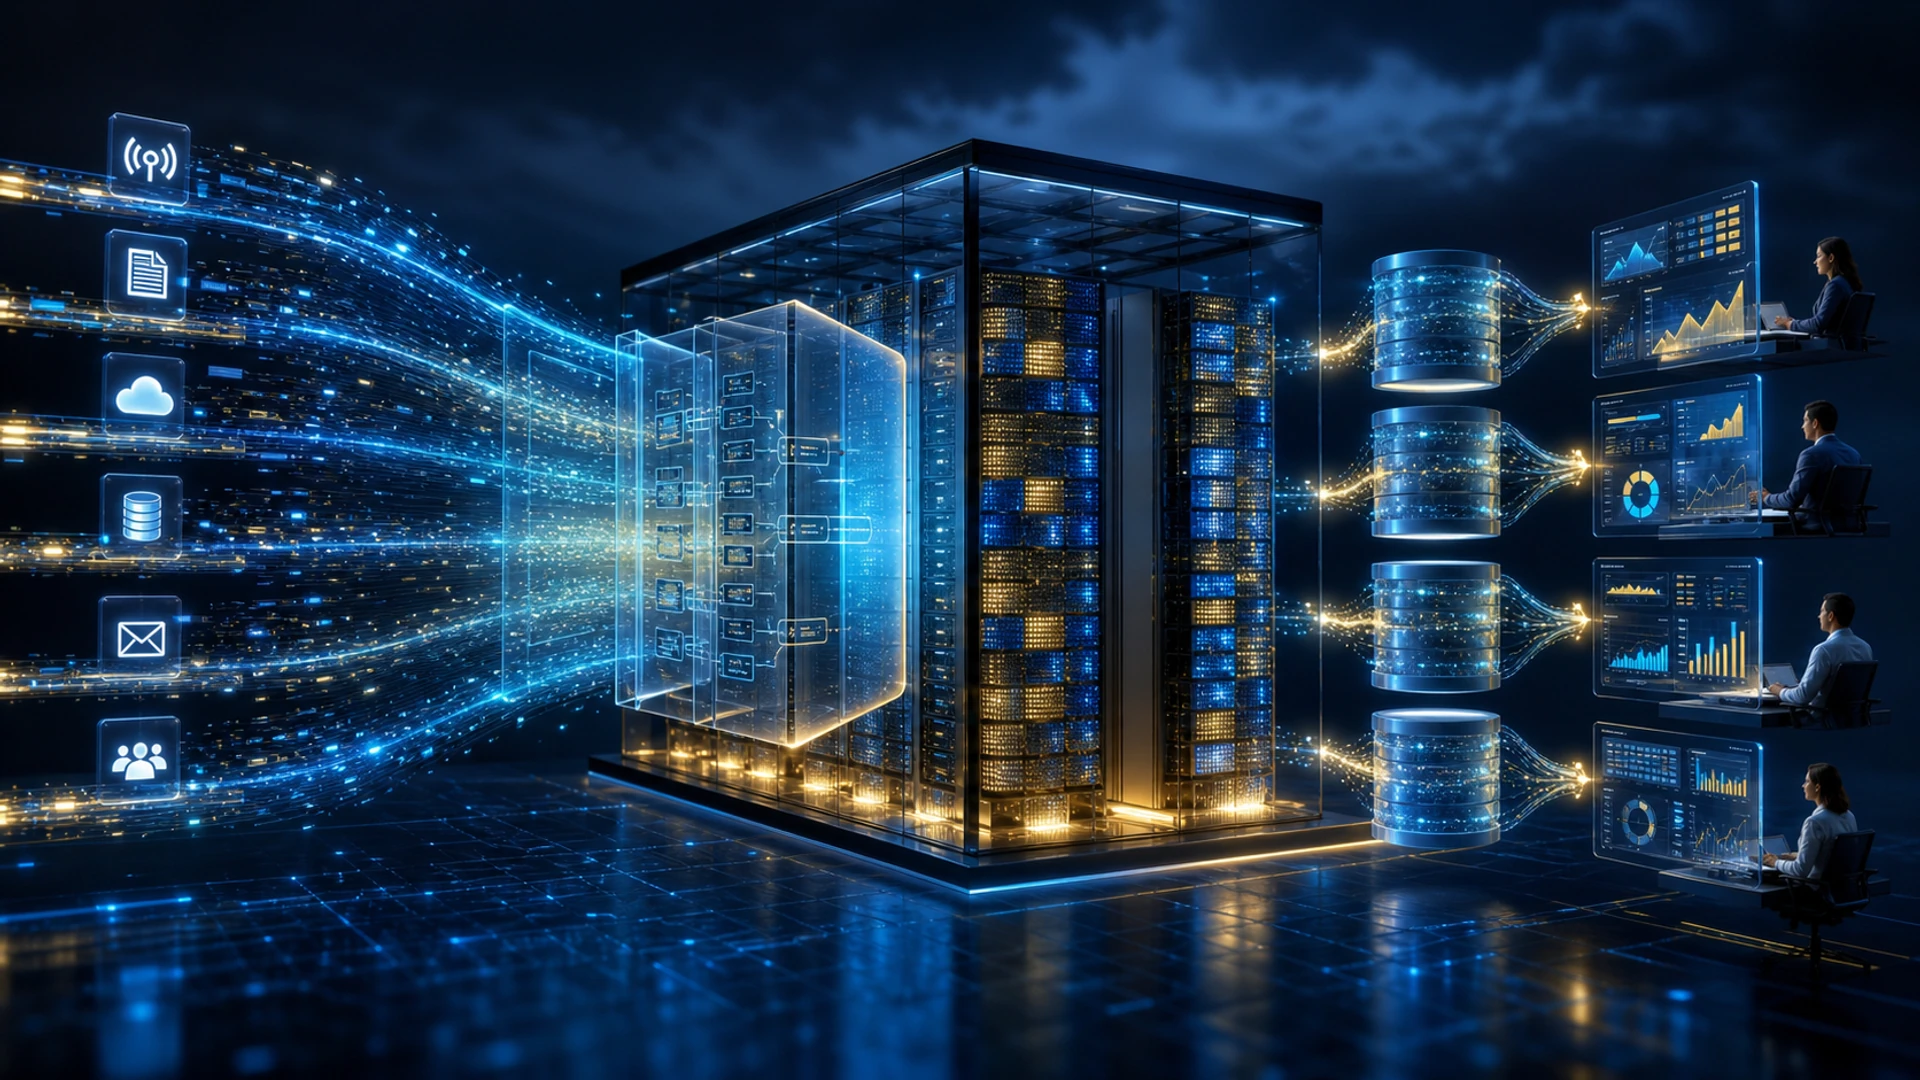
Un depozit de date este un sistem de date analitic care integrează informații din surse operaționale și le organizează pentru raportare, inteligență de afaceri și analiză repetabilă. Acesta separă multe sarcini analitice de aplicațiile care înregistrează tranzacțiile.
Depozitele moderne pot fi coloanare, distribuite, fără server (serverless) sau conectate la stocare de obiecte. Munca definitorie rămâne consistentă: ingestie guvernată, semnificație modelată, istoric, performanță a interogărilor, securitate, calitate și livrare fiabilă către utilizatori.
Aspecte cheie
- Sistemele operaționale optimizează tranzacțiile curente; depozitele optimizează analiza istorică pe multiple surse.
- ETL transformă înainte de încărcare, în timp ce ELT încarcă mai întâi și transformă în interiorul platformei analitice.
- Modelele dimensionale, normalizate și cele cu tabele largi servesc diferite sarcini și nevoi de guvernanță.
- Încrederea depinde de linia de proveniență, teste, actualitate, controlul accesului, definițiile semantice și monitorizarea costurilor.
Surse, ingestie și stocare
Datele pot ajunge prin loturi, capturi de schimbare a datelor, fluxuri, fișiere și API-uri. Un strat de aterizare păstrează contextul sursei; transformările standardizează tipurile, deduplică înregistrările, gestionează evenimentele întârziate și creează entități analitice reutilizabile.
Aceasta extinde fluxul de lucru ETL. ELT folosește calculul depozitului pentru transformare, în timp ce ETL poate reduce sau valida datele înainte de încărcare. Alegerea corectă depinde de latență, confidențialitate, scară și lanțul de instrumente.
Modelarea datelor pentru întrebări
Modelele dimensionale organizează faptele măsurabile în jurul dimensiunilor descriptive, cum ar fi client, produs și timp. Modelele de bază normalizate pot păstra relațiile enterprise, în timp ce marțurile denormalizate simplifică interogările comune.
Un strat semantic oferă definiții coerente pentru metrici. Fără el, echipele pot produce mai multe valori de venit sau retenție care par valide din aceleași rânduri. Datele structurate necesită în continuare un sens convenit.
Depozit, lac și lakehouse
Un lac de date stochează în mod obișnuit fișiere și date brute sau procesate diverse în stocarea de obiecte. Un depozit furnizează tabele analitice gestionate și servicii de interogare. Designurile lakehouse adaugă metadate de tabel, tranzacții și guvernanță la stocarea lacului.
Acestea sunt modele arhitecturale, nu garanții. Organizațiile le combină adesea printr-un data fabric sau un strat de guvernanță partajat. Sarcina, competența, interoperabilitatea și costul ciclului de viață contează mai mult decât eticheta.
Calitate, securitate și operațiuni
Definiți proprietarii, contractele, obiectivele de actualitate, linia de proveniență, testele, retenția și accesul la rânduri sau coloane. Separați datele cu identificare personală, utilizați principiul celui mai mic privilegiu și auditați interogările sensibile. Retroîncărcările și modificările de schemă necesită proceduri controlate și observabile.
Măsurați reîmprospătările reușite, întârzierea datelor, eșecurile testelor, performanța interogărilor, adoptarea, impactul incidentelor și costul per sarcină. Un depozit este util atunci când utilizatorii pot urmări o metrică până la datele guvernate și pot reproduce rezultatul.
Modelare dimensională și semantică
Un tabel de fapte înregistrează evenimente sau măsurători periodice la un granulat declarat, cum ar fi o linie de comandă sau un dispozitiv pe oră. Dimensiunile furnizează context descriptiv. Declararea granulatului înainte de selectarea coloanelor previne amestecarea nivelurilor care cauzează dubla numărare. Măsurile aditive pot fi însumate pe toate dimensiunile; măsurile semi-aditive necesită atenție în timp.
Cheile surrogate decuplează istoricul depozitului de identificatorii sursei în schimbare. Dimensiunile care se modifică lent definesc modul în care sunt gestionate schimbările de atribute: suprascriere, păstrarea unui nou rând istoric sau menținerea unor valori anterioare limitate. Metoda corectă urmează întrebarea analitică și obligațiile de retenție.
O metrică semantică ar trebui să definească formula, filtrele, comportamentul în timp, moneda, excluderile, proprietarul și testele. Definițiile centrale reduc inconsistența, dar guvernanța ar trebui să permită modificările propuse și versionarea. Un singur strat semantic devine un blocaj dacă utilizatorii nu pot să îl inspecteze sau să îl extindă în mod responsabil.
Stocare modernă și arhitectură de interogare
Stocarea coloanară păstrează valorile unei coloane împreună, îmbunătățind comprimarea și scanarea doar a câmpurilor necesare. Particionarea taie secțiuni mari după dată sau altă cheie; clusteringul colocalizează valori legate; vizualizările materializate și cache-urile reutilizează rezultatele. Alegerile proaste de partiționare creează fișiere mici, dezechilibru sau scanări complete costisitoare.
Motoarele de interogare masiv paralele împarte scanările, îmbinările și agregările între lucrători. Mișcarea datelor în timpul îmbinărilor poate domina timpul de rulare, așa că distribuția, statisticile și ordinea îmbinărilor contează. Autoscalarea și serviciile fără server simplifică capacitatea, dar necesită controale de cost, priorități de sarcină și limite pentru interogările necontrolate.
Formatele de tabel lakehouse adaugă metadate, instantanee, evoluție de schemă și semantici de tranzacție peste fișierele de obiecte. Ele îmbunătățesc interoperabilitatea, dar introduc responsabilități de catalog și întreținere. Formatele deschise reduc dependența doar când motoarele de calcul, guvernanța și procedurile operaționale le pot utiliza efectiv.
Conducte fiabile și produse de date
Conductele ar trebui să fie idempotente sau capabile să reconcilie duplicatele. Marcajele de timp și timpul evenimentului gestionează sosirile întârziate; retroîncărcările reproduc transformările istorice; contractele de schemă definesc schimbări compatibile. Testele de date acoperă unicitatea, completitudinea, valorile acceptate, relațiile și invariatele de business — nu doar dacă un job a rulat.
Tratați seturile de date importante ca produse cu proprietari, documentație, așteptări de serviciu, descoperibilitate, suport și utilizatori. Linia de proveniență conectează câmpurile sursă prin transformări la rapoarte, făcând impactul schimbărilor și investigarea incidentelor mai rapide. Politicile de acces ar trebui să se propage sau să fie reevaluate când datele sunt copiate.
Un program de depozitare are succes când deciziile devin mai fiabile și mai rapide, nu când volumul de stocare crește. Eliminați tabelele neutilizate, expuneți costul interogărilor și al stocării, revizuiți accesul sensibil și măsurați dacă echipele au încredere și reutilizează metricile guvernate în loc să mențină foi de calcul private.
Exemplu practic: proiectarea unui depozit de analiză a vânzărilor
Definiți granulatul de fapt ca o linie de comandă finalizată, apoi legați dimensiunile de produs, client, canal, promoție, geografie și dată prin chei surrogate. Păstrați evenimentele de stare a comenzii într-un tabel de fapte separat în loc să amestecați instantanee și tranzacții. Venitul, cantitatea, reducerea, taxa și costul necesită monedă explicită, reguli de returnare, anulare și recunoaștere. Definiția metricii ar trebui să producă același răspuns în tablouri de bord, notebook-uri și reconcilierea financiară.
Ingestia captează schimbările sursei, așază date brute imuabile, validează schema și le transformă în modele de staging și dimensionale testate. Actualizările care sosesc târziu trebuie să corecteze perioada istorică corespunzătoare fără a duplica faptele. Comparați numărul de rânduri și totalurile monetare cu sistemele sursă, testați unicitatea și relațiile și înregistrați linia de proveniență de la câmpul raportului la sursă. Retroîncărcările folosesc cod versionat și validare izolată înainte de a înlocui tabelele de încredere.
Accesul separă identificatorii clienților de agregatele larg disponibile și aplică principiul celui mai mic privilegiu pe rol și scop. Gestionarea sarcinilor menține tablourile de bord executive receptive în timp ce analiștii rulează interogări exploratorii. Monitorizați actualitatea, testele eșuate, costul interogărilor, tabelele neutilizate și schimbările semantice. Un depozit are succes când metricile guvernate susțin decizii repetabile; simpla centralizare a datelor poate centraliza confuzia dacă proprietatea, calitatea și definițiile rămân nerezolvate.
Recuperarea în caz de dezastru ar trebui să specifice acoperirea backup-ului, copiile cross-regional, restaurarea catalogului și a permisiunilor, pierderea de date acceptabilă și timpul de recuperare. Testați restaurarea într-un mediu izolat și verificați metricile, nu doar fișierele. Cheile de criptare, configurarea identității, codul de orchestrare și definițiile semantice fac parte din sistemul recuperabil. Un depozit care poate restaura petabytes, dar nu poate reproduce politica de acces sau calculele de încredere, nu și-a recuperat serviciul analitic.
Lista de verificare pentru implementare practică
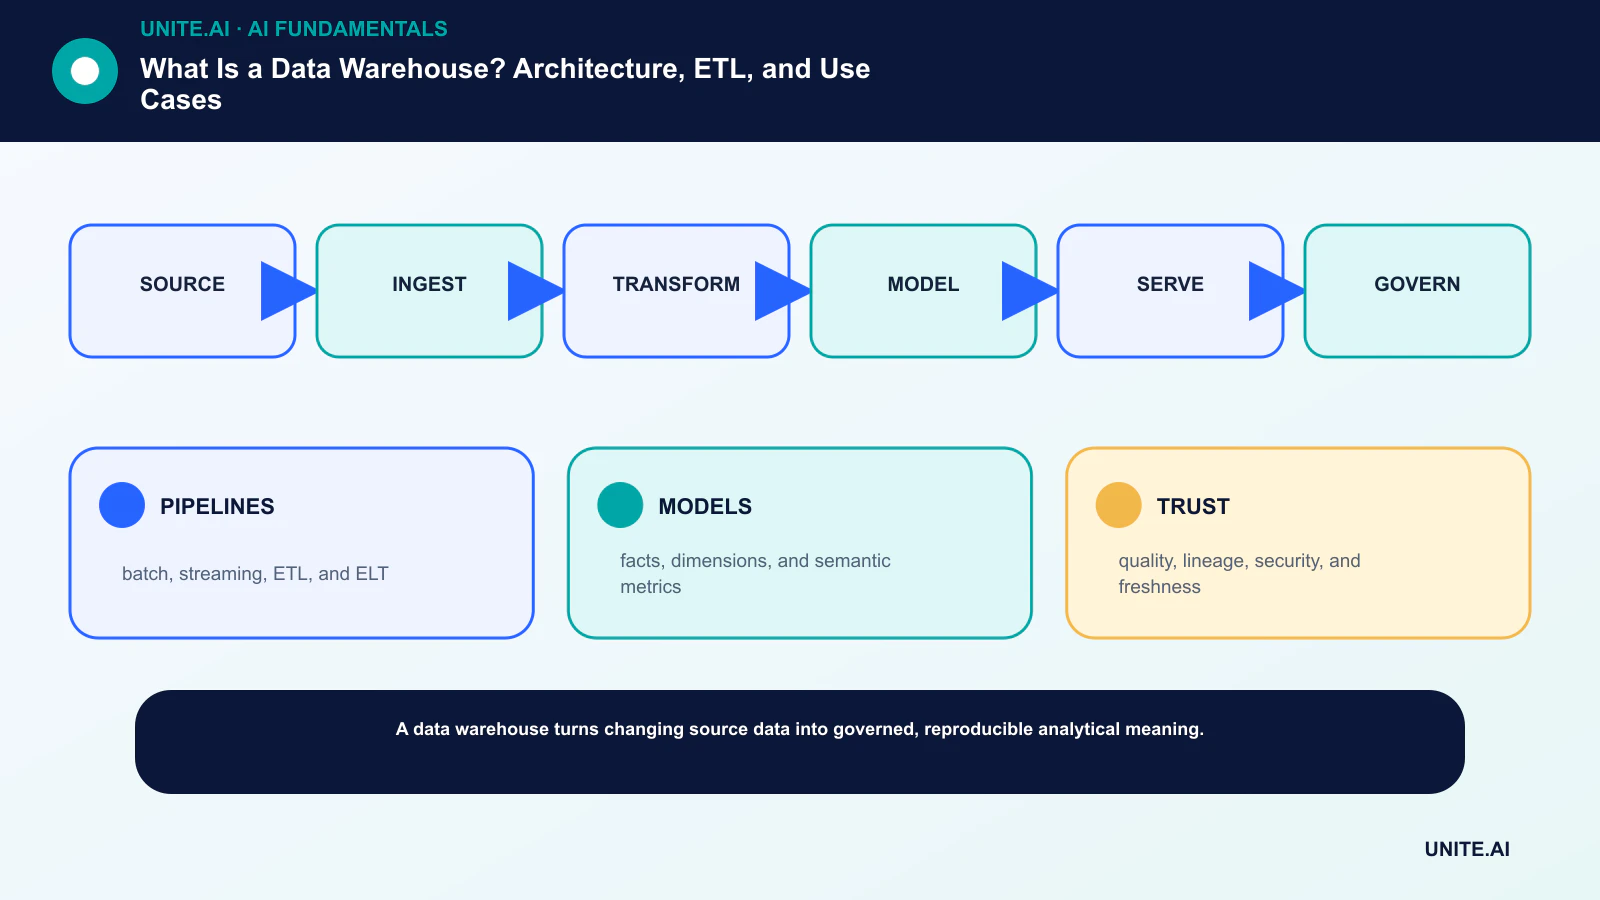
Transformați conceptul într-un flux de lucru delimitat și testabil: sursă → ingestie → transformare → modelare → servire → guvernanță. Numiți un proprietar responsabil, documentați datele și dependențele, stabiliți o bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, revenirea și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și presupunerile pentru ca o altă echipă să poată reproduce rezultatul și să înțeleagă ce s-a schimbat.
Înainte de lansare, efectuați o revizuire documentată a pregătirii cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții de frontieră, eșecuri de dependență și utilizări incorecte; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, anula un rezultat sau opri funcționarea. Revizuiți decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează performanță fiabilă la scară mai largă.
- PIPELINES: loturi, fluxuri, ETL și ELT.
- MODELS: fapte, dimensiuni și metrici semantice.
- TRUST: calitate, linie de proveniență, securitate și actualitate.
Întrebări frecvente
Este un depozit de date doar o bază de date mare?
Este o bază de date sau o platformă analitică concepută pentru analiză integrată și istorică. Modelarea, ingestia, guvernanța și tiparele de sarcină diferă de cele ale unei baze de date pentru aplicații tranzacționale.
Ar trebui o companie să folosească ETL sau ELT?
Multe folosesc ambele. Transformă devreme când confidențialitatea, validarea sau lățimea de bandă o impun; transformă după încărcare când calculul depozitului și iterația rapidă sunt avantajoase.
Referințe principale











