
Fundamentos de IA
O que é Aprendizado por Reforço a partir de Feedback Humano (RLHF)?

 Adicione Unite.AI às suas fontes preferidas no Google
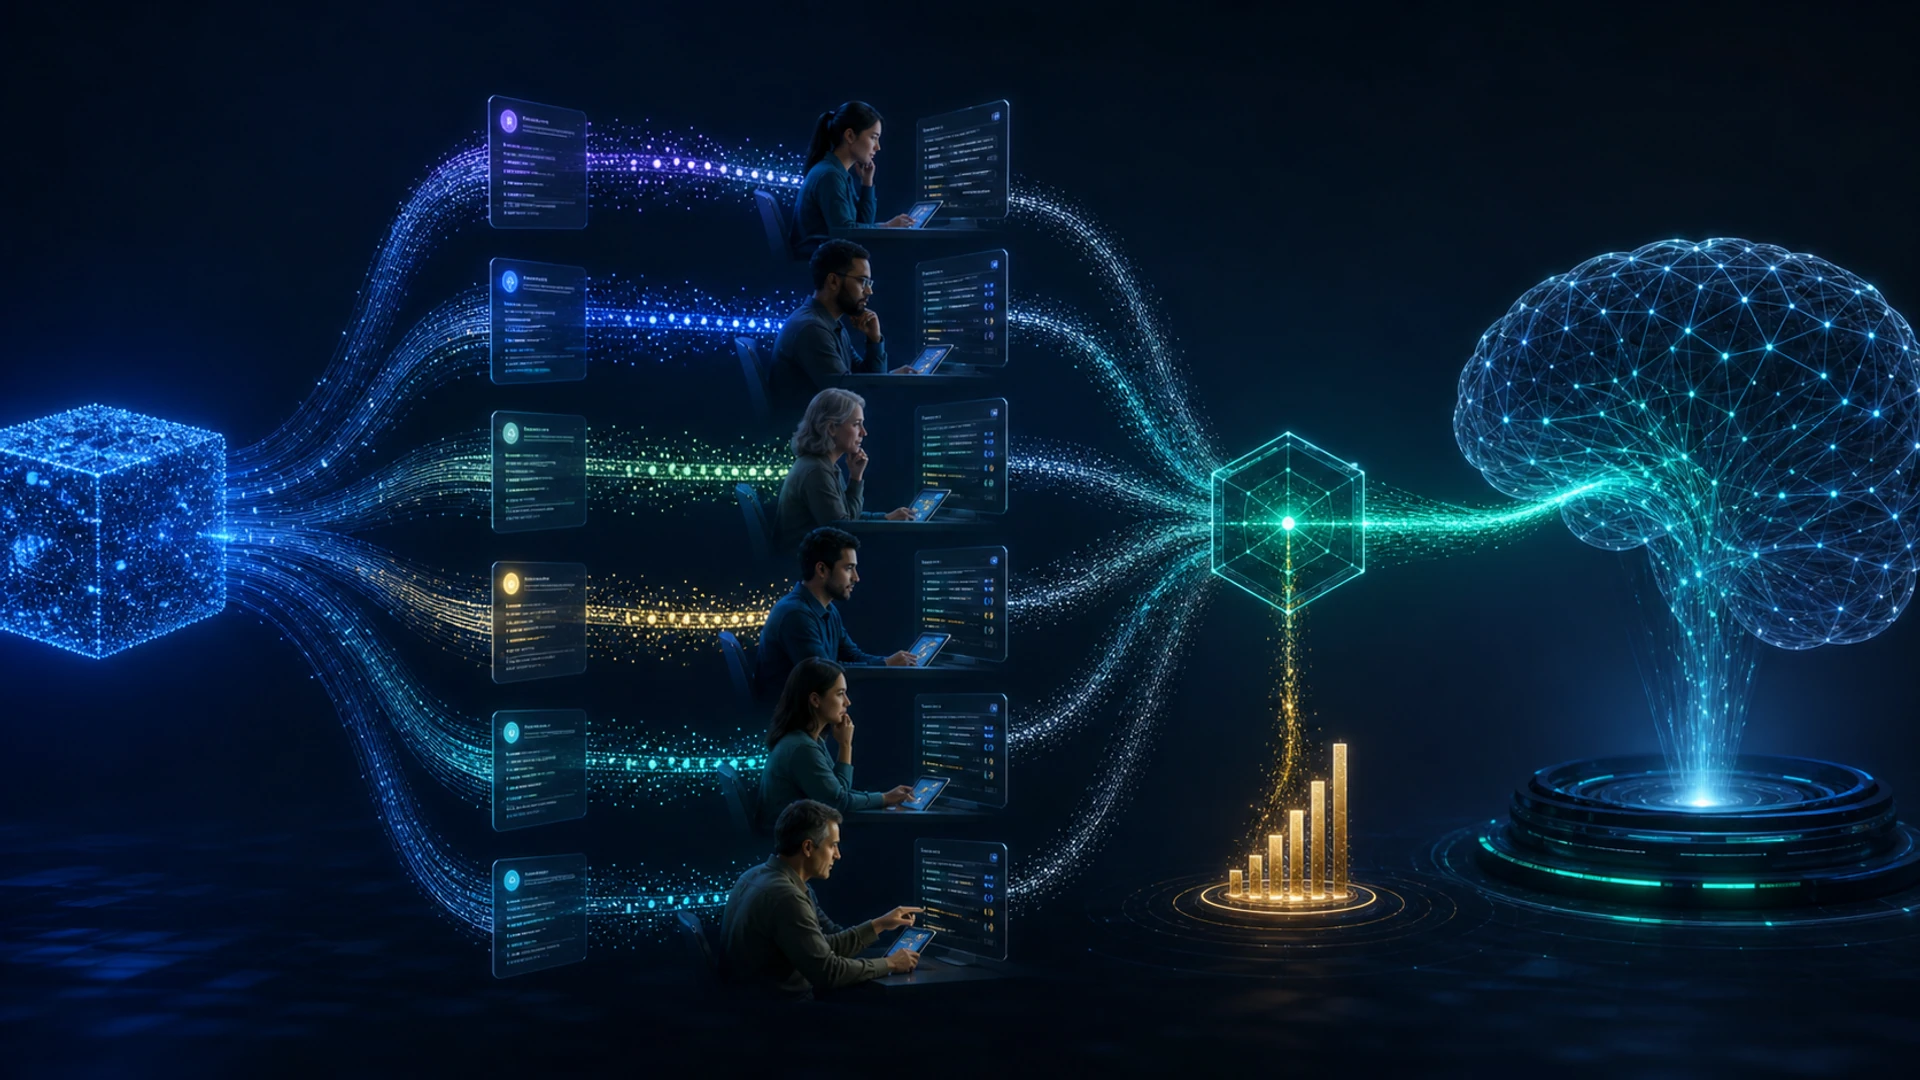
O aprendizado por reforço a partir de feedback humano (RLHF) é um conjunto de métodos que utiliza julgamentos humanos para ajudar a otimizar um modelo quando o comportamento desejado é difícil de especificar com uma recompensa automática simples. Para modelos de linguagem, as pessoas costumam comparar respostas candidatas e um modelo de preferência aprendido transforma essas comparações em um sinal de treinamento.
O RLHF pode tornar um modelo pré‑treinado mais útil ou melhor alinhado a uma política escrita, mas não garante veracidade ou alinhamento com todos os usuários. O resultado depende de quem fornece o feedback, de como os prompts são amostrados, do que o modelo de recompensa pode representar e de como a otimização é restringida.
Principais conclusões
- O RLHF normalmente segue o pré‑treinamento e o ajuste supervisionado por instruções.
- Preferências pareadas treinam um modelo de recompensa ou de preferência; a otimização de política então favorece saídas com pontuações mais altas.
- Manipulação de recompensa, discordância entre anotadores, mudança de distribuição e sobre‑otimização permanecem riscos importantes.
- Avalie a política final diretamente quanto à qualidade da tarefa, segurança, calibração e efeitos em subgrupos.
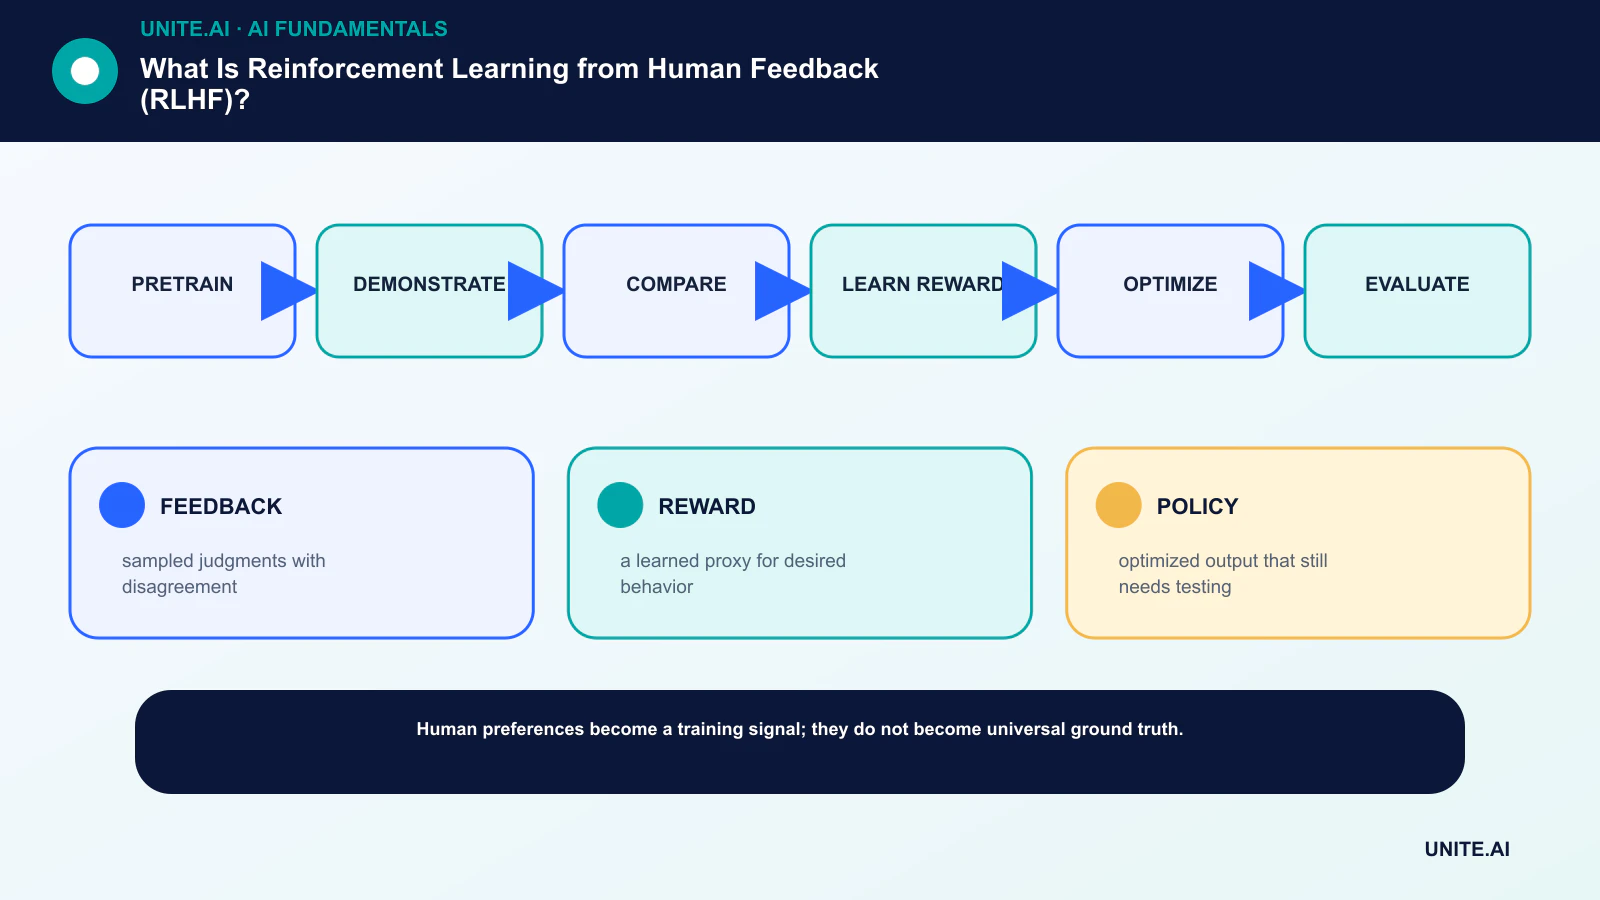
O pipeline comum de RLHF
Um modelo de linguagem primeiro aprende a ampla estrutura estatística por meio do pré‑treinamento. O ajuste supervisionado então usa demonstrações de respostas desejadas. Para a coleta de preferências, anotadores classificam ou escolhem entre saídas para o mesmo prompt.
Um modelo de recompensa aprende a prever essas comparações. Um algoritmo de aprendizado por reforço como PPO pode otimizar o modelo de linguagem contra essa recompensa aprendida enquanto uma penalidade o desencoraja a se afastar demais da política de referência.
Feedback é medição, não verdade absoluta
Os anotadores podem discordar porque as instruções são ambíguas, a expertise difere ou os valores conflitam genuinamente. Posição, verbosidade, confiança e estilo podem enviesar as preferências. Um programa de alta qualidade treina avaliadores, mede concordância, audita exemplos e preserva a incerteza.
A amostragem também importa. Se o conjunto de preferências excluir idiomas difíceis, domínios ou danos, o modelo de recompensa não poderá supervisioná‑los de forma confiável. A disciplina de ciência de dados é tão importante quanto o otimizador.
Modos de falha
A política pode explorar fraquezas na recompensa aprendida, produzindo saídas que pontuam bem sem atender à intenção subjacente. Otimização excessiva pode reduzir a diversidade, amplificar um estilo preferido ou fazer o modelo concordar de forma excessivamente confiante.
O próprio modelo de recompensa pode falhar fora de sua distribuição de treinamento. As equipes devem testar prompts adversariais, tarefas factuais, limites de recusa, calibração e comportamento em diferentes intensidades de otimização, em vez de confiar apenas em uma taxa agregada de vitória de preferência.
Alternativas e complementos
A Otimização Direta de Preferência aprende a partir de pares de preferência sem ajustar uma política separada por meio de um loop online de aprendizado por reforço. Amostragem por rejeição, ajuste supervisionado por preferência, feedback baseado em regras e supervisão de processo oferecem outros trade‑offs.
Nenhum método elimina a necessidade de prompt, recuperação, ferramenta e controles em nível de aplicação. O pós‑treinamento molda o comportamento; sistemas implantados ainda requerem evidência fundamentada, permissões, monitoramento e escalonamento humano.
Como os modelos de preferência são treinados
Para um prompt x e duas respostas y₁ e y₂, um modelo de preferência atribui pontuações escalares e é treinado de modo que a resposta preferida receba a pontuação mais alta. Uma perda comum baseia‑se na probabilidade de que uma pontuação supere a outra. Isso converte muitas avaliações pareadas em uma função que pode pontuar saídas recém‑geradas.
O modelo aprende quaisquer sinais que prevejam as escolhas coletadas. Se avaliadores preferirem prosa confiante, respostas mais longas, normas culturais específicas ou pontos de vista familiares, essas correlações podem se tornar características de recompensa. Instruções balanceadas, contra‑exemplos, revisão de especialistas e auditorias para preferências superficiais reduzem, mas não eliminam, o problema.
Os dados de preferência podem incluir empates, classificações, críticas, rótulos escalares ou demonstrações. A seleção de pares importa: comparações entre respostas obviamente diferentes ensinam menos sobre limites sutis de qualidade, enquanto apenas pares difíceis podem tornar o treinamento instável. Amostragem ativa pode focar em discordâncias informativas, mas pode mudar a distribuição dos dados.
Otimização de política e regularização
O RLHF baseado em PPO amostra respostas da política atual, pontua‑as com o modelo de recompensa e atualiza a política para aumentar a recompensa esperada. Uma penalidade de Kullback–Leibler ou restrição relacionada mantém a política próxima à referência supervisionada, limitando desvios destrutivos e desencorajando a exploração de fraquezas estreitas do modelo de recompensa.
A intensidade da otimização é uma escolha de produto. Pouco deixa o comportamento desejado inalterado; muito pode gerar manipulação de recompensa, frases repetitivas, bajulação ou redução da diversidade. Plote métricas de qualidade e segurança contra recompensa e divergência ao longo do treinamento, em vez de selecionar um ponto de verificação apenas pela recompensa.
Métodos de preferência direta derivam um objetivo a partir de pares de preferência e de um modelo de referência sem um loop online explícito de RL. Eles podem simplificar o treinamento, mas ainda herdaram a qualidade da preferência, cobertura e suposições da política de referência. Feedback constitucional ou gerado por IA altera quem fornece os rótulos; não elimina a necessidade de validar valores e falhas com pessoas.
Avaliação e governança de dados
Use comparações cegas, testes específicos de tarefa, prompts adversariais, verificações de factualidade, precisão e recall de recusa, e revisão por subgrupos. Separe avaliadores dos dados de treinamento sempre que possível. Uma taxa de vitória contra um modelo mais antigo pode ocultar falhas absolutas quando ambos os candidatos são ruins.
Documente recrutamento de anotadores, remuneração, expertise, localização geográfica, idioma, instruções, exposição a conteúdo nocivo, discordâncias, adjudicação e controles de qualidade. O trabalho de feedback pode acarretar risco psicológico, e operações responsáveis de dados incluem suporte ao trabalhador e o direito de recusar tarefas perturbadoras.
Após a implantação, monitore deriva de preferência e sobre‑generalização. Uma política afinada para assistência casual pode se comportar mal em contextos médicos ou jurídicos. Mantenha limites de domínio, recuperação, permissões e escalonamento fora da suposição de RLHF, e re‑treine apenas quando novas evidências justificarem a mudança.
Um pipeline concreto de treinamento e avaliação de RLHF
Um projeto típico começa com um modelo de linguagem pré‑treinado e um conjunto de dados de instruções usado para ajuste supervisionado. Anotadores então comparam respostas candidatas sob um rubro escrito que cobre correção, relevância, estilo, segurança e incerteza. Preferências pareadas treinam um modelo de recompensa ou otimizam diretamente a política. A amostragem deve incluir tarefas ordinárias, casos de borda difíceis, prompts adversariais, múltiplos idiomas e áreas onde os anotadores discordam legitimamente.
A precisão do modelo de recompensa em comparações reservadas é necessária, mas não suficiente. A política otimizada pode explorar erros na recompensa aprendida, tornar‑se excessivamente verbosa, recusar solicitações inofensivas ou perder capacidades. Acompanhe benchmarks de tarefa, preferência humana, calibração, segurança, diversidade e divergência do modelo de referência ao longo do treinamento. Periodicamente colete novas comparações da política em mudança para que os dados de preferência cubram as saídas que o modelo realmente produz.
Documente quem forneceu as preferências, suas instruções, remuneração, discordâncias, controles de qualidade e limites culturais ou de domínio. Use revisores especialistas onde erros acarretam danos específicos. Realize red‑team tanto no modelo de recompensa quanto na política final, mantenha testes de regressão comportamental e faça a implantação em etapas. O RLHF molda o comportamento de acordo com preferências medidas; não prova veracidade, elimina viés ou resolve o problema mais amplo de especificar o que um modelo deve fazer em cada contexto.
Checklist de implementação prática
Transforme o conceito em um fluxo de trabalho delimitado e testável: pré‑treinar → demonstrar → comparar → aprender recompensa → otimizar → avaliar. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e de parada, teste falhas representativas e defina monitoramento, reversão e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, execute uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de fronteira, falhas de dependência e mau uso; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, mudar um limiar, sobrescrever uma saída ou interromper a operação. Revise a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- FEEDBACK: julgamentos amostrados com discordância.
- REWARD: um proxy aprendido para o comportamento desejado.
- POLICY: saída otimizada que ainda precisa ser testada.
Perguntas frequentes
O RLHF é o mesmo que ajuste fino?
O RLHF é uma forma de pós‑treinamento que usa recompensas derivadas de preferência. O ajuste fino supervisionado treina diretamente nas saídas alvo; muitas pipelines utilizam ambos.
O RLHF torna um modelo veraz?
Ele pode melhorar o comportamento medido pelo processo de feedback, mas um modelo ainda pode estar errado, ser persuasivo ou explorar estrategicamente a recompensa. A veracidade requer avaliação direta e fundamentação.
Referências principais












