
Fundamentos de IA
O que é Aprendizado por Reforço Profundo?

 Adicione Unite.AI às suas fontes preferidas no Google
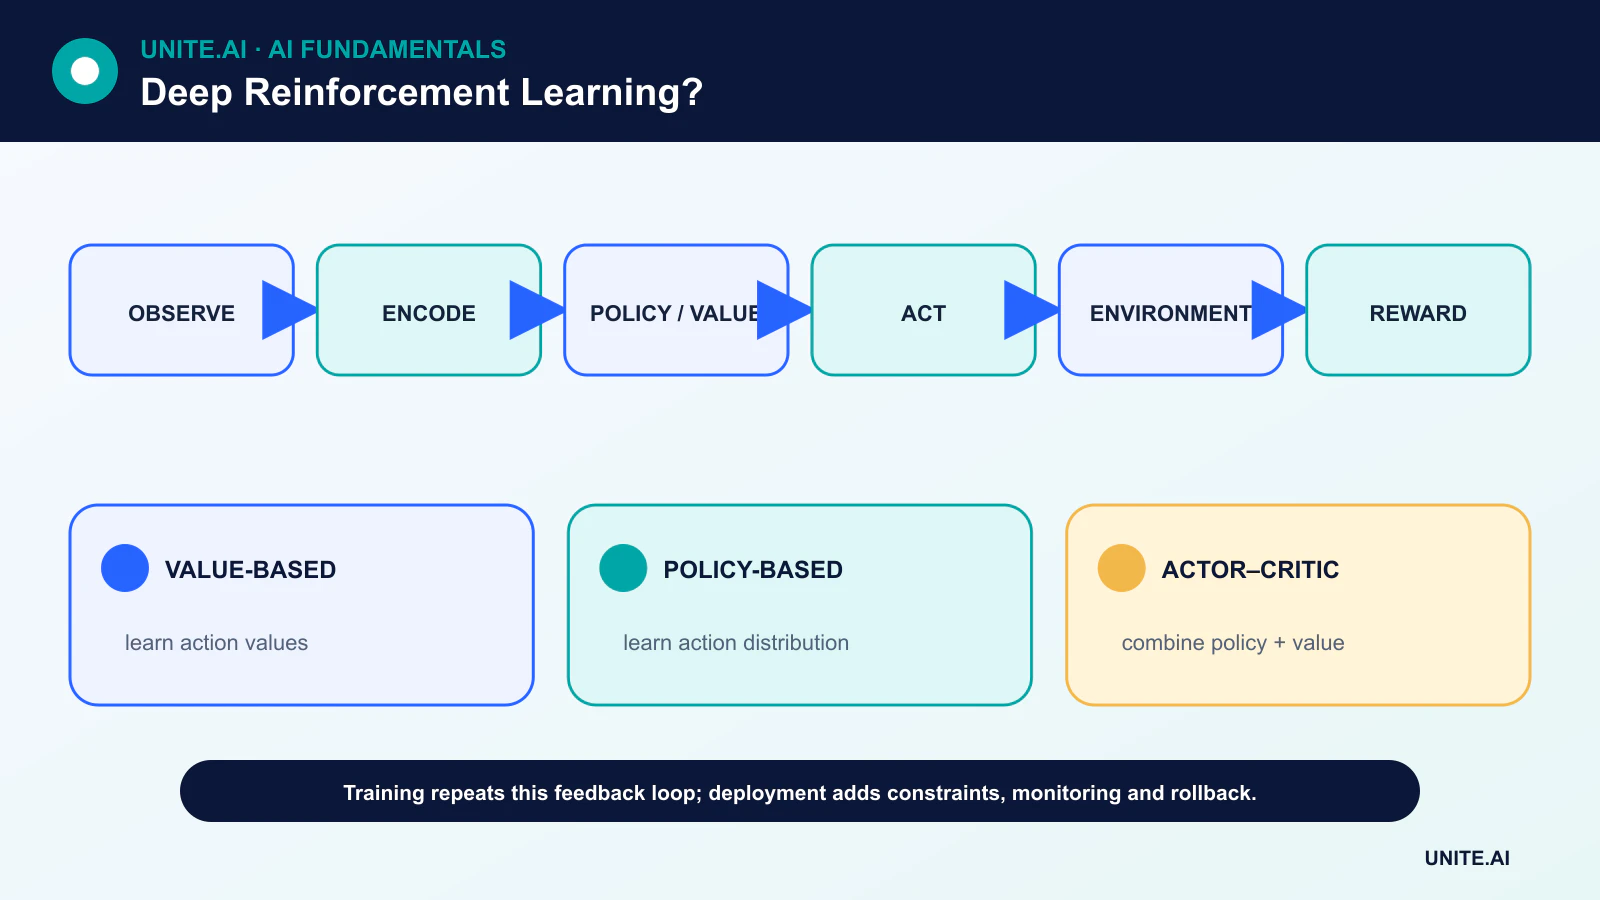
Deep reinforcement learning (deep RL) combina aprendizado por reforço com redes neurais profundas. Um agente observa um estado, escolhe uma ação, recebe uma recompensa e uma nova observação, então ajusta uma política ou função de valor para melhorar decisões futuras.
A rede profunda não elimina as partes difíceis do aprendizado por reforço. Ela oferece uma forma flexível de representar imagens, fluxos de sensores, grandes espaços de ação ou funções de valor complexas. Exploração, crédito atrasado, treinamento instável e avaliação segura no mundo real permanecem problemas centrais de engenharia.
Principais conclusões
- O Deep RL aprende decisões sequenciais a partir da interação, em vez de uma tabela fixa de exemplos rotulados.
- Métodos baseados em valor estimam quão boas são as ações; métodos de política aprendem diretamente a distribuição de ações; métodos ator‑crítico combinam ambos.
- Buffers de replay, redes‑alvo e um design cuidadoso de recompensas podem melhorar o treinamento, mas nenhum garante um comportamento confiável.
- Uma alta pontuação em simulador não prova robustez, segurança ou transferência bem‑sucedida para o mundo físico.
O problema de decisão: estados, ações e recompensas
Muitas tarefas de deep RL são modeladas como um processo de decisão de Markov. No instante t, o agente recebe o estado ou observação s_t, seleciona a ação a_t, então recebe a recompensa r_{t+1} e o próximo estado. O objetivo é o retorno descontado esperado, não necessariamente apenas a recompensa imediata.
O fator de desconto controla o quanto recompensas distantes importam. Uma função de recompensa define o que o processo de otimização buscará, de modo que um proxy incompleto pode gerar comportamentos tecnicamente bem‑sucedidos, porém operacionalmente indesejáveis. Essa é uma das razões pelas quais o design de recompensas e o teste de restrições merecem a mesma atenção que a arquitetura do modelo.
Métodos baseados em valor, baseados em política e ator‑crítico
Um algoritmo baseado em valor estima o valor de um estado ou de uma ação. Deep Q‑networks utilizam uma rede neural para aproximar os valores Q e tipicamente escolhem a ação com a maior estimativa, preservando certa exploração. Um algoritmo de gradiente de política, por outro lado, otimiza uma política parametrizada que gera uma distribuição de ações.
Sistemas ator‑crítico mantêm tanto um ator, que propõe ações, quanto um crítico, que estima seu valor. Esse design suporta controle contínuo, mas introduz fontes interativas de erro de estimativa. Portanto, o Deep RL depende das mesmas bases que aprendizado profundo, gradiente descendente e retropropagação.
Por que buffers de replay e redes‑alvo ajudam
Amostras de experiência sucessivas são correlacionadas, enquanto uma atualização de rede altera os alvos usados por atualizações posteriores. O replay de experiência rompe parte dessa correlação temporal ao amostrar transições mais antigas. Uma rede‑alvo muda mais lentamente que a rede online, tornando os alvos bootstrap menos voláteis.
Esses mecanismos melhoram a estabilidade do treinamento, mas a sintonização ainda importa. Taxa de aprendizado, agenda de exploração, escala de recompensa, composição do replay e capacidade da rede podem mudar o resultado. Várias sementes aleatórias devem ser relatadas, pois uma única execução pode ser enganosa.
RL offline, RL baseado em modelo e sim‑to‑real
RL offline aprende a partir de um conjunto de dados registrado fixo, sem coletar novas interações. Pode ser útil quando a exploração é cara ou insegura, mas a política deve evitar ações pouco representadas no registro. RL baseado em modelo aprende ou utiliza um modelo de transição para planejar, trocando suposições adicionais por maior eficiência de amostras.
Robótica costuma treinar em simulação, randomizando parâmetros físicos, e depois ajusta ou valida no hardware. O gap de realidade ainda pode expor erros de percepção, temporização, dinâmica de contato e casos extremos não modelados. Um sistema de aprendizado por reforço deve ser avaliado sob perturbações, mudança de distribuição e restrições de segurança explícitas.
Avaliação e implantação
Uma avaliação útil separa ambientes de treinamento e teste, relata distribuições de retorno em vez de apenas a melhor pontuação, e verifica violações de restrições, frequência de intervenções e comportamento de pior caso. Para sistemas reais, as equipes também precisam de monitoramento, procedimentos de reversão, espaços de ação limitados e uma intervenção humana.
O Deep RL é mais atraente quando as decisões são sequenciais, há feedback disponível e regras de controle escritas à mão são inadequadas. É uma escolha ruim quando há abundância de rótulos supervisionados, um otimizador convencional resolve o problema, ou a exploração colocaria pessoas ou ativos em risco.
Arquiteturas de Deep RL e sinais de treinamento
O aprendizado por reforço profundo utiliza redes neurais para representar uma função de valor, política, modelo de ambiente ou alguma combinação. Uma deep Q‑network prediz valores de ação e aprende a partir de alvos de diferença temporal; o replay de experiência reduz a correlação entre atualizações, enquanto uma rede‑alvo estabiliza o objetivo em movimento. Métodos de gradiente de política otimizam o retorno esperado diretamente, e métodos ator‑crítico utilizam um crítico aprendido para reduzir a variância do gradiente. Ações contínuas frequentemente requerem variantes determinísticas ou estocásticas de ator‑crítico, enquanto ações discretas de alta dimensão exigem exploração cuidadosa e design de saída.
O treinamento é não estacionário porque a política altera os dados que coleta. Dados de replay tornam‑se off‑policy, alvos bootstrap dependem de estimativas atuais, e a aproximação de função pode amplificar erros — combinação às vezes chamada de tríade mortal. Estimadores duplos reduzem a superestimação de valor; funções de vantagem melhoram a atribuição de crédito; bônus de entropia incentivam a exploração; objetivos recortados restringem atualizações destrutivas da política. Normalizar observações e recompensas apenas com estado seguro contra vazamento, e registrar ambiente, wrapper, repetição de ação, terminação e pré‑processamento de recompensa, pois cada um altera o problema.
Avaliação, simuladores e segurança na implantação
Relate distribuições de retorno em diferentes sementes independentes e instâncias de ambiente, não apenas a melhor execução. Avalie eficiência de amostras, violações de restrições, resultados catastróficos, sensibilidade à escala de recompensa e robustez a ruído de observação, atraso, erro de atuador e mudanças de dinâmica. Compare com controle scriptado, controle clássico, imitação supervisionada e RL mais simples. Reserve variações de ambiente e teste métricas de resultado sem recompensa, pois um agente pode explorar a recompensa programada enquanto falha na tarefa pretendida. Inspeções de vídeo e trajetórias frequentemente revelam comportamentos ocultos por retornos agregados.
A simulação permite exploração, mas introduz um gap de realidade. Randomize física e percepção relevantes, calibre contra medições reais e use transferência conservadora. Dados registrados ou RL offline evitam exploração online, mas não podem avaliar de forma confiável ações não suportadas pela política de comportamento. Sistemas de produção devem limitar o conjunto de ações, taxa, recursos e envelope operacional; exigir aprovação para ações de alto impacto; e incluir um controlador seguro verificado ou parada. Monitore entradas da política, distribuição de ações, recompensa, resultados reais e intervenções, com reversão para uma versão de política testada.
Um exemplo concreto de controle
Para roteamento de robôs em armazém, defina o estado a partir da localização, carga, bateria, tráfego próximo e fila de tarefas; as ações a partir de movimentos permitidos e decisões de carregamento; e a recompensa a partir do trabalho concluído, energia, congestionamento e restrições de segurança. Treine primeiro em um simulador calibrado com demanda aleatória e falhas de sensores, depois acompanhe decisões reais. Nunca permita que a política aprendida contorne a prevenção de colisões. Avalie o rendimento junto com quase acidentes, deadlocks, emergências de bateria e atraso no pior caso. O projeto só tem sucesso se o sistema em camadas melhorar as operações sem transferir risco de exploração inaceitável para pessoas ou equipamentos.
Exemplo prático: DRL para refrigeração de data center
Um data center restringe um agente RL a pontos de ajuste de refrigeração aprovados e o treina em um simulador calibrado a partir de dados históricos de clima, carga de trabalho, temperaturas e resposta de equipamentos. A recompensa inclui energia, mas restrições rígidas protegem separadamente temperatura, umidade e ciclos de equipamento. Controle preditivo baseado em modelo e regras existentes são linhas de base. A avaliação abrange estações, ruído de sensores, atraso de atuadores, falhas de equipamentos, cargas incomuns e múltiplas sementes, relatando energia, violações, variância e recuperação.
A política aprendida opera em modo sombra antes de um teste em zona limitada. Um controlador de segurança externo limita ações e operadores podem intervir. Taxa de ação, cobertura de estado, incerteza do modelo e resultados reais da instalação são monitorados; divergência do simulador ou intervenções repetidas acionam reversão. Equipamentos ou lógica de controle atualizados criam uma nova versão de ambiente e validação. Economias de energia são aceitas somente quando confiabilidade, margem térmica, manutenção e resposta a falhas permanecem pelo menos tão fortes quanto a linha de base.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, rendimento, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas inseridas deliberadamente. A telemetria operacional deve revelar a qualidade das entradas, comportamento das saídas, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação, em vez de supor que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O aprendizado por reforço profundo é o mesmo que aprendizado profundo?
Não. O aprendizado profundo fornece os aproximadores de função; o aprendizado por reforço fornece a interação, a recompensa e o objetivo de decisão sequencial.
Uma alta recompensa significa que o agente aprendeu o comportamento pretendido?
Não necessariamente. Significa que a política encontrou um comportamento que pontua bem sob a recompensa e o ambiente implementados. Testes independentes de segurança e alinhamento de objetivo ainda são necessários.
Referências principais












