
Modelos e plataformas de IA
Melhorando a Geração de Tela Verde para Difusão Estável

 Adicione Unite.AI às suas fontes preferidas no Google
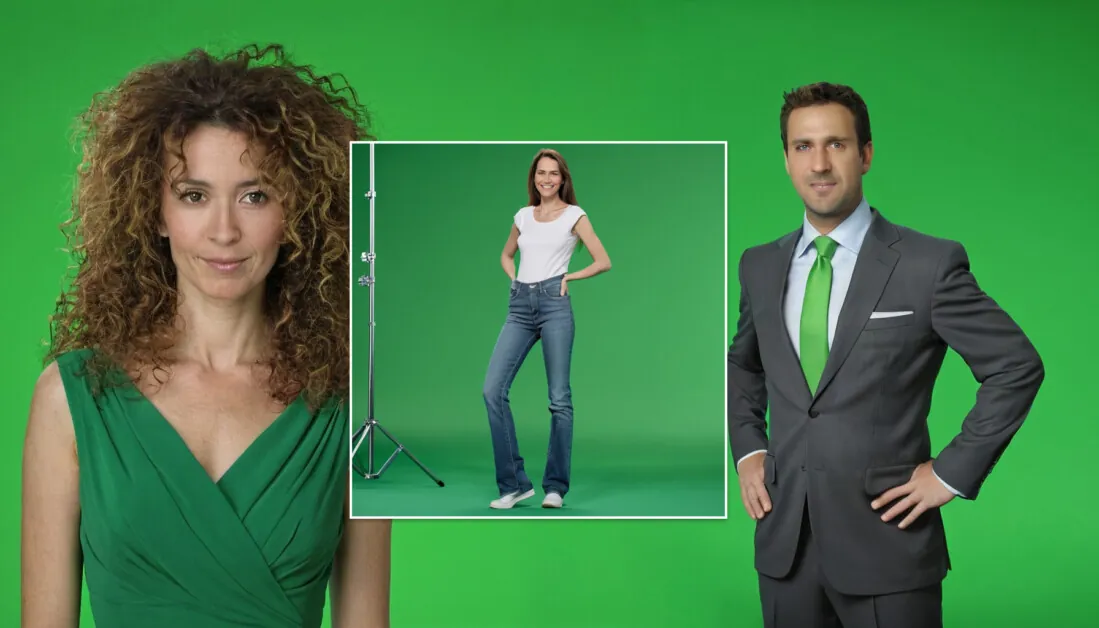
Apesar do entusiasmo da comunidade e dos investidores em torno da inteligência artificial visual gerativa, a saída desses sistemas nem sempre está pronta para uso no mundo real; um exemplo disso é que os sistemas de IA gerativa tendem a produzir imagens inteiras (ou uma série de imagens, no caso de vídeo), em vez dos elementos individuais e isolados que são normalmente necessários para aplicações diversificadas em multimídia e para profissionais de efeitos visuais.
Um exemplo simples disso é o clip-art projetado para “flutuar” sobre qualquer plano de fundo que o usuário tenha selecionado:

O fundo de xadrez cinza-claro, talvez mais familiar aos usuários do Photoshop, veio a representar o canal alfa, ou canal de transparência, mesmo em itens de consumo simples, como imagens em estoque.
A transparência desse tipo tem sido comumente disponível por mais de trinta anos; desde a revolução digital do início dos anos 1990, os usuários têm sido capazes de extrair elementos de vídeo e imagens por meio de uma série cada vez mais sofisticada de conjuntos de ferramentas e técnicas.
Por exemplo, o desafio de “remover” fundos de tela azul e verde em footagens de vídeo, que antes era o domínio de processos químicos caros e impressoras ópticas (além de molduras feitas à mão), se tornaria o trabalho de minutos em sistemas como os aplicativos After Effects e Photoshop da Adobe (entre muitos outros programas e sistemas gratuitos e proprietários).
Uma vez que um elemento tenha sido isolado, um canal alfa (efetivamente uma máscara que obscurece qualquer conteúdo não relevante) permite que qualquer elemento no vídeo seja superposto facilmente sobre novos planos de fundo, ou composto junto com outros elementos isolados.

Exemplos de canais alfa, com seus efeitos representados na linha inferior. Fonte: https://helpx.adobe.com/photoshop/using/saving-selections-alpha-channel-masks.html
Removendo
Na visão computacional, a criação de canais alfa cai dentro do âmbito da segmentação semântica, com projetos de código aberto, como o Segment Anything da Meta, que fornece um método de isolamento/extração de objetos-alvo por meio de reconhecimento de objetos semanticamente aprimorado.
O framework Segment Anything foi usado em uma ampla gama de fluxos de trabalho de extração e isolamento de efeitos visuais, como o projeto Alpha-CLIP.

Exemplos de extrações usando Segment Anything, no framework Alpha-CLIP: Fonte: https://arxiv.org/pdf/2312.03818
Há muitos métodos alternativos de segmentação semântica que podem ser adaptados à tarefa de atribuir canais alfa.
No entanto, a segmentação semântica depende de dados treinados que podem não conter todas as categorias de objeto necessárias para serem extraídas. Embora os modelos treinados em grandes volumes de dados possam permitir um maior número de objetos a serem reconhecidos (efetivamente se tornando modelos fundamentais ou modelos de mundo), eles ainda são limitados pelas classes que são treinadas para reconhecer com mais eficácia.

Sistemas de segmentação semântica, como o Segment Anything, podem ter dificuldade em identificar certos objetos ou partes de objetos, como exemplificado aqui na saída de prompts ambíguos. Fonte: https://maucher.pages.mi.hdm-stuttgart.de/orbook/deeplearning/SAM.html
Em qualquer caso, a segmentação semântica é tanto um processo pós-fato quanto um procedimento de tela verde, e deve isolar elementos sem a vantagem de uma única faixa de cor de fundo que possa ser efetivamente reconhecida e removida.
Por essa razão, ocasionalmente ocorreu à comunidade de usuários que as imagens e vídeos poderiam ser gerados que realmente contenham fundos de tela verde que poderiam ser instantaneamente removidos por meio de métodos convencionais.
Infelizmente, os modelos de difusão latente populares, como o Stable Diffusion, frequentemente têm alguma dificuldade em renderizar uma tela verde realmente vívida. Isso ocorre porque os dados de treinamento dos modelos não contêm muitos exemplos desse cenário especializado. Mesmo quando o sistema tem sucesso, a ideia de ‘verde’ tende a se espalhar de maneira indesejada para o assunto de primeiro plano, devido à entanglement de conceito:

Acima, vemos que o Stable Diffusion priorizou a autenticidade da imagem sobre a necessidade de criar uma única intensidade de verde, efetivamente replicando problemas do mundo real que ocorrem em cenários de tela verde tradicionais. Abaixo, vemos que o conceito de ‘verde’ poluiu a imagem de primeiro plano. Quanto mais o prompt se concentra no conceito de ‘verde’, pior esse problema é provável que se torne. Fonte: https://stablediffusionweb.com/
Apesar dos métodos avançados em uso, tanto o vestido da mulher quanto a gravata do homem (nas imagens inferiores vistas acima) tenderiam a ‘sumir’ junto com o fundo verde – um problema que remonta aos dias de remoção de cor de emulsão fotoquímica nos anos 1970 e 1980.
Como sempre, as limitações de um modelo podem ser superadas jogando dados específicos em um problema e dedicando consideráveis recursos de treinamento. Sistemas como o LayerDiffuse da Stanford criam um modelo fine-tuned capaz de gerar imagens com canais alfa:

O projeto LayerDiffuse da Stanford foi treinado em um milhão de imagens apropriadas capazes de infundir no modelo capacidades de transparência. Fonte: https://arxiv.org/pdf/2402.17113
Infelizmente, além dos consideráveis recursos de curadoria e treinamento necessários para essa abordagem, o conjunto de dados usado para o LayerDiffuse não está disponível publicamente, restringindo o uso de modelos treinados nele. Mesmo que esse impedimento não existisse, essa abordagem é difícil de personalizar ou desenvolver para casos de uso específicos.
Um pouco mais tarde em 2024, a Adobe (ADBE ) Research colaborou com a Universidade de Stonybrook para produzir MAGICK, uma abordagem de extração de IA treinada em imagens de difusão personalizadas.

Do artigo de 2024, um exemplo de extração de canal alfa de granulação fina em MAGICK. Fonte: https://openaccess.thecvf.com/content/CVPR2024/papers/Burgert_MAGICK_A_Large-scale_Captioned_Dataset_from_Matting_Generated_Images_using_CVPR_2024_paper.pdf
150.000 objetos extraídos e gerados por IA foram usados para treinar o MAGICK, para que o sistema desenvolvesse uma compreensão intuitiva da extração:

Amostras do conjunto de dados de treinamento do MAGICK.
Esse conjunto de dados, como afirma o artigo de origem, foi muito difícil de gerar pela razão mencionada anteriormente – que os métodos de difusão têm dificuldade em criar faixas sólidas de cor. Portanto, a seleção manual das máscaras geradas foi necessária.
Essa gargalo logístico leva novamente a um sistema que não pode ser facilmente desenvolvido ou personalizado, mas deve ser usado dentro de sua capacidade inicialmente treinada.
TKG-DM – Extração de Croma ‘Nativa’ para um Modelo de Difusão Latente
Uma nova colaboração entre pesquisadores alemães e japoneses propôs uma alternativa a esses métodos treinados, capaz – afirma o artigo – de obter melhores resultados do que os métodos mencionados acima, sem a necessidade de treinar em conjuntos de dados especialmente curados.

O TKG-DM altera o ruído aleatório que semeia uma imagem gerada para que seja melhor capaz de produzir um fundo sólido e chaveável – em qualquer cor. Fonte: https://arxiv.org/pdf/2411.15580
A nova abordagem aborda o problema no nível de geração, otimizando o ruído aleatório a partir do qual uma imagem é gerada em um modelo de difusão latente (LDM) como o Stable Diffusion.
A abordagem se baseia em uma investigação anterior sobre o esquema de cor de uma distribuição de Stable Diffusion, e é capaz de produzir cor de fundo de qualquer tipo, com menos (ou nenhum) entanglement da cor de fundo chaveada no conteúdo de primeiro plano, em comparação com outros métodos.

O ruído inicial é condicionado por um deslocamento de média de canal que pode influenciar aspectos do processo de desruído, sem entanglement do sinal de cor no conteúdo de primeiro plano.
O artigo afirma:
‘Nossos experimentos extensivos demonstram que o TKG-DM melhora as pontuações FID e mask-FID em 33,7% e 35,9%, respectivamente.
‘Portanto, nosso modelo de treinamento livre rivaliza com modelos fine-tuned, oferecendo uma solução eficiente e versátil para várias tarefas de criação de conteúdo visual que exigem controle preciso de primeiro plano e fundo. ‘
O novo artigo é intitulado TKG-DM: Modelo de Difusão de Conteúdo de Chave de Croma de Treinamento Livre, e vem de sete pesquisadores da Universidade Hosei em Tóquio e RPTU Kaiserslautern-Landau & DFKI GmbH, em Kaiserslautern.
Método
A nova abordagem estende a arquitetura do Stable Diffusion condicionando o ruído gaussiano inicial por meio de um deslocamento de média de canal (CMS), que produz padrões de ruído projetados para encorajar a separação desejada de fundo e primeiro plano no resultado gerado.

Esquema para o fluxo de trabalho do sistema proposto.
O CMS ajusta a média de cada canal de cor enquanto mantém o desenvolvimento geral do processo de desruído.
Os autores explicam:
‘Para gerar o objeto de primeiro plano no fundo de chave de croma, aplicamos uma estratégia de seleção de ruído inicial que combina seletivamente o ruído inicial e o ruído de cor inicial usando uma máscara gaussiana 2D.
‘Essa máscara cria uma transição gradual preservando o ruído original na região de primeiro plano e aplicando o ruído deslocado de cor na região de fundo.’

O canal de cor desejado para a cor de croma do fundo é instanciado com um prompt de texto nulo, enquanto o conteúdo de primeiro plano real é criado semanticamente a partir da instrução de texto do usuário.
A autatenção e a atenção cruzada são usadas para separar os dois aspectos da imagem (o fundo de croma e o conteúdo de primeiro plano). A autatenção ajuda com a consistência interna do objeto de primeiro plano, enquanto a atenção cruzada mantém a fidelidade ao prompt de texto. O artigo observa que, como a imagem de fundo é usualmente menos detalhada e enfatizada nas gerações, sua influência mais fraca é relativamente fácil de superar e substituir por uma faixa de cor pura.

Visualização da influência da autatenção e atenção cruzada no processo de geração de estilo de croma.
Dados e Testes
O TKG-DM foi testado usando o Stable Diffusion V1.5 e o Stable Diffusion SDXL. As imagens foram geradas em 512x512px e 1024x1024px, respectivamente.
As imagens foram criadas usando o agendador DDIM nativo do Stable Diffusion, em uma escala de orientação de 7,5, com 50 etapas de desruído. A cor de fundo alvo foi verde, agora o método de dropout dominante.
A nova abordagem foi comparada ao DeepFloyd, sob as configurações usadas para o MAGICK; ao modelo de difusão de baixo ranque fine-tuned GreenBack LoRA; e também ao mencionado LayerDiffuse.
Para os dados, 3000 imagens do conjunto de dados do MAGICK foram usadas.

Exemplos do conjunto de dados do MAGICK, dos quais 3000 imagens foram curadas nos testes para o novo sistema. Fonte: https://ryanndagreat.github.io/MAGICK/Explorer/magick_rgba_explorer.html
Para as métricas, os autores usaram a Distância de Incepção de Fréchet (FID) para avaliar a qualidade do primeiro plano. Eles também desenvolveram uma métrica específica do projeto chamada m-FID, que usa o sistema BiRefNet para avaliar a qualidade da máscara resultante.

Comparações visuais do sistema BiRefNet contra métodos anteriores. Fonte: https://arxiv.org/pdf/2401.03407
Para testar o alinhamento semântico com os prompts de entrada, os métodos CLIP-Sentence (CLIP-S) e CLIP-Image (CLIP-I) foram usados. O CLIP-S avalia a fidelidade do prompt, e o CLIP-I a similaridade visual com a verdade de base.

Primeiro conjunto de resultados qualitativos para o novo método, desta vez para o Stable Diffusion V1.5. Por favor, consulte o PDF de origem para uma melhor resolução.
Os autores afirmam que os resultados (visualizados acima e abaixo, SD1.5 e SDXL, respectivamente) demonstram que o TKG-DM obtém resultados superiores sem engenharia de prompt ou a necessidade de treinar ou fine-tunar um modelo.

Resultados qualitativos do SDXL. Por favor, consulte o PDF de origem para uma melhor resolução.
Eles observam que, com um prompt para incitar um fundo verde nas imagens geradas, o Stable Diffusion 1.5 tem dificuldade em gerar um fundo limpo, enquanto o SDXL (embora performando um pouco melhor) produz tons de verde instáveis propensos a interferir na separação em um processo de croma.
Eles notam ainda que, embora o LayerDiffuse gere fundos bem separados, ele ocasionalmente perde detalhes, como números ou letras precisas, e os autores atribuem isso a limitações no conjunto de dados. Eles acrescentam que a geração de máscara também ocasionalmente falha, levando a imagens ‘não cortadas’.
Para os testes quantitativos, embora o LayerDiffuse aparentemente tenha a vantagem no SDXL para a FID, os autores enfatizam que isso é resultado de um conjunto de dados especializado que efetivamente constitui um produto ‘assado’ e não flexível. Como mencionado anteriormente, quaisquer objetos ou classes não cobertos nesse conjunto de dados, ou cobertos inadequadamente, podem não se sair tão bem, enquanto o fine-tuning adicional para acomodar classes novas apresenta ao usuário uma carga de curadoria e treinamento.

Resultados quantitativos para as comparações. A aparente vantagem do LayerDiffuse, o artigo implica, vem à custa da flexibilidade e da carga de curadoria e treinamento.
O artigo afirma:
‘As pontuações FID, m-FID e CLIP-I altas do DeepFloyd refletem sua semelhança com a verdade de base com base nas saídas do DeepFloyd. No entanto, essa alinhamento dá a ele uma vantagem inerente, tornando-o inadequado como uma referência justa para a qualidade da imagem. Sua pontuação CLIP-S mais baixa indica ainda uma alinhamento de texto mais fraco em comparação com outros modelos.
‘No geral, esses resultados destacam a capacidade do nosso modelo de gerar primeiros planos de alta qualidade e alinhados com o texto sem fine-tuning, oferecendo uma solução eficiente de geração de conteúdo de chave de croma.’
Finalmente, os pesquisadores realizaram um estudo de usuário para avaliar a aderência ao prompt entre os diferentes métodos. Cem participantes foram solicitados a julgar 30 pares de imagens de cada método, com assuntos extraídos usando o BiRefNet e refinamentos manuais em todos os exemplos. A abordagem de treinamento livre dos autores foi preferida nesse estudo.

Resultados do estudo de usuário.
O TKG-DM é compatível com o sistema de terceiros popular ControlNet para o Stable Diffusion, e os autores afirmam que ele produz resultados superiores à capacidade nativa do ControlNet de alcançar esse tipo de separação.
Conclusão
Talvez a principal conclusão a ser tirada desse novo artigo seja a extensão com que os modelos de difusão latente estão entrelaçados, em contraste com a percepção pública popular de que eles podem separar facilmente aspectos de imagens e vídeos ao gerar novo conteúdo.
O estudo enfatiza ainda a extensão com que a comunidade de pesquisa e hobbyistas se voltou para o fine-tuning como uma solução pós-fato para as limitações dos modelos – uma solução que sempre abordará classes e tipos de objeto específicos. Nesse cenário, um modelo fine-tuned funcionará muito bem em um número limitado de classes ou funcionará toleravelmente bem em um volume muito maior de classes e objetos possíveis, de acordo com maiores quantidades de dados nos conjuntos de treinamento.
Portanto, é refrescante ver pelo menos uma solução que não depende de soluções laboriosas e arguivelmente desonestas.
* ao filmar o filme Superman de 1978, o ator Christopher Reeve foi obrigado a usar um traje do Superman de cor turquesa para as cenas de tela azul, para evitar que o traje azul icônico fosse apagado. A cor azul do traje foi restaurada posteriormente por meio de color-grading.


