
Podstawy AI
Czym jest uczenie federacyjne?

 Dodaj Unite.AI do preferowanych źródeł w Google
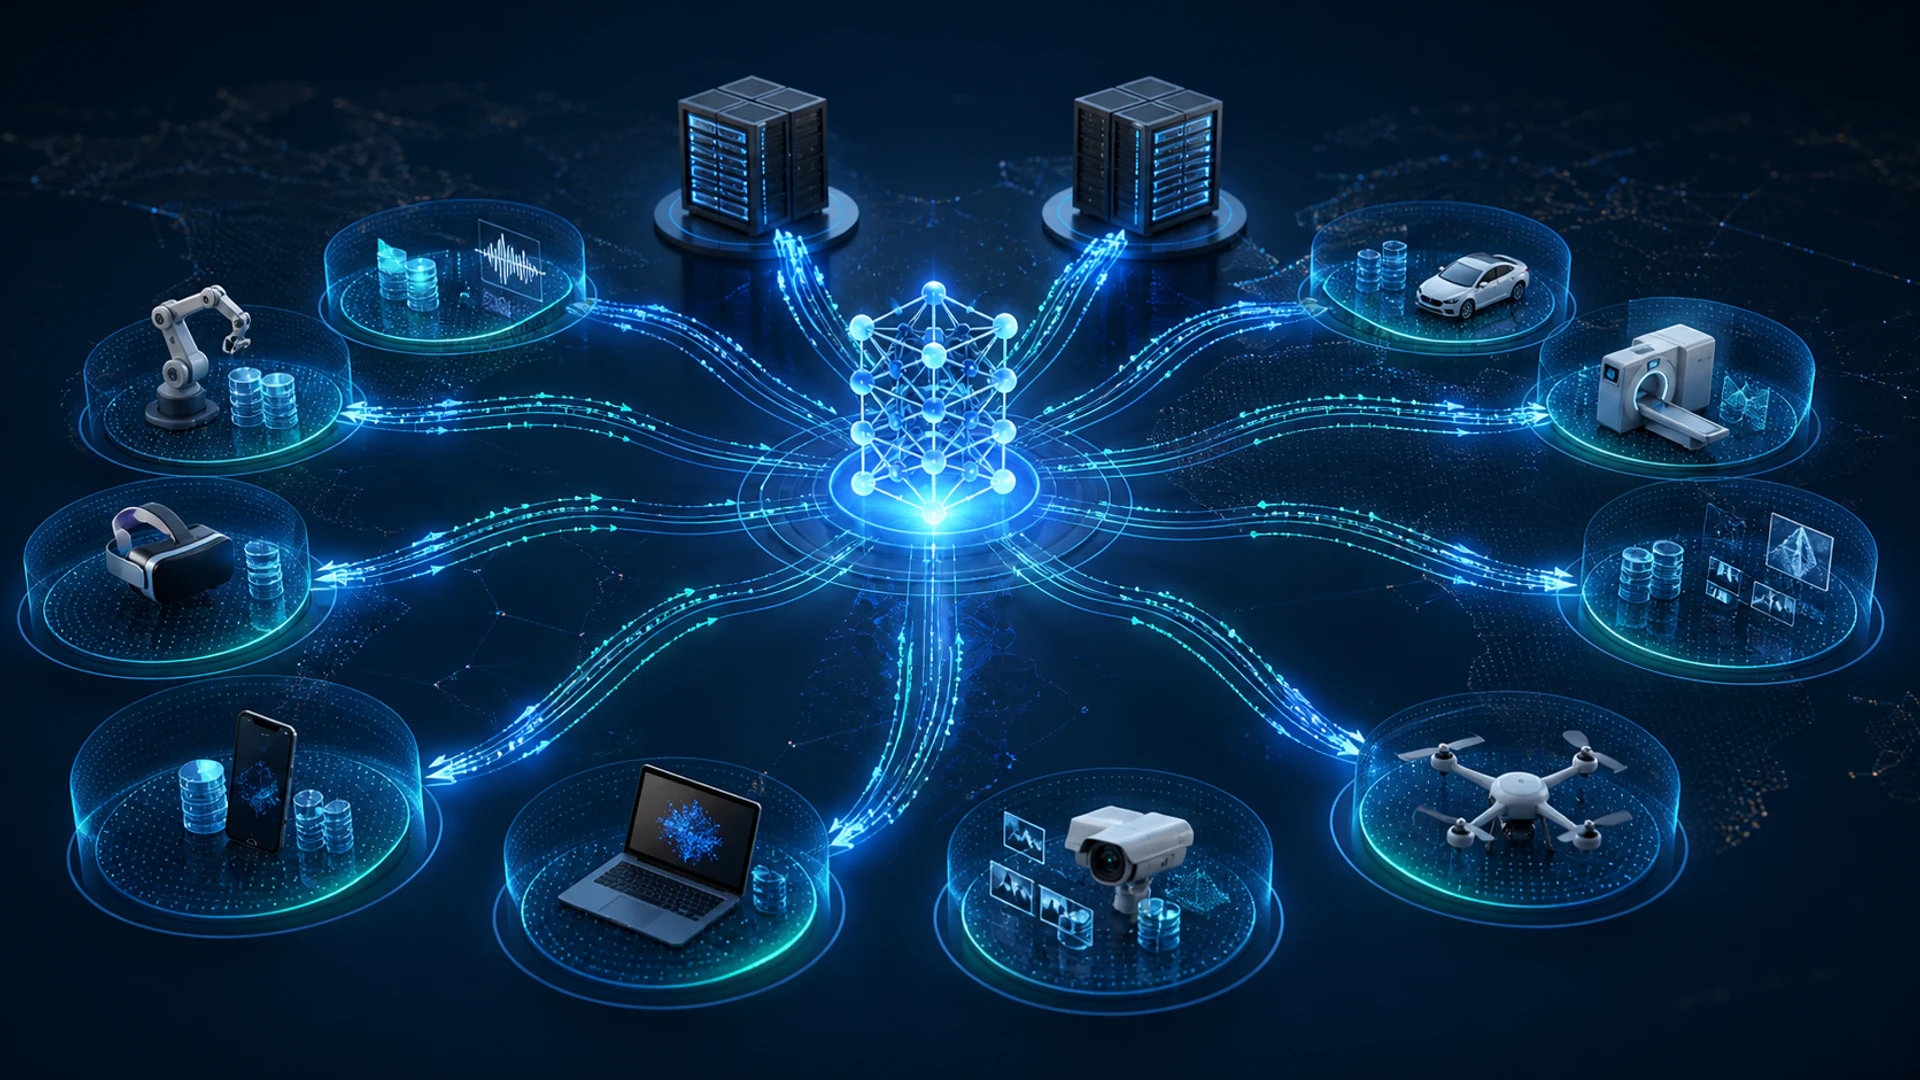
Uczenie federacyjne trenuje wspólny model na wielu urządzeniach lub w organizacjach, jednocześnie pozostawiając surowe dane treningowe każdego uczestnika lokalnie. Koordynator rozprowadza parametry modelu, klienci obliczają aktualizacje na własnych rekordach, a krok agregacji łączy te aktualizacje.
Utrzymywanie rekordów lokalnie jest przydatne, ale nie jest synonimem prywatności ani bezpieczeństwa. Aktualizacje modelu mogą wyciekać informacje, przejęci klienci mogą zatruwać trening, a koordynator wciąż potrzebuje uwierzytelniania, zabezpieczeń transportu, kontroli dostępu i określonego modelu zaufania.
Kluczowe wnioski
- Uczenie federacyjne przenosi obliczenia do rozproszonych danych; nie przenosi surowego zestawu danych do jednego centralnego trenera.
- Systemy cross‑device obejmują wiele przerywanych urządzeń, podczas gdy systemy cross‑silo obejmują mniejszą liczbę bardziej stabilnych organizacji.
- Bezpieczna agregacja i prywatność różnicowa rozwiązują różne ryzyka i mogą być łączone.
- Dane nie‑IID, ograniczona przepustowość, niepewna partycypacja oraz złośliwe aktualizacje są podstawowymi ograniczeniami projektowymi.
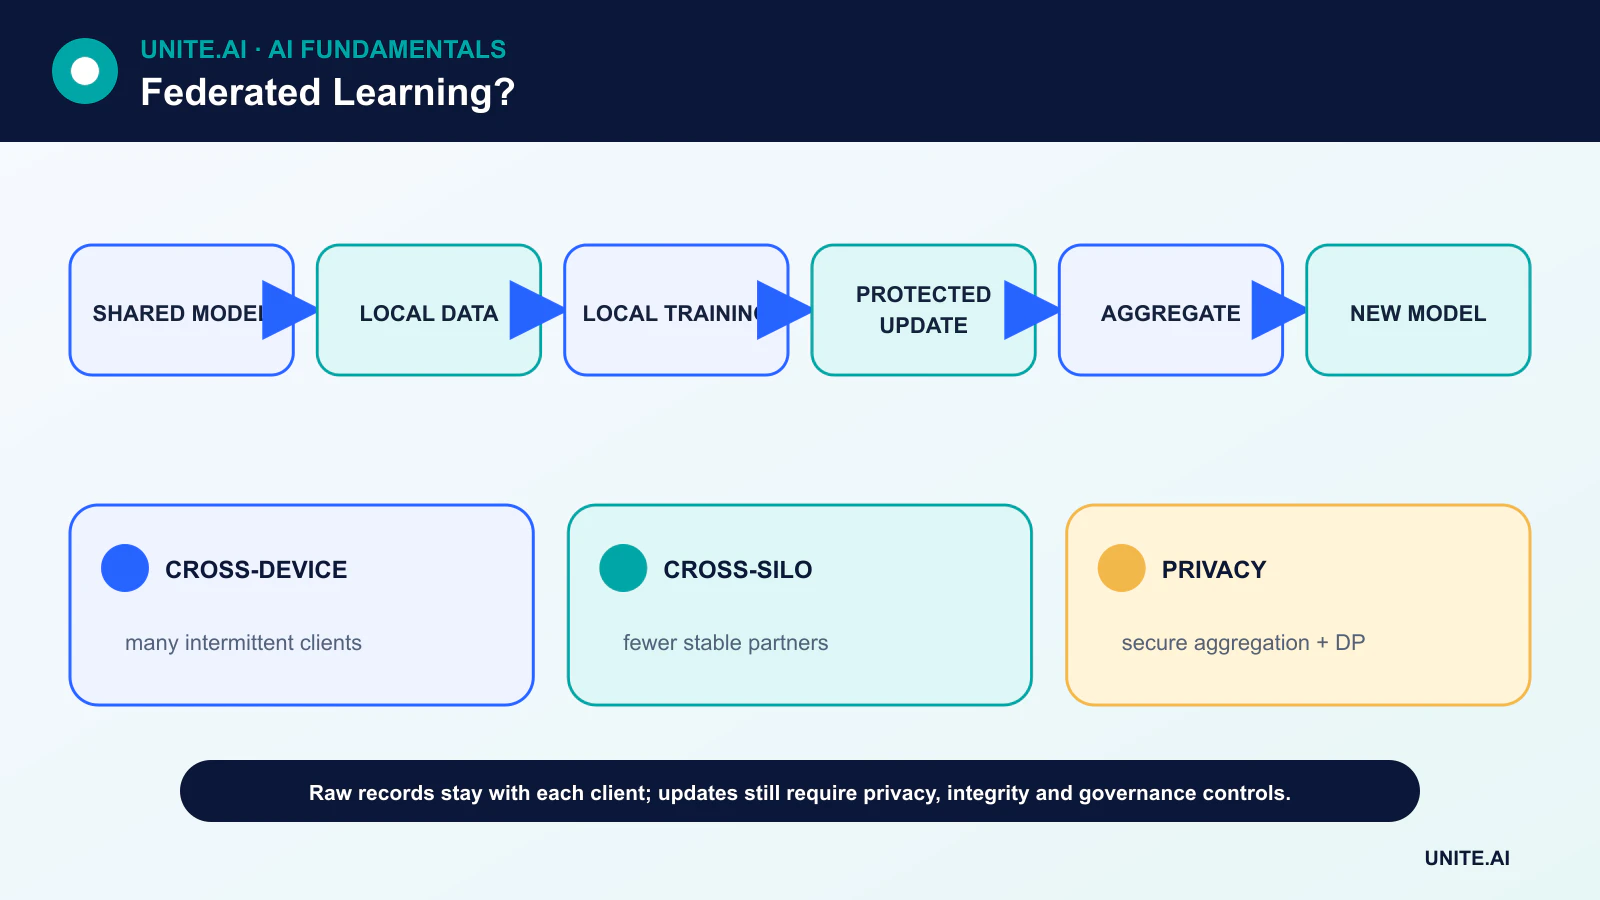
Cykl życia uśredniania federacyjnego
Typowa runda rozpoczyna się, gdy koordynator wybiera kwalifikowanych klientów i wysyła aktualny model. Każdy klient trenuje lokalnie przez ograniczoną liczbę kroków, generując aktualizację parametrów lub gradientów. Koordynator agreguje kwalifikowane aktualizacje — często z wagami opartymi na liczbie lokalnych przykładów — i publikuje nowy wspólny model.
Tylko część klientów może uczestniczyć w każdej rundzie. Protokół musi tolerować zerwane połączenia, niezgodności wersji oraz urządzenia, które nie mogą trenować podczas ładowania, są zajęte lub offline. Komunikacja może dominować nad obliczeniami, więc kompresja aktualizacji i mniejsza liczba wymian często mają większe znaczenie niż sama prędkość akceleratora.
Cross‑device kontra cross‑silo
Uczenie federacyjne cross‑device może obejmować telefony, czujniki lub przeglądarki należące do wielu osób. Klienci są liczni, słabo zaufani i dostępni przerywanie. Uczenie federacyjne cross‑silo zazwyczaj łączy mniejszy zestaw szpitali, banków lub jednostek biznesowych z stabilną infrastrukturą i umownym zarządzaniem.
Oba ustawienia wymagają innych założeń dotyczących tożsamości, audytu i awarii. Projekt cross‑silo może negocjować wspólny schemat i proces walidacji; usługa cross‑device może musieć obsługiwać miliony wersji oprogramowania i wysoce nierówne lokalne zestawy danych.
Bezpieczna agregacja, prywatność różnicowa i szyfrowanie
Bezpieczna agregacja to protokół kryptograficzny, który pozwala serwerowi odtworzyć sumę bez odczytywania aktualizacji każdego klienta. Prywatność różnicowa ogranicza, jak bardzo opublikowany wynik może zależeć od pojedynczego rekordu lub uczestnika, poprzez przycinanie wkładów i dodawanie skalowanego szumu.
Żaden z mechanizmów nie eliminuje wszystkich ryzyk. Bezpieczna agregacja nie czyni sumy nieszkodliwą, a prywatność różnicowa wprowadza kompromis dokładność‑prywatność, który musi być uwzględniony w explicite określonym budżecie prywatności. Szyfrowanie chroni dane w tranzycie lub w przechowywaniu; samo w sobie nie zapobiega wnioskowaniu z modelu.
Dane nie‑IID i jakość modelu
Dane klientów rzadko są niezależne i identycznie rozłożone. Model klawiatury widzi słownictwo każdego użytkownika; szpitale obsługują różne populacje; fabryki używają odmiennych maszyn. Te różnice mogą spowalniać zbieżność i ukrywać słabą wydajność w małych grupach klientów.
Ocena powinna obejmować globalne metryki, rozkłady per‑klient lub kohorty, kalibrację i analizę awarii. Centralny zestaw testowy może być wygodny, ale niewystarczający. Łączy to uczenie federacyjne z uczeniem maszynowym oraz zarządzaniem danymi strukturalnymi i niestrukturalnymi.
Zagrożenia i kontrole operacyjne
Złośliwi klienci mogą wysyłać zatruwane aktualizacje, klienci sybil mogą zniekształcać agregację, a przejęty serwer może rozpowszechniać celowy model. Obrona obejmuje uwierzytelnione rejestracje, wykrywanie anomalii, solidną agregację, walidację aktualizacji, limity szybkości i odtwarzalne poświadczenia oprogramowania, gdy jest to praktyczne.
Uczenie federacyjne wchodzi w szerszy program bezpieczeństwa cybernetycznego. Zespoły powinny dokumentować, kto kontroluje koordynatora, jakie metadane są zbierane, jak uczestnicy mogą odejść, jak modele są wycofywane oraz co się dzieje, gdy testy prywatności lub jakości zawodzą.
Optymalizacja federacyjna i heterogeniczność danych
Uczenie federacyjne wysyła model lub zadanie aktualizacji do uczestniczących klientów, trenuje lokalnie i agreguje aktualizacje bez centralizacji surowych przykładów. W uśrednianiu federacyjnym wybrani klienci wykonują kilka lokalnych kroków optymalizacji, a serwer oblicza średnią ważoną, najczęściej według liczby przykładów. Rundy komunikacji, lokalne epoki, selekcja i współczynniki uczenia wymieniają przepustowość na zbieżność. Ustawienia cross‑device obejmują wiele zawodnych telefonów lub czujników; ustawienia cross‑silo obejmują mniejszą liczbę organizacji z silniejszą mocą obliczeniową, tożsamością i zarządzaniem.
Dane klientów są zwykle nie‑niezależne i nierówne: użytkownicy różnią się zachowaniem, rozkładem etykiet, wolumenem i dostępnością. Lokalny trening może dryfować w niekompatybilnych kierunkach, czyniąc prostą średnią niestabilną lub stronniczą na rzecz aktywnych, wysokowolumenowych klientów. Algorytmy mogą wykorzystywać terminy proksymalne, adaptacyjną optymalizację serwera, klasteryzację, personalizację lub zmienne kontrolne. Ocena powinna raportować wydajność globalną i na poziomie klienta, klientów ogonowych, częstotliwość udziału, zbieżność, komunikację i zużycie energii. Dobra średnia może ukrywać, że małe lub rzadkie populacje klientów otrzymują gorszy model.
Prywatność, bezpieczeństwo i inżynieria systemów
Utrzymywanie danych lokalnie nie gwarantuje samej prywatności. Gradienty i aktualizacje mogą wyciekać informacje o przynależności lub cechach, a finalny model może zapamiętywać przykłady. Bezpieczna agregacja ukrywa indywidualne aktualizacje przed serwerem, a prywatność różnicowa ogranicza wkład informacyjny przez przycinanie i dodawanie szumu, ale oba zmieniają użyteczność i złożoność operacyjną. Określ model zagrożeń, jednostkę prywatności, budżet i zaufane komponenty. Szyfrowanie w tranzycie jest niezbędne, lecz nie zapobiega złośliwemu klientowi, zatruwanej aktualizacji, przejętemu koordynatorowi ani atakom wnioskowania.
Obrona obejmuje uwierzytelnionych klientów, solidną agregację, kontrole anomalii, limity aktualizacji, bezpieczne enklawy w niektórych projektach oraz walidację względem czystych danych. Atakujący typu sybil może tworzyć wiele klientów; tylne drzwi mogą przetrwać uśrednianie; odrzucanie podejrzanych aktualizacji może także wykluczyć rzadkie, prawidłowe zachowania. Wersjonuj kod klienta, obsługuj przerwane rundy, zapobiegaj powtórzeniom i projektuj pod kątem opóźnionych i ograniczeń urządzeń. Zgoda, przechowywanie, przepisy regionalne i usuwanie nadal obowiązują względem danych lokalnych i pochodnych aktualizacji.
Przykład wdrożenia i zarządzania
Klawiatura mobilna może trenować ulepszenia przewidywania kolejnych słów lokalnie, ale wdrożenie powinno korzystać z populacji kwalifikowanej pod kątem możliwości urządzenia i zgody, zbierać przycięte chronione aktualizacje i porównywać z zamrożonym modelem bazowym. Należy zweryfikować wydajność językową i dialektalną, zużycie baterii, wykorzystanie danych oraz ryzyko zapamiętywania przed wydaniem. Klienci potrzebują podpisanych zadań treningowych i aktualizacji modelu; serwer potrzebuje audytowalnej konfiguracji rund i możliwości wycofania. Uczenie federacyjne jest architekturą rozproszonego uczenia pod ograniczeniami, a nie substytutem reprezentatywnych danych, inżynierii prywatności czy rozliczalności.
Przykład praktyczny: uczenie federacyjne w szpitalach
Szpitale trenują wspólny model jakości obrazu bez łączenia skanów. Wspólny protokół definiuje metadane urządzeń, etykiety, wstępne przetwarzanie, kwalifikację klientów, lokalne epoki, przycinanie i bezpieczną agregację. Placówki zachowują dane pacjentów i przesyłają chronione aktualizacje, podczas gdy koordynator ocenia każdą rundę na lokalnych zestawach odrzuconych. Wyniki raportują wydajność na poziomie placówek i klientów ogonowych, nie tylko średnią ważoną wolumenem, ponieważ małe szpitale i typy urządzeń mogłyby w przeciwnym razie zostać pominięte.
Model zagrożeń obejmuje złośliwe aktualizacje, wyciek przynależności, przejęte klientów oraz dostęp koordynatora. Prywatność różnicowa jest skonfigurowana z udokumentowanym budżetem i testowaną użytecznością. Pakiety modelu i zadania są podpisane; placówki mogą się wycofać, a aktualizacje są audytowalne. Zatruwana lub niestabilna runda nie zastępuje automatycznie wdrożonego modelu. Projekt zachowuje lokalne bazy odniesienia i przegląd kliniczny, traktując architekturę federacyjną jako jedną z kontroli prywatności w szerszych zobowiązaniach dotyczących zgody, bezpieczeństwa i zarządzania.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanego demonstratora. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące wejścia, przesunięcia rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofywanie i wycofywanie. Stosuj stopniowe wdrażanie, zachowaj bezpieczną rezerwę i weryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki bez zbierania niepotrzebnych wrażliwych danych. Określ progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline wydajność się utrzyma. Przeglądaj ponownie, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanych procedur przywracania, nauki po incydentach, usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy uczenie federacyjne gwarantuje, że prywatne dane nie mogą wyciec?
Nie. Redukuje ono przemieszczanie surowych danych, ale aktualizacje i finalne modele nadal mogą ujawniać informacje. Prywatność wymaga modelu zagrożeń oraz dodatkowych technicznych i organizacyjnych kontroli.
Kiedy trening scentralizowany jest prostszy?
Gdy dane mogą być legalnie i bezpiecznie scentralizowane, trening scentralizowany jest często łatwiejszy w debugowaniu, odtwarzaniu i monitorowaniu. Uczenie federacyjne jest uzasadnione, gdy rozproszenie jest rzeczywistym wymogiem, a nie jedynie celem marketingowym.
Podstawowe źródła












