
Grunnleggende AI
Hva er AIOps? Kunstig intelligens for IT-drift

 Legg til Unite.AI blant dine foretrukne kilder på Google
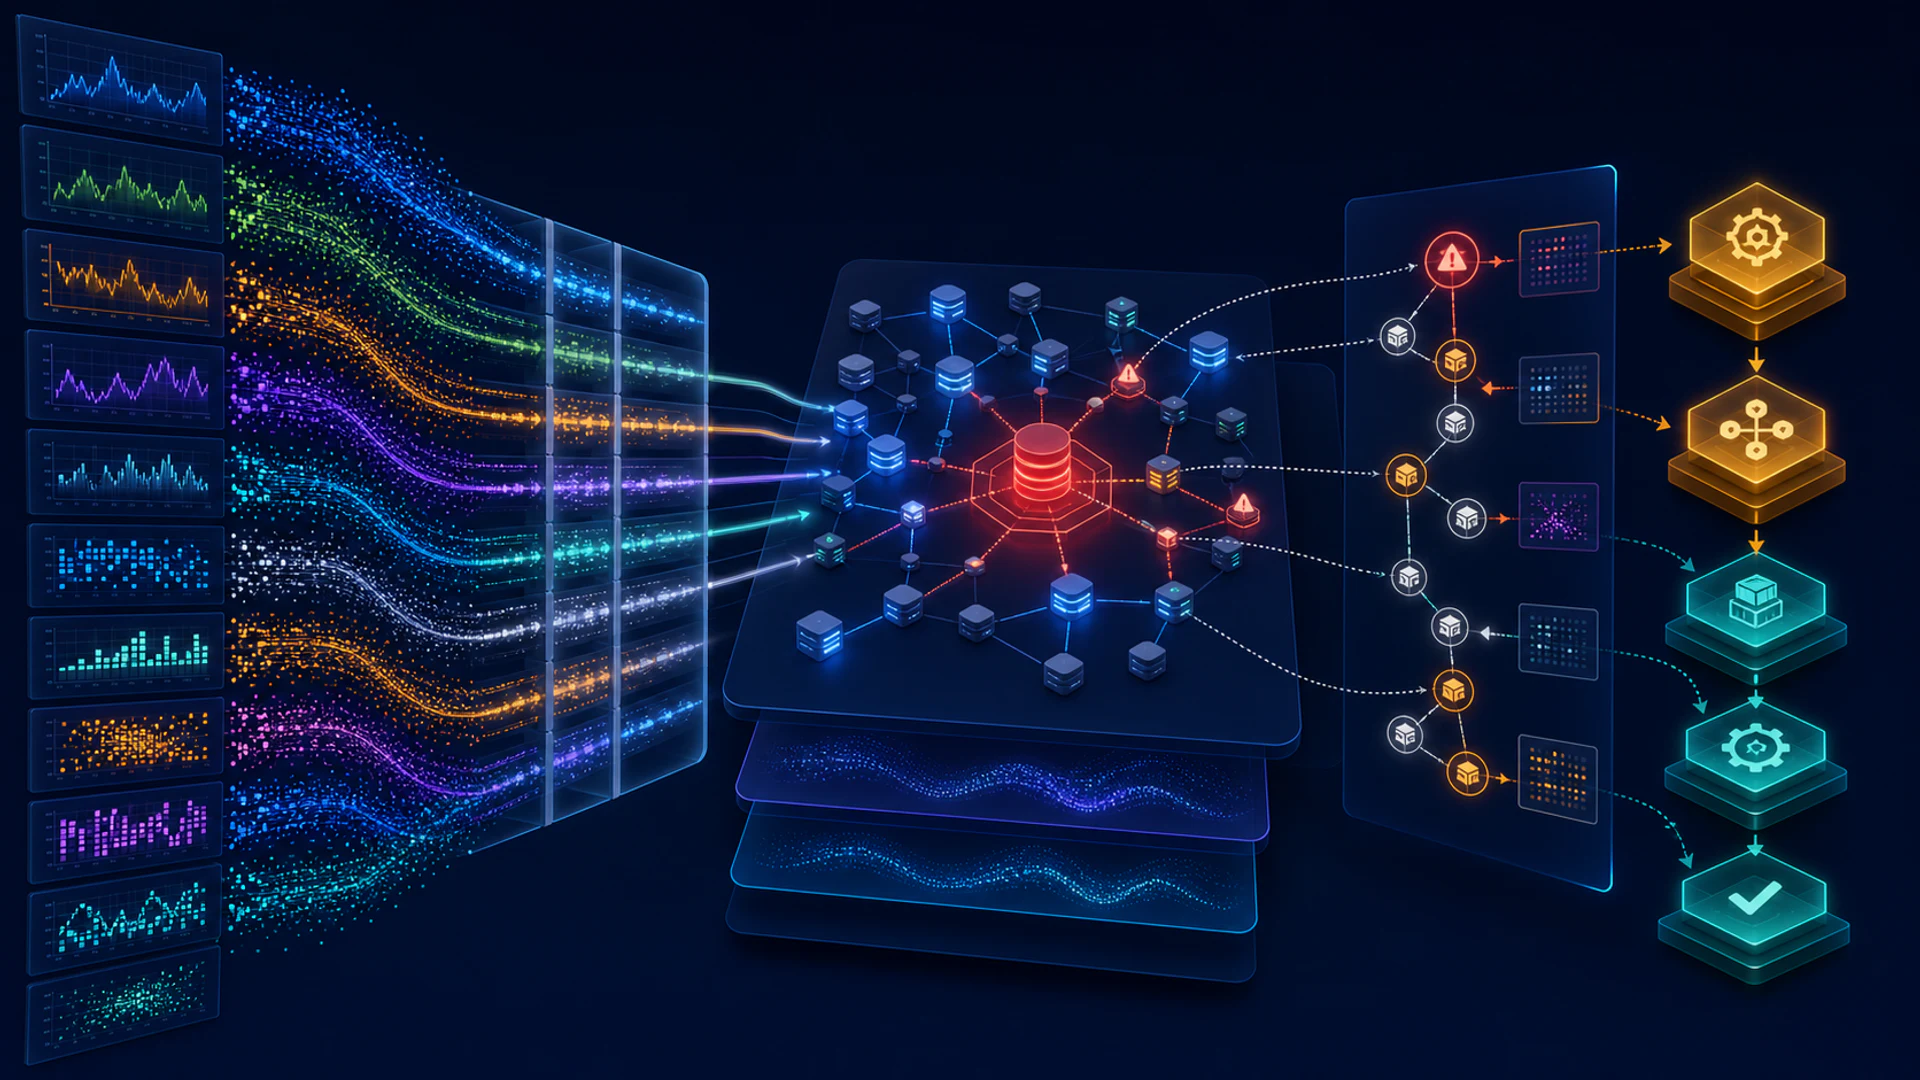
AIOps bruker maskinlæring og automatisering på IT‑driftsdata slik at team kan oppdage unormal oppførsel, redusere dupliserte varsler, koble sammen relaterte hendelser, rangere sannsynlige årsaker og anbefale eller utføre respons‑handlinger.
AIOps er ikke en autonom erstatning for drift. Det er et lag inne i et ITOps-system, og verdien avhenger av telemetrikkvalitet, tjenestetopologi, endringshistorikk, menneskelig tilbakemelding og sikre automatiseringsgrenser.
Viktige punkter
- Normaliser hendelser og legg til tjenestekontekst før du bruker avanserte modeller.
- Anomali‑deteksjon identifiserer avvik, ikke nødvendigvis feil eller rotårsaker.
- Korrelasjon og rangering av sannsynlig årsak bør vise bevis og usikkerhet.
- Automatisert utbedring krever minst mulig privilegier, godkjenninger, kanarifisering, tilbakeføring og overvåking av resultater.
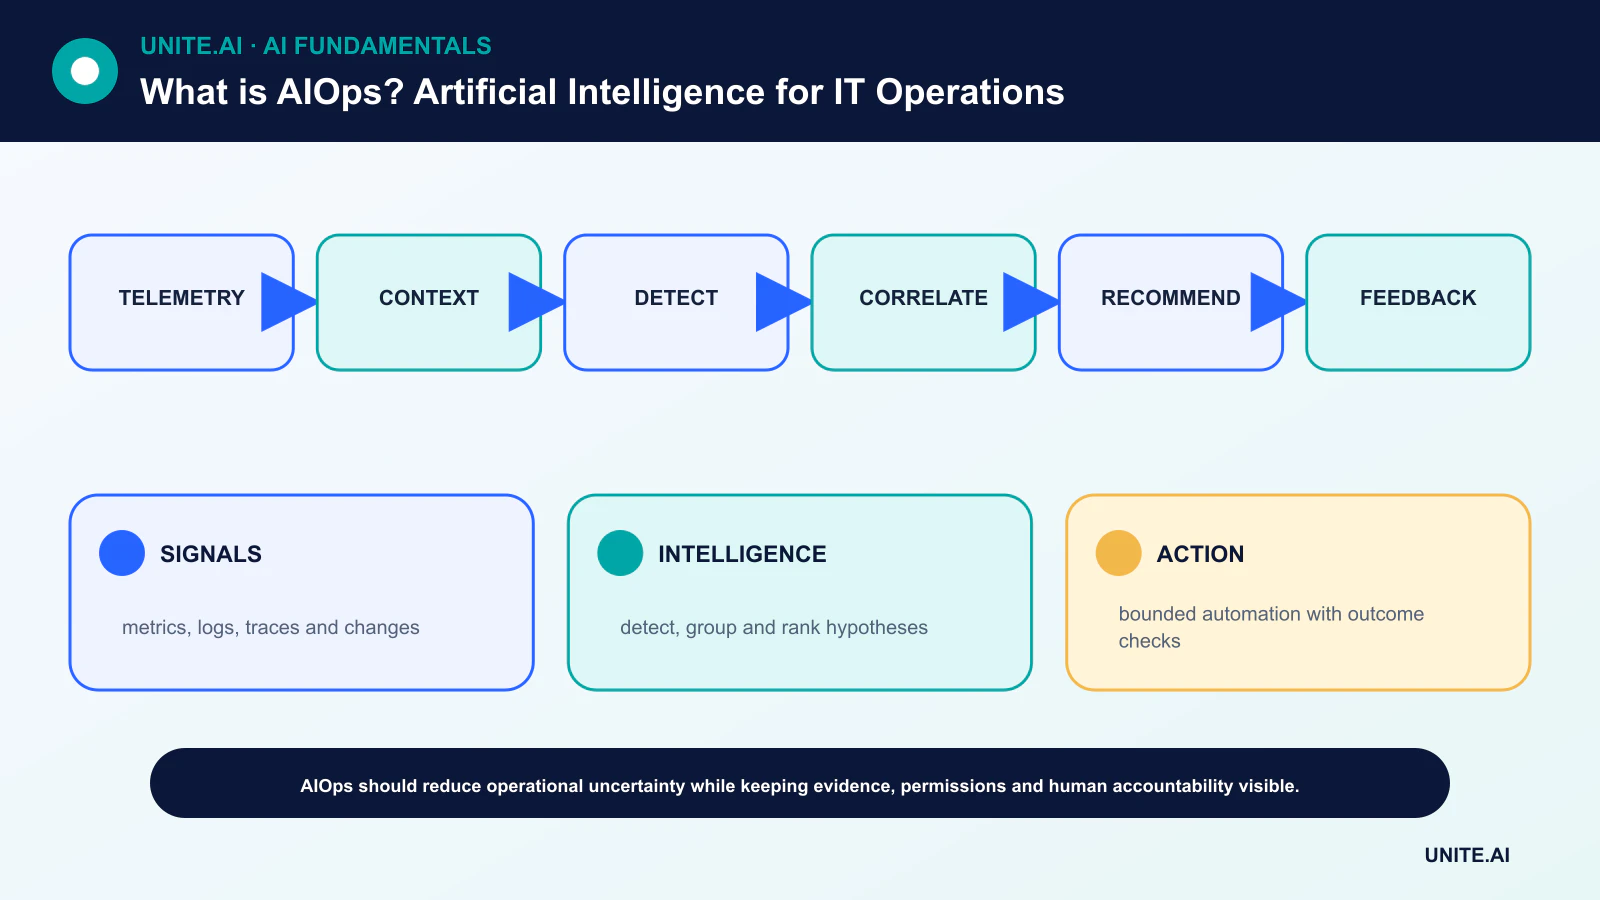
Bygg et operasjonelt datalag
AIOps‑plattformer tar inn måledata, logger, sporinger, varsler, saker, topologi, utrullinger og konfigurasjonsendringer. Tidsstempler, identifikatorer og tjenesteeiere må avstemmes slik at systemet kan koble signaler som refererer til samme hendelse.
Manglende eller inkonsekvent kontekst forårsaker falske korrelasjoner. Databevaring, tilgang og personvern er også viktig fordi logger kan inneholde påloggingsinformasjon eller personopplysninger. Bruk samme styringspraksis som forventes for andre produksjonsdatasystemer.
Deteksjon og støyreduksjon
Statisk terskler fungerer for kjente grenser; statistiske og maskin‑lærings-metoder kan modellere sesongvariasjoner eller multivariate mønstre. Deduplisering grupperer gjentatte varsler, mens undertrykkelse fjerner varsler som ikke er handlingsbare under definerte regler.
En anomali er kun et avvik fra forventet oppførsel. Planlagte utgivelser, trafikkampanjer og forretningssykluser kan være uvanlige, men sunne. Evaluer presisjon, tilbakekalling, deteksjonsforsinkelse og operatørbelastning i stedet for å feire antallet fjernede varsler.
Korrelasjon og sannsynlig årsak
Hendelseskorrelasjon knytter symptomer på tvers av en avhengighetsgraf og tidsvindu. En sannsynlig‑årsaks‑modell kan rangere komponenter eller nylige endringer som kan forklare hendelsen. Dette prioriterer etterforskning; det fastslår ikke årsakssammenheng.
Vis bidragende bevis, alternative hypoteser og sikkerhetsnivå. Forklarbar AI er spesielt viktig når en operatør må avgjøre om en tjeneste skal isoleres eller en utrulling skal rulles tilbake.
Fra anbefaling til automatisering
En runbook kan samle diagnostikk, starte en tilstandsløs arbeider på nytt eller skalere kapasitet. Kopiloter kan oppsummere hendelser og hente prosedyrer. Agenter kan planlegge verktøy‑kall, men produksjonstillatelser bør være smale og handlinger bør valideres mot gjeldende tilstand.
Start med kun‑lese‑anbefalinger. Fremhev modne handlinger gjennom simulering, menneskelig godkjenning, kanarifisering og automatisk tilbakeføring. Registrer inndata, modellversjon, autorisasjon og resultat for hver handling.
Evaluering og operasjonell tilbakemelding
Spill av historiske hendelser uten å lekke deres endelige merkelapper inn i funksjonene. Test på nye tjenester og endringer, mål falsk undertrykkelse, tid til å oppdage, tid til å dempe, operatøraksept og gjentakelse. Sammenlign med eksisterende regler og enkle referansepunkter.
Drift oppstår når arkitektur, trafikk eller responspraksis endres. Lukk sløyfen ved å la operatører korrigere korrelasjoner og resultater, og deretter vurdere om systemet reduserer slitsomhet uten å skjule risiko eller skape automatiseringsselvtilfredshet.
AIOps-data- og analysepipeline
AIOps bruker statistiske og maskin‑læringsmetoder på driftsdata som måledata, logger, sporinger, hendelser, topologi, saker og endringer. Pipelines samler inn og normaliserer signaler, beriker dem med tjeneste‑ og eierskapskontekst, oppdager anomalier, korrelerer relaterte hendelser, estimerer sannsynlige årsaker, og anbefaler eller utløser handling. Kvaliteten avhenger av tidsstempler, identifikatorer, topologi og endringslogg. En sofistikert modell kan ikke pålitelig korrelere varsler som refererer til samme tjeneste under inkonsistente navn.
Anomali‑deteksjon lærer baselines per tjeneste, sesong og driftsstatus; statiske terskler kan være bedre for kjente sikkerhetsgrenser. Hendelseskorrelasjon grupperer symptomer til en hendelse ved hjelp av tid, topologi, tekst og historiske mønstre. Rotårsaks‑rangering foreslår hypoteser, men kan forveksle den første observerte feilen med den egentlige årsaken eller gå glipp av en delt avhengighet som mangler i topologien. Sammendrag på naturlig språk kan hjelpe responderere, men må lenke til råbevis og angi usikkerhet.
Automatisering, evaluering og tilbakemelding
Start med beslutningsstøtte og lav‑risiko reversibel utbedring. Hver automatisert handling krever autorisasjon, forhåndsbetingelser, avgrenset omfang, tidsavbrudd, verifisering av etterbetingelse, tilbakeføring og revisjonsspor. Modellen må ikke gi seg selv legitimasjon eller behandle loggtekst som pålitelige instruksjoner. Menneskelige responderere bør akseptere, avvise eller korrigere anbefalinger, og disse resultatene bør oppdatere regler eller treningsdata gjennom gjennomgang i stedet for ukontrollert selv‑læring.
Evaluer varselsreduksjon uten å gå glipp av hendelser, deteksjonsforsinkelse, korrelasjonspresisjon, rotårsaks‑rangering, utbedringssuksess, gjenopprettingstid, gjentakelse og responderbelastning. Bruk historisk avspilling og injiserte feil, men ta hensyn til ufullstendige hendelsesmerkelapper. Mål per tjeneste og hendelsestype; et gjennomsnitt kan skjule farlige feil i sjeldne kritiske systemer. Sammenlign med deterministiske regler og forbedret observabilitet før du legger til AI‑kompleksitet.
Styring og feilmoduser
AIOps kan forsterke telemetrikkhull, automatisere en feil diagnose eller skape korrelerte handlinger på tvers av hele flåten. Isoler miljøer, begrens samtidighet, oppretthold en nødstopp utenfor modellen, og øv på feil i AIOps‑plattformen selv. Beskytt logger og saker som inneholder hemmeligheter eller personopplysninger. Overvåk modell‑drift, topologifrishet, falske handlinger og overstyringer. AIOps støtter pålitelig drift når det gjør bevis og avgrenset handling raskere; det er ikke en autonom erstatning for tjenesteeierskap, hendelsesledelse eller ingeniørvurdering.
Arbeidseksempel: AIOps for en betalingshendelse
AIOps grupperer en bølge av API‑feil, database‑metning og regionale varsler til én hendelse og beriker den med en nylig utrulling, topologi og eier. Den rangerer utrullingen som en sannsynlig bidragsyter, men viser rå‑telemetri og alternativer. En deterministisk policy stopper videre utrulling; en menneskelig hendelsesleder godkjenner trafikkforskyvning etter å ha sjekket at kapasitet og datakonsistens er trygge.
Systemet måler grupperingens presisjon, deteksjonsforsinkelse, rangeringsnøyaktighet, responderaksept, gjenoppretting og falsk utbedring i historisk avspilling og spill‑dager. Alle automatiserte handlinger har grenser, idempotens, etterbetingelseskontroller og tilbakeføring. Logger blir renset og ondsinnet tekst kan ikke bli en kommando. Etter hendelsen oppdaterer bekreftet årsak og handlingsresultater gjennomgåtte regler og evalueringsdata. AIOps‑plattformen bistår med bevis og koordinering; den erstatter aldri hendelsesledelse eller ekstern autorisasjon.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende inndata, distribusjonsforskyvning, avhengighetsnedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig er underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker tilbakefallsplan, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avsløre inndatakvalitet, utdataatferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslingsgrenser og en responsansvarlig, og gjennomgå bevis fra virkeligheten etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, samt et klart tidspunkt for når det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er AIOps det samme som observabilitet?
Nei. Observabilitet leverer og utforsker systemsignalene; AIOps bruker analyse og automatisering på disse signalene. Hver kan eksistere uten den andre.
Kan AIOps bestemme rotårsak automatisk?
Den kan rangere hypoteser og samle bevis, men kausale påstander krever topologi, endringskontekst og validering. Mange hendelser har samvirkende årsaker.
Primære referanser












