
Grunnleggende AI
Hva er Asset Performance Management (APM)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Asset performance management (APM) kombinerer asset‑strategi, vedlikehold, tilstandsovervåking, pålitelighetsanalyse og driftsdata for å forbedre verdien som leveres av fysiske eiendeler. Det brukes vanligvis på utstyr som turbiner, pumper, kjøretøy, produksjonslinjer og infrastruktur.
APM er ikke et sensor‑dashbord eller en prediktiv‑vedlikeholdsmodell i seg selv. Det er en beslutningsprosess som balanserer ytelse, kostnad, risiko, sikkerhet og bærekraft gjennom eiendelens livssyklus, med tydelig eierskap for inspeksjoner, arbeid, reservedeler og kapitalplanlegging.
Nøkkelpunkter
- Start med kritikalitet og konsekvenser av feil, ikke med den enkleste sensoren å samle inn.
- Kombiner tilstandsdaten med vedlikeholdshistorikk, driftskontekst og ingeniørkunnskap.
- Bruk prediktive signaler for å støtte en definert arbeidsbeslutning og ledetidskrav.
- Mål unngått risiko, tilgjengelighet, vedlikeholdskvalitet, livssykluskostnad og falske alarmer.
Fra asset‑strategi til arbeid
Organisasjoner definerer mål, asset‑hierarkier, kritikalitet, ytelsesstandarder, feilmoduser og vedlikeholdsstrategier. Et arbeidsstyringssystem planlegger inspeksjoner og reparasjoner; APM‑analyse hjelper med å prioritere når og hvorfor arbeid skal utføres.
Den samme tilstanden kan innebære ulik handling for en redundante, lavkost‑pumpe og en sikkerhetskritisk turbin. APM knytter teknisk bevis til forretnings‑ og sikkerhetskontekst i stedet for å optimalisere kun én prediksjons‑score.
Data og digitale representasjoner
Nyttige kilder inkluderer sensors tidsserier, alarmer, operatørrunder, vedlikeholdsnotater, deler, miljø, belastninger og designgrenser. Asset‑identifikatorer og tidsstempler må stemme overens før analyse. Manglende, driftende eller utskiftede sensorer kan skape falske trender.
A digital tvilling may combine engineering models and live state, but it needs validated assumptions and update rules. Ustrukturert technician notes can add context that telemetry lacks.
Tilstand, prediksjon og beslutning
Terskler oppdager kjente grenser; anomalimodeller flagger avvik; diagnostiske modeller estimerer årsaker; prognostiske modeller estimerer gjenværende nyttige levetid. Hver krever et tidshorisont og usikkerhet som passer til vedlikeholdsbeslutningen.
En modell som forutsier feil fem minutter før den inntreffer kan være nøyaktig, men operasjonelt ubrukelig dersom deler krever en uke. Maskinlæring bør sammenlignes med regler og pålitelighetsmetoder og testes på tvers av driftsregimer.
Implementering og måling
Start med en kritisk eiendelsklasse, en troverdig feilmodus, tilgjengelig ledetid og en eier som kan handle. Integrer anbefalinger i planlegging, arbeidsordrer og lager; samle resultatet slik at regelen eller modellen kan gjennomgås.
Følg med på tilgjengelighet, uplanlagt nedetid, vedlikeholdskostnader, planoverholdelse, falske alarmer, tapte hendelser, sikkerhetseksponering og livssyklusen verdi. Unngå å påstå unngåtte feil uten en kontrafaktisk metode og dokumenterte antakelser.
Asset‑hierarki, feiladferd og kritikalitet
Et APM‑program starter med et asset‑hierarki som kobler sammen lokasjoner, systemer, utstyr, samlinger og vedlikeholdbare komponenter. Hvert nivå trenger konsistente identifikatorer, eierskap, plassering, spesifikasjoner og relasjoner. Uten dette grunnlaget kan sensorstrømmer, arbeidsordrer, inspeksjonsfunn og kostnadsregistre ikke pålitelig beskrive den samme fysiske eiendelen.
Feilmoduser forklarer hvordan en eiendel kan slutte å oppfylle sin påkrevde funksjon, hvorfor feilen oppstår, hvilket bevis som dukker opp først, og hvilken konsekvens som følger. Failure mode and effects analysis, reliability‑centered maintenance og root‑cause analysis gjør vedlikehold fra en kalenderaktivitet til en risikobasert disiplin. Analysen bør skille symptomer fra årsaksmekanismer.
Kritikalitet kombinerer sannsynlighet med konsekvenser for sikkerhet, miljø, produksjon, kvalitet, overholdelse og kostnad. En redundant pumpe som betjener en ikke‑essensiell krets bør ikke få samme overvåkingsbudsjett som en kompressor med enkelt‑punkt‑av‑feil. Kritikalitet endres med driftskontekst, så team bør revurdere rangeringer etter prosess‑, asset‑ eller etterspørselsendringer.
Tilstandsovervåking, prediksjon og vedlikeholdsbeslutninger
Tilstandsovervåking kan bruke vibrasjon, temperatur, trykk, strøm, akustisk emisjon, smøremiddelanalyse, visuell inspeksjon og operatørobservasjoner. Prøvetakingsfrekvensen må tilsvare fysikken i feilen. Høyfrekvent ledesvibrasjon og sakte driftskorrosjon krever ulike sensorer, lagring, funksjoner og alarmlogikk. Kalibrering og installasjonskvalitet er en del av datakvaliteten.
Prediktive modeller kan oppdage anomalier, klassifisere kjente feil, estimere helsetilstander eller forutsi gjenværende nyttige levetid. Et statistisk uvanlig signal er ikke automatisk en handlingsbar feil. Modeller trenger kontekst for driftsstatus, usikkerhet, ledetidsvurdering og validering på tvers av utstyr, sesonger, belastninger og vedlikeholdshendelser. Falske alarmer tærer på tillit og arbeidskraft; tapte deteksjoner kan skape alvorlige tap.
Resultatet fra analysene må kobles til en beslutning: inspisere, smøre, derate, planlegge arbeid, bestille en del eller stenge ned. Beslutningsterskler bør reflektere feilkonsekvens, intervensjonsledetid, arbeidskapasitet, reservedeler og produksjonsvinduer. Den økonomisk optimale terskelen er sjelden den som maksimerer en generisk modellmåling.
APM‑integrasjon, verdimåling og styring
APM knytter operasjonell teknologi til bedriftsystemer som datastyrt vedlikeholdsstyring, enterprise asset management, historikere, lager og planlegging. Integrasjon bør bevare tidsstempler, enheter, asset‑identitet, arbeidsstatus og opprinnelse. Nettverkssegmentering og kontrollerte porter er essensielle fordi diagnostisk bekvemmelighet ikke må skape en vei inn i sikkerhetskritiske kontrollsystemer.
Mål verdi gjennom unngått nedetid, redusert nødstopp‑arbeid, vedlikeholdskostnader, reservedels‑tilgjengelighet, energieffektivitet, avkastning, sikkerhetseksponering og eiendelens levetid. Unngåtte feil er kontrafaktiske, så bruk troverdige referanseverdier, sammenlignbare eiendeler, dokumenterte antakelser og følsomhetsintervaller. En pilot som finner mange anomalier men ikke endrer vedlikeholdsbeslutninger har ikke demonstrert forretningsverdi.
Styring tildeler eiere for sensorer, modeller, alarmregler, feilbiblioteker og arbeidsprosesser. Gjennomgå alarmer etter hver intervensjon, registrer om diagnosen var korrekt, og føt bekreftede resultater tilbake til regler og modeller. Operatører og vedlikeholdere trenger en måte å utfordre anbefalinger på; lokal kunnskap er bevis, ikke motstand mot automatisering.
Arbeidseksempel: beskytte en kritisk roterende eiendel
For en produksjonskompressor kartlegger teamet komponenter og feilmoduser, rangerer tap i produksjon og sikkerhetskonsekvenser, og kobler historikertagger, vibrasjonssensorer, smøremiddelsprøver, inspeksjoner og arbeidsordrer til én asset‑identitet. Basisdata må dekke oppstart, jevn belastning, nedtrapping og sesongforhold. Ellers kan modellen flagge normale driftsoverganger som feil eller gå glipp av degradering som kun er synlig ved en bestemt belastning.
Et analysetrinn oppdager endringer i vibrasjonsspekteret og ledes temperatur, estimerer usikkerhet, og viser bevisene ved siden av sammenlignbare historiske hendelser. En vedvarende alarm genererer en inspeksjonsforespørsel i stedet for automatisk nedstenging. Vedlikeholderen registrerer funn, handling, erstattet del og bekreftet årsak. Disse resultatene bestemmer om terskelen, feilmodellen eller sensorinstallasjonen skal endres.
Evaluer varslingens ledetid, bekreftet deteksjonsrate, falsk alarm‑belastning, unngått nedetid, nødstopp‑arbeid, reservedelsberedskap og vedlikeholdskostnad i forhold til en dokumentert basisverdi. Inkluder kostnaden for sensorer, integrasjon, analyse og endrede arbeidsprosesser. En cybersikkerhetsgjennomgang isolerer overvåkning fra kontroll, og styring tildeler eiere for data og modeller. Målet er en tryggere, økonomisk vedlikeholdsbeslutning, ikke den størst mulige samlingen av asset‑telemetri.
Praktisk implementeringssjekkliste
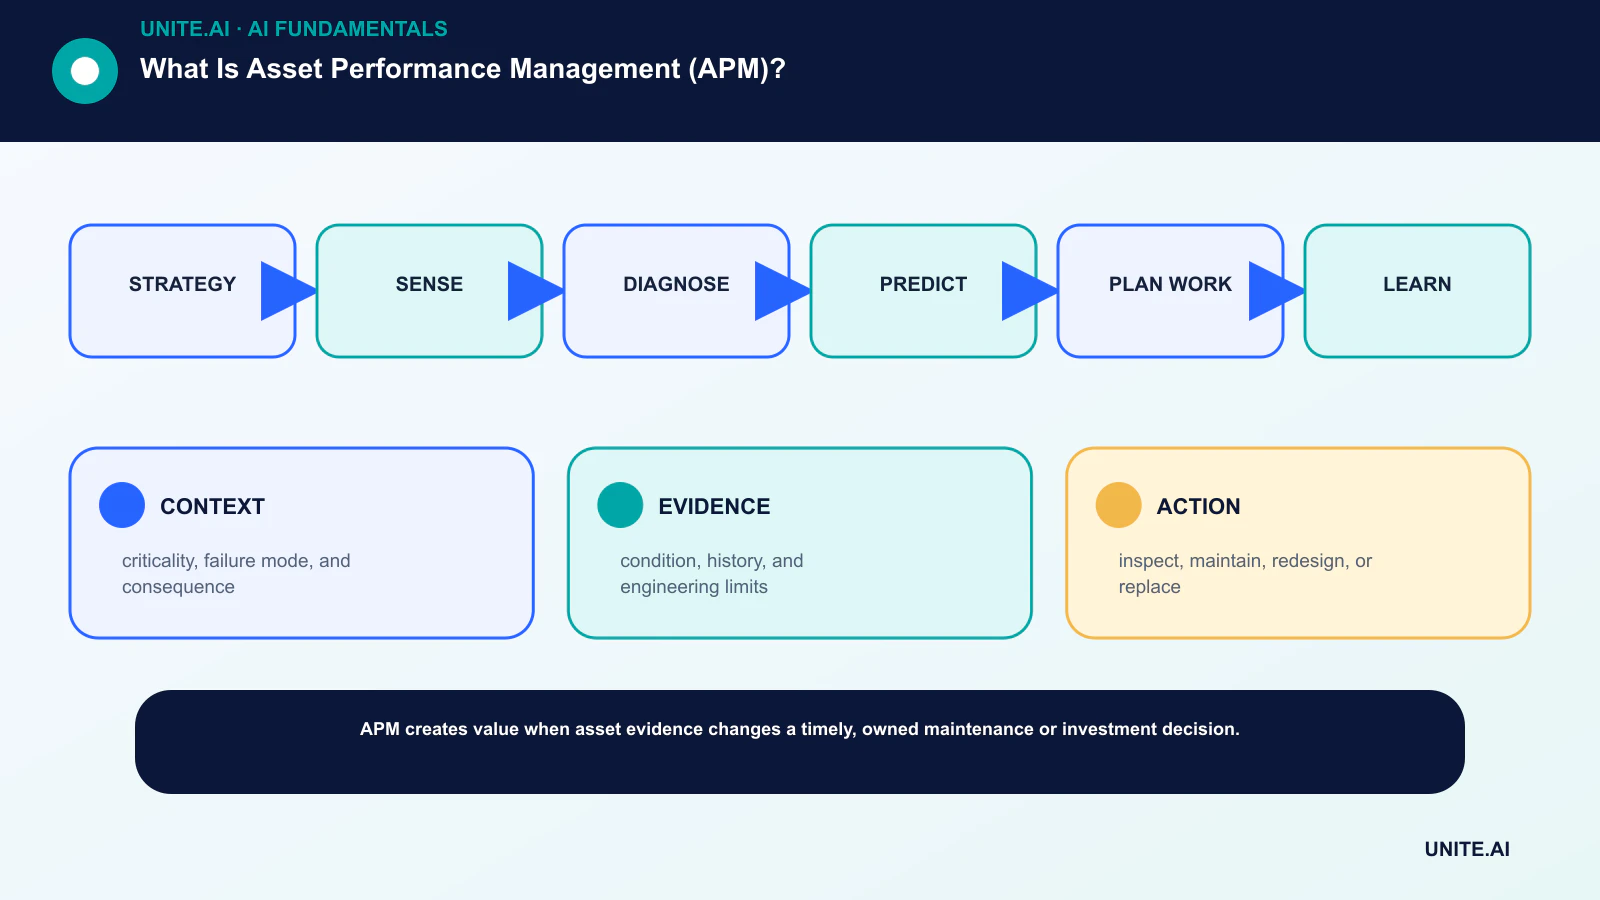
Gjør konseptet til en avgrenset, testbar arbeidsflyt: strategi → sanse → diagnostisere → forutsi → planlegge arbeid → lære. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basisverdi, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåkning, tilbakeføring og gjennomgang før omfanget utvides. Registrer versjoner og antakelser slik at et annet team kan reprodusere resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevisene og uløste risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre et resultat eller stoppe driften. Revurder beslutningen etter at virkelige data kommer, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- CONTEXT: kritikalitet, feilmodus og konsekvens.
- EVIDENCE: tilstand, historikk og ingeniørgrenser.
- ACTION: inspeksjon, vedlikehold, redesign eller utskifting.
Ofte stilte spørsmål
Hvordan er APM forskjellig fra et CMMS?
Et CMMS håndterer primært vedlikeholdsarbeid, tidsplaner og registre. APM legger til asset‑strategi, pålitelighets‑ og tilstandsanalyse, prioritering og ytelsesbeslutninger; systemene integreres ofte.
Er prediktivt vedlikehold påkrevd for APM?
Nei. Forebyggende, tilstandsbasert, run‑to‑failure, redesign‑ og utskiftningsstrategier kan alle være aktuelle. Prediksjon er ett verktøy innen en asset‑strategi.
Primære referanser












