
Grunnleggende AI
Hva er IT-drift (ITOps)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
IT-drift (ITOps) er arbeidet med å drive teknologitjenestene en organisasjon er avhengig av. Det omfatter beregning, nettverk, identitet, endepunkter, skyplattformer, databaser, lagring, sikkerhetskopier og de operative prosessene som holder disse komponentene tilgjengelige, sikre og støttbare.
Moderne ITOps er ikke begrenset til et nettverksoperasjons‑senter som overvåker dashbord. Team håndterer i økende grad programvaredefinert infrastruktur, plattformtjenester, automatisering og distribuert eierskap, samtidig som de beholder ansvar for hendelser, kapasitet, kontinuitet og tjenestenivåer.
Viktige punkter
- ITOps styrer tjenester og deres avhengigheter på tvers av lokale, sky‑ og kantmiljøer.
- Observabilitet, konfigurasjon og inventar gir konteksten som trengs for å tolke feil.
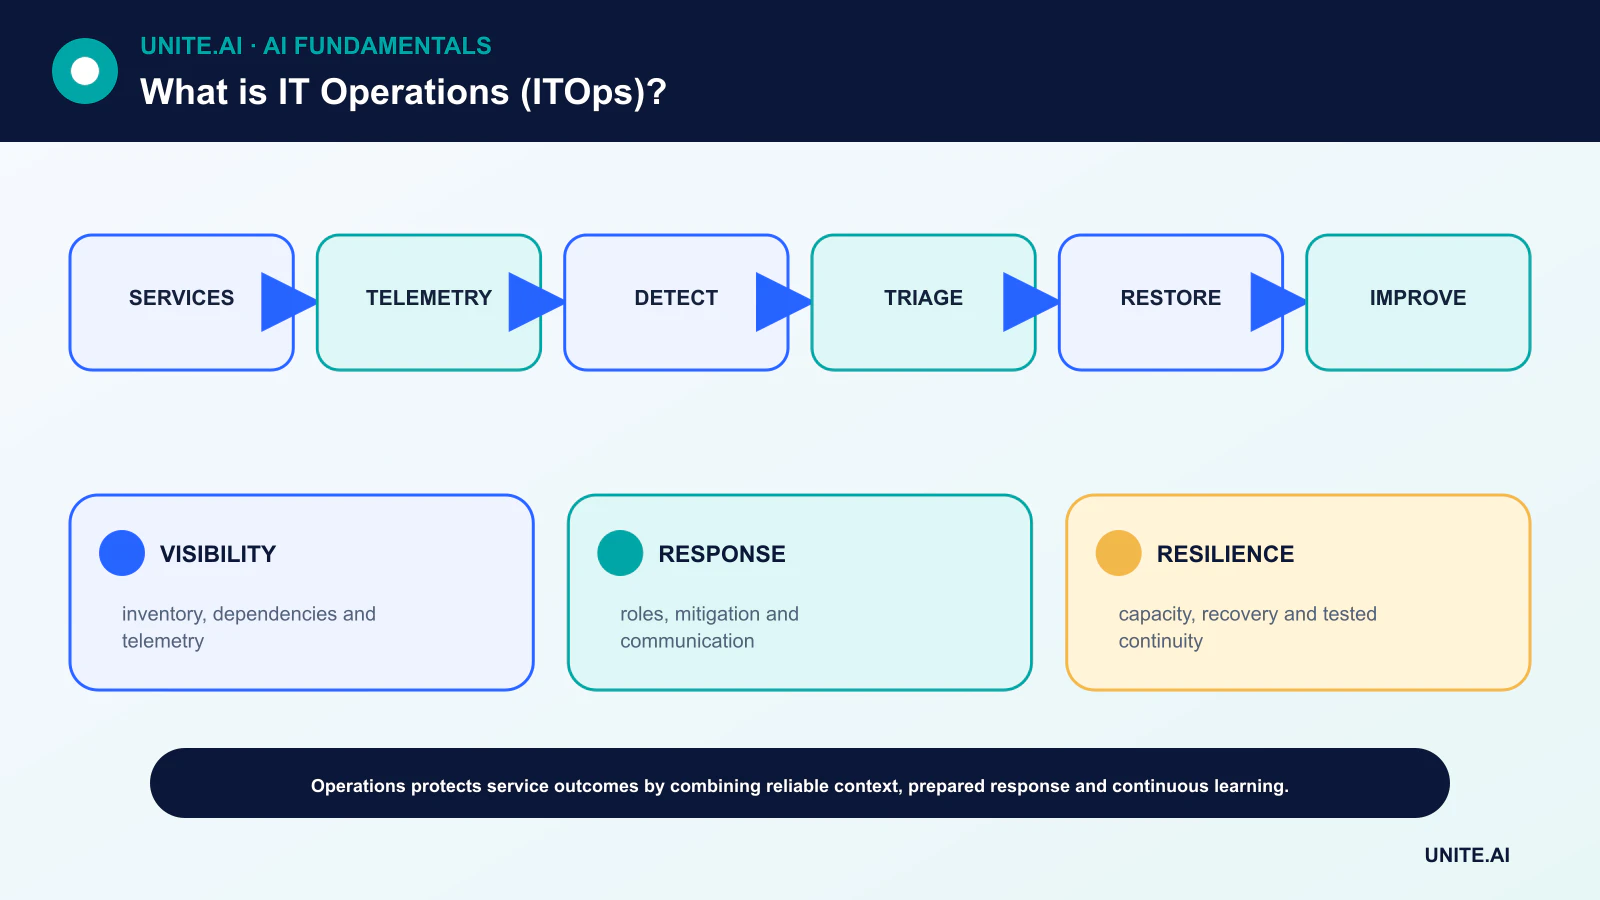
- Hendelsesstyring gjenoppretter tjenesten; problemstyring håndterer tilbakevendende eller systemiske årsaker.
- ITOps overlapper med ITSM, SRE, DevOps, SecOps og AIOps, men er ikke identisk med noen av dem.
Tjenester, eiendeler og konfigurasjon
Drift begynner med å vite hvilke tjenester som finnes, hvem som eier dem, hvilke brukere som er avhengige av dem, og hvilken infrastruktur som støtter dem. Eiendelsinventar registrerer komponenter; konfigurasjonsstyring registrerer relevante relasjoner og kontrollert tilstand.
Et inventar som aldri blir avstemt blir misvisende. Automatiser oppdagelse der det er nyttig, identifiser autoritative kilder og registrer tillit eller ferskhet i stedet for å late som om hvert avhengighetskart er komplett.
Observabilitet og tjenestemål
Måleverdier kvantifiserer oppførsel, logger registrerer hendelser og spor følger arbeid på tvers av tjenester. Syntetiske tester kan teste en brukerreise. Nyttig observabilitet starter med spørsmål og tjenestemål, og samler deretter signalene som trengs for å besvare dem.
Varsling bør identifisere forhold som krever rask handling. Terskler uten brukerpåvirkning skaper støy, mens manglende avhengighetskontekst bremser diagnostisering. AIOps kan bistå med korrelasjon, men den trenger pålitelig telemetri og operativ tilbakemelding.
Hendelses-, problem- og endringsstyring
Hendelsesstyring koordinerer oppdagelse, triage, avbøting, kommunikasjon og gjenoppretting. Klare roller reduserer forvirring under press. En midlertidig løsning kan gjenopprette tjenesten mens en senere problemundersøkelse adresserer dypere årsaker.
Endringsstyring vurderer og registrerer risiko uten å gjøre hver endring til en kø. Standardiserte, automatiserte og lavrisikoendringer kan følge forhåndsgodkjente veier; endringer med høy påvirkning krever sterkere bevis, planlegging og forberedelse for tilbakeføring.
Kapasitet, robusthet og kontinuitet
Teamene forutsier ressursbehov, fjerner flaskehalser og tester oppførsel under belastning. Sikkerhetskopier er kun nyttige når gjenoppretting er testet. Redundans hjelper kun når feilmoduser er uavhengige og failover faktisk fungerer.
Forretningskontinuitet definerer prioriteringer, gjenopprettingstid og akseptabelt datatap. Avhengigheter til identitet, DNS, skyens kontrollplaner og leverandører bør inkluderes i øvelser i stedet for å bli antatt tilgjengelige.
ITOps, ITSM, SRE og DevOps
IT-tjenestestyring (ITSM) gir prosesser for å tilpasse tjenester til organisasjonens behov. Site Reliability Engineering (SRE) anvender programvareutvikling på drift og bruker tjenestenivåmål og feilbudsjetter. DevOps forener utvikling og drifts‑tilbakemeldinger.
SecOps fokuserer på trusler og respons, mens ITOps opprettholder bredere tjenestehelse. Organisasjonskartene varierer; det viktigste kravet er tydelig eierskap og delt bevisføring på tvers av disse disiplinene.
ITOps‑driftsmodellen
IT-drift holder organisasjonens teknologitjenester tilgjengelige, ytelsessterke, sikre og gjenopprettbare. Omfanget inkluderer vanligvis endepunkter, identitet, nettverk, servere, sky, lagring, samarbeid, databaser, overvåking, servicedesk, sikkerhetskopiering og leverandørtjenester. Moderne ITOps spenner over egen infrastruktur og administrerte plattformer, så ansvaret må være eksplisitt selv når driften er outsourcet. Et konfigurasjons‑ eller tjenesteinventar knytter tekniske komponenter til eiere, brukere, avhengigheter, dataklassifisering og forretningskritikalitet.
Tjenestestyring organiserer hendelser, forespørsler, problemer, endringer, eiendeler, kunnskap og tjenestenivåer. Hendelsesstyring gjenoppretter tjenesten; problemstyring undersøker tilbakevendende årsaker; endringsmuliggjøring vurderer og koordinerer risiko. Å behandle hver endring som en langsom godkjenning skaper omveier, mens ustyrt automatisering skaper ukontrollerte feil. Standard lavrisikoendringer kan forhåndsgodkjennes og automatiseres; høy‑risikoendringer krever bevis, kommunikasjon, tilbakeføring og planlegging basert på påvirkning.
Pålitelighet, kapasitet og kontinuitet
Overvåking bør følge brukerrettede tjenester og avhengigheter, ikke kun antall enheter. Definer tilgjengelighet, latency, kapasitet, ferskhet og støtte‑mål sammen med forretningsansvarlige. Varsle om handlingsbare symptomer og forbruk av feilbudsjett; berik hendelser med eierskap og nylige endringer. Kapasitetsplanleggingsmodeller omfatter etterspørsel, metning, lisenser og ledetid. Sky‑elasticitet reduserer provisjoneringstid, men eliminerer ikke kvoter, regionale begrensninger eller kostnadskontroll.
Forretningskontinuitet krever testede sikkerhetskopier, gjenoppretting, identitetsgjenoppretting, nettverksalternativer, leverandørkontakter og manuelle prosedyrer. Definer gjenopprettingstid‑ og gjenopprettings‑punkt‑mål per tjeneste. En sikkerhetskopi er ikke bevis på gjenoppretting før den er gjenopprettet og validert. Øv på løsepengevirus, regionstap, utløpte sertifikater, identitetsavbrudd og leverandørsvikt. Spor konfigurasjon og infrastruktur som kode der det er mulig, slik at gjenoppretting er reproduserbar.
Sikkerhet, automatisering og målinger
Bruk minst privilegium, oppdaterings‑ og sårbarhetsstyring, endepunktskontroller, nettverkssegmentering, logging og hendelsesrespons. Automatiser repeterende arbeid med idempotens, grenser, godkjenninger og revisjon. Mål tjenestetilgjengelighet, hendelsesgjentakelse, forespørselsoppfyllelse, endringsfeil, gjenoppretting, oppdaterings‑eksponering, kapasitet, kostnad og brukertilfredshet – ikke kun lukking av saker. ITOps er vellykket når teknologi støtter arbeidet forutsigbart og kan gjenopprette fra feil, ikke når infrastrukturen ser travel ut eller dashbordene viser flere grønne indikatorer.
Arbeidseksempel: gjenoppretting av en samarbeidstjeneste
Et selskap definerer et gjenopprettingstid‑mål på fire timer og et gjenopprettings‑punkt‑mål på én time for en samarbeidsplattform. Det lager inventar over identitet, DNS, nettverk, data, nøkler, konfigurasjon, integrasjoner og leverandøravhengigheter. En gjenopprettingsøvelse forutsetter at den primære regionen og administratorkontoen er utilgjengelige. Operatører aktiverer en uavhengig beskyttet nødidentitet, gjenoppretter tjenestekonfigurasjon og data i en isolert region, og validerer tillatelser, meldinger, integrasjoner og klienttilgang. Forretningsansvarlige verifiserer den gjenopprettede tjenesten med realistiske brukerreiser i stedet for kun å stole på infrastruktur‑helsekontroller.
Øvelsen registrerer faktisk datatap, forløpt tid, manuelle trinn, mislykkede kontakter og skjulte avhengigheter. En sikkerhetskopi som gjenoppretter filer, men ikke krypteringsnøkler eller identitetspolicy, merkes som ufullstendig. Korrigerende tiltak får eiere og datoer, og driftsboken oppdateres og testes på nytt. Overvåknings‑ og kommunikasjonsmaler inkluderes. Organisasjonen måler gjenopprettingsbevis i stedet for suksess for sikkerhetskopijobben, og erkjenner at pålitelig ITOps må gjenopprette tjenesten brukerne trenger under realistiske feilforhold.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inn‑ og utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensebetingelser, feilformatert eller manglende input, distribusjons‑skifte, avhengighets‑nedetid, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latency, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og avvikling. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operativ telemetri bør avsløre inndata‑kvalitet, utdata‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en respons‑eier, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumenterte gjenopprettings‑, hendelses‑lærings‑, slettings‑ og lagringsprosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Hva er hovedmålet med ITOps?
Å levere og gjenopprette pålitelige teknologitjenester innenfor avtalte sikkerhets-, ytelses‑, kontinuitets‑ og kostnadsrammer.
Driftes skyinfrastruktur helt av skyleverandøren?
Nei. Leverandører driver deler av den underliggende plattformen, mens kundene fortsatt er ansvarlige for konfigurasjon, identitet, data, arbeidsbelastninger, overvåking og mange tjenestenivå‑beslutninger.
Primære referanser












