
Grunnleggende AI
Hva er hendelsesautomatisering? Arbeidsflyter, sikkerhetsrammer og brukstilfeller

 Legg til Unite.AI blant dine foretrukne kilder på Google
Hendelsesautomatisering bruker programvare til å oppdage, berike, rute, koordinere og noen ganger utbedre drifts‑ eller sikkerhetshendelser. Den kobler overvåkingssignaler til runbooks, ticketsystemer, kommunikasjon, tilgangskontroller og gjenopprettingshandlinger, slik at responsere bruker mindre tid på å kopiere data og mer tid på å ta beslutninger.
Automatisering er ikke fjerning av menneskelig ansvarlighet. Et trygt program skiller lav‑risiko deterministiske trinn fra handlinger som kan påvirke kunder eller produksjon, og anvender deretter godkjenninger, avgrensede påloggingsdetaljer, revisjonsspor, tidsavbrudd og tilbakeføring i henhold til påvirkningen.
Nøkkelpunkter
- Automatiser gjentakbar innsamling av bevis før du forsøker autonom utbedring.
- Bruk alvorlighetsgrad, sikkerhet, påvirkningsområde og reversibilitet for å velge et godkjenningsnivå.
- Behandle hver runbook som versjonert produksjonskode med tester og en eier.
- Mål oppdagelse, anerkjennelse, gjenoppretting, tilbakefall og brukerpåvirkning – ikke kun antall varsler.
Fra signal til koordinert respons
En arbeidsflyt kan deduplisere varsler, legge ved nylige utrullinger og logger, identifisere tjenesteeier, åpne en hendelsespost, varsle beredskapsteamet, opprette en kommunikasjonskanal og starte en tidslinje. Disse trinnene reduserer kognitiv belastning uten å automatisk foreta en risikabel diagnose.
Korrelering må bevare bevis. Hvis en plattform grupperer symptomer for aggressivt, kan den skjule samtidige hendelser. Koble automatiseringen til IT operations eierskap og behold de rå signalene som responsere kan trenge.
Velg handlinger etter risiko
Kun‑lese‑spørringer, øyeblikksbilder og reversible trafikkforskyvninger er generelt enklere å automatisere enn å slette data, rotere brede påloggingsdetaljer eller endre et produksjonsskjema. Definer forutsetninger, et utførelsestidsavbrudd, etterbetingelser og en tilbakeføring for hver handling.
Bruk minst‑privilegierte tjenesteidentiteter og separer autorisasjon fra arbeidsflytmotoren. Høypåvirknings‑trinn bør kreve en identifisert godkjenner. Hvis AIOps foreslår en årsak eller løsning, trenger responsere fortsatt støttende bevis og en sikker måte å avvise den på.
Bygg pålitelige runbooks
En runbook bør deklarere innganger, avhengigheter, eier, omfang, feiladferd og produserte bevis. Test den i staging og gjennom spill‑dager. Idempotente trinn er verdifulle fordi gjentatte forsøk ikke skaper ytterligere skade.
Versjonér og gjennomgå automatisering som annen programvare. Overvåk utløp av påloggingsdetaljer, API‑endringer, takstriper, delvis utførelse og skjult kobling mellom tjenester. Manuelle prosedyrer forblir nødvendige når automatiseringsplattformen selv er utilgjengelig.
Lær etter gjenoppretting
Automatisering bør bevare en tidsstemplet oversikt over signaler, beslutninger, handlinger, godkjenninger og resultater. En skyldfri gjennomgang kan da skille bidragende systemforhold fra den endelige utløseren og omdanne lærdom til testede forbedringer.
Nyttige målinger inkluderer gjennomsnittlig tid til anerkjennelse og gjenoppretting, prosentandel sikre trinn automatisert, feilhandlingsrate, gjentatte hendelser og kunde‑påvirkning. Koble funn til DevOps‑planlegging i stedet for å optimalisere for antall lukkede tickets.
Typer hendelsesautomatisering
Hendelsesautomatisering normaliserer og beriker innkommende signaler. Koordineringsautomatisering oppretter en hendelsespost, varsler eiere, åpner kommunikasjonskanaler og publiserer statusoppdateringer. Diagnostisk automatisering kjører kun‑lese‑spørringer eller tar øyeblikksbilder. Utbedringsautomatisering endrer systemtilstand, mens gjenopprettingsautomatisering verifiserer tjenestehelse og lukker midlertidige avbøtninger.
Disse kategoriene bør ikke dele ett standardtillitsnivå. Berikelse kan ofte kjøres automatisk; en produksjons‑failover kan kreve sikkerhetskontroller og en godkjenner; datagjenoppretting krever vanligvis en hendelsesleder og applikasjonseier. Kontroll bør følge potensiell påvirkning, ikke om trinnet er implementert av en regel eller en maskinlæringsmodell.
Sikkerhetshendelser legger til krav om bevaringsbevis. Automatisering må unngå å endre en kompromittert vert før flyktige data er fanget, eksponere sensitive indikatorer i offentlige kanaler, eller sette delt infrastruktur i karantene uten å forstå påvirkningsområdet. Operasjonelle og rettsmedisinske runbooks kan overlappe, men deres rekkefølge kan variere.
Arbeidsflytdesign og kontrollplan
Modeller runbooken som eksplisitte tilstander med forutsetninger og endelige resultater. Hver handling bør rapportere startet, lykkes, feilet, tidsavbrutt eller hoppet over, sammen med en uforanderlig utførelses‑identifikator. En sentral orkestrator kan koordinere trinn, men nedstrøms tjenester bør håndheve sin egen autorisasjon og validere innganger uavhengig.
Bruk avgrensede, kort‑levende påloggingsdetaljer og begrens nettverksveier fra automatiseringsmotoren. Skill utviklings‑, test‑ og produksjons‑kjørere. Hemmeligheter må ikke vises i chat‑utskrifter eller logger. For høypåvirknings‑handlinger, kreve to‑personers godkjenning eller en nødstilfelle‑rolle som ved bruk oppretter en umiddelbar revisjonsspor.
Design for delvis feil. En ticket kan opprettes mens varsling feiler; en trafikkforskyvning kan lykkes i én region og tidsavbrytes i en annen. Kompenserende handlinger, avstemnings‑jobber og klar eierskap hindrer arbeidsflyten i å rapportere suksess kun fordi orkestreringsprosessen avsluttet.
Eksempler, testing og modenhet
Et modent første brukstilfelle er uttømming av databaseforbindelser: samle pool‑metrikk, nylige utrullinger, trege spørringer og eierinformasjon; åpne en hendelse; foreslå en reversibel skalering eller trafikkhandling; kreve godkjenning; og deretter verifisere feilrate og latenstid. Det samme mønsteret kan brukes for sertifikatutløp, disk‑press, mislykkede jobber eller mistenkelig kontooaktivitet.
Test runbooks gjennom enhetstester, mock‑API‑er, staging‑hendelser, spill‑dager og kontrollerte produksjonsøvelser. Injiser utdaterte data, nektet tilgang, trege avhengigheter, dupliserte hendelser og konfliktende hendelser. Bekreft at gjenforsøk er trygge og at responsere kan ta manuell kontroll uten å kjempe mot automatiseringen.
Modenhet utvikler seg fra varsling, til berikelse, til veiledede handlinger, til avgrenset auto‑utbedring. Fremdrift bør avhenge av bevis: stabil diagnose, lav feilhandlingsrate, verifisert tilbakeføring og klar brukerfordel. Autonom lukking bør være sjelden inntil systemet kan bevise gjenoppretting og bevare nok bevis for senere læring.
Arbeids‑eksempel: automatisering av en produksjonstjeneste‑hendelse
Tenk på et betalings‑API der feilraten øker etter en utrulling. Overvåkning sender et strukturert varsel som inneholder tjeneste, miljø, region, versjon, feilbudsjett og runbook‑lenke. Automatisering beriker dette med endringsloggen, avhengighetshelse, nylige logger og eierskap, og grupperer dupliserte varsler til én hendelse. En deterministisk policy kan umiddelbart pause videre utrulling; en tilbakeføring bør kreve bevis for at den nye versjonen er årsaken og at tilbakeføring er trygg.
Arbeidsflyten tildeler en hendelsesleder, åpner kommunikasjonskanaler, registrerer en tidslinje og foreslår diagnostiske trinn. Automatisert utbedring starter med lav‑risiko reversible handlinger som å flytte trafikk til en sunn instans. Hver handling krever autorisasjon, samtidighetsgrenser, et tidsavbrudd, verifiserte etterbetingelser og tilbakeføring. Generative sammendrag kan bistå responsere, men kilde‑telemetri og kommandoer forblir synlige slik at teamet kan utfordre en feilfortelling.
Mål tid til oppdagelse, anerkjennelse, demping og gjenoppretting; varslingsvolum; duplikatundertrykkelse; utbedringssuksess; tilbakefall; og skade forårsaket av automatisering. Gjennomfør spill‑dager for utløpte påloggingsdetaljer, delvise regioner, misvisende varsler og mislykkede tilbakeføringer. Etter gjenoppretting, bevar den faktiske tidslinjen, identifiser bidragende tekniske og organisatoriske forhold, oppdater runbooks og tester, og spor korrigerende arbeid til fullføring i stedet for å behandle en rask demping som slutten på pålitelighetsarbeidet.
Praktisk implementeringssjekkliste
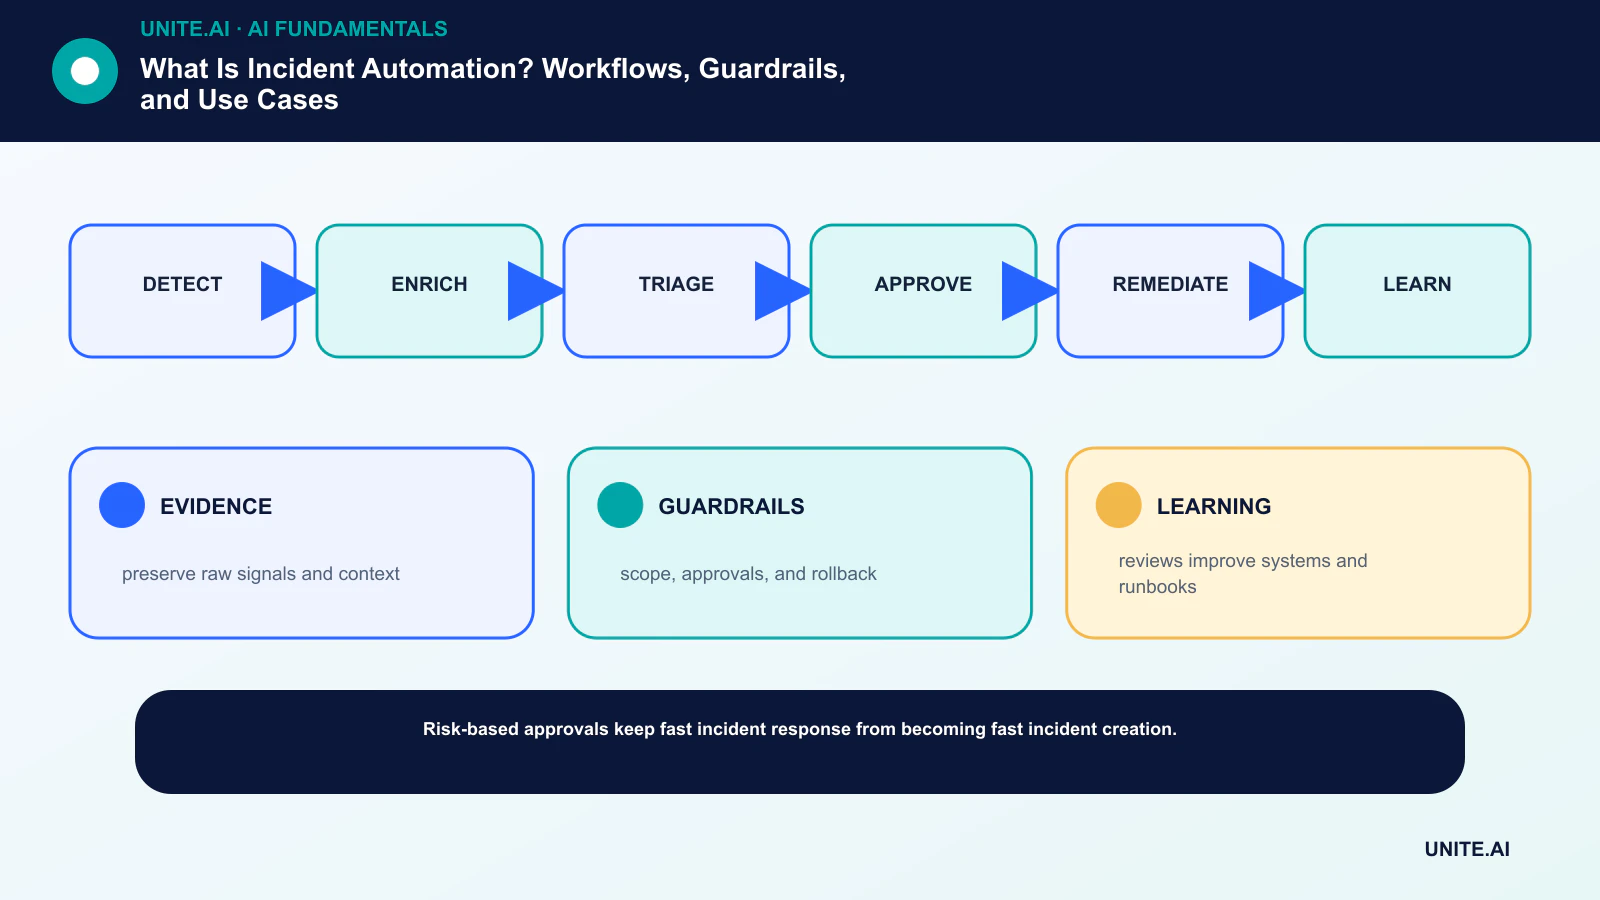
Gjør konseptet til en avgrenset, testbar arbeidsflyt: oppdag → berik → triager → godkjenn → utbedre → lær. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basislinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåkning, tilbakeføring og gjennomgang før du utvider omfanget. Registrer versjoner og forutsetninger slik at et annet team kan gjenskape resultatet og forstå hva som endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevisene og uavklarte risikoer. Definer hvem som kan godkjenne en utgivelse, endre en terskel, overstyre et resultat eller stoppe driften. Gå gjennom beslutningen på nytt etter at virkelige data kommer inn, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- BEVIS: bevar rå signaler og kontekst.
- SIKKERHETSRAMMER: omfang, godkjenninger og tilbakeføring.
- LÆRING: gjennomganger forbedrer systemer og runbooks.
Ofte stilte spørsmål
Er hendelsesautomatisering det samme som AIOps?
Nei. AIOps anvender analyse eller maskinlæring på driftsdata. Hendelsesautomatisering er det bredere utførelses‑ og koordineringslaget; den kan bruke enkle regler, AIOps‑resultater eller begge.
Hva bør automatiseres først?
Start med høy‑frekvente, lav‑risiko, godt forståtte trinn som berikelse, oppslag av eierskap, innsamling av bevis, statusoppdateringer og reversible diagnostikk.
Primære referanser











