
AI-basisprincipes
Wat is Computer Vision?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Computer vision is het vakgebied van het bouwen van systemen die bruikbare informatie uit afbeeldingen en video halen. Een vision‑model kan een volledige afbeelding classificeren, objecten lokaliseren, elke pixel labelen, tekst lezen, pose schatten, beweging volgen, of visuele inhoud verbinden met taal.
Moderne visionsystemen reproduceren niet simpelweg het vroege randdetectieproces van de menselijke waarneming. Ze leren taak‑specifieke representaties uit data, vaak met behulp van convolutionele neurale netwerken, vision‑transformers of multimodale foundation‑modellen.
Belangrijkste conclusies
- Classificatie, detectie, segmentatie, OCR, tracking en generatie zijn afzonderlijke vision‑taken.
- CNN’s bouwen localiteit en gewichtsdeling in; vision‑transformers gebruiken aandacht over afbeeldings‑patches.
- Labels kunnen afkomstig zijn van mensen, zwakke supervisie, synthetische data of zelf‑supervised doelstellingen.
- Nauwkeurigheid alleen is onvoldoende: robuustheid, latentie, privacy, bias en foutkosten zijn belangrijk.
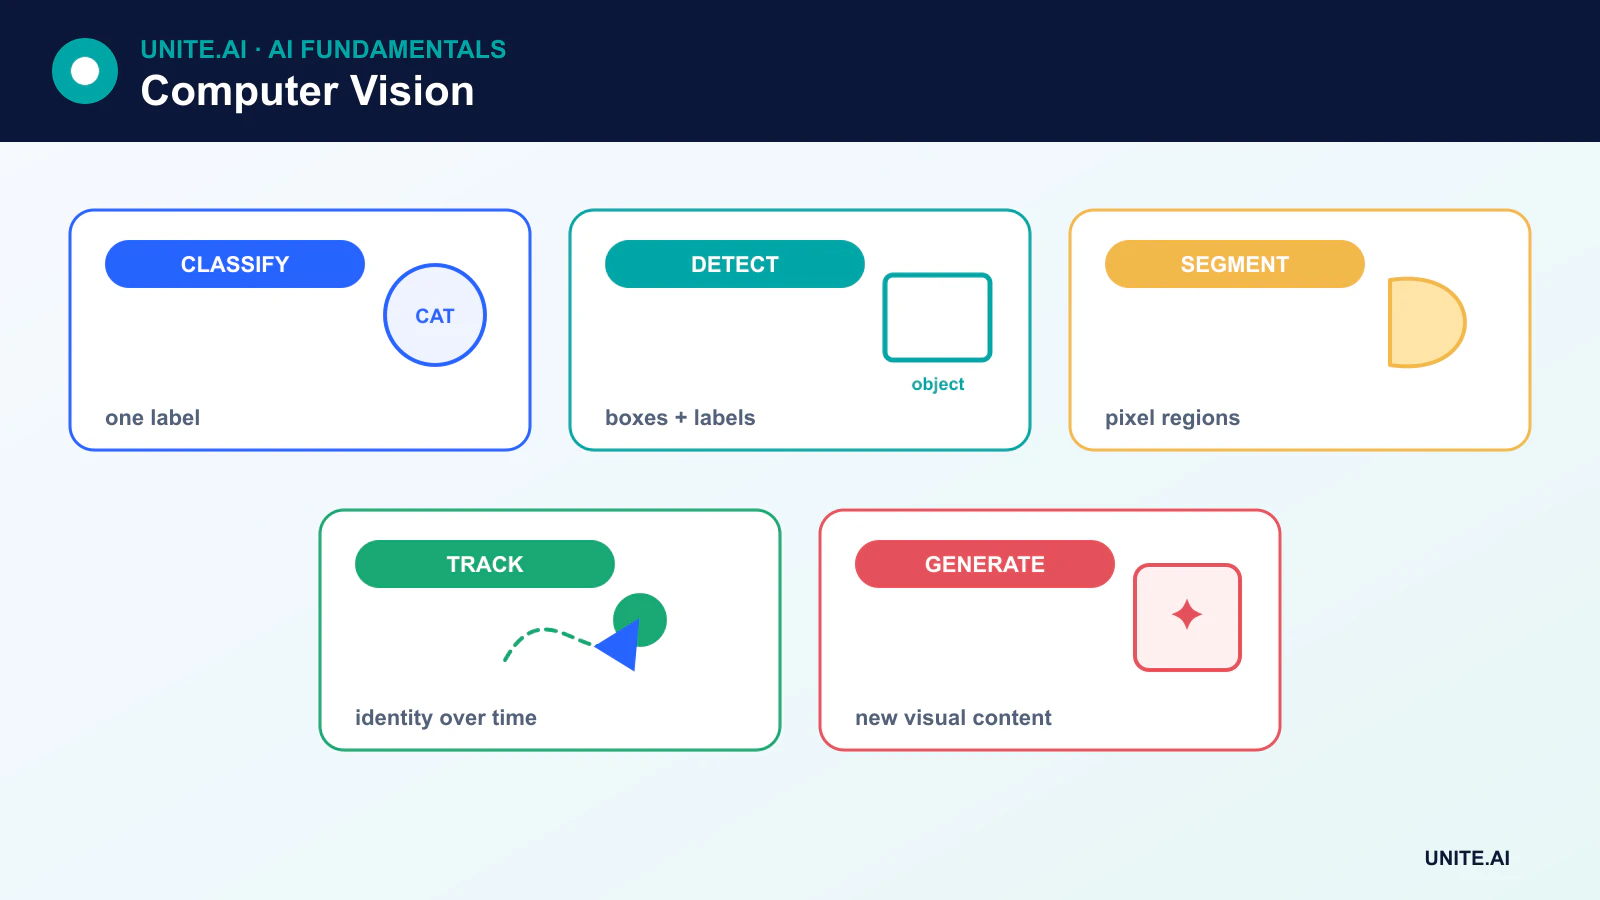
De belangrijkste computer‑vision‑taken
- Afbeeldingsclassificatie kent één of meer labels toe aan een afbeelding. Zie hoe afbeeldingsclassificatie werkt.
- Objectdetectie voorspelt categorieën en begrenzingskaders voor meerdere objecten.
- Semantische segmentatie labelt elke pixel per klasse, terwijl instance‑segmentatie individuele objecten scheidt.
- Optische tekenherkenning (OCR) detecteert en transcribeert tekst.
- Pose‑schatting voorspelt lichaams‑ of object‑landmarks.
- Tracking associeert detecties over videoframes.
- Afbeeldingsgeneratie en -bewerking produceren of transformeren visuele inhoud, vaak met behulp van diffusiemodellen.
Hoe afbeeldingen modelinvoer worden
Een digitale afbeelding is al numerieke data: een tensor met pixelwaarden over ruimtelijke dimensies en kanalen. Preprocessing kan de afbeelding herschalen, normaliseren, bijsnijden of augmenteren. Video voegt een tijdsdimensie toe, terwijl medische en wetenschappelijke beeldvorming diepte, golflengte of andere modaliteiten kan toevoegen.
Klassieke computer‑vision gebruikte hand‑ontworpen rand‑, hoek‑ en textuurkenmerken. Moderne diepe modellen leren meestal kenmerken gezamenlijk met de taak, hoewel klassieke methoden nuttig blijven wanneer data beperkt is, regels goed begrepen zijn of de rekencapaciteit minimaal moet zijn.
CNN’s en geleerde lokale kenmerken
Een CNN past geleerde kernels toe over lokale buurten. Vroege lagen kunnen reageren op lokale patronen, terwijl latere blokken ze combineren tot taak‑relevante representaties. Pooling‑ of stride‑operaties verlagen de ruimtelijke resolutie, en residuele verbindingen maken diepe netwerken makkelijker te optimaliseren.
Een moderne CNN‑classifier gebruikt vaak globale pooling in plaats van een grote stapel volledig verbonden lagen. Detectoren en segmentatienetwerken voegen gespecialiseerde heads of decoder‑paden toe die ruimtelijke informatie behouden.
Vision‑transformers en foundation‑modellen
Een vision‑transformer verdeelt een afbeelding in patches, embedt ze, en gebruikt aandacht om hun relaties te modelleren. Transformers kunnen effectief opschalen met grote datasets en pre‑training, terwijl CNN’s vaak sterkere ingebouwde aannames en efficiëntie bieden op kleinere schaal.
Multimodale modellen aligneren afbeeldingen met tekst zodat gebruikers kunnen zoeken, bijschriften maken, vragen beantwoorden of segmentatie begeleiden met taal. Deze modellen breiden de mogelijkheden uit, maar erven ook zwaktes van brede web‑scale data, waaronder stereotypen, auteursrechtelijk beschermd materiaal en ongelijke dekking van bevolkingsgroepen en omgevingen.
Labels, zelf‑supervisie en synthetische data
Begrenzingskaders, maskers, landmarks en bijschriften kunnen duur zijn om te maken. Zelf‑supervised leren haalt doelstellingen uit de afbeeldingen zelf, terwijl zwakke supervisie ruis‑ of indirecte labels gebruikt. Synthetische data kan zeldzame scenario’s toevoegen, maar simulatie‑gaten kunnen voorkomen dat synthetische prestaties naar de echte wereld overgaan.
Annotatie‑kwaliteit moet worden gemeten. Ambigue labels, inconsistente grenzen en ontbrekende objecten stellen een plafond aan de prestaties en kunnen falen van subgroepen verbergen.
Hoe visionsystemen worden geëvalueerd
Classificatie gebruikt meetwaarden zoals nauwkeurigheid, precisie, recall, F1 en calibratie. Detectie maakt vaak gebruik van intersection over union en mean average precision. Segmentatie gebruikt intersection over union of Dice‑achtige maten. Tracking voegt identiteit‑ en trajectmetriek toe.
De meetwaarde moet passen bij de inzet. Een model kan goed scoren op een samengestelde benchmark en toch falen bij regen, weinig licht, ongebruikelijke camerahoeken, nieuwe apparaten of onbekende populaties. Evaluatie moet verschuiving in distributie, adversariële omstandigheden en operationele latentie omvatten.
Privacy, bias en inzet
Gezichten, kentekens, woningen, medische scans en video op de werkplek kunnen gevoelige informatie onthullen. Verzameling en bewaring moeten volgens een gedefinieerde juridische en ethische basis plaatsvinden, met toegangscontroles en dataminimalisatie. Gezichtsanalyse en biometrische identificatie verdienen bijzondere aandacht omdat fouten en surveillance ongelijke schade kunnen veroorzaken.
Edge‑inzet kan latentie en datatransfer verminderen. Edge AI, kwantisatie, pruning en gespecialiseerde versnellers kunnen visionsystemen praktisch maken op camera’s, voertuigen, robots en mobiele apparaten, maar compressie moet opnieuw worden geëvalueerd voor nauwkeurigheid en bias.
Van pixels naar visuele taken
Computer vision zet afbeeldingen of video om in taakuitvoer zoals classificatie, detectie, segmentatie, tracking, pose, diepte, optische flow of teksterkenning. De taakdefinitie bepaalt de annotatie: een afbeeldingslabel kan geen precieze lokalisatie trainen, en een begrenzingskader kan een segmentatiemasker niet volledig beschrijven. Camera‑geometrie, lenzen, belichting, verlichting, beweging, compressie en gezichtspunt vormen de datadistributie. Definieer de operationele omgeving en de foutgevolgen voordat een model wordt gekozen, omdat een benchmark‑beeldcollectie mogelijk niet de ingezette sensor of scène weergeeft.
Een pijplijn decodeert en orienteert media, schaalt of verdeelt het, normaliseert waarden, past label‑behoudende augmentatie toe, voert een model uit en post‑processes logits, boxes, maskers of tracks. Objectdetectoren gebruiken vertrouwensdrempels en suppressie; trackers associëren detecties over tijd; segmentatie kan morfologische opschoning vereisen. Behoud coördinatentransformaties zodat uitvoer overeenkomt met de originele afbeelding. Splits data op persoon, camera, locatie of opnamesessie om te voorkomen dat bijna identieke frames in zowel trainings‑ als testsets voorkomen.
Evaluatie, bias, privacy en operaties
Meetwaarden moeten passen bij de taak en het gebruik. Classificatie vereist klassen‑specifieke precisie en recall; detectie gebruikt intersection‑over‑union en gemiddelde precisie over drempels; segmentatie gebruikt IoU of Dice; tracking voegt identiteitswisselingen toe; latentie en gemiste‑gebeurtenisduur zijn belangrijk voor video. Rapporteer resultaten per verlichting, afstand, apparaat, occlusie, huidskleur, leeftijd en andere relevante omstandigheden. Inspecteer calibratie en fouten met hoge zekerheid. Synthetische of vergrote data kunnen hiaten opvullen, maar vereisen vergelijking met echte inzet‑data en mogen geen testscènes lekken.
Vision kan omstanders, locaties, biometrie en gevoelig gedrag verzamelen. Minimaliseer vastlegging en bewaring, beveilig streams, beperk secundair gebruik en geef waar nodig kennisgeving of toestemming. Test adversariële patches, replay, occlusie, camera‑falen en domeinschuiving. Monitor sensor‑gezondheid, invoerstatistieken, uitvoer‑snelheden en bevestigde uitkomsten; houd menselijke beoordeling voor belangrijke beslissingen. Vervagen of bijsnijden kan blootstelling verminderen, maar kan ook bewijs wegnemen. Een hoge laboratoriumscore rechtvaardigt geen identiteits‑, emotie‑ of intentie‑claims buiten de gevalideerde taak.
Praktisch voorbeeld: voetgangersdetectie bij een magazijnoversteek
Camera’s bewaken een beperkt voertuig‑oversteekpunt, en het model detecteert mensen zonder ze te identificeren. Data omvat dag en nacht, weer, kleding, occlusie, rolstoelgebruikers, cameraposities en lege scènes, gesplitst per opnamesessie. De detector wordt geëvalueerd op gebeurtenis‑recall, valse alarmen, lokalisatie, waarschuwings‑lead‑time en prestaties op afstand. Veiligheids‑engineering definieert de maximaal tolerabele latentie en onafhankelijke fysieke controles.
De vision‑alert kan een voertuig vertragen, maar noodstops en barrières zijn niet afhankelijk van het geleerde model. Camera‑obstructie, bevroren frames, netwerkverlies en model‑time‑out veroorzaken expliciete fouten. Het bewaren van ruwe video wordt geminimaliseerd en toegang gelogd. Monitoring volgt sensor‑gezondheid, alarm‑frequenties, beoordeelde incidenten en bijna‑incidenten per conditie. Elke verplaatsing van een camera of wijziging van de lay‑out triggert hervalidatie omdat ogenschijnlijke beeld‑gelijkenis dezelfde geometrie of risico niet garandeert.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieschuiving, afhankelijkheids‑uitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taak‑kwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet invoer‑kwaliteit, uitvoer‑gedrag, model‑ of regel‑versie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en beoordeel vervolgens bewijs uit de praktijk na inzet in plaats van te veronderstellen dat offline prestaties blijven bestaan. Her‑evalueer wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en bewaarprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Is computer vision hetzelfde als beeldherkenning?
Nee. Beeldherkenning verwijst meestal naar classificatie of identificatie. Computer vision omvat ook lokalisatie, segmentatie, meting, tracking, reconstructie, generatie en redeneren over visuele informatie.
Ziet een visionsysteem zoals een mens?
Nee. Een model verwerkt numerieke invoer volgens zijn architectuur en trainingsdoelstelling. Het kan mensen overtreffen op een smalle benchmark, maar faalt bij kleine veranderingen die een persoon gemakkelijk aankan.
Primaire referenties












