
AI-basisprincipes
Hoe werkt beeldclassificatie?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
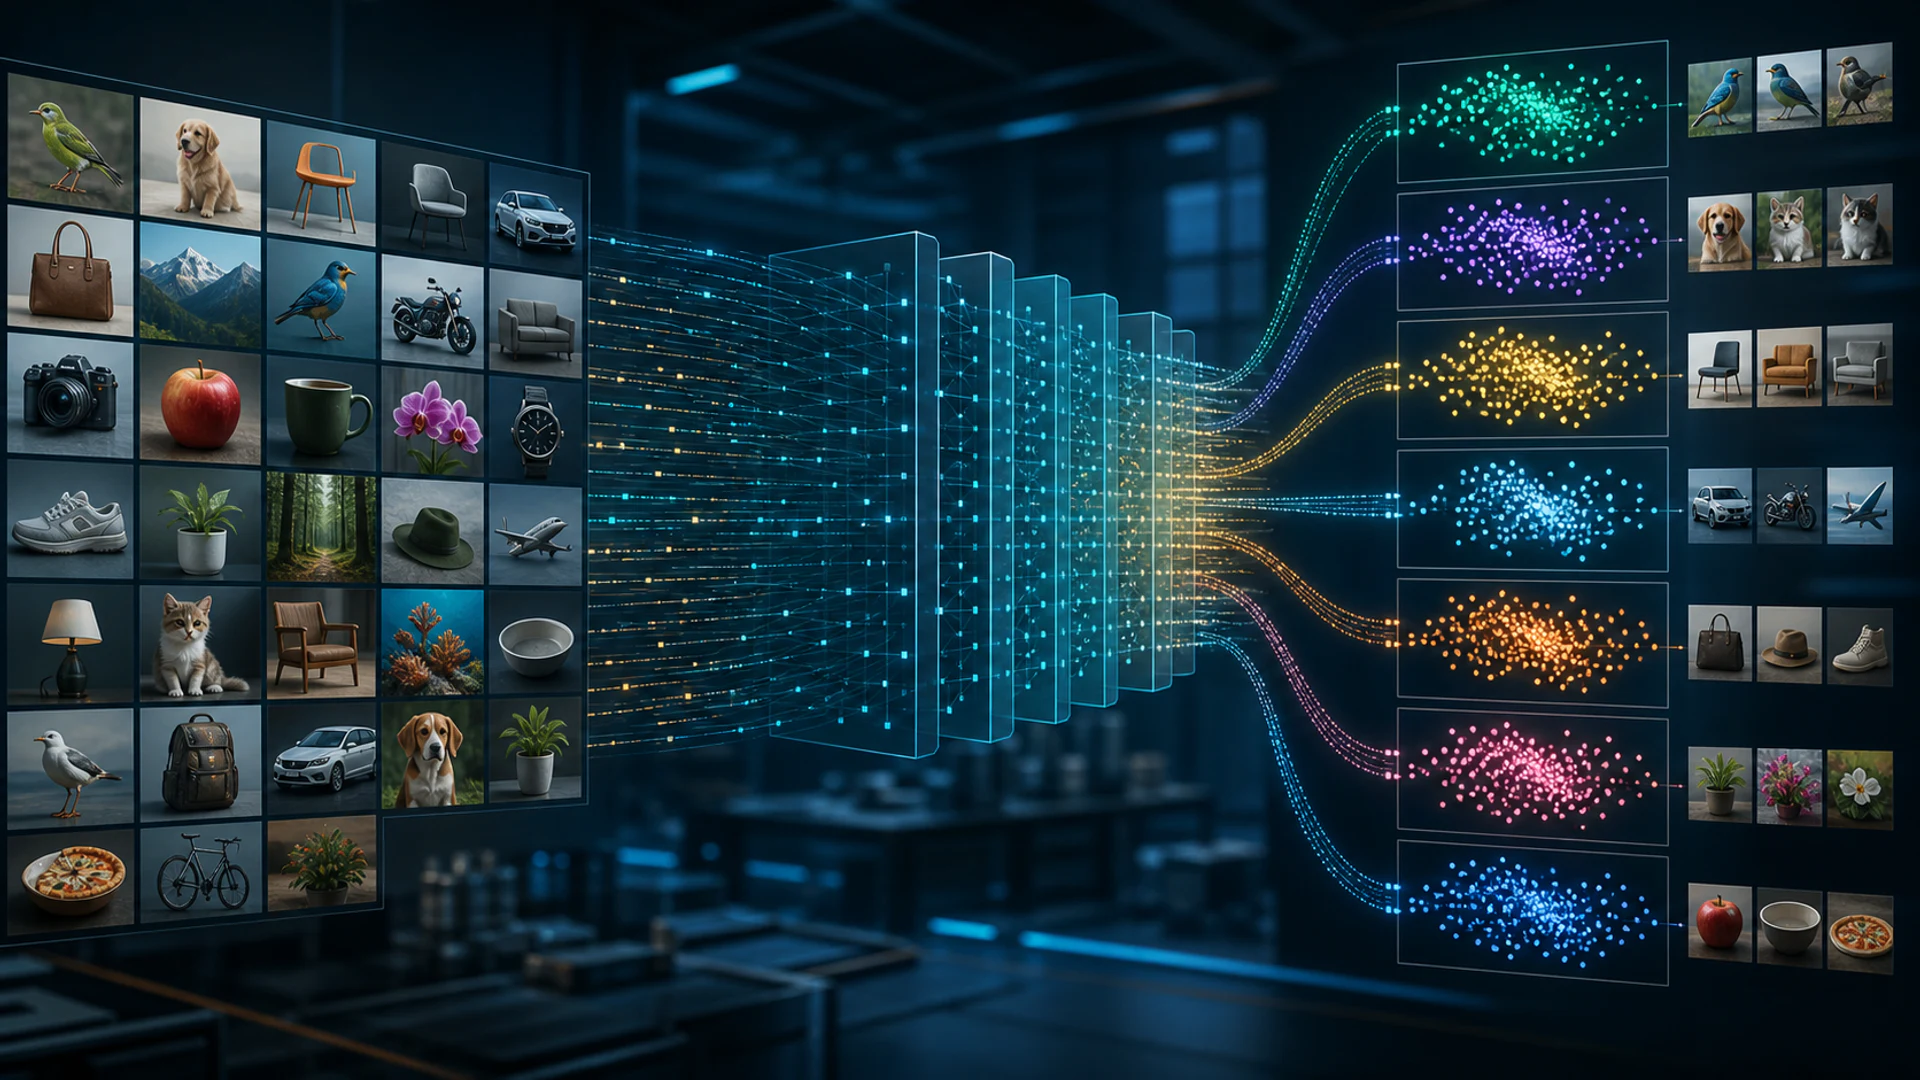
Beeldclassificatie voorspelt een label voor een volledige afbeelding. Het beantwoordt vragen zoals “Welke productcategorie wordt getoond?” of “Bevat deze scan een doelwit?” Het lokaliseert niet zelf elk object of schetst de pixels.
Moderne systemen gebruiken vaak convolutionele neurale netwerken of vision transformers, vaak geïnitialiseerd met voorgetrainde gewichten. Betrouwbare prestaties blijven afhankelijk van labels, bemonstering, augmentatie, calibratie en testen onder echte implementatieomstandigheden.
Belangrijkste punten
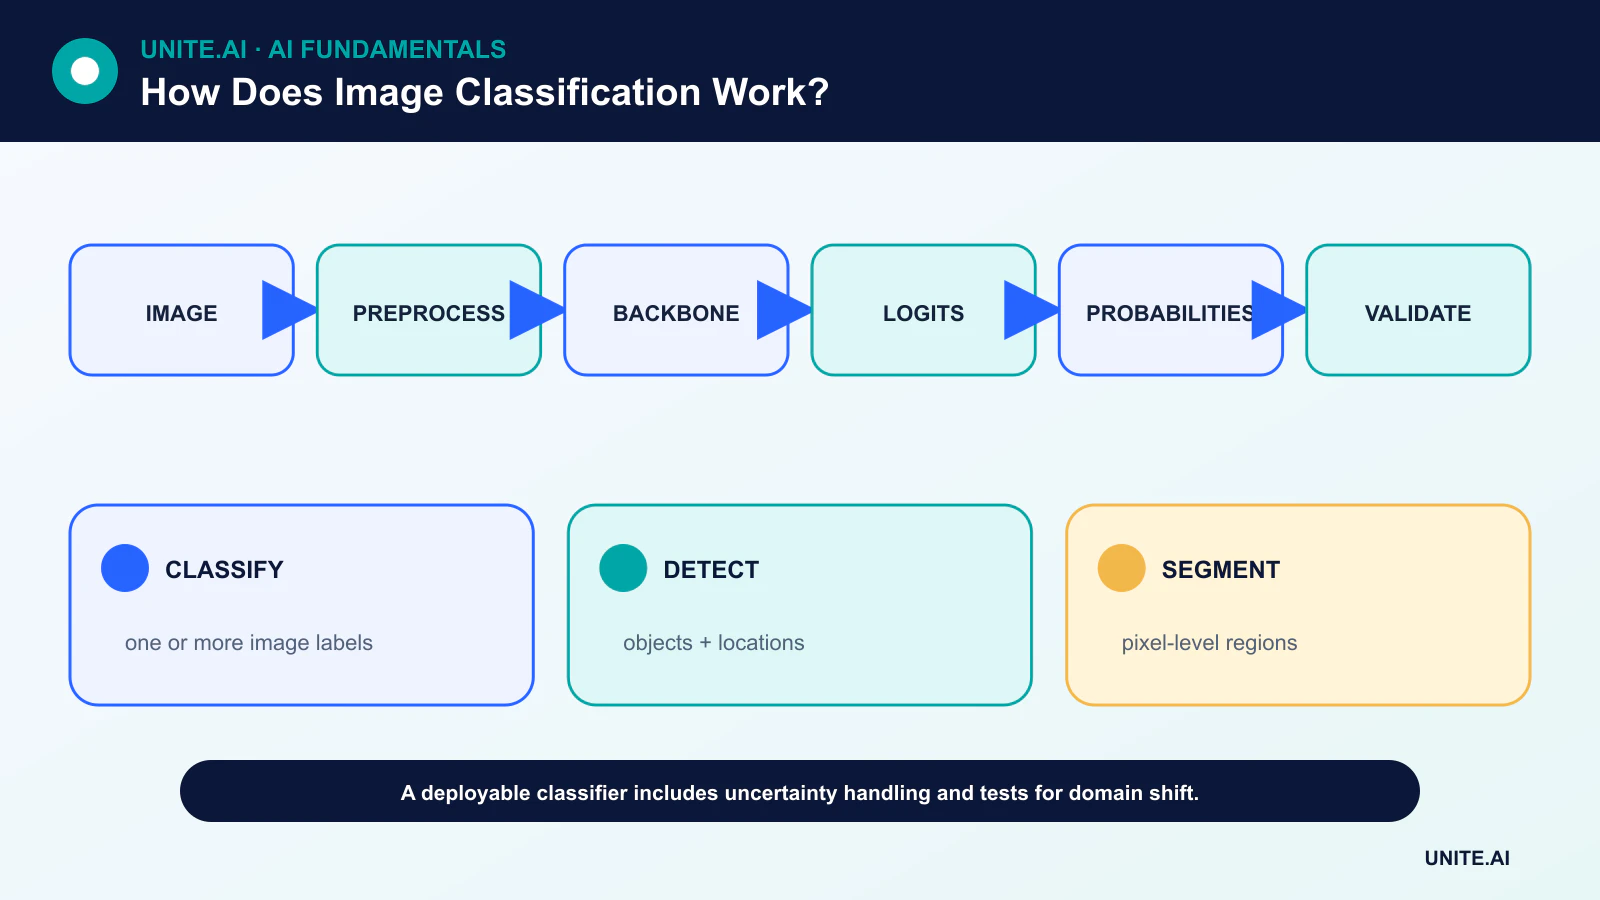
- Classificatie labelt de volledige afbeelding; detectie tekent objectkaders en segmentatie kent pixel‑niveau regio’s toe.
- Voortraining en transfer learning kunnen de datavereisten verminderen, maar domein‑mismatch kan het voordeel tenietdoen.
- Algemene nauwkeurigheid kan klasse‑onevenwichtigheid, misleidende shortcuts en slechte calibratie verbergen.
- Beeldkwaliteit, opnameapparaat, geografie en workflow‑veranderingen kunnen allemaal een distributieverschuiving veroorzaken.
Van pixels naar scores
Afbeeldingen worden verkleind of bijgesneden, genormaliseerd en omgezet naar tensors. Data‑augmentatie kan label‑behoudende transformaties toepassen, zoals spiegelen, bijsnijden of kleurveranderingen. Een backbone zet pixels om in kenmerken; een classificatie‑head produceert logits die worden omgezet in relatieve klasse‑scores.
De gekozen preprocessing moet overeenkomen met de implementatie. Een centrale uitsnede die het relevante object verwijdert of een normalisatie‑mismatch kan de prestaties aantasten, zelfs wanneer de getrainde gewichten ongewijzigd blijven.
CNN’s en vision transformers
Convolutionele neurale netwerken gebruiken lokale filters en gedeelde gewichten om ruimtelijke kenmerken te bouwen. Residual connections maakten zeer diepe CNN’s gemakkelijker te optimaliseren. Vision transformers splitsen een afbeelding in patches en gebruiken aandacht om relaties daartussen te modelleren.
Architectuurvergelijkingen moeten gecontroleerd worden op trainingsdata, augmentatie, rekenkracht en resolutie. Het beste model op een publieke benchmark is mogelijk niet het beste voor een edge‑apparaat, een kleine dataset of een vereiste voor verklaarbaarheid.
Transfer learning en data‑ontwerp
Transfer learning begint met gewichten die getraind zijn op een grotere bron‑dataset. Een team kan de backbone bevriezen, latere lagen fijn afstellen of het volledige model bijwerken. Fijn afstellen vereist meestal een lagere leersnelheid en een validatieset die lekken voorkomt.
Labels moeten beschrijven wat visueel af te leiden is. Als een diagnose afhankelijk is van de patiëntgeschiedenis die niet in de afbeelding aanwezig is, kan de classifier de volledige klinische beslissing niet leren. Duplicaten, frames uit één video en afbeeldingen van dezelfde subject moeten in dezelfde split blijven.
Metrieken, onzekerheid en shortcuts
Top‑1‑accuratesse vereist dat de klasse met de hoogste score correct is; top‑k‑accuratesse accepteert de correcte klasse onder de k hoogste scores. Per‑klasse precisie, recall en een confusiematrix onthullen ongelijke fouten.
Modellen kunnen achtergronden, watermerken, acquisitie‑apparatuur of framing exploiteren in plaats van het beoogde object. Counterfactual‑tests, subgroepanalyse en saliency‑tools kunnen helpen shortcuts te ontdekken, maar een verklarende heatmap bewijst geen causaal redeneren.
Monitoring tijdens implementatie
Productiecontroles moeten corrupte bestanden, onverwachte afmetingen, onscherpte, verlichting, cameramodellen en nieuwe klassen dekken. Vertrouwen moet gekalibreerd worden op data die lijken op de implementatie, en out‑of‑scope‑invoer moet worden afgewezen of beoordeeld.
Het monitoren van vertraagde labels en veranderingen in foutkosten is essentieel. Een model dat stabiel lijkt op basis van invoerstatistieken kan nog steeds falen als de relatie tussen pixels en labels verandert.
Een beeldclassificatie‑dataset bouwen
Beeldclassificatie kent één of meer labels toe aan een volledige afbeelding. Het verschilt van detectie, die objecten lokaliseert, en segmentatie, die pixels labelt. Definieer de klasse‑scope, hiërarchie, multi‑label regels, achtergrond‑ of onbekende categorieën, en welk bewijs zichtbaar moet zijn. Verzamel camera’s, locaties, verlichting, gezichtspunten, afstanden en onderwerpen die representatief zijn voor de implementatie. Splits op onderwerp, scène, sessie of bron vóór augmentatie; aangrenzende videoframes of gedupliceerde productafbeeldingen over partities veroorzaken ernstige lekken.
Annotatie‑instructies moeten occlusie, ambiguë objecten, meerdere klassen, lage kwaliteit en onthouding behandelen. Meet overeenstemming en beoordeel systematische meningsverschillen. Klassenbalans alleen garandeert geen dekking: een ziekte‑klasse kan één apparaat omvatten of een wildlife‑klasse één achtergrond. Inspecteer metadata en bijna‑duplicaten, en houd een beschermde testset van onafhankelijke acquisitie. Synthetische data en web‑scraping kunnen de variëteit vergroten, maar brengen licentie‑, herkomst‑, stijl‑ en labelproblemen met zich mee die op echte afbeeldingen gemeten moeten worden.
Modellen, training en evaluatie
Klassieke methoden combineren ontworpen descriptoren met een classifier; moderne systemen gebruiken convolutionele netwerken of vision transformers, vaak via transfer learning. Keuzes voor verkleinen en bijsnijden bepalen welke informatie behouden blijft. Augmentatie moet valide variatie weerspiegelen en labels behouden. Optimaliseer een taak‑geschikte loss, behandel onevenwichtigheid zorgvuldig via weging of sampling, en selecteer checkpoints op validatiedata. Vergelijk met een eenvoudige baseline en verwijder augmentatie, resolutie en voorgetrainde initialisatie om te leren waar de winst vandaan komt.
Rapporteer per‑klasse precisie, recall, F1, confusie, top‑k‑accuratesse wanneer relevant, calibratie en prestaties per conditie. Test onscherpte, compressie, verlichting, bijsnijden, occlusie, apparaat en invoer zonder ondersteunde klasse. Drempels voor vertrouwen kunnen onzekere gevallen naar review sturen; softmax‑probabiliteit is geen gegarandeerd vertrouwen, vooral bij verschuiving. Counterfactual‑achtergronden en occlusietests onthullen shortcut‑leren. Voor veiligheid‑gerelateerde toepassingen, evalueer worst‑case‑falen en de consequenties van false positives en false negatives.
Implementatie en monitoring
Bundel decode, kleurconversie, oriëntatie, normalisatie, model en label‑map samen. Valideer het geëxporteerde of gekwantiseerde artefact op doelapparaten en meet end‑to‑end‑latentie, geheugen, stroom en doorvoer. Monitor beeldkwaliteit, invoer‑ en uitvoer‑distributies, calibratie, bevestigde labels en sensorgezondheid. Minimaliseer en beveilig het bewaren van afbeeldingen, vooral van gezichten, locaties en omstanders. Bied een fallback voor corrupte of out‑of‑scope‑invoer en rol modelversies terug. Classificatie beantwoordt de gedefinieerde vraag op afbeeldingsniveau; het mag niet worden uitgerekt tot niet‑ondersteunde lokalisatie, identiteit of intentie‑claims.
Voorbeeld: recyclebare materialen classificeren
Een faciliteit fotografeert items op een transportband en labelt materiaalklasse, contaminatie en onbekend. Afbeeldingen worden gesplitst op verzamelingsdag en objectbatch, met variatie in verlichting, natte oppervlakken, kreukelen, overlapping en lege banden. Een kleine CNN en een voorgetraind model worden vergeleken met kleur‑ en vormregels. Per‑klasse recall, foutieve sortering, calibratie, doorvoer en resultaten per camera en materiaalkonditie bepalen de selectie.
De productiepijplijn verifieert de camera‑exposure en band‑timing, en stuurt vervolgens onzekere items naar een algemene stroom in plaats van een klasse af te dwingen. Gekwantificeerde inferentie wordt gevalideerd op exacte hardware. Monitoring volgt invoerkwaliteit, klasse‑percentages, afwijzingen en steekproef‑handmatige audits; nieuwe verpakkingen activeren een herzien data‑update. Het model bestuurt een begrensde sorteerder met fysieke afschermingen, en sensor‑ of model‑falen brengt het mechanisme terug naar een veilige toestand in plaats van stilzwijgend materiaal verkeerd te routeren.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke storing. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, grensvoorwaarden, misvormde of ontbrekende invoer, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet invoerkwaliteit, uitvoergedrag, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentierichtlijnen nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Kan een beeldclassifier meerdere objecten identificeren?
Een multilabel‑classifier kan aangeven welke categorieën aanwezig zijn, maar lokaliseert geen individuele exemplaren. Objectdetectie is nodig voor vakken of tellingen.
Waarom kan een model falen op foto’s die er normaal uitzien voor een mens?
Het kan afhankelijk zijn van opname‑artefacten, texturen of correlaties die zijn veranderd. Kleine verschillen in preprocessing en domeinsverschuiving kunnen ook de geleerde kenmerken beïnvloeden.
Primaire referenties












