
Andersonの視点
Stable Diffusionが直面する3つの課題

 Unite.AI を Google の優先ソースに追加
要点Stable Diffusionは、十分に細分化された学習データのアノテーションが不足しているため、人間の手足の描写に苦戦しています。
もっと見る
- Stable Diffusionは、十分に細分化された学習データのアノテーションが不足しているため、人間の手足の描写に苦戦しています。
- タイルベースのアップスケーリング手法は、より広範な文脈認識がない場合、断片的な画像を生成するリスクがあります。
- このモデルの512x512というネイティブ解像度は出力品質を制限し、複雑な回避策を必要とします。
数週間前の 公開 で登場した stability.ai の Stable Diffusion は、 潜在拡散 による画像合成モデルであり、極めて重要な技術公開の一つかもしれない。 1999年の DeCSS 以来という意味でだ。AI生成画像では、2017年に deepfakes のコード が GitHub にコピーされ、そこから分岐したものが後の DeepFaceLab や FaceSwap、そしてリアルタイム配信の deepfake ソフトウェア DeepFaceLiveへと発展した出来事以来、最大の事件であることは確かだ。
一挙に ユーザーの不満 が解消された。それまでの コンテンツ制限 は DALL-E 2 の画像合成 API にあったが、Stable Diffusion の NSFW フィルターは コードを1行変更するだけで無効化できると分かったからだ。ポルノ中心の Stable Diffusion Reddit コミュニティがほぼ即座に現れ、同じくらい速く閉鎖された。一方、開発者とユーザーは Discord 上で公式と NSFW のコミュニティに分かれ、Twitter は Stable Diffusion の幻想的な作品で埋まり始めた。
現在、このシステムを採用した開発者は毎日のように驚くべき革新をもたらしている。プラグインや第三者の補助機能が急いで書かれ、 Krita, Photoshop, Cinema4D, Blenderなど多くのアプリケーション基盤に対応しつつある。
一方、 プロンプト作成術 は、今や専門職となった「AIにささやく」技術だ。「Filofax整理係」以来最も短命な職業になりかねないこの仕事も、すでに 商業化されている。Stable Diffusion の初期の収益化は Patreon の段階で進んでいるが、さらに高度なサービスが登場することは確実だ。それは、 Conda を使った ソースコードのインストールや、ウェブ版の厳しい NSFW フィルターを扱いたくない人向けである。
開発とユーザーの自由な探索は目が回るほど速く進み、遠い先を見通すのは難しい。そもそも何を扱っているのか、その全ての限界や可能性は何か、まだ正確には分からない。
それでも、急速に形成され成長する Stable Diffusion コミュニティが直面し、できれば乗り越えるべき、特に興味深く難しい障害を三つ見てみよう。
1:タイル方式の処理パイプラインを最適化する
限られたハードウェア資源と学習画像の解像度の厳格な上限を考えると、開発者は Stable Diffusion の出力品質と解像度を改善する迂回策を見つけるだろう。多くのプロジェクトは、ネイティブ解像度がわずか512×512ピクセルであることなど、システムの制約を利用することになる。
コンピュータービジョンや画像合成の取り組みで通常そうであるように、Stable Diffusion も正方形画像で学習した。ここでは512×512にリサンプリングして元画像を統一し、学習に使う GPU の制約内に収めた。
したがって Stable Diffusion は、もし「考える」なら512×512単位で、確実に正方形を前提に考える。限界を探っている多くのユーザーは、このかなり限定された縦横比で最も信頼性が高く、欠陥の少ない結果が得られると報告している(下の四肢の問題を参照)。
各種実装には RealESRGAN による拡大機能がある( GFPGAN で不出来な顔も修正できる)が、複数のユーザーは画像を512×512ピクセルの区画に分け、つなぎ合わせて大きな合成作品を作る方法を開発中だ。

通常は Stable Diffusion の1回の生成では不可能な解像度である、この1024×576の画像は、 DoggettX 版 Stable Diffusion の attention.py という Python ファイルを別の派生版にコピーして作られた。元の派生版はタイル方式の拡大を実装している。 出典:https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
こうした試みの一部は独自コードや別のライブラリを使うが、GOBIG の txt2imghd 移植版 は近く主要ブランチにこの機能を提供する予定だ。GOBIG は大量の VRAM を要する ProgRockDiffusion のモードである。txt2imghd は GOBIG 専用の移植版だが、他のコミュニティ開発者は別の GOBIG 実装を試している。

この説明に都合のよい抽象画像の元の512×512ピクセル生成結果(左と左から2番目)。今や各 Stable Diffusion 配布版にほぼ標準搭載される ESGRAN で拡大し、さらに GOBIG の実装で「特別な注意」を与えた。少なくとも該当する画像区画内では、よりよく拡大されたように見える細部が生まれる。出典:https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
上の抽象例には、その区画だけを見る拡大方式に適した細部の「小さな王国」が多数ある。しかし、反復のない一貫した拡大結果を作り、多くの部分を寄せ集めたように 見えない ようにするには、もっと難しいコードによる解決が必要かもしれない。特に顔では、私たちは異常や目障りな人工的欠陥に非常に敏感だ。したがって顔には最終的に専用の解決策が必要かもしれない。
Stable Diffusion にはまだ、人が顔情報を優先するように、生成中に顔へ注意を集中する仕組みがない。Discord の開発者の一部は、この「強化された注意」を検討しているが、今は最初の生成後に手動で顔を改善する方がはるかに簡単だ。将来は自動化も考えられる。
人の顔には、例えば建物の下隅の「タイル」にはない、内部で完結する意味上の論理がある。このため、Stable Diffusion の出力の粗い顔を拡大して再生成することは、現在でも非常に有効だ。

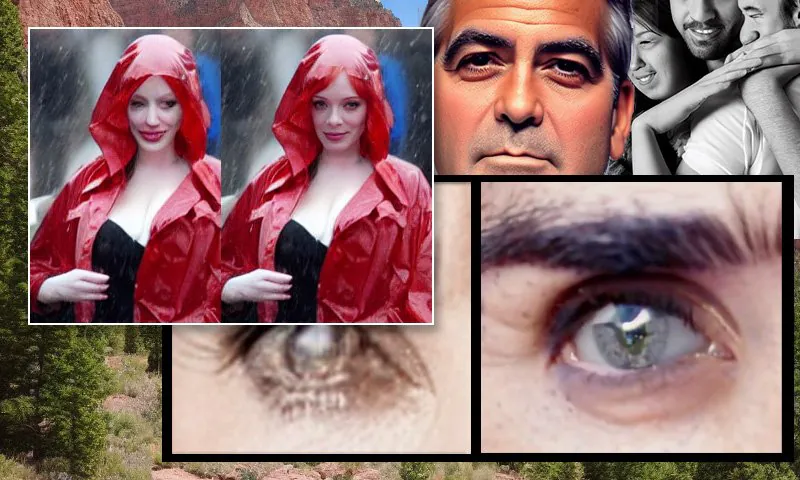
左:プロンプト ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ に対する Stable Diffusion の最初の試み。右:最初の生成のぼやけた粗い顔を Img2Img で再入力し、Stable Diffusion の注意を十分に与えて改善した顔(下のアニメーション画像を参照)。
専用の Textual Inversion 解決策がなければ(後述)、これは学習に使われた LAION の部分集合に十分な画像がある有名人でしか機能しない。Tom Cruise、Brad Pitt、Jennifer Lawrence など、元データに大量の写真がある限られた本物のメディア有名人が対象になる。
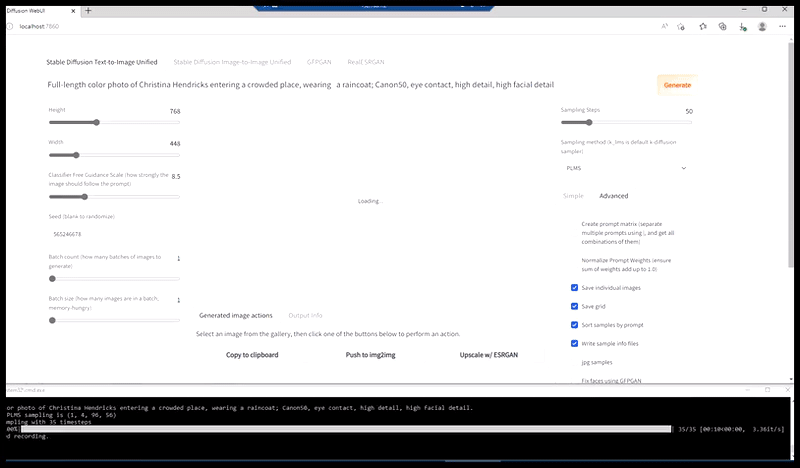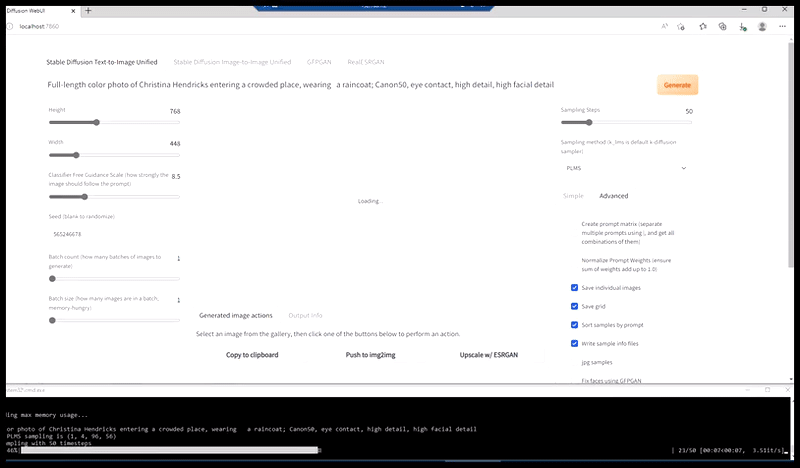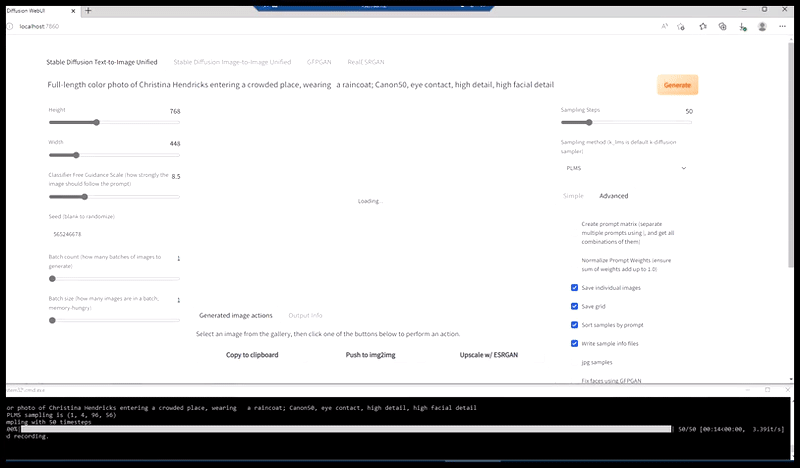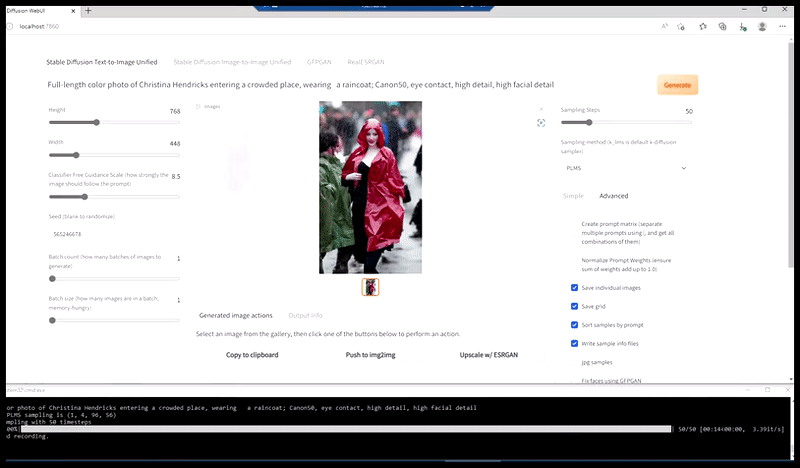
プロンプト ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ で、もっともらしい報道写真を生成する。
長く継続した経歴を持つ有名人では、Stable Diffusion は普通、最近の、つまり年齢の高い姿を生成する。若い見た目にはプロンプトに ‘young’ や ‘in the year [YEAR]’ といった語句を追加する必要がある。

著名で、多くの写真に残り、約40年の継続した経歴を持つ女優 Jennifer Connelly は、LAION で Stable Diffusion に幅広い年齢を表現させられる数少ない有名人の一人だ。出典:ローカルの構成済み Stable Diffusion、v1.4 チェックポイント、年齢関連プロンプト。
主な理由は、2000年代半ば以降に高価な乳剤式写真に代わってデジタル報道写真が普及し、後にブロードバンドの高速化で画像量が増えたことにある。
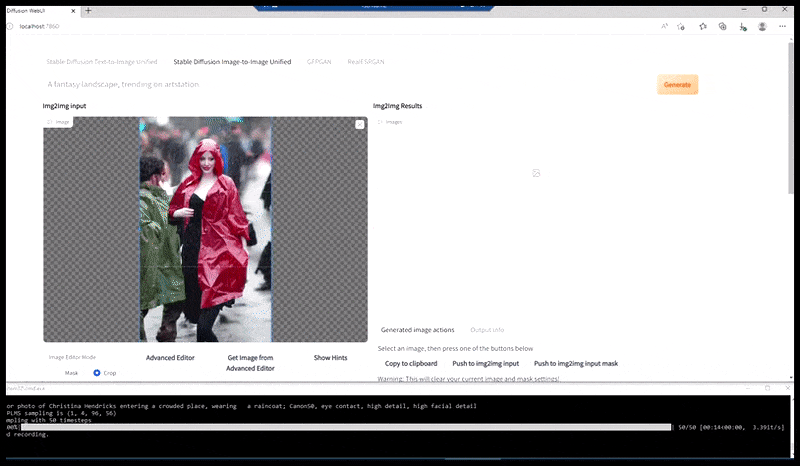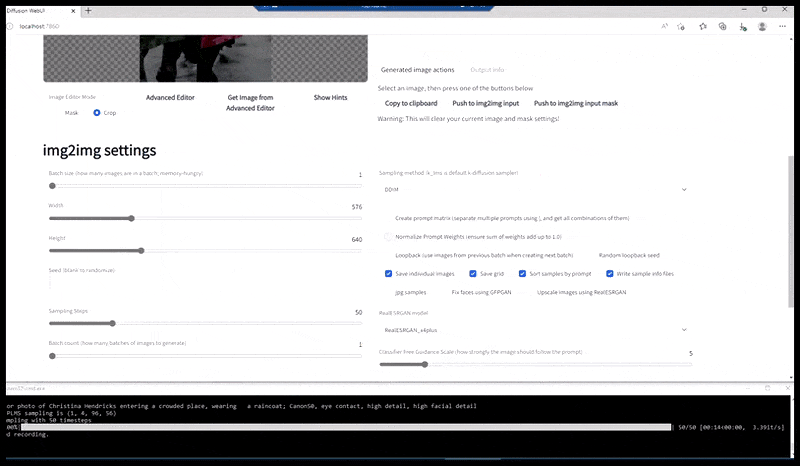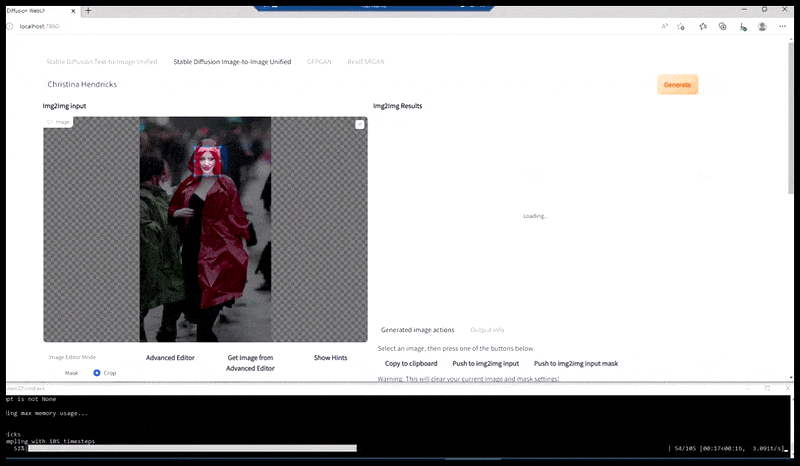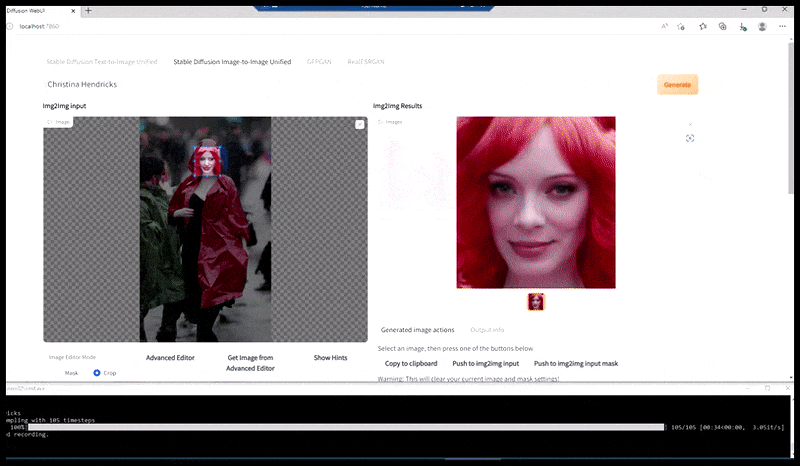
生成した画像を Stable Diffusion の Img2Img に渡し、「注目領域」を選ぶ。その領域だけを最大サイズで再生成することで、利用可能な資源をすべて顔の再構成に集中できる。
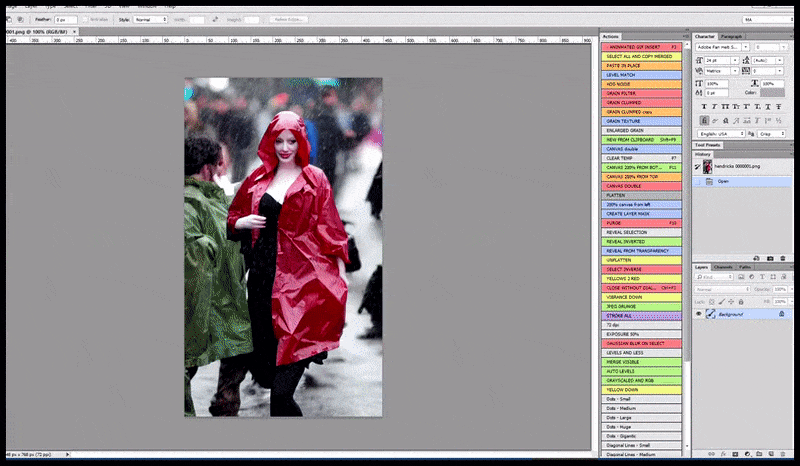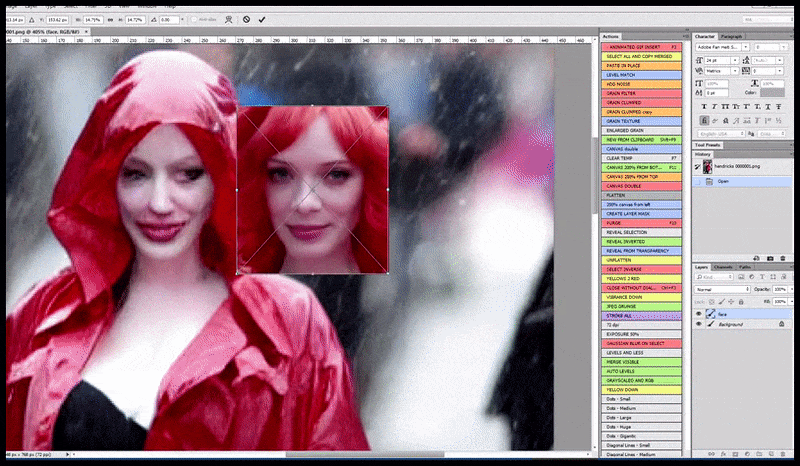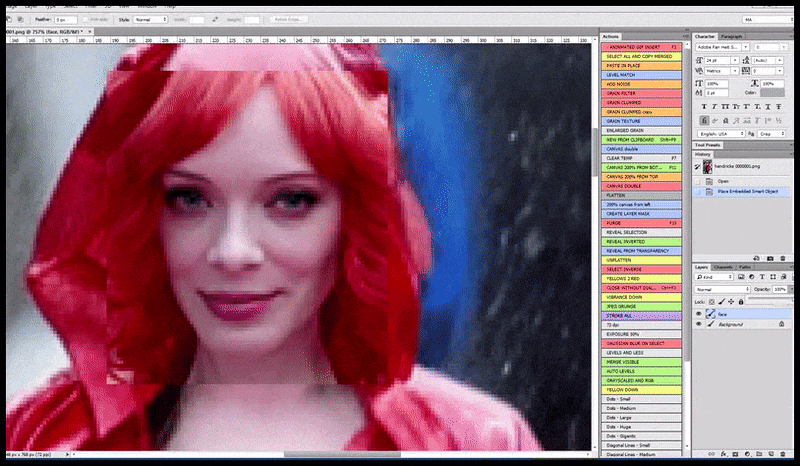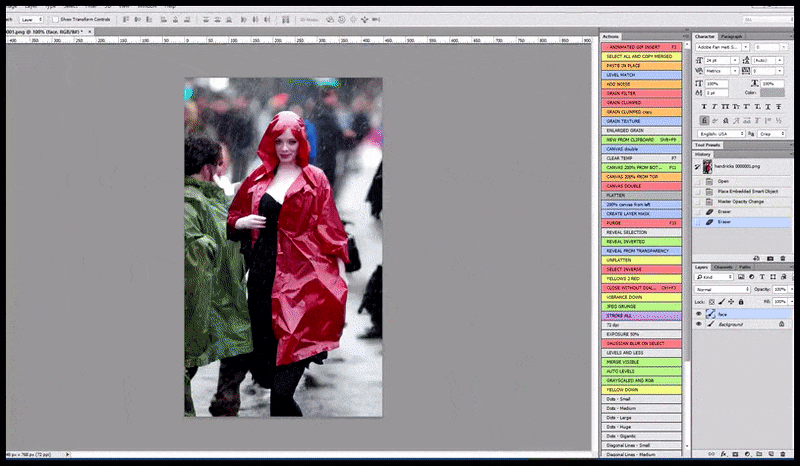
十分な注意で生成した顔を元の画像へ合成する。顔以外では、時計や車のように、元写真の一部に明確な物体があり、既知で一貫した全体像を持ち得る場合にしか機能しない。例えば壁の一部を拡大すると、組み直した壁は非常に奇妙になる。個々のタイルを生成するとき、その「パズルの一片」の広い文脈がなかったからだ。
データベースの有名人の中には、最初から特定の時代に「凍結」されている人がいる。Marilyn Monroe のように早く亡くなったか、短期間だけ大衆的な注目を浴び、その間に大量の画像ができたためだ。Stable Diffusion に問い合わせると、現代と昔のスターの一種の「現在の」人気指標になるともいえる。昔と今の一部の有名人は元データに十分な画像がなく、よく似た姿を作れない。一方、長く前に亡くなったり忘れられたりした特定のスターでも、根強い人気によって妥当な似姿を得られる。

Stable Diffusion の生成結果は、学習データにどの有名な顔が十分含まれるかをすぐ示す。執筆時に十代後半として非常に人気のあった Millie Bobby Brown も、LAION の元データがウェブから収集された当時はもっと若く無名だった。そのため現在、高品質でよく似た姿を作ることは難しい。
データがある場合、Stable Diffusion のタイル方式の拡大は顔全体への注目を超えられるかもしれない。顔の特徴を分解し、組み立てる前に一つずつ重要な特徴へローカル GPU の全能力を向ければ、さらに正確で細かな顔を作れる可能性がある。これも今は手作業だ。

これは顔だけではないが、元の物体の広い文脈の中で少なくとも同じほど予測可能な位置にあり、超大規模データセットで見つかると合理的に期待できる高水準の埋め込み表現に沿う部分に限られる。
真の限界はデータセット内の参照データ量である。深く反復された細部はいずれ完全に「幻覚」、つまり架空になり、真正性が下がる。
Jennifer Connelly でこうした精細な拡大がうまくいくのは、さまざまな年齢が LAION-aesthetics に豊富に含まれるからだ。これは LAION 5B のうち Stable Diffusion が使用する主要な部分集合であり、LAION 全体でも同様に豊富だ。他の多くの例ではデータ不足で精度が落ち、微調整、つまり追加学習(下の「カスタマイズ」参照)や Textual Inversion(後述)が必要になる。
タイルは Stable Diffusion に高解像度出力を可能にする強力で比較的安価な手法だ。しかし、より広く高水準の注意機構を欠くこの種のアルゴリズム的な拡大は、多様な内容で期待する水準に達しないかもしれない。
2:人間の四肢の問題に対処する
Stable Diffusion は、人の身体末端の複雑さを描くとき、名前ほど安定していない。手が無作為に増え、指が融合し、突然3本目の脚が現れ、既存の四肢が跡形もなく消える。ただし同種のモデルにも共通し、DALL-E 2 も間違いなく同じ問題を抱える。

2022年8月末の DALL-E 2 と Stable Diffusion(1.4)の未編集の結果。どちらも四肢の問題を示す。プロンプトは ‘A woman embracing a man’。
より集中的に学習され、パラメーターも改善した次の1.5チェックポイントで四肢の混乱が解消すると期待する Stable Diffusion ファンは、おそらく失望するだろう。新モデルは 約2週間後に公開予定で、現在 stability.ai の商用ポータル DreamStudioで先行提供されている。ここでは1.5が標準で使われ、新しい出力をローカルや他の1.4システムの生成結果と比較できる。

出典:ローカルの構成済み1.4パッケージと https://beta.dreamstudio.ai/

出典:ローカルの構成済み1.4パッケージと https://beta.dreamstudio.ai/

出典:ローカルの構成済み1.4パッケージと https://beta.dreamstudio.ai/
よくあるように、データ品質が主な原因である可能性がある。
Stable Diffusion や DALL-E 2 のような画像合成システムを支える公開データベースは、個人と人同士の行動の両方に多数のラベルを提供できる。ラベルは関連する画像や画像片と相互に結びついて学習される。

Stable Diffusion のユーザーは、LAION-aesthetics を検索してモデルが学習した概念を調べられる。これはシステムを支える大きな LAION 5B データセットの部分集合だ。画像はラベルのアルファベット順ではなく「美的スコア」で並ぶ。 出典:https://rom1504.github.io/clip-retrieval/
人の腕を描くための個別ラベルとクラスの 適切な階層 は、例えば次のようになる。 body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

手の各部分の精細な意味分割。この異例なほど詳しい分解でも、各「指」は単一の実体とされ、指の3つの節と親指の2つの節は考慮されていない。 出典:https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
実際には、データ全体の元画像にこれほど一貫した注釈があるとは考えにくい。教師なしラベル付けのアルゴリズムは、おそらく 上位 の「手」などで止まり、技術的には指の情報を含む内部ピクセルをラベルのない塊として残す。そこから特徴が任意に抽出され、後の生成で不自然な要素になることがある。

本来の姿(右上、アッパーカットでなければ)と、よくある姿(右下)。これはラベル付け資源の不足や、存在するラベルをモデル構造が活用する方法に由来する。
したがって潜在拡散モデルが腕を描ければ、その端に手を描こうとすることはほぼ確実だ。なぜなら arm>hand は最低限必要な階層であり、モデル構造の知る「人体解剖学」のかなり上位にあるからだ。
その先では「指」が最小のまとまりかもしれない。しかし手の描写には、指と親指のさらに14の部分を考慮する必要がある。
この説が正しければ、本当の解決策はない。手動注釈の予算が業界全体で足りず、低い誤り率でラベル付けを自動化できる十分に有効なアルゴリズムもないからだ。実際、モデルは今、学習データの欠点を覆うために人体構造の一貫性に頼っているのかもしれない。
それを 頼れない かもしれない理由が、最近 Stable Diffusion Discord で 提案 された。モデルにデータを供給する LAION 由来のデータベースには指の少ない漫画キャラクターが含まれ、現実的な人の手の指の数を混乱させる可能性があるのだ(これはそもそも 作業量を減らす近道である)。

Stable Diffusion や同種モデルの「指の欠損」問題の犯人候補となる2人のキャラクター。下はモデルを支える LAION-aesthetics の漫画の手の例。 出典:https://www.youtube.com/watch?v=0QZFQ3gbd6I
もしそうなら、明確な解決策は非現実的な人型コンテンツを除外して再学習し、本当に欠損がある場合、例えば切断障害者は適切に例外としてラベル付けすることだ。データ整備の観点だけでも大きな課題で、資源に乏しいコミュニティの取り組みには特に難しい。
もう一つは「指が3本/5本の手」のような内容が生成時に現れないようフィルターを適用することだ。これは OpenAI がある程度 フィルターをかけた GPT-3 や DALL-E 2と同様で、元モデルを再学習せずに出力を制御できる。

Stable Diffusion では指や四肢の意味的な区別さえ恐ろしく曖昧になることがあり、David Cronenberg のような監督による1980年代ホラー映画の「ボディホラー」の流れを思わせる。 出典:https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
しかし、やはり関連画像の全てに存在するとは限らないラベルが必要で、同じ管理と予算の課題が残る。
残された道は二つだといえる。問題にさらに多くのデータを投入することと、ここで述べた身体の誤りが最終利用者に示される際に介入できる第三者の解釈システムを使うことだ。少なくとも後者は、OpenAI にその意思があれば「ボディホラー」生成への返金方法を与える。
3:カスタマイズ
Stable Diffusion の将来で特に楽しみな可能性の一つは、ユーザーや組織が修正版システムを開発することだ。事前学習した LAION の範囲外の内容を取り込めるようになる。理想は、モデル全体を再学習する制御不能な費用や、成熟した既存モデルに大量の新しい画像を学習させる危険を伴わないことだ。
例えるなら、30人の上級クラスに能力の低い学生が2人加われば、適応して追いつくか、少数の例外として失敗するだろう。どちらでもクラスの平均成績は変わらない可能性が高い。しかし15人加われば、全体の成績分布が悪化しそうだ。
同じように、継続的で高価なモデル学習が築いた相乗的で繊細な関係網は、過剰な新データによって損なわれ、場合によっては実質的に破壊され、出力の質が全般に低下し得る。
こうする主な理由は、関係や物についてのモデルの概念的理解を完全に乗っ取り、追加した素材に似た内容だけを作るために専用化したい場合である。
そこで、既存の Stable Diffusion チェックポイントに50万フレームの Simpsons を学習させれば、最終的に元の版より良い Simpsons シミュレーターを得られそうだ。ただし十分に広い意味的な関係が残ることが条件となる。例えば Homer Simpson eating a hotdogには、追加素材になくても元のチェックポイントにはあるホットドッグの資料が必要かもしれない。また、突然 Simpsons の内容から fabulous landscape by Greg Rutkowski の生成に切り替えたくならないことも条件だ。追加学習後のモデルは注意が大きく別方向へ向き、以前ほどその仕事が得意でなくなるからだ。
著名な例が waifu-diffusionで、これは完成した学習済み Stable Diffusion チェックポイントに対して、 56,000枚のアニメ画像で追加学習 することに成功した。しかし愛好家には難しい。モデルは最低30GBもの VRAM を必要とし、NVIDIA の今後の40XXシリーズの消費者向けで提供されそうな量を大幅に上回る。

waifu-diffusion による Stable Diffusion への独自内容の学習。この水準のイラストを出すまでに2週間の追加学習を要した。左の6枚は、学習が進むにつれて、新データを基に主題に一貫性のある出力を作る能力が向上した様子を示す。 出典:https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
こうした Stable Diffusion チェックポイントの派生版には、多大な労力を投入した末に技術的負債に阻まれる可能性がある。公式 Discord の開発者は、将来のチェックポイントは必ずしも後方互換でなく、以前使えたプロンプトの論理さえ維持されるとは限らないと既に述べている。旧来のアプリや処理の支援より、最良のモデルを得ることが第一だからだ。
したがってチェックポイントを分岐して商用製品にする会社や個人には、事実上戻る道がない。そのモデルは「ハードフォーク」となり、stability.ai の後続版から上流の改良を取り込めなくなる。大きな覚悟が必要だ。
現在、Stable Diffusion のカスタマイズへのより大きな期待は Textual Inversionで、利用者は少数の CLIPに整合した画像で学習する。

テルアビブ大学と NVIDIA の共同研究である Textual Inversion は、元モデルの能力を壊さずに、個別の新しい実体を学習させられる。 出典:https://textual-inversion.github.io/
Textual Inversion の主な明白な制約は、ごく少数の画像、わずか5枚程度の利用が推奨されることだ。このため限定的な実体ができ、写真のようにリアルな物体の挿入より、スタイル転写に向いているかもしれない。
とはいえ、Stable Diffusion の各 Discord では、もっと多くの学習画像を使う実験が進んでいる。その生産性はまだ分からない。これも大量の VRAM、時間、忍耐を要する。
こうした制約から、愛好家による高度な Textual Inversion 実験を見るには少し待つ必要があるかもしれない。公式チェックポイントの驚くべき機能を保ちながら、Photoshop の切り貼りより良く「自分を写真に入れる」ことができるかも、確かめる必要がある。
2022年9月6日初出。


