
AIモデルとプラットフォーム
グラフニューラルネットワークと大規模言語モデルによるスーパーチャージ: 究極のガイド

 Unite.AI を Google の優先ソースに追加

要点大規模言語モデルは、テキスト属性付きグラフにおけるGNNの性能向上のため、拡張されたテキスト特徴を生成することができます。
もっと見る
- 大規模言語モデルは、テキスト属性付きグラフにおけるGNNの性能向上のため、拡張されたテキスト特徴を生成することができます。
- 知識グラフは、大規模言語モデルの幻覚を減少させ、事実に基づく推論を改善するために、その基盤を提供することができます。
- 大規模言語モデルは、構造に関する自然言語プロンプトからの予測を通じて、少数ショットグラフ学習を可能にします。
グラフは、ソーシャルネットワーク、ナレッジベース、生物システムなど、幅広いドメインで複雑な関係を表現するデータ構造です。これらのグラフでは、エンティティはノードとして表現され、その関係はエッジとして表現されます。
これらの複雑な関係構造を効果的に表現し、推論する能力は、ネットワーク科学、ケミインフォマティクス、レコメンダーシステムなどの分野の進歩を可能にするために不可欠です。
グラフニューラルネットワーク(GNN)は、グラフマシンラーニングタスクのための強力なディープラーニングフレームワークとして登場しました。グラフトポロジーを近傍集約またはグラフ畳み込みを通じてニューラルネットワークアーキテクチャに組み込むことで、GNNはノードの特徴と構造的役割の両方を符号化する低次元ベクトル表現を学習できます。これにより、GNNはノード分類、リンク予測、グラフ分類などのタスクで最先端のパフォーマンスを達成できます。
GNNは大きな進歩を遂げましたが、いくつかの重要な課題が残っています。高品質のラベル付きデータを取得することは、監視付きGNNモデルをトレーニングするために時間がかかり、高価になる可能性があります。また、GNNは、グラフ構造が異なる場合や、テスト時のグラフ分布がトレーニングデータと大きく異なる場合(出現分布外の一般化)に苦労することがあります。
一方で、大規模言語モデル(LLM) seperti GPT-4やLLaMAは、自然言語の理解と生成能力で世界を驚かせています。これらのモデルは、数十億のパラメータを持つ巨大なテキストコーパスでトレーニングされており、数ショット学習、タスク間の一般化、コモンセンス推論能力が優れています。
LLMの驚くべき成功は、グラフマシンラーニングタスクにその力を活かすための探索を刺激しています。グラフニューラルネットワークとLLMの統合は、グラフマシンラーニングの新しい可能性を解放することができます。
グラフニューラルネットワークと自己教師あり学習
必要な背景を提供するために、グラフニューラルネットワークと自己教師ありグラフ表現学習の核心概念と方法を簡単にレビューします。
グラフニューラルネットワークアーキテクチャ

グラフニューラルネットワークアーキテクチャ – ソース
伝統的なディープニューラルネットワークとGNNの主な違いは、GNNがグラフ構造化データを直接操作できることです。GNNは近傍集約スキームに従い、各ノードは隣接ノードからの特徴ベクトルを集約して自身の表現を計算します。
さまざまなGNNアーキテクチャが提案されており、メッセージと更新関数の異なるインスタンスが提供されています。例として、グラフ畳み込みネットワーク(GCN)、GraphSAGE、グラフ注意ネットワーク(GAT)、グラフ同型ネットワーク(GIN)などがあります。
最近では、グラフトランスフォーマーがグラフ構造化データで自己注意メカニズムを適用することで人気を博しています。例として、GraphormerTransformerやGraphFormersがあります。これらのモデルは、純粋に近傍ベースのGNNよりもグラフ内の長距離依存関係をより良く捉えることができます。
グラフでの自己教師あり学習
GNNは強力な表現モデルですが、そのパフォーマンスは、監視付きトレーニングに必要な大規模なラベル付きデータセットの欠如によって制限されることがよくあります。自己教師あり学習は、GNNをラベルなしグラフデータで事前トレーニングするための有望なパラダイムとして登場しました。

自己教師ありグラフ – ソース
GNNの事前トレーニングに使用される一般的な事前タスクには、以下のものがあります。
- ノードプロパティ予測: ノード属性の一部をランダムにマスクまたは破損させ、GNNにそれらを再構築するタスク。
- エッジ/リンク予測: ノードのペア間のエッジの存在を予測するタスク、通常はランダムなエッジマスクに基づいています。
- 対比学習: 同じグラフのさまざまなビュー間の類似性を最大化し、異なるグラフのビュー間の類似性を最小化するタスク。
- 相互情報量の最大化: ローカルノード表現と、グローバルグラフ埋め込みなどのターゲット表現との間の相互情報量を最大化するタスク。
これらの事前タスクにより、GNNはラベルなしグラフデータから有意義な構造的および意味的パターンを抽出できます。事前トレーニングされたGNNは、比較的小規模なラベル付きサブセットでファインチューニングすることで、ノード分類、リンク予測、グラフ分類などのダウンストリームタスクで優れたパフォーマンスを発揮できます。
自己教師あり学習により、GNNはより優れた一般化、ロバスト性、効率性を実現しますが、従来のGNNベースの自己教師あり方法にはいくつかの限界があります。これらの限界をLLMを使用して解決する方法を次に探ります。
大規模言語モデルによるグラフマシンラーニングの強化
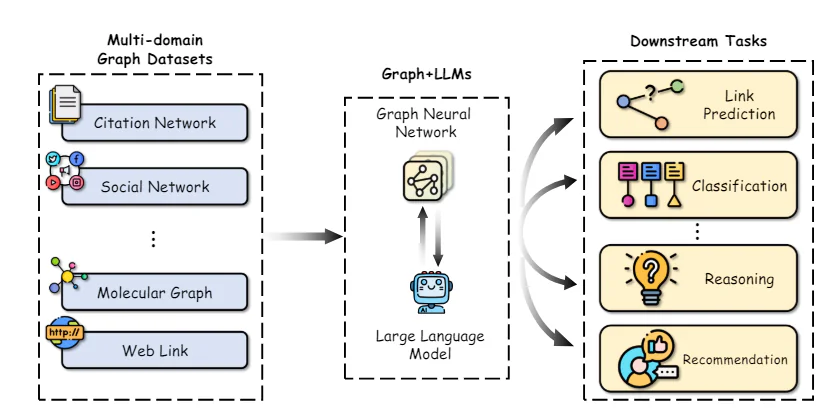
グラフとLLMの統合 – ソース
LLMの自然言語の理解、推論、数ショット学習能力は、グラフマシンラーニングパイプラインのさまざまな側面を強化する機会を提供します。この分野のいくつかの研究方向を探ります。
GNNを適用する際の重要な課題は、ノードとエッジの高品質の特徴表現を取得することです。特に、ノードとエッジが豊富なテキスト属性(説明、タイトル、要約など)を含む場合にそうです。従来的には、単純なバッグオブワーズまたは事前トレーニング済みのワードエンベディングモデルが使用されましたが、これらは繊細な意味を捉えることができません。
最近の研究では、LLMをテキストエンコーダーとして使用して、GNNに渡される前にノード/エッジの特徴表現を改善することを示しています。例として、Chen et al.は、GPT-3などのLLMを使用してテキストノード属性をエンコードし、伝統的なワードエンベディングよりもノード分類タスクで大きなパフォーマンスの向上を示しています。
テキストエンコーダーとしてのLLMの使用を超えて、LLMはノードとエッジのテキスト属性から半教師ありの方法で追加情報を生成するために使用できます。例として、TAPEは、LLMを使用してノードの説明/ラベルを生成し、これをGNNの追加特徴として使用します。
LLMを使用することで、GNNは自然言語の理解能力を向上させることができ、ダウンストリームタスクのパフォーマンスが向上します。








