
インタビュー
ピオトル・トマシク、TensorWave共同創設者兼会長 – インタビュー・シリーズ

 Unite.AI を Google の優先ソースに追加
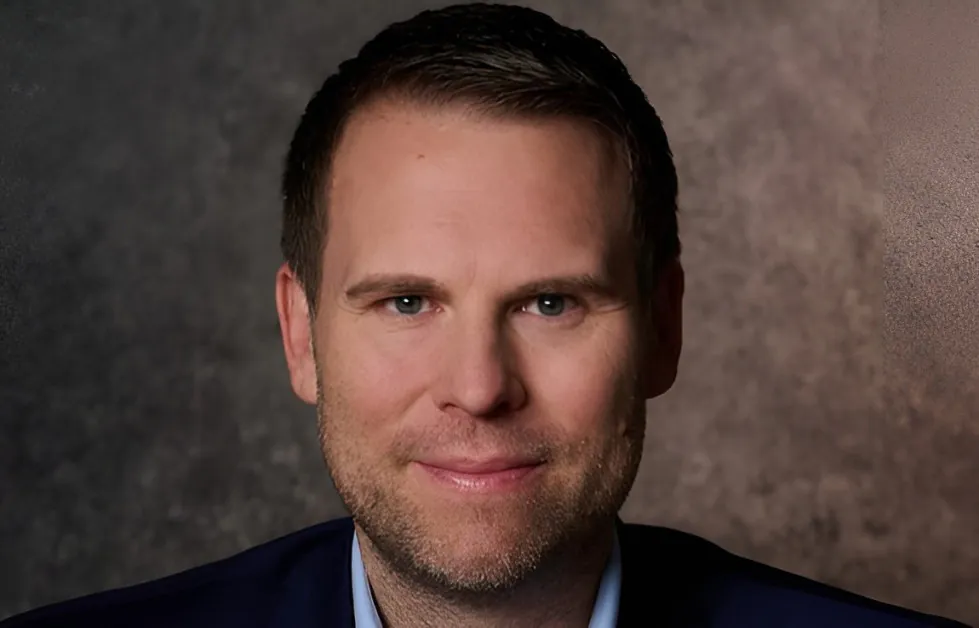
ピオトル・トマシク、TensorWave共同創設者兼会長は、AI、SaaS、クラウドコンピューティング、フィンテック、クリエイター経済を含む分野で20年以上の経験を持つベテラン技術起業家であり、AIインフラストラクチャーのエグゼクティブです。TensorWaveを共同創設する前、彼はInfluentialを共同創設し、パブリシスに約5億ドルで買収されました。そこではCTOを務め、後にアドバイザーの役割に移りました。
彼のキャリアの中で、トマシクはLets Rolo、On Guard Data、ActiveSideを創設または率いてきました。また、CARD.comとMarker Traxではシニアテクノロジー担当者を務めてきました。運営役割に加えて、1864ファンドのジェネラルパートナーであり、StartUp Vegasの共同創設者でもあり、ラスベガスのスタートアップエコシステムと新興テクノロジー人材を積極的に支援しています。UNLVコンピューターサイエンスの卒業生であり、認められたテクノロジーリーダーであるトマシクは、TensorWaveを急成長しているAIコンピュートインフラストラクチャー会社として位置付け、AMDアクセラレータを搭載した大規模GPUクラウドプラットフォームに焦点を当てています。
TensorWaveは、AMD GPUを搭載した高性能クラウドコンピューティングを提供するAIインフラストラクチャー会社であり、より閉じたAIエコシステムの代替として位置付けられています。2023年に創設され、ラスベガスに本社を置く同社は、AIモデルをトレーニングおよびデプロイするために最適化された大規模GPUクラスターを構築しており、パフォーマンス、柔軟性、コスト効率に重点を置いています。オープンなハードウェアとソフトウェアエコシステムを活用することで、TensorWaveは、企業、研究者、開発者が従来のベンダーロックインの制限なしにスケーラブルなAIワークロードを実現できるように、強力なAIコンピュートリソースへのアクセスを拡大することを目指しています。
NVIDIA (NVDA ) はほとんどのGPU市場を支配していますが、AMDに全力を注ぐことを決めた理由は何ですか?また、その選択によってTensorWaveとその顧客にどのような利点がありますか?
ChatGPTの発売により、AIの需要が急激に高まり、GPUがすぐに売り切れ、NVIDIAはほぼ唯一の選択肢でしたが、コストが高かったため、不足が起こりました。その不足は代替手段への大きな関心を引き起こしました。初期のハイプが過ぎ去った今、NVIDIAの支配を挑戦する機会があります。
スタートアップとして、 हमは強い焦点と目的を持ってビジネス上の決定を下してきました。NVIDIAを試験的に使用せずに、AMDの機能を構築し続けてきました。私たちの会社の次の段階は、AIで何か意味のあることを行うために、誰でも簡単に参加できるようにすることです。AMDは、信頼できる代替手段であり、実際の製造スケール、オープンなソフトウェア姿勢、モダンAIのためのメモリファーストロードマップを持っています。
TensorWaveのAIインフラストラクチャーへのアプローチは、従来のGPUクラウドプロバイダーとどのように異なりますか?
私たちの違いは明確です。私たちは大規模なAMD専用クラウドであり、AIコンピュートにおける選択肢を回復し、NVIDIAの支配を打ち破り、AIへのアクセスを民主化することを目指しています。しかし、それは私たちのエートスと、真の代替手段を市場に提供するという私たちのコミットメントについても言えることです。まず第一に、優れたAMDベースのインフラストラクチャーを提供したいと思います。その上に、モデル・アズ・ア・サービス、AI・アズ・ア・サービスなどのトップティアサービスを展開し、すべてを簡単にします。
AMD専用クラウドとして、AMD専用のソフトウェアエクスペリエンスを最初から持っています。この焦点により、シリコン、ネットワーク、ソフトウェアのエンドツーエンド最適化が可能になり、チームが必要に応じてスケールできます。
TensorWaveの成長と差別化におけるAMDとの戦略的パートナーシップの役割は何ですか?
それは基盤的なものです。AMDはTensorWaveに投資し、MI300X Instinctの発売に私たちを招待し、ハードウェア、ソフトウェアの有効化、エコシステムの成長について密接に協力しています。AMD専用クラウドであるということは、各Instinct世代で迅速に動作し、市場内の代替手段を大規模に提供することができます。私たちのAMD専用の差別化により、AIインフラストラクチャー市場で達成できないペースで動作できます。彼らのパートナーシップにより、ギャップを迅速に埋め、最新のGPUで最初に出荷し、大規模なパフォーマンスを公開できます。
GPUへのアクセスはAIチームにとって大きなボトルネックのままです。TensorWaveはこの課題にどのように対処していますか?
私たちは、供給の独立性を通じてこれらのボトルネックに取り組んでいます。AMDを構築することで、他のチップメーカーの供給制限の最悪の影響を回避し、利用可能性を顧客に提供します。AMDを通じた供給の独立性により、顧客は他のすべての人が待っているのと同じキューに待たされることはありません。
AIインフラストラクチャーエコシステムのギャップは、多くのプレイヤーが類似のソリューションを構築しているため、重複が生じていることが原因です。これは、市場全体で何が起こっているかについての認識不足から生じます。ギャップを埋める第一歩は、誰が何をしているか、協力の機会があるどこか、競争がイノベーションを駆り立てるどこか、最終的にエコシステムが全体としてどのように改善できるかを理解することです。AIインフラストラクチャー市場には、電力というユニークなギャップがあります。GPUが利用可能であっても、AIアプリケーションの増加に十分なエネルギーがなければなりません。これらのリソースの課題を解決することは、将来の持続可能な成長とイノベーションを可能にするための重要な鍵です。
ダイレクトリキッドクーリングやUEC準拠ネットワーク(Universal Ethernet Consortium)などの機能は、パフォーマンスとコスト効率をどのように向上させますか?
ダイレクトリキッドクーリングとUEC準拠ネットワークは、現代のAIクラウドが経済的に実行可能なスケールで設計される上で基盤的なものです。
ダイレクトリキッドクーリングについて:最新のアクセラレータ世代、AMDのMI355XとMI455Xは、1400W以上のTDPで動作し、空気だけでは効率的に熱を処理できないです。私たちは冷却プレートまたは浸没設計を使用して熱源からの熱を除去し、顧客に3つの利点を提供します。第一に、ラック密度を大幅に高めることができます。30〜40kWではなく、120〜300kW以上のラック密度を実現できます。これにより、フットプリントが圧縮され、メガワットあたりの不動産と電力配布コストが削減されます。第二に、PUE(パワーアシストエフィシエンシーラティオ)を1.1に向上させることができます。1.4〜1.5のレガシーエアクーリング施設と比較して、当社のスケールでは年間の公益費が数千万ドル削減されます。第三に、シリコンを低温で安定したジャンクション温度に保つことができます。これは、長時間のトレーニング中に持続的なクロックレートを維持し、ハードウェアの有効期間を延ばすために非常に重要です。これは、6年間の資産を保証する場合に特に重要です。
UECについて:Ultra Ethernet Consortiumの仕様は、AMDが共同創設し、2025年に1.0に到達したもので、実際に重要なメトリクスでInfiniBandに匹敵する、またはそれを上回るオープンなマーチャントシリコンファブリックを提供します。コレクティブのテールレイテンシ、コンテンション下での有効帯域幅、10万個を超えるGPUのスケーリング動作についてです。コストの話は構造的なものです。イーサネットには、価格で競合する半ダースの信頼できるマーチャントシリコンベンダーが存在します。一方、代替手段には、明確なプレミアムが付いています。100MWのサイトでは、UEC準拠ネットワークを選択することは、通常、9桁のCAPEXの決定です。また、運用上の利点も複合して、ネットワークエンジニアは既にイーサネットを知っているためです。
これらの選択肢を組み合わせることで、レガシークラウドよりも優れたトレーニングエコノミーを提供できます。顧客は、1ドルあたりの有効FLOPSが高く、予測可能なステップ時間が短く、モデルのスケールに合わせて明確な実行可能な道筋が見えるようになります。私たちにとって、これらはより防御可能なコスト構造と、真正に競争力のあるレートカードを提供するための柔軟性を意味します。
TensorWaveを使用して大規模なAIモデルをトレーニングする顧客の例を共有できますか?
TensorWaveの顧客は、GPUの不足、ベンダーロックイン、またはコストの暴走なしに、高性能AIコンピュートを必要とします。TensorWaveは、オープンでメモリ最適化された、プロダクションレディなAMD GPU専用クラウドを提供し、チームはアクセス可能で柔軟でコスト効率の良いスケーラブルAIインフラストラクチャーを利用できます。
例えば、Modularは、TensorWaveのAMD GPUインフラストラクチャー上でMAX推論スタックを実行することを選択しました。TensorWaveは、大規模なAI推論のコストパフォーマンスを大幅に改善します。ModularのMAXをTensorWaveのAMDコンピュートで実行することで、顧客は1百万トークンあたりのコストを70%削減し、スループットを57%向上させ、他のGPUスタックよりも全体的なコストを削減できます。
NVIDIAの継続的な支配の下で、TensorWaveのような挑戦者にとって最大の機会はどこにありますか?
AIコンピュートのスペースが数人の大きなプレイヤーによって支配されている場合、最大の課題は市場へのスピード、最新のテクノロジーの提供、優れたサポートの提供です。ハイパースケーラーは幅広い選択肢を提供しますが、顧客が必要とする焦点やパーソナライズされたガイダンスを提供するのに苦労することがあります。NVIDIAの支配的なスペースを突破するために、TensorWaveは強みに焦点を当て、最良のテクノロジーを提供するために協力し、顧客が代替の選択肢を持っていることを確認します。
TensorWaveのようなNVIDIAのAIインフラストラクチャー支配に対する挑戦者の最大の機会は、オープンエコシステムとメモリです。オープンエコシステムは、ハードウェア、インターコネクト、ソフトウェアのすべてのレイヤーでロックインを排除します。さらに、メモリとネットワーク最適化トレーニング/推論はコスト曲線を反転させます。
5年先を見て、AIインフラストラクチャーの未来とTensorWaveの役割をどのように見ていますか?
AIインフラストラクチャーにおける目標は、良いもの、安定したもの、使いやすいものを作ることでした。次の段階は、それらを提供することの上に何を提供できるかについてです。マネージドサービス、AIアズアサービス、顧客がより簡単にデプロイしてスケールできるものなどです。
私たちは大きな変化の始まりにあります。AIテクノロジーは進化を続け、AMDのような代替手段はより実行可能になってきています。そうなるにつれて、顧客はそれらを大規模にデプロイすることに慣れ、全体のエコシステムが成長し始めます。
素晴らしいインタビュー、ありがとうございます。詳しく知りたい方は、TensorWaveを訪問してください。


