
インタビュー
オープンオリジンズのMathilde Pavis博士、法務責任者 – インタビュー・シリーズ

 Unite.AI を Google の優先ソースに追加
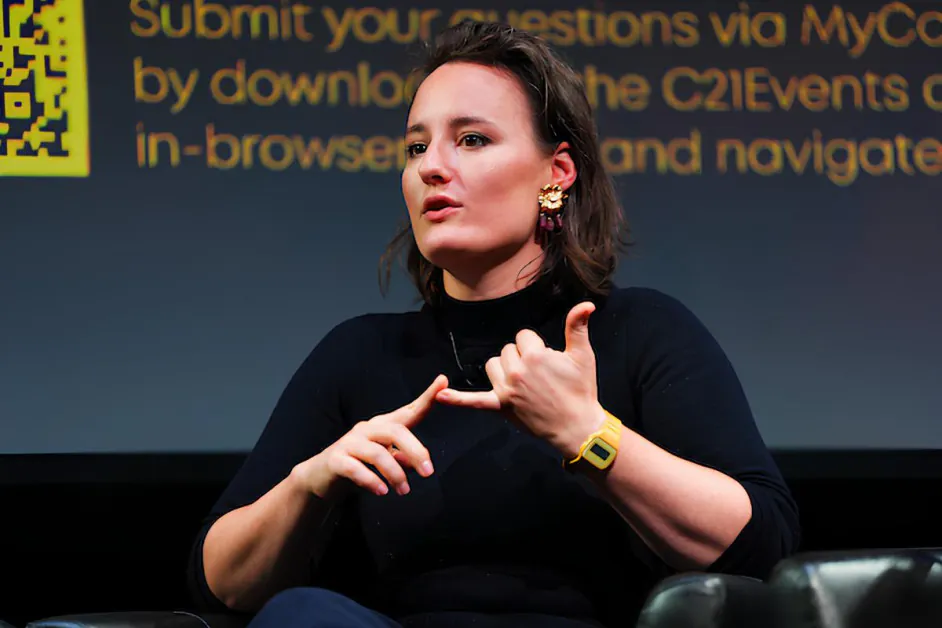
Mathilde Pavis博士は、オープンオリジンズの法務責任者であり、AI規制とデジタルメディアのガバナンスの分野で先駆的な専門家です。彼女は、ディープフェイク、合成メディア、コンテンツの出典について専門知識を持ち、企業、政府、労働組合にコンプライアンス、ライセンス、リスクについてアドバイスしています。また、Microsoft (MSFT ) とElevenLabsとのAIポリシーと戦略についても協力しています。さらに、ユネスコにもAIと知的財産についてアドバイスし、イギリスの政策立案者に専門家としての証言を提供しています。
OpenOriginsは、デジタルコンテンツの出典を検証するテクノロジーを開発し、誤情報とディープフェイクに対抗しています。同社のプラットフォームは、コンテンツの出典を明確に確立し、メディア、クリエイター、プラットフォームがコンテンツの作成、編集、配布の時期と方法を証明できるようにします。これは、合成メディアがより高度で検出が難しくなっている現在、ますます重要な機能となっています。
あなたは政府、国際機関、企業にAI規制についてアドバイスしています。ディープフェイク、デジタルレプリカ、合成メディアに特に焦点を当てた理由と、その旅がRepliqueを設立する決断にどのように影響したかについてお話しください。
私のディープフェイクに関する研究は、技術から始まるところではありません。2013年に知的財産についての博士論文の研究を始めたとき、私はパフォーマーが著者、作曲家、映画製作者よりも法的保護を受けにくいことに気づきました。実践的には、言葉や音楽は法的に保護される一方で、声、顔、身体は保護されないということです。この不均衡は私に疑問を持ち、パフォーマーの仕事の価値を文化的、法的にどのように見るべきかという問いを促しました。
その問いが私をパフォーマーの権利とデータの研究に導きました。当時、商業的に無関係なニッチな分野と見なされていました。私は、特許や従来の著作権のようなより「儲かる」分野に移ることを勧められました。しかし、私にはそのギャップが研究の終わりではなかったと感じました。そこで、私はそのテーマを追求し続けました。
現在、ほとんどの人がパフォーマーです。私たちはカメラを通じて生活しています。仕事や個人的な使用に関係なく、人々は常に自分自身のバージョンを記録し、共有しています。以前は主に俳優やミュージシャンに適用されていた法的質問が、スマートフォンを持つ誰でも適用されるようになりました。
ディープフェイクはこれらの問題を生み出さなかったですが、それを露呈し、加速させました。2013年から行っていた研究が、2017年、2018年頃に急速に重要性を増しました。MITやUCバークレーのような場所から出てきたニューラルネットワークの進歩は、人の顔、声、身体をどれだけ信憑性を持ってデジタルに操作できるかを示しました。1年以内に、その能力は「ディープフェイク」として広く知られるようになり、特に非同意的な性的なコンテンツを通じて有害な方法で最初に注目されました。
その後、商業的影響が現れ、クリエイティブ業界が合成メディアを採用し始めました。そこで、私が取り組んでいた契約上の経済的質問が表面化しました。ほぼ一夜にして、法的分野は理論的、学術的なものから、実践的、商業的に重要な分野に変わりました。
法的な課題の核は変わりません。人々は自分自身の側面を共有したいですが、同時に意味のある制御を維持したいと望んでいます。既存の枠組みはそのニュアンスに苦労しています。個人が完全にプライベートか、完全にパブリックかのどちらかとして扱う傾向があります。しかし、ほとんどの人はその中間にあるのです。現在、プロのパフォーマーだけでなく、デジタル生活に参加する誰にとっても、その緊張は中心的なものとなっています。
私はこの分野で研究し、仕事をしてきたので、政府や企業と協力する機会を得ました。Repliqueでは、私が学んだことを、デジタルクローニングやデジタルレプリカ技術を責任を持って安全に使用したい人々や企業に提供しています。基本的に、私の「青空」研究を、クリエイティブ業界に専門の法的アドバイスを提供するビジネスに変えました。
オープンオリジンズの法務責任者として、コンテンツの出典を検証する不変のレコードを確立することに焦点を当てています。出典ベースのシステムは、従来のディープフェイク検出アプローチとどのように競合または置き換わる可能性がありますか?
ディープフェイク検出ツールを比較することは、すぐにリンゴとオレンジの比較になることがあります。なぜなら、その有効性はコンテキストと目的によって決まるからです。政策的観点から、私たちが必要とするのは、補完的なツールの範囲です。1つの「最善」の解決策はありません。OpenOriginsは、そのより広いエコシステムの1部です。OpenOriginsの技術がディープフェイク検出解決策として際立っているのは、コンテンツクリエイターまたは情報組織がパートナー、聴衆、または一般大衆と共有するコンテンツの真実性を証明する必要がある状況です。
作成時に検証可能な出典と「レシート」を提供することで、強力な予防形態を提供し、コンテンツがディープフェイクではないことを証明します。しかし、このアプローチは、オンラインでコンテンツを迅速に評価したい一般のインターネットユーザーにとっては、最も役立つものではありません。そうした場合、検出は、出典ベースの検証ではなく、確率的でコンテンツ分析に基づく方法に依存します。さまざまなニーズに対してさまざまなツールが必要であり、銀の弾丸はないことを受け入れる必要があります。
法的な観点から、AI生成またはAI複製コンテンツにおける同意と所有権の取り扱いにおいて、管轄区域が取り組むべき最大のギャップは何ですか?
お時間がありますか?答えは、AI生成または複製コンテンツの種類によって異なります。問題は、AI生成画像や猫の画像、または人の顔や声のデジタル再現の場合など、さまざまです。ディープフェイクやデジタルレプリカのトピックに集中し、「デジタルクローニング」の文脈で質問に答えましょう。
同意について、主な問題は、ほとんどの契約(雇用契約やプラットフォームの条件)が、ユーザーコンテンツに対する広範で漠然とした条項を含んでいることです。これらは、クローニングのような使用を含む広範な権利の付与とみなされる可能性があります。多くの人はその解釈に強く異議を唱えるでしょう。これにより、法的解釈とユーザーの期待の間に大きなギャップが生じ、現在、企業が利益を得ている一方で、規制は遅れています。
所有権については、ディープフェイクやデジタルレプリカの所有者が誰であるかについて、明確な法的答えはありません。なぜなら、データ保護、著作権、人格権などの既存の枠組みは、この技術に対応するように設計されていないからです。今日、ほとんどの人は仕事で、雇用主またはクライアントの要求と資金提供によりスキャンされ、クローニングされます。そうしたエンティティは、通常、コンテンツに対する高いレベルの管理を期待しますが、問題となるのは、そのアセットがあなたの顔や声のデジタル模倣であり、実際には言ったことやしたこととは異なることを言うことも、することもできるからです。
「あなたのクローンは誰が所有するのか?」という質問は非常に重要ですが、現在、法律では答えられていません。
ボイスクローニング技術に密接に取り組んでいます。合成音声の法的リスクについて、企業と個人の両方で最も誤解されている点は何ですか?
法的コンプライアンスにおける最も誤解されている問題は、企業のデジタルクローンの資金提供と活用に対する商業的利益と、個人のプライバシーとデジタル尊厳の権利のバランスです。この緊張は、知的財産、データ保護、プライバシーの法的枠組みにわたって存在し、これらの枠組みはクローニングを根本的に異なる方法で解釈します。したがって、これを実行可能でビジネスに優しい慣行に翻訳することは複雑で、しばしば曖昧です。企業はしたがって、主要なリスクを無視するか、適切に航行するために重大なコストを負担します。その結果、責任あるコンプライアンスは、デフォルトではなく、より困難で高価な道になります。
企業は、特に類似性、アイデンティティ、トレーニングデータに関して、AIシステムにおける同意アーキテクチャについてどのように考えるべきですか?
企業は、3つの核心能力を設計する必要があります。まず、オンボーディング時に情報に基づいた、コンテキストに応じた同意を確保する必要があります。2番目に、ユーザーがその同意を取り消し、一部またはすべてのデータを削除できるようにする必要があります。これは技術的に困難で、しばしば見落とされるものですが、UKおよびEUのGDPRなどの法律や米国の同様の規制へのコンプライアンスに不可欠です。同意を維持することは、ビジネスモデルと一致するようにシステムを構築することを意味します。
同意はグラニュラーでなければなりません。3番目に、ユーザーは個々のファイル、類似性データの更新、そしてその使用方法を管理できる必要があります。これには、透明性とコントロールが必要です。ユーザーがデジタルクローンの展開を監視、レビュー、モデレートできるツールが必要です。このレベルの柔軟性はまだまれですが、競争上の優位性が増す場所です。
スタートアップと政府の両方にアドバイスしているあなたの経験から、AIの構築と規制の間で最大の断絶はどこにあると思いますか?
AIの構築と規制の間の断絶は、根本的に異なるミッションに起因します。政府は公共の利益のために規制しますが、AI企業(多くの場合、ベンチャー資本によって支援される)は、成長、収益、利益によって推進されます。これらの優先事項は常に衝突するわけではありませんが、頻繁に異なる方向に引っ張られ、規制は制約と見なされることがあります。
これにより、構造的な緊張が生じます。規制当局とイノベーターは、異なるインセンティブ、価値観、そして言語で動いています。これにより、実践では調整が困難になります。技術企業が公共の利益の目標とより密接に一致するようになる新しい波は始まっていますが、それらはまだ例外であり、特に成功した企業の中ではそうです。
オープンオリジンズは、暗号化された出典を使用してコンテンツの作成時に検証を行います。このアプローチは、配布後の安全対策と比較してどれだけ重要ですか?
これは先ほどの答えに戻ります。コンテンツを作成時に検証することは、「上流」で行うよりも、「下流」で行うよりもはるかに効果的です。コンテンツを作成時に検証することは、食品を農場で栽培されたときから追跡することと似ています。食品がどのように扱われ、供給チェーンを通じてどのように移動したかを知ることができると、食べ物が何であるかを信頼できます。ただし、完成した料理を見て、それがどのように作られたかを推測する場合、推測に頼ることになります。オンラインでの人間が作成したコンテンツとAIが生成したコンテンツを区別する場合も同じです。出典を使用すると、検証可能な保証が得られますが、下流の検出はより不確実で反応的です。
C2PAのような規格は、メディアの未来にどのような役割を果たすと思いますか? それらは単独でオンラインでの信頼を回復するのに十分ですか?
C2PAは歓迎される取り組みであり、オープンオリジンズと同様にコンテンツの真実性の運動を支持しています。コンテンツの安全性と真実性のエコシステムの重要な部分です。ただし、サイバーセキュリティツールと同様に、銀の弾丸ではありません。
映画、音楽、ゲームなどの業界のクリエイターとタレントは、未承認のデジタルレプリカから自分自身を保護するために、今日何をするべきですか?
アーティストは2つの異なるリスクに直面しています。彼らの作品(音楽、画像、文章など)の複製と、彼らの類似性(顔、声、身体)の複製です。AIシステムはこれらを高い精度で再現できます。実用的には、オンラインで何を共有するかを意図的に選択することから始めます。投稿されたコンテンツは、同意や可視性なしにスクラップされ、トレーニングデータセットに使用される可能性があることを認識する必要があります。
そのリスクは、オンラインで活動する現実です。しかし、より即時のリスクはしばしば契約にあります。アーティストがコラボレーター、配給者、またはプラットフォームと結ぶ契約は、AIの使用、再使用、またはコンテンツのトレーニング目的の再販売を許可する条項を含むことがあります。アーティストにとって、契約の調査は重要です。彼らの作品と類似性がどのように使用され、ライセンスされ、または再利用されるかを理解することは、創作プロセスと同等に重要です。
現在の議論(組合、業界団体、プラットフォームを通じて)は、クリエイターが管理と公正な補償を維持することを保証する不均衡を是正することです。したがって、2つの重要なアドバイスがあります。オンラインで共有するものに注意し、AI関連の条項を含む契約を慎重に読んでから署名してください。
3~5年先を見て、デジタルコンテンツのすべてに検証可能な出典が付与される時期が訪れると思いますか? それとも、信頼はプラットフォームや管轄区域に分散したままになるでしょうか?
はいと言いたいですが、現実的に見て、5年以内にはそうはならないと思います。テクノロジーでは5年は長い期間ですが、ユーザーの行動や習慣を変えるには非常に短い期間です。ほとんどの消費者は、コンテンツが検証された出典を持っているかどうかによって決定を下すことはありません。プラットフォームは、エンゲージメントを優先して、出典よりも優先します。
規制が介入すれば、状況は変化するかもしれません。カリフォルニアのような場所では、ラベル付けとモデレーションの要件が現れ始めていますが、世界規模で拡大するには時間がかかります。おそらく5年ではなく、10年程度かかるでしょう。
変化のもう1つの分野は業界特有のものです。ジャーナリズム、金融、保険、ヘルスケアなどの業界は、信頼がその運営の基本であるため、出典と認証を要求し始めるかもしれません。
最後に、消費者は短期的には出典情報に気付いていないかもしれませんが、コンテンツの品質と情報の品質には気付くでしょう。AI生成コンテンツがあまりにも均一化したり「平凡」になったりする場合、聴衆は人間が作成したコンテンツをより高く評価し始めるかもしれません。これは、市場のセグメント化を促進し、AI生成コンテンツを重視するプラットフォームと、出典、真実性、信頼性の高い人間主導コンテンツを重視するプラットフォームに分かれる可能性がありますが、その変化はまだ不確実です。
素晴らしい答えをありがとうございます。詳細については、OpenOriginsを訪けてください。


