
Andersonの視点
視界外、心外:解決AIビデオ最大の問題

 Unite.AI を Google の優先ソースに追加
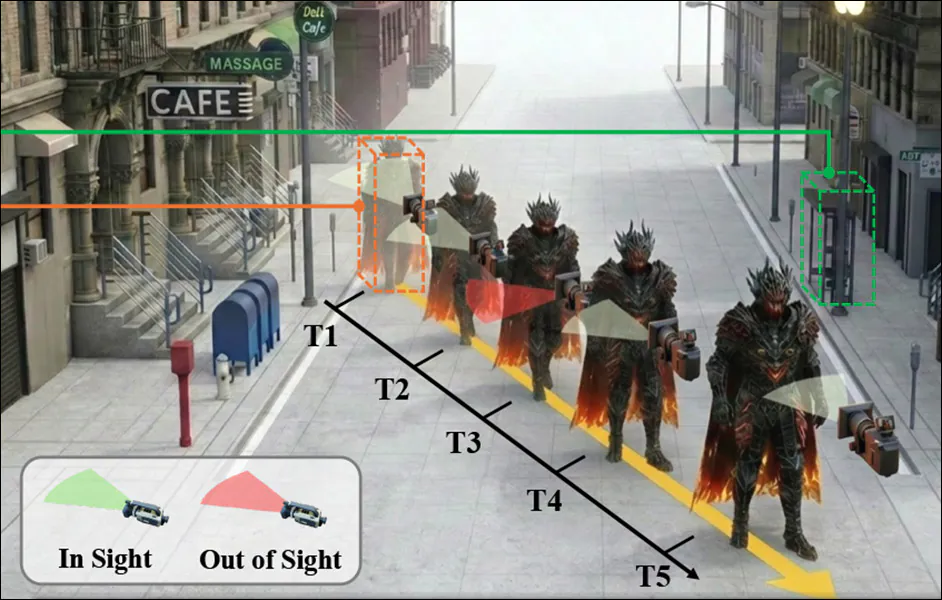
最も優れたAIビデオ生成システムでも、慢性の記憶喪失という課題があります。中国からの新しい研究がこの問題に取り組んでいます。
最も優れたAIビデオ生成システムでも、慢性の記憶喪失という課題があります。カメラが注目しているものから離れてから戻ってくると、元のものは見つけることができません。キャラクターは消え、外見や動きが変わり、背景も変化します。
これは、拡散ベースの生成システムが限られたローリング・アテンション・ウィンドウしか持たず、常にその瞬間に見えているものだけを扱うためです。まさに独我論を実演するように、フレーム外のものは生成AIにとって存在せず、文字どおり記憶から捨てられます。
これは従来のCGIでは問題になりません。CGIなら、必要になった時点で被写体の外見や動きを正確に参照し、再現できるからです。一方、AIの手法には同等の「フラットな参照」ファイルや関連ファイル群がないため、同じことは困難です。

従来のCGIメッシュとビットマップテクスチャは、レンダリングに一貫した外見を提供するためにいつでも描くことができます。AIアプローチでは、これは達成するのが難しいです。
CGIのコンポーネント要素、たとえばメッシュとテクスチャ(上の画像参照)や動きファイルなどの動的動作は、ディスク上に個別に存在し、いつでも描くことができます。
生成AIビデオには同等の「フラットな保管庫」がありません。最も近い仕組みはLoRAです。これは一般向け機器でも学習できる補助ファイルで、独自のキャラクターや特定の衣装をビデオに「強制的に」登場させることができます。
クリックして再生。 AIビデオのソリプシズム問題は、LoRAを使用することである程度軽減できますが、結果は圧倒的な場合があります。
これは理想的な解決策ではありません。LoRAは特定の基盤モデル(Wan2+やHunyuan Videoなど)の特定バージョンに結び付いており、基盤モデルが変わるたびに作り直す必要があります。また、LoRAは基盤モデルの重みを歪める傾向があり、学習したLoRAのアイデンティティがシーン内のすべてのキャラクターに及ぶことがあります。さらに、この種のファインチューニング手法は、不適切に整理されたデータセットに非常に敏感です。
正確なアンコール
中国からの新しい学術・産業共同研究が、3年以上にわたるこの問題についての私の注目を集めた最初の重要な解決策を提供しています。この方法は、オフスクリーンのキャラクターとその直接の環境を、モデルの潜在空間でアクティブかつ正確に保ち、カメラが戻ってきたときに一貫した外見を実現するために、ハイブリッドメモリを使用します。
クリックして再生。 プロジェクトサイトからの、AI生成(WAN)キャラクターがフレームから出入りする2つの例。 ソース
これは、異なるショット間でキャラクターの一貫性を実現することとは別の問題です。後者は1年前のRunway Gen 4公開時に達成されたと主張されましたが、研究文献では今なお継続中の研究課題です。
ここで解決されたのは、オフスクリーンのキャラクターの以前の外見、動き、環境の視覚的一貫した再出現です。
クリックして再生。 新しいイニシアチブのプロジェクトサイトにある他の2つの主要な例。
この原理は、都市探索、POVドライブ、またはその他の非キャラクターレンダリングのドメインにも同様に適用できます。
また、この新しいアプローチは、Runway Gen4やその他のクローズドソースプラットフォームが解決したと主張している問題、つまり異なるショット間でキャラクターを再作成する問題を解決または対処していません。代わりに、これまでに成功していなかったことを実現します。つまり、キャラクターと環境を、常に視覚的に表示する必要なく、メモリに保持します。
新しい研究には、Unreal Engineを介して生成された専用のデータセットと、ソリプシズム問題用のカスタムメトリクス、およびWAN上に構築されたカスタム生成フレームワークが含まれます。利用可能な数少ない類似システムとのテストでは、著者は最先端の結果を主張しています。
‘メモリメカニズムは、世界モデルを進歩させるための重要なフロンティアとして浮上しています。メモリ容量は、生成されたコンテンツの空間的および時間的一貫性を決定します。
‘特に、視点の変化や長期的な外挿の際に歴史的背景を保持するための認知的アンカーとして機能します。
‘強力なメモリなしでは、シミュレートされた世界はすぐに断片的な、混沌としたフレームに崩壊します。’
論文は、Out of Sight but Not Out of Mind: Hybrid Memory for Dynamic Video World Modelsというタイトルで、Huazhong University of Science and TechnologyとKuaishou TechnologyのKling Teamの7人の研究者によって発表されました。
方法
新しい研究の中心は、ハイブリッドメモリです。これにより、「視野外の推論」が可能になり、キャラクターとそのコンテキストを保持しながら、ビューワーが「見ない」(またはキャラクターがフレームから出る)ことができます。このシナリオでは、フレームワークは、空間時間の切り離しを実行する必要があります。ここで、ビューワーが見える生成と、オフスクリーンのキャラクターの存在の両方に同時に焦点を当てます。

カメラの出入りモーションの例。ここではカメラの動きによってキャラクターがフレーム外へ出ますが、別のサンプルではキャラクター自身が一時的にフレーム外へ移動します。 ソース
著者は、拡散の潜在埋め込みでは、抽出して利用したい特徴が他の特徴や属性と強く絡み合っているため、直接取り出そうとすると不要な文脈が入り、被写体が背景に「凍り付く」ことがあると指摘します。そこで、ハイブリッドメモリの学習に特化したHM-Worldデータセットを作成しました。

論文からの、HM-Worldデータセットの4つのカテゴリのサンプル。
コレクションは、サブジェクトの軌跡、カメラの軌跡、シーン、サブジェクトの4つの次元で構成されています。
HM-Worldの合成データには、17のシーンと49のサブジェクト(さまざまな外見の人や複数の種類の動物)が含まれています。Unreal Engineを介して、各シーンにこれらの組み合わせがプロシージャルに配置され、各シーンには独自のモーションアニメーションがあり、ランダムに選択された軌跡に設定されます。
著者は、データセットに28種類のカメラ軌跡が含まれていることを示しています。各軌跡には複数の開始点があります。
最終的なコレクションは、59,225のビデオクリップで構成されており、MiniCPM-Vマルチモーダル大規模言語モデル(MLLM)でアノテーションされています。
研究者は、従来のデータセットであるWorldScore、Context-As-Memory、Multi-Cam Video、360° Motionと比較し、このコレクションの統計的な利点を強調しています。

既存のデータセットとHM-Worldデータセットの比較。
道の少ない旅
複数の過去のフレームと既知のカメラパスが与えられた場合、ビューワーの視点が変化するにつれて、将来のビューを予測するタスクは、独立して移動するサブジェクトがフレームから出入りすることを考慮しながら、背景を安定させます。これには、移動するサブジェクトの外見と動作を、見えない間でも保持するための内部的な一貫したレコードをモデルが保持する必要があります。
著者のHybrid Dynamic Retrieval Attention(HyDRA)方法は、動的サブジェクトを静的シーン表現から切り離す専用のメモリパスを導入することでこれを解決します。ここで、サブジェクトは時間の経過とともに維持され、再出現時に一貫した外見と動作で再出現します。

HyDRAモデルの概念スキーマ。
HyDRAはWan2.1-T2V-1.3B上に構築されており、拡散パイプラインの中心部分はほぼそのままですが、動的リトリーバルアテンションを組み込んだ修正されたトランスフォーマーブロックが導入されています。これにより、モデルは、固定またはローカルコンテキストに依存するのではなく、過去のフレームから動作と外見のヒントを選択的に呼び出すことができます。
このプロセスでは、標準の拡散損失の代わりに、調整されたFlow Matching学習目的関数が使われます。
シーンをカメラモーションと一致させるために、カメラ軌跡は明示的な条件付けシグナルとして注入され、各フレームのポーズは回転と変換で定義され、視点が時間の経過とともにどのように進化するかを捉えるコンパクトな表現に変換されます。
Klingの従来のReCamMasterに沿い、この表現はカメラエンコーダで解析されます。エンコーダは多層パーセプトロンとして実装され、その出力がDiffusion Transformerの特徴へブロードキャストして加算されるため、カメラ移動中も一貫した物体配置を維持できます。
トークン化
生の拡散潜在的な埋め込みは、サブジェクトの動き、外見、背景を1つの絡み合った表現にまとめ、ここから直接抽出を試みると、無関係なコンテキストを導入したり、移動するサブジェクトが「背景に凍りつく」ことになります。
HyDRAは、空間と時間を同時に処理する3D畳み込みベースのメモリトークナイザーを使用してこれを解決します。完全な潜在的な履歴を転送するのではなく、それらを、サブジェクトの外見と動きを保存するコンパクトな、動きを認識したメモリトークンに圧縮します。

HyDRAの概要。左側で、メモリトークナイザーは過去のフレームを、動きを認識したメモリトークンに変換します。右側で、動的リトリーバルアテンションは、現在のクエリをこれらのトークンに対して評価し、最も関連するトークンを取得し、それらを使用して生成されたフレームで一貫した外見と動きを回復します。
これらのトークンは、ノイズを除去しながら長距離のダイナミクスを保持する構造化されたハイブリッドメモリを形成します。動的リトリーバルアテンションモジュールに渡されると、これらのトークンは、モデルがオフスクリーンのサブジェクトを選択的に呼び出すことを可能にし、再出現時に一貫した外見、動き、コンテキストで再出現できるようにします。
動的リトリーバルアテンション
HyDRAの二重メモリメカニズムは、フレームワーク内で別個の補足的な役割を果たします。
メモリトークン化により、過去の潜在的な表現を動きを認識したトークンに圧縮し、動的サブジェクトを静的シーンコンテンツから切り離すことができます。これにより、トークンは完全なフレーム履歴ではなく、恒久的なメモリバンクを形成します。
動的リトリーバルアテンションは、生成中にこのバンク上で動作し、現在のクエリを保存されたトークンに対して評価し、進化するフレームに最も関連するトークンを選択的に呼び出します。これにより、オフスクリーンのサブジェクトは潜在的な進化を続け(例:見えないときでも歩き続ける)、見えるようになると一貫した外見と動きで再出現します。
データとテスト
テストでは、WanベースのHyDRAシステムは77枚のコンテキストフレームをエンコードしてダウンサンプリングし、3D変分オートエンコーダ(VAE)で解析しました。メモリトークナイザーは、3D畳み込みをカーネルサイズ2×4×4で使用しました。
モデルはHM-World上で、種類未指定のGPU 32基とバッチサイズ32を用い、10,000イテレーション学習されました。
テストでは、一般的なPSNR、SSIM、LPIPSに加え、VBenchスイートの被写体一貫性と背景一貫性も用いて、フレーム単位の整合性を評価しました。
さらに、著者は、YOLO V11のバウンディングボックスを使用して、動的サブジェクトの一貫性(DSC)というカスタムメトリックを提案しました。ここで、移動するサブジェクトを含むクロップされた領域が抽出され、セマンティック特徴が抽出され、類似性が計算されました。
HyDRAはDiffusion Forcing Transformer(DFoT)およびContext-As-Memoryと比較され、カメラエンコーダを備えたWan2.1-T2V-1.3Bがベースラインに使われました。すべてのモデルをHM-Worldで学習し、WorldPlayもゼロショットの二次テスト用コレクションとして使用しました。
初期の定量的な比較では、HyDRAはすべてのベースラインを上回り、PSNRを18.696から20.357、SSIMを0.517から0.606まで引き上げました。また、最も高いコンテキストとグラウンドトゥルースのDiceスコア、0.827と0.849を達成し、サブジェクトと背景の一貫性はそれぞれ0.926と0.932でした。

以前のアプローチとの初期の定量的な比較結果。
DFoTは17.693のPSNRを達成し、Context-as-Memoryは18.921を達成しました。メモリトークン化と動的リトリーバルアテンションの組み合わせによる利点が報告されています。

HyDRAと最新の最先端アプローチとの定量的な比較。
WorldPlayに対するテストについて、著者は次のように述べています。
‘私たちの方法は、WorldPlayを含むすべてのメトリックで上回り、PSNRでは5.502のギャップがあります。WorldPlayは、ドメイン分布のギャップと特定のファインチューニングの欠如により、GT参照メトリック(例:PSNR 14.855、DSCGT 0.832)で低いパフォーマンスを示しますが、コンテキスト参照メトリック(DSCctx 0.822)で優れたロバスト性を示します。 ‘
‘この観察は、広範囲にトレーニングされたモデルが妥当なハイブリッドの一貫性を備えていることを示唆するだけでなく、私たちが提案したDSCメトリックの妥当性を間接的に検証し、動的サブジェクトの一貫性を反映することを確認しています。 ‘
‘最終的に、これらの印象的な結果は、私たちのモデルの優れた能力を強調し、確立された商用モデルを上回ることを実証しています。 ‘
論文には、テストの定性的比較の静的な表現が含まれています。

カメラモーションでの出入り比較。著者は、HyDRAがサブジェクトのアイデンティティ、ポーズ、モーションの連続性を、フレームから出入りする後に保持することを主張しています。これは、グラウンドトゥルースに近く、競合する方法は、ドリフト、無意味なモーション、またはサブジェクトの劣化(赤で強調)を示します(一貫した回復は緑で示されます)。
これらの結果について、著者は次のように述べています。
‘複雑な出入りイベントの場合、ベースラインとコンテキストアズメモリは、サブジェクトの歪みとモーションの無意味さを示します。DFoTはサブジェクトの完全性を維持できず、完全に消失します。WorldPlayはサブジェクトの外見の一貫性を維持しますが、途切れた動きと自然でない動作を示します。 ‘
‘対照的に、私たちの方法は、ハイブリッドの一貫性を維持し、サブジェクトのアイデンティティとモーションの連続性を、サブジェクトがフレームに再入った後も維持します。 ‘
さらに結果は、補足サイトでビデオ形式で見ることができます。最初の4つの例は、以下のビデオにまとめられています。
クリックして再生。 プロジェクトサイトの6つのテスト結果のうち最初の4つ。 ソース
結論
AIビデオ生成の最大の問題の1つに対処しようとするあらゆる試みは歓迎されますが、最適な解決策は、CGIと同様に、編集およびコンポジット可能な個別のリファレンス資料の形で実現する可能性が高いと思われます。
このような問題を解決するための最適な解決策は、個別のキャラクター埋め込みを使用することです。後続のショットに先行ショットの潜在的な空間へのアクセスが必要な場合は、両方のインスタンスが個別のキャラクター埋め込みを配置する必要があります。
* これまで誰も名前をつけていないため、共通の用語なしでは議論が困難です。
** プロジェクトページでは「すぐに公開」と報告されています。
2026年3月27日(金)に初めて公開されました


