
インタビュー
TrueFoundry共同創業者兼CEO Nikunj Bajaj氏 — インタビューシリーズ

 Unite.AI を Google の優先ソースに追加
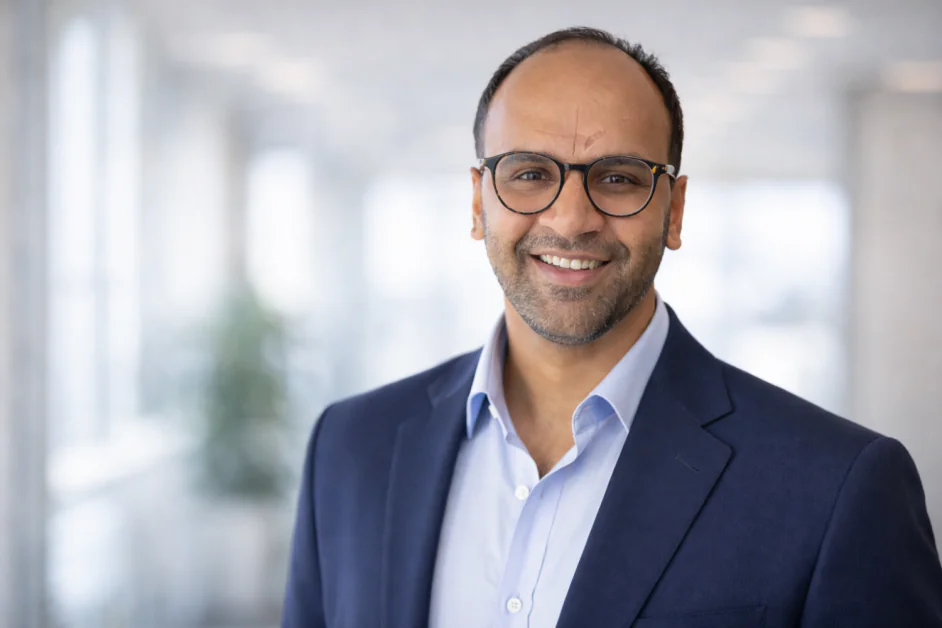
TrueFoundryを創業する前は、機械学習の研究、Facebook (META )での本番環境のAI、大規模な推薦システムに携わっていました。どのような経験が企業向けAIインフラの会社を立ち上げる直接のきっかけとなり、当時どのような課題が未解決だと感じていましたか。
Metaでは、機械学習をソフトウェアの特殊なケース、生成AIを機械学習の特殊なケースと捉えていました。その結果、ソフトウェアを最下層、機械学習を中間、生成AIを最上層に置く垂直型の技術スタックになっていました。この構成では、機械学習の開発者である私が作るモデルも、ほかのソフトウェアと同じデプロイのパターンに従うため、システムのスケーリングが非常に容易になります。
一方、大半の企業は並列型のスタックを導入していました。ソフトウェア、機械学習、生成AIにそれぞれ別のスタックがあるということです。こうした並列型のスタックでは、機械学習とソフトウェアの領域の間で作業の引き継ぎが必要になるため、スケーリングが複雑になります。
私たちのチームは常に、機械学習モデルの開発と機械学習インフラの接点で仕事をしてきました。その独自の視点から、同様の垂直型スタックを企業に導入し、各社の具体的な要件に合わせて調整できると考えました。また、2021年末には、機械学習が転換点に近づいており、その時点に達すれば、これらのシステムを効果的にデプロイしてスケーリングするために垂直統合型スタックを必要とする企業が増えるという仮説を立てました。これが最終的にTrueFoundryの創業につながり、仮説は正しかったと分かりました。2022年末にChatGPTが登場した後、AIの導入は加速しました。
AIシステムが実験から日常の運用へ移る中で、組織が信頼性と障害について考えるべきあり方には、どのような変化が生じていますか。
生成AIでは、従来の機械学習システムに比べて、はるかに大きなものが懸かっています。システムが本番運用に入ると、LLMが本質的に確率的であるため、組織ははるかに高い曖昧さと非決定性に対処しなければなりません。その上に構築されるエージェントシステムは、さらに曖昧さを増します。
また、障害はもはや二者択一ではありません。単純にシステムが故障しているか、していないかというだけでなく、多くの問題が部分的な障害や気づきにくい劣化として現れます。時間の経過とともに応答遅延が増えたり、品質が低下したり、動作が誤ったりすることがあります。こうした劣化は発見が難しい場合が多く、時には完全な停止よりも大きな損害をもたらすことさえあります。
組織は信頼性を考える際、稼働時間だけでなく、時間とともに進む性能劣化にも目を向ける必要があります。
TrueFailoverが発表されたのは、クラウドやAIサービスで注目を集める障害が相次いでいた時期でした。最近のどのような出来事によって、AIの信頼性が「あれば望ましいもの」から中核的なアーキテクチャ要件へ変わったことが明らかになりましたか。
医療分野のお客様の1社は、患者の処方に関する依頼をリアルタイムで処理しており、迅速な対応が重要です。このお客様がモデルの障害によるサービス停止の影響を受けました。そのワークフローは1秒当たり数千ドルの売上を生み出しており、停止によって一部の重要なワークフローが妨げられました。このお客様はTrueFailoverの初期の利用企業だったため、私たちは迅速な復旧を支援でき、影響を抑えられました。
こうした出来事は重要な問いを投げかけます。生成AIシステムに懸かるものがますます大きくなる中、復旧プロセスはなぜ依然として大部分が手作業なのでしょうか。これにより、障害は起こるという前提でシステムを構築し、自動的に問題を修正するよう設計すべきだという考えが強まりました。信頼性はAIスタック自体にも組み込む必要があります。AIゲートウェイを使えば、集中型のルーティング、可観測性、ガードレール、異なるプロバイダーのモデル間でのインテリジェントな切り替えを提供できます。
多くのAIの停止は、今も小さな技術的不具合として語られています。AIシステムが停止したとき、実際の経済的・人的コストはどこから現れ始めると考えますか。
企業のAIは、こうした不具合がもはや内部のワークフローだけに影響する段階を超えました。現在、本番環境の用途は顧客向けになっているため、停止や劣化は世間の評価と利益に直接かつ即座に影響します。内部テストから、重大な影響を伴う一般利用者向けアプリケーションへ移行したことが、経営層による関与と監督の必要性が高まっている理由です。
AIシステムが業務ワークフローに深く組み込まれるにつれて、停止は単なる技術的問題ではなくなります。事業、顧客、評判に対して、ますます直接的な影響を及ぼすようになっています。
薬局、医療業務、カスタマーサポートなどのミッションクリティカルな環境では、AIの停止はどの程度の速さで業務上のリスクや評判へのリスクに発展しますか。
ミッションクリティカルな環境では、ほぼ即座に深刻化します。システムが、対応のタイミングが重要なリアルタイムのワークフローを支えているからです。短い中断でも重要なプロセスを止め、サービス提供を遅らせ、あるいはその出力に依存する後続システムを中断させて、組織全体に連鎖的な業務上の影響を生む可能性があります。
医療などの分野では、影響は業務の中断を超え、顧客体験やサービスの成果にも及びます。患者が処方薬を必要な時に受け取れなければ、実際の不利益が生じ得ます。患者にとっての問題であるだけでなく、薬局や医療提供者の評判を損なうこともあります。信頼が重要なミッションクリティカルな環境では、システムがオンラインであり続けることが何より大切です。そのため組織は、障害が起こるという前提でAIシステムを設計し、リスクを最小限に抑えるために復旧メカニズムを自動で作動させる必要があると、ますます認識するようになっています。
多くのチームが継続性よりも機能を重視してアーキテクチャを設計しているとおっしゃいました。AIシステムの設計では、なぜこれまでレジリエンスの優先順位が低かったのでしょうか。
主な理由は組織内のインセンティブです。新しい機能は目に見え、魅力があります。デモ、機能、製品の新たな可能性を生み、経営層はその成果をすぐに確認できます。
継続性は、その性質上、すべてが正常に動いているときには見えません。そのため報酬制度は、何も壊れないようにすることより、新機能をリリースすることを評価しがちです。その結果、組織はレジリエンスのエンジニアリングに比べ、機能開発に不釣り合いなほど多く投資することがあります。
企業が外部モデルやAPIへの依存を深める中で、AIスタックには、経営層がその重要性をまだ十分に認識していないかもしれない、どのような新しい脆弱性が生じていますか。
LLMは本質的に共有リソースであり、企業は従来のインフラと同じように所有しているわけではありません。また、企業の事業に不可欠な重要システムが、長期にわたる検証をまだ十分に経ていない外部システム上で稼働しています。LLM自体が急速に進化しており、プロバイダーは研究の反復を非常に速く進めているため、遅延やモデル性能のわずかな低下といったことについて、その責任を問うことができないということです。
LLMは共有リソースなので、ほかの利用者の特定の操作によって遅延が急増することがあります。LLMの根本的な性質によって、このような障害点が数多く生じ、企業はこの新しい世界で完全な制御権を持てません。完全に制御できない以上、企業にできる最善のことは、十分なシステム冗長性を確保してレジリエンスのあるシステムを設計することです。
特定の製品に焦点を当てずに伺います。組織は、停止をまれな例外と捉えるのではなく、障害を前提とするAIアーキテクチャをどのように考え直すべきでしょうか。
組織は分散システム設計の基本原則に立ち返るべきです。ソフトウェアシステムは、ネットワーク機器やマシンが故障し、リージョン全体が停止することもあるという前提で構築されてきました。
AIシステムも例外であってはなりません。モデルプロバイダーでは遅延の問題、劣化、停止が起こると想定し、さまざまな障害シナリオでもアプリケーションがレジリエンスを保てるよう冗長性を組み込むべきです。
稼働時間や冗長性がクラウドインフラの意思決定を左右してきたように、AIのレジリエンスもプラットフォームやベンダー選定の決定要因になるとお考えですか。
より多くのAIシステムが本番運用に入るにつれ、レジリエンスは最低条件になります。稼働時間と全体的なレジリエンスに関するグラフや指標を示せないベンダーは、検討の対象にさえなりません。レジリエンスがすべてのベンダーに対する基本的な期待になると、決定要因はユーザー体験、性能の最適化、可観測性、より上位の製品機能へと移ります。やがてAIゲートウェイや自動フェイルオーバー機能などの要素が、企業のAIインフラの中核的な基盤になります。
今後、AIが時々役に立つだけでなく、常に利用可能であることが求められる世界では、「本番運用に対応できる」AIとは本当は何を意味するのでしょうか。
本番運用に対応できるAIシステムは、観測可能、制御可能、復旧可能でなければなりません。この3つの条件をすべて満たす必要があります。
本番環境のAIで可観測性を確保するには、モデルの振る舞い、遅延、エラー率、トークン使用量、ドリフト、障害パターンを深く把握する必要があります。高い可観測性がなければ、利用者が気づき始める前に劣化を検出することは非常に困難です。
システムの制御可能性には、トラフィックシェーピング、リクエストのレート制限、ガードレール、ポリシーの適用、モデルやプロバイダー間のインテリジェントなルーティングが含まれます。ここでAIゲートウェイが基盤となり、ガードレールを適用し、一貫したガバナンスを提供し、性能や信頼性の低下時にモデルを動的に切り替える中央制御プレーンとして機能します。
最後に、復旧可能にするには、コンポーネントが部分的または完全に機能しなくなることを前提にシステムを構築すべきです。原因としては、プロバイダーの停止、モデル品質の低下、レート制限、悪意のある行為者からの想定外の入力などがあります。自動フェイルオーバーと自己修復のメカニズムは、問題が起きた後に始動する手作業の手順ではなく、アーキテクチャに組み込まれているべきです。
これがTrueFoundryで私たちが目指している方向です。可観測性、中央制御、自動復旧を組み合わせて本番運用への対応をこのように定義するベンダーは、顧客の長期的な信頼を獲得し、新たな問題が現れるたびに解決し続けられるでしょう。
素晴らしいインタビューをありがとうございました。詳しく知りたい読者は、TrueFoundryをご覧ください。


