
Andersonの視点
AIに視覚的アナロジーをもたらす

 Unite.AI を Google の優先ソースに追加
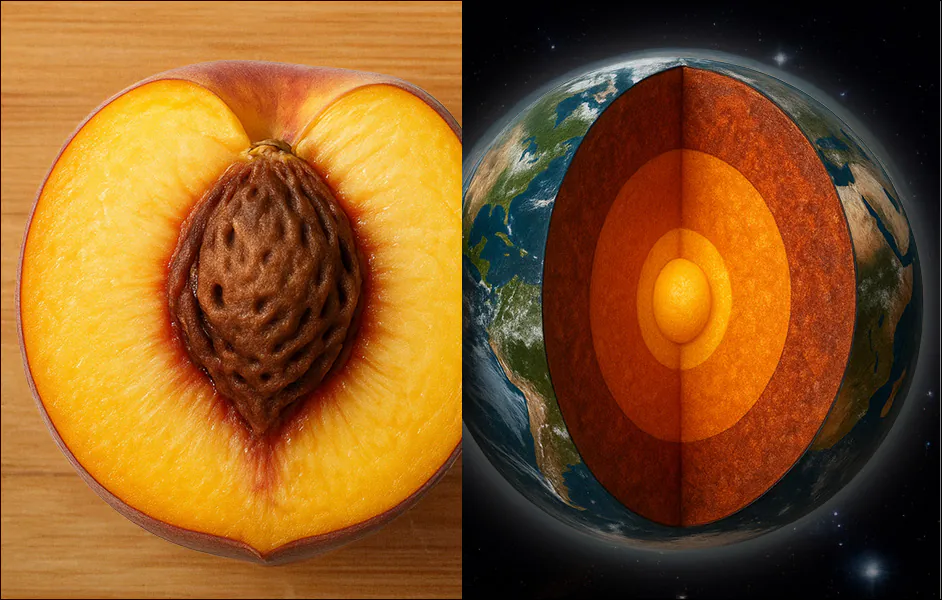
ョンモデルは多数存在し、画像を比較して類似性を検出することができます。しかし、現在の比較システムは、想像力のある能力がほとんどありません。19
コンピュータビジ 60年代のク ラシックソング「 現在のAIモデルは、地球の層と桃の類似性などの「関係性」画像の類似性を認識できません。これは、人間が 歌詞を考 画像を認識する方法の重要な側面を欠いています。 」の えてみましょう:
「物体」ドメインを作成するにつれて、視覚的な類似性の能力を開発し、例えば桃と地球の断面、またはコーヒーの渦巻きと銀河の枝のようなフラクタル再帰が、私たち
Windmills of Your Mind このような比較は、人間にとって意味のある詩的な暗示のドメインを表し、芸術的な表現を超えて、私たちが認識システムを開発する方法と結びついています。私たちが にとって類似性を持ちます。 このように、私たちは明らかに関連のない物体や物体の種類間のつながりを推測し、重力、運動量、表面凝集などのシステムを 推論することがで きます。これらのシステムは、さまざまなドメインやスケールで適用できます。 回るメリーゴーラン ドのように 、月の周りを走り回る 時計の針が時計の面を通過するように 世界は静かに空間を回転しています
物を見る
最新の画像比較AIシステム、たとえば、 LPIPS や DINO は、人間 のフィードバックに基づいていますが、表面的な比較のみを実行します。 人間の顔が存在し ない 場所で 顔を見つける能力、つまり は、人間が開発する視覚的な類似性メカニズムを表すものではなく、顔検出アルゴリ ズムが 低レベルの顔構造 パレドリ

折ランダムな物体と一致します: 特徴 「Faces with Things」データセットの顔認識の誤検知 の 例。 ました。このデータ 出典 アメリカの研究者は、 についての研究を実施し、新しいデータセットをキュレーションしてトレーニングし


著者が提案した「relsim」メトリックに寄与する予測され プシた「匿名」キャ ョン。 この新しいアプローチ

ます。 関係性の類似性と属性の類似性の定義 典型的なデータ セットのキャプ ションスタイルとrels imア プローチの比較。relsimアプ

次のように述
ています: 「人間は、属性の類似性を感覚的に処理しますが、関係性の類似性は概念的な抽象化を必要とし、言語や事前の知識によって支えられることが多い。」 「これは、関係性の類似性を認識するには、画像を理
べ 解し 、知識 本的な構造を抽象を利用し、根 化する必要 があることを示唆しています。」
方法
研究者は、LAION-2Bという有名なデータセットを使用して、独自のコレクションを作成しました。

出典 LAION-2Bから、114,000枚の画像が抽出され、関係的な構造を含む画像をフィルタリングするために使用されました。 Qwen2.5-VL-7Bを使用して、1,300の正例と11,000の負例の人間によるラベル付けされた例を利用して、選択プロセスのパイプラインを作成しました。

114kの画像が関係的に興味深いものとして識別されました。」 結果として得られたグループレベルのキャプションは、特定のオブジェクトではなく、 や
「アノテーターは次のように指示されました。『この画像に、他の画像を作成またはリンクするために役立つ関係的なパターン、論理、または構造を見つけることができますか?』」 「ファインチューンされたモデルは、人間の判断と93%の一致を達成し、LAION-2Bに適用すると、N = 「{主題}」 などのプレイスホルダーに置き換えられ、広く適用可能なものとなりました。 「{動作の種類}」
データとテスト
Qwen2.5-VL-7Bを使用して関係的な特徴を抽出してから、 L oRAを使用して15,000ステップでモデルをファインチュー ンしました 。テ キスト側では、relsimメトリックを埋め込む ため に、Sentence-Transformersライブラリのall-MiniLM-L6-v2を使用しました。 114,000枚の画像のデータセットを100,000枚のトレーニングセットと14,000枚の評価セットに分割しました。システムをテストするために、リトリーバ ル設 定を使用しました。クエリ画像が与えられたとき、モデルは28,000アイテムのプールから同じ関係的なアイデアを表す別の画像を見つける必要がありました。 リトリーバルの品質を評価するために、GPT-4oを使用して、クエリとリトリーブされた画像の関係的な類似性を0から10のスケールでスコア付けしました。また、ユーザーの好みを測るために別の人間による研究も実施しました。 各参加者は匿名化されたクエリ画像と2つの候補(1つは提案され た方法で リトリーブされたもの、もう1つはベースラインでリトリーブされたもの)を提示され、どの画像がクエリにrelationally類似であるか、またはどちらも等しく類似であるかを判断するように求められました。 relsimアプローチは、LPIPS、DINO、dreamsim、CLIP-Iなどの既存の画像間の類似性を計算するベースラインと比較されました。また、Qwenを使用して各画像の匿名または抽象的なキャプションを生成するキャプションベースの方法もテストされました。
既存のメトリックと関係性の類似性
著者は、既存のメトリックが関係

示しています。従
来の類似性メトリックであるLPIPS、DINO、CLIP-Iは、調整されていても低スコアでした。キャプションベースのベ
とCLIP-Tも低性能でした。最高スコアは、relsim(6.7
ースラインであるQwen-T

合性が
ます: 「LPIPSは、 い純粋に感覚的な類似性に焦点を当てているため、最も低い
向上したことを示しています。 著者は次のように述べては、自己スコア(4.56)を達成します。DINO

Iはまだ私たちの方法に劣っています。より良いスコアを達成するには、匿名キャプションにあるようなより高い抽象化が必要である可能性があります。」
ユースケース
この論文では、関係性の類似性のいくつかの潜在的なユースケースも探索されています。関係性の画像検索を可能にする

関係性の検索では、クエリ画像と同じ根本的な構造を共有する画像が返されます。たとえば、顔のように見える食事は、他の擬人化された食事を返し、切断された物体は他の切断された形状を返し、親子間のやり取りのシーンは、種や構成が異なっていても、同じ関係的な役割を持つ画像を返します。 です。これにより、関係的な構造を使用してクエリを合成することができます。別の可能性は、

結論
生成的なAIシステムは、抽象的な表現を概念化に組み込む能力を持つことで、著しく強化されるようです。現在、概念ベースの画像、たとえば「怒り」や「幸せ」などの画像を要求すると、最も人気のある画像やデータセットに含まれる画像が返されます。これは、抽象化ではなく、 記憶化 です。 この原則は、生成的な書き込み、特に分析的な、推測的な、または小説的な出力に適用される場合に、さらに有益である可能性があります。 (/video) 再生するにはクリックしてください。 出典 * A100には、40Gbまたは80GBのVRAMが搭載できますが、論文では指定されていません。
著者の引用は冗長で除外されています。
2025年12月16日初めて公開されました。


